TechGuide「AI Agent 面试专题」第 1 篇 · 什么是Agent
正文约 5800 字 · 预计阅读 12 分钟
大家好,我是声哥。
最近在整理 Agent 岗位面试高频题,发现单点去背答案,很难真正理解agent原理,因此容易被面试官追问尬住,所以我准备写个系列,把这些题放回实际例子里,从 Agent 原理讲到开发和评测。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
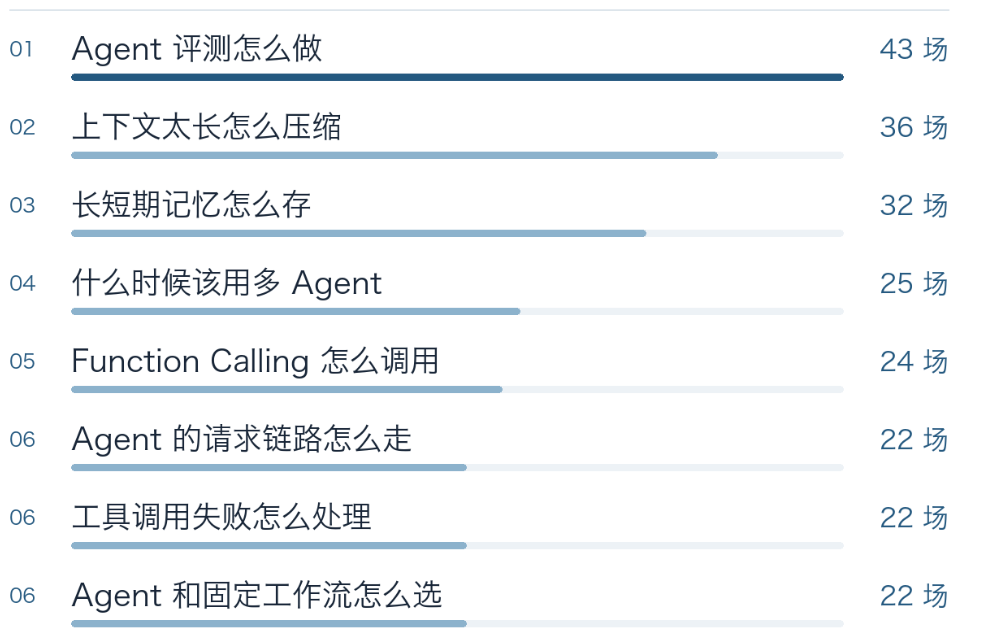
Agent 岗位面试高频题(138 场面试,同一轮同一题只计一次)
我理解 Agent,主要看它做完一步之后,怎么决定下一步。一个模型决定去查什么,工具把结果带回来,这个结果又会影响它接下来怎么做。弄懂这一轮是怎么转起来的,再看工作流、RAG 和 MCP,就容易分清它们各自解决什么问题。
01 Agent 这个概念是怎么来的?
Agent 通常译作「智能体」,原意接近「采取行动的人或事物」。要理解软件怎么自己采取行动,可以先看 1973 年发表的 Actor 模型。你可以把一个 Actor 想象成负责一件事的小单元,收到消息后,它会按自己的规则处理,再发消息给其他 Actor。
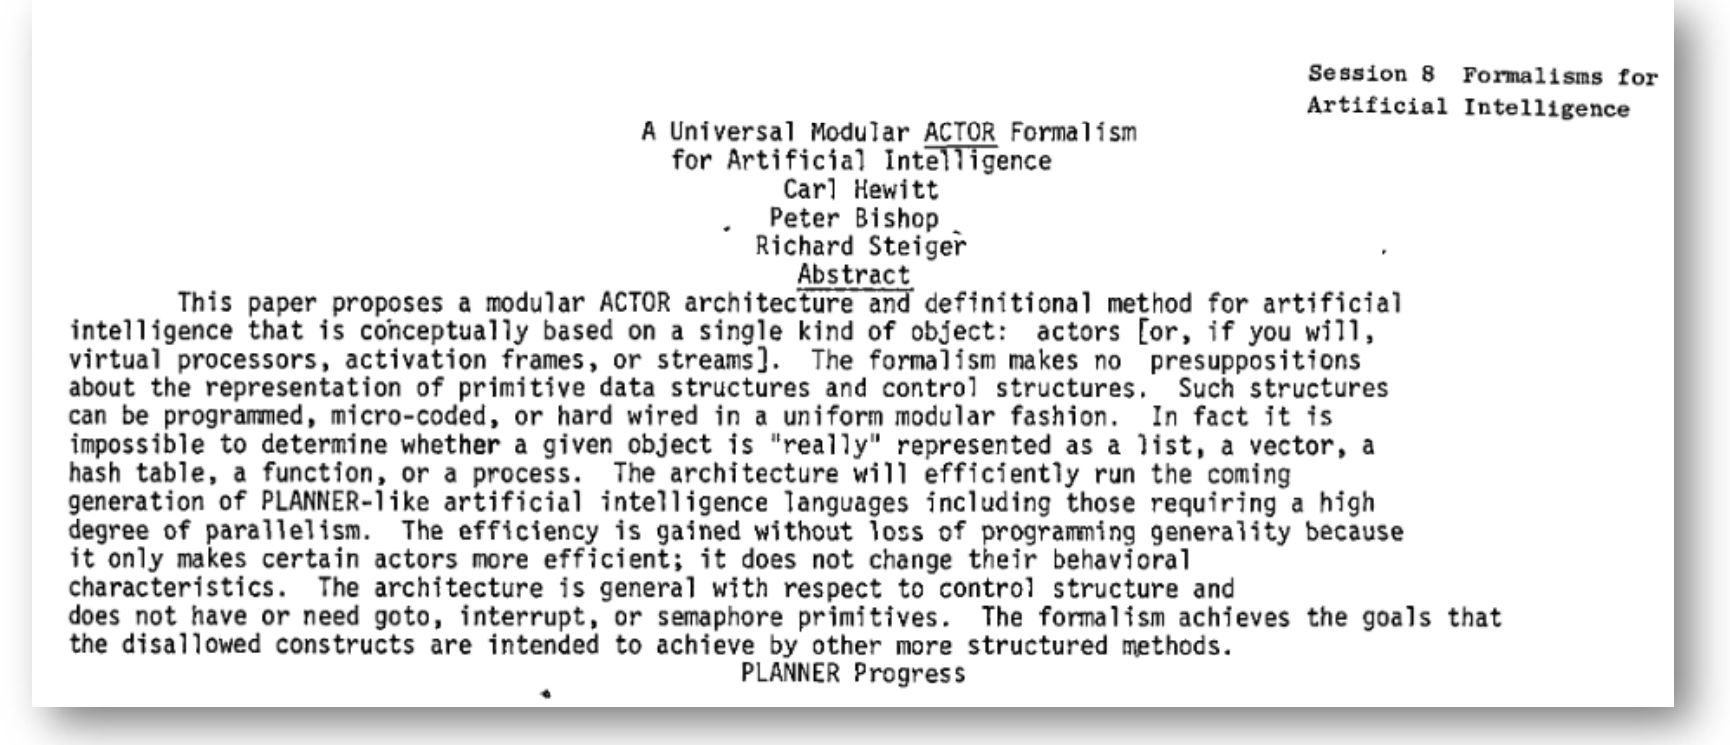
图 01 图中是 1973 年 Actor 论文的标题和摘要。看摘要开头即可,它用 Actor 作为搭建系统的基本单元。 来源 [1]Actor 模型原论文(IJCAI 1973)
如果有一群这样的单元,任务怎么分?1980 年提出的合同网协议给出了一种办法,让不同单元通过公告任务、响应和分配来协作[2]。1986 年的《心智社会》也用许多小单元的协作解释复杂行为。
到 1990 年代,研究者开始更明确地描述 Agent 的特征。它有一定自主性,会跟其他对象交互,能对环境变化作出反应,也能主动为目标采取行动。另一个更直观的说法是,Agent 从环境里获得信息,再对环境采取行动。 比如它通过传感器感知周围,再通过执行器改变周围的状态。
到强化学习时期,这个过程就能画成一个循环。Agent 做一个动作,环境返回新状态和奖励,Agent 根据这些信息再做下一步。
图里的 DQN(深度 Q 网络)是一种强化学习算法。它能从 Atari 街机游戏的画面估计各个动作的长期回报,再决定这一步按哪个键。AlphaGo是下围棋的系统。OpenAI Five则是一个打《Dota 2》的五人 AI 队伍,五个角色需要配合。这些系统各自围绕特定任务训练。
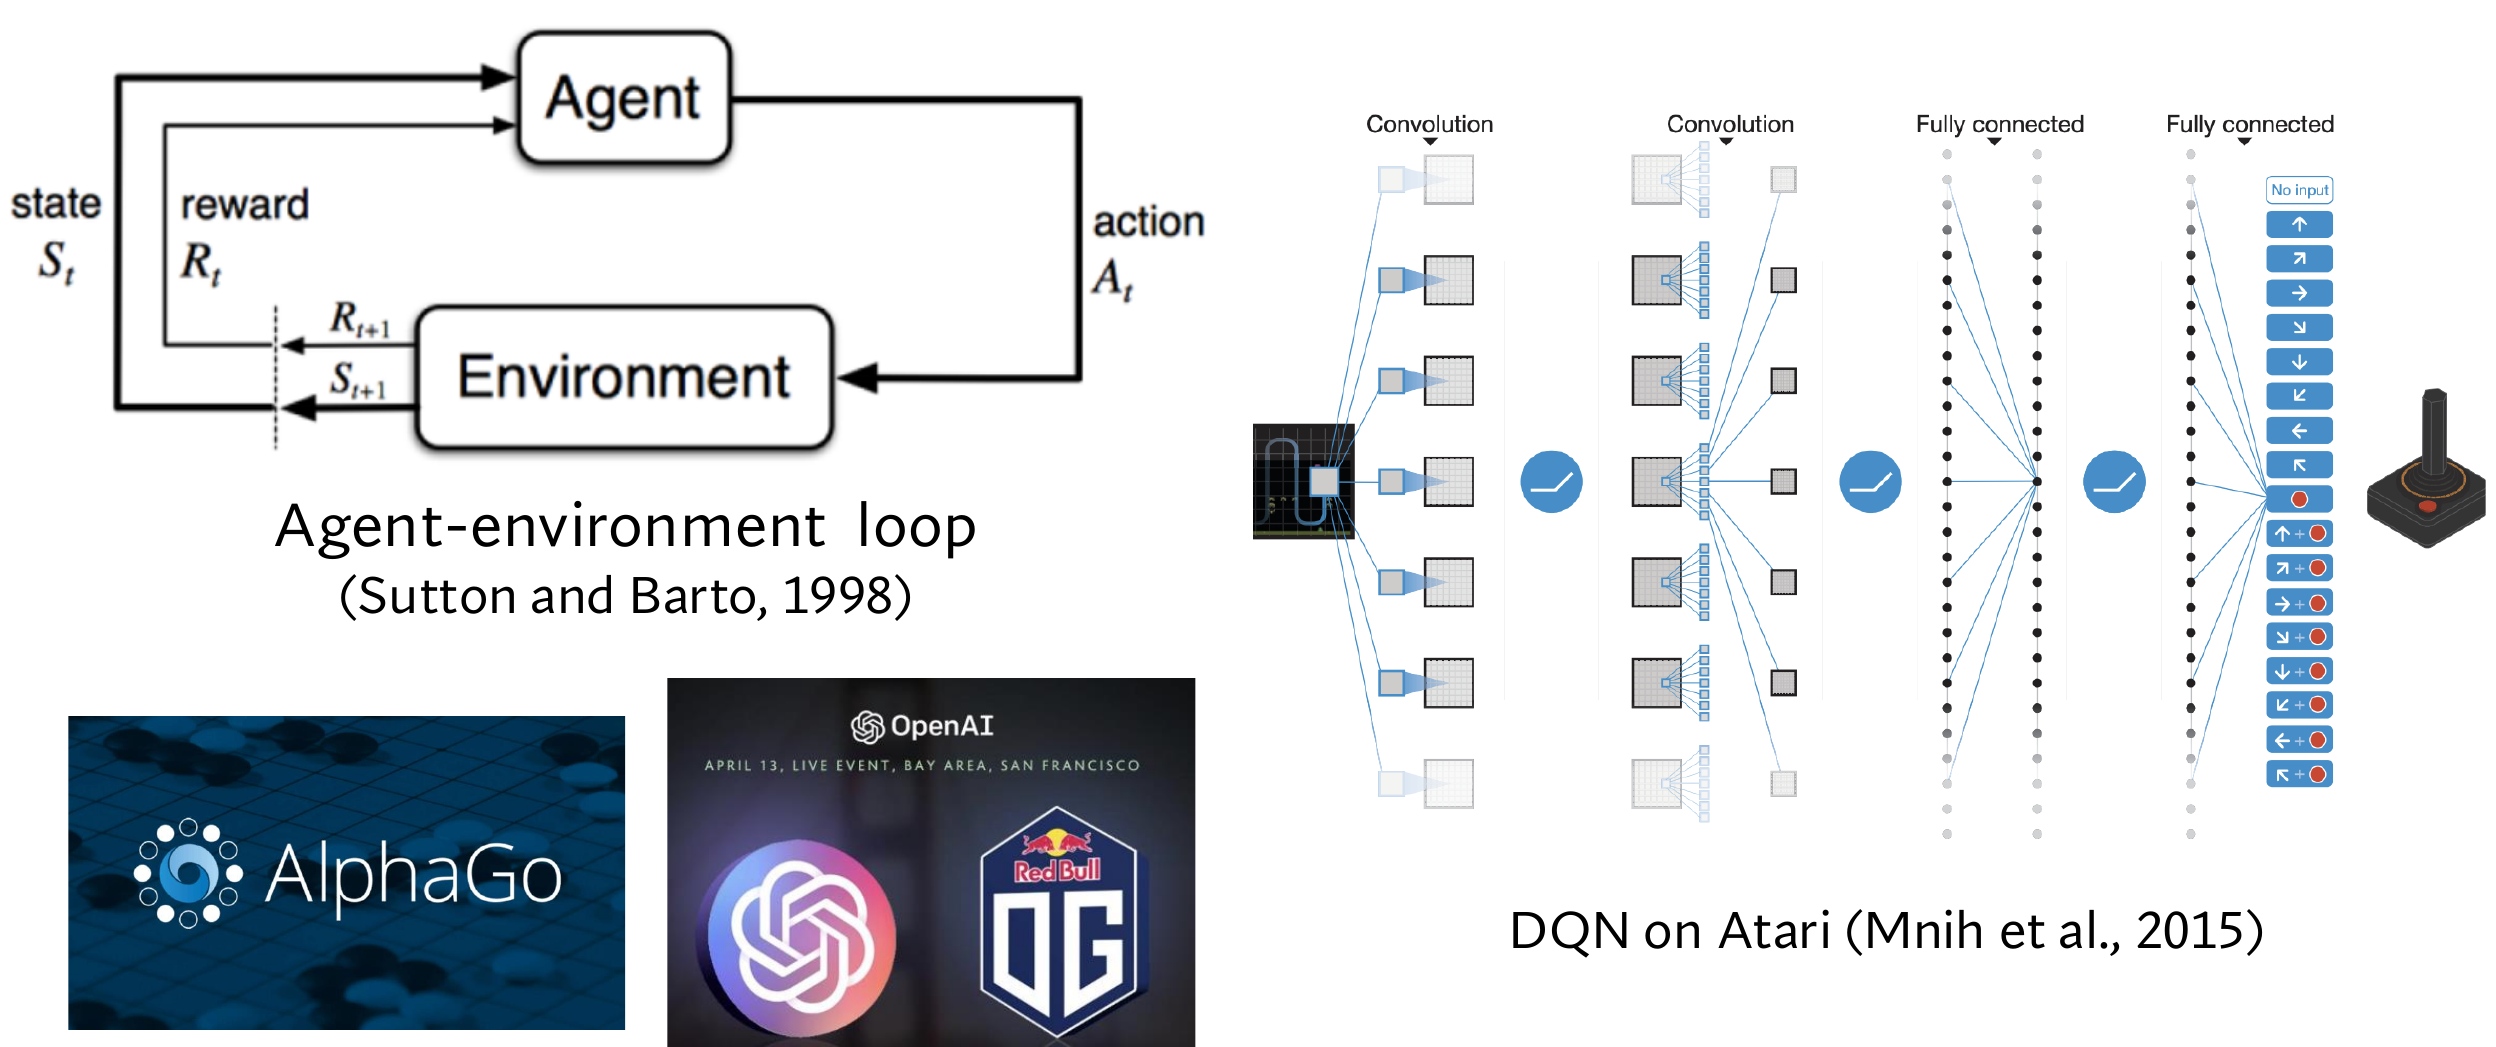
图 02 左上画的是循环。Agent 把动作交给环境,环境返回状态和奖励。右边是 DQN 从游戏画面算动作价值,左下是 AlphaGo 和 OpenAI Five 的例子。 来源 [3]DQN 玩 Atari 的论文(2015)、[4]OpenAI Five 项目介绍
02 大语言模型带来了什么变化?
先是上下文学习。GPT-3 的例子是在提示里放几组翻译示范,再给一条新句子,模型就能照着做。示范是这次调用的输入,模型权重在这个过程中没有更新。
接下来有两条线。一条是让模型写出中间推理,比如用思维链提示它一步一步解题。另一条是让模型借助外部工具。WebGPT 能用浏览器查资料。MRKL 的设想是把任务交给合适的外部模块,遇到天气问题就找天气接口,遇到计算问题就找相应工具。
2022 年的 ReAct 把推理和行动接在一起。模型想一步,做一步,看看结果,再决定下一步。后来 ChatGPT 和 GPT-4 推出,BabyAGI 和 AutoGPT 也很快出现。BabyAGI 给模型一个目标,让它生成和更新任务清单。AutoGPT 把模型接到搜索、文件系统等工具上,尝试让它多做几步。这两个早期项目都试着让模型自己把任务往下推进,当时跑起来还不太稳定。
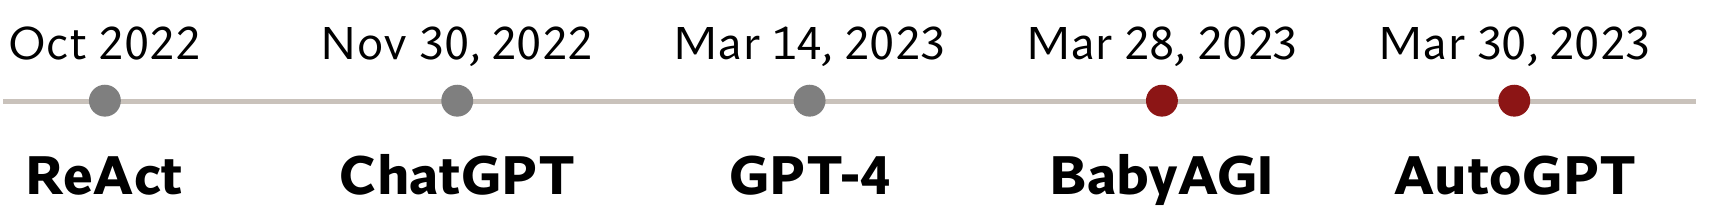
图 03 从左往右是 ReAct、ChatGPT、GPT-4、BabyAGI 和 AutoGPT 的时间线。2023 年 3 月,两个开源项目在 GPT-4 发布后约两周陆续出现。
底层模型的进步,也影响 Agent 能做什么。以 GPT-3 到 GPT-5 的评测为例,早期用 MMLU 这类基准就能看出差距。后来一些基准上的分数接近上限,就需要用 GPQA 和更难的数学题来区分模型的能力。Agent 的评测也在变,比如用 SWE-bench Verified 看修代码的能力,用 OSWorld 看电脑操作,用 Terminal-Bench 看终端任务。有些图同时画价格和准确率,因为完成同样的任务,花费也值得比较。让模型多推理几步,可能会提高答对的机会,也往往会用掉更多 token。看评测结果时,可以把准确率和这笔开销放到一起看。
03 拆开一个 Agent 看看
我用 ReAct 论文里的一个小任务来拆解 Agent 的结构。它要把胡椒瓶放进罐子。模型先猜胡椒瓶可能在柜子里,再去查看。查完后,周围有什么、拿到了什么,会成为它下一轮判断的依据。
- 大模型(LLM Core) 是底层模型,负责理解输入和生成下一步的判断。
- 规划与推理(Planning & Reasoning) 决定该怎么拆任务、先去哪里找。
- 记忆(Memory) 记录已经发生的动作和观察,免得下一轮从头开始。
- 工具(Tools) 把决定变成实际操作,比如查询、计算、读写文件。模拟任务里的走到柜子旁、拿起胡椒瓶,也是系统允许执行的动作。
- 环境(Environment) 是真正发生操作的地方,可以是网页、代码仓库、游戏或数据库。操作做完,环境还会返回结果。
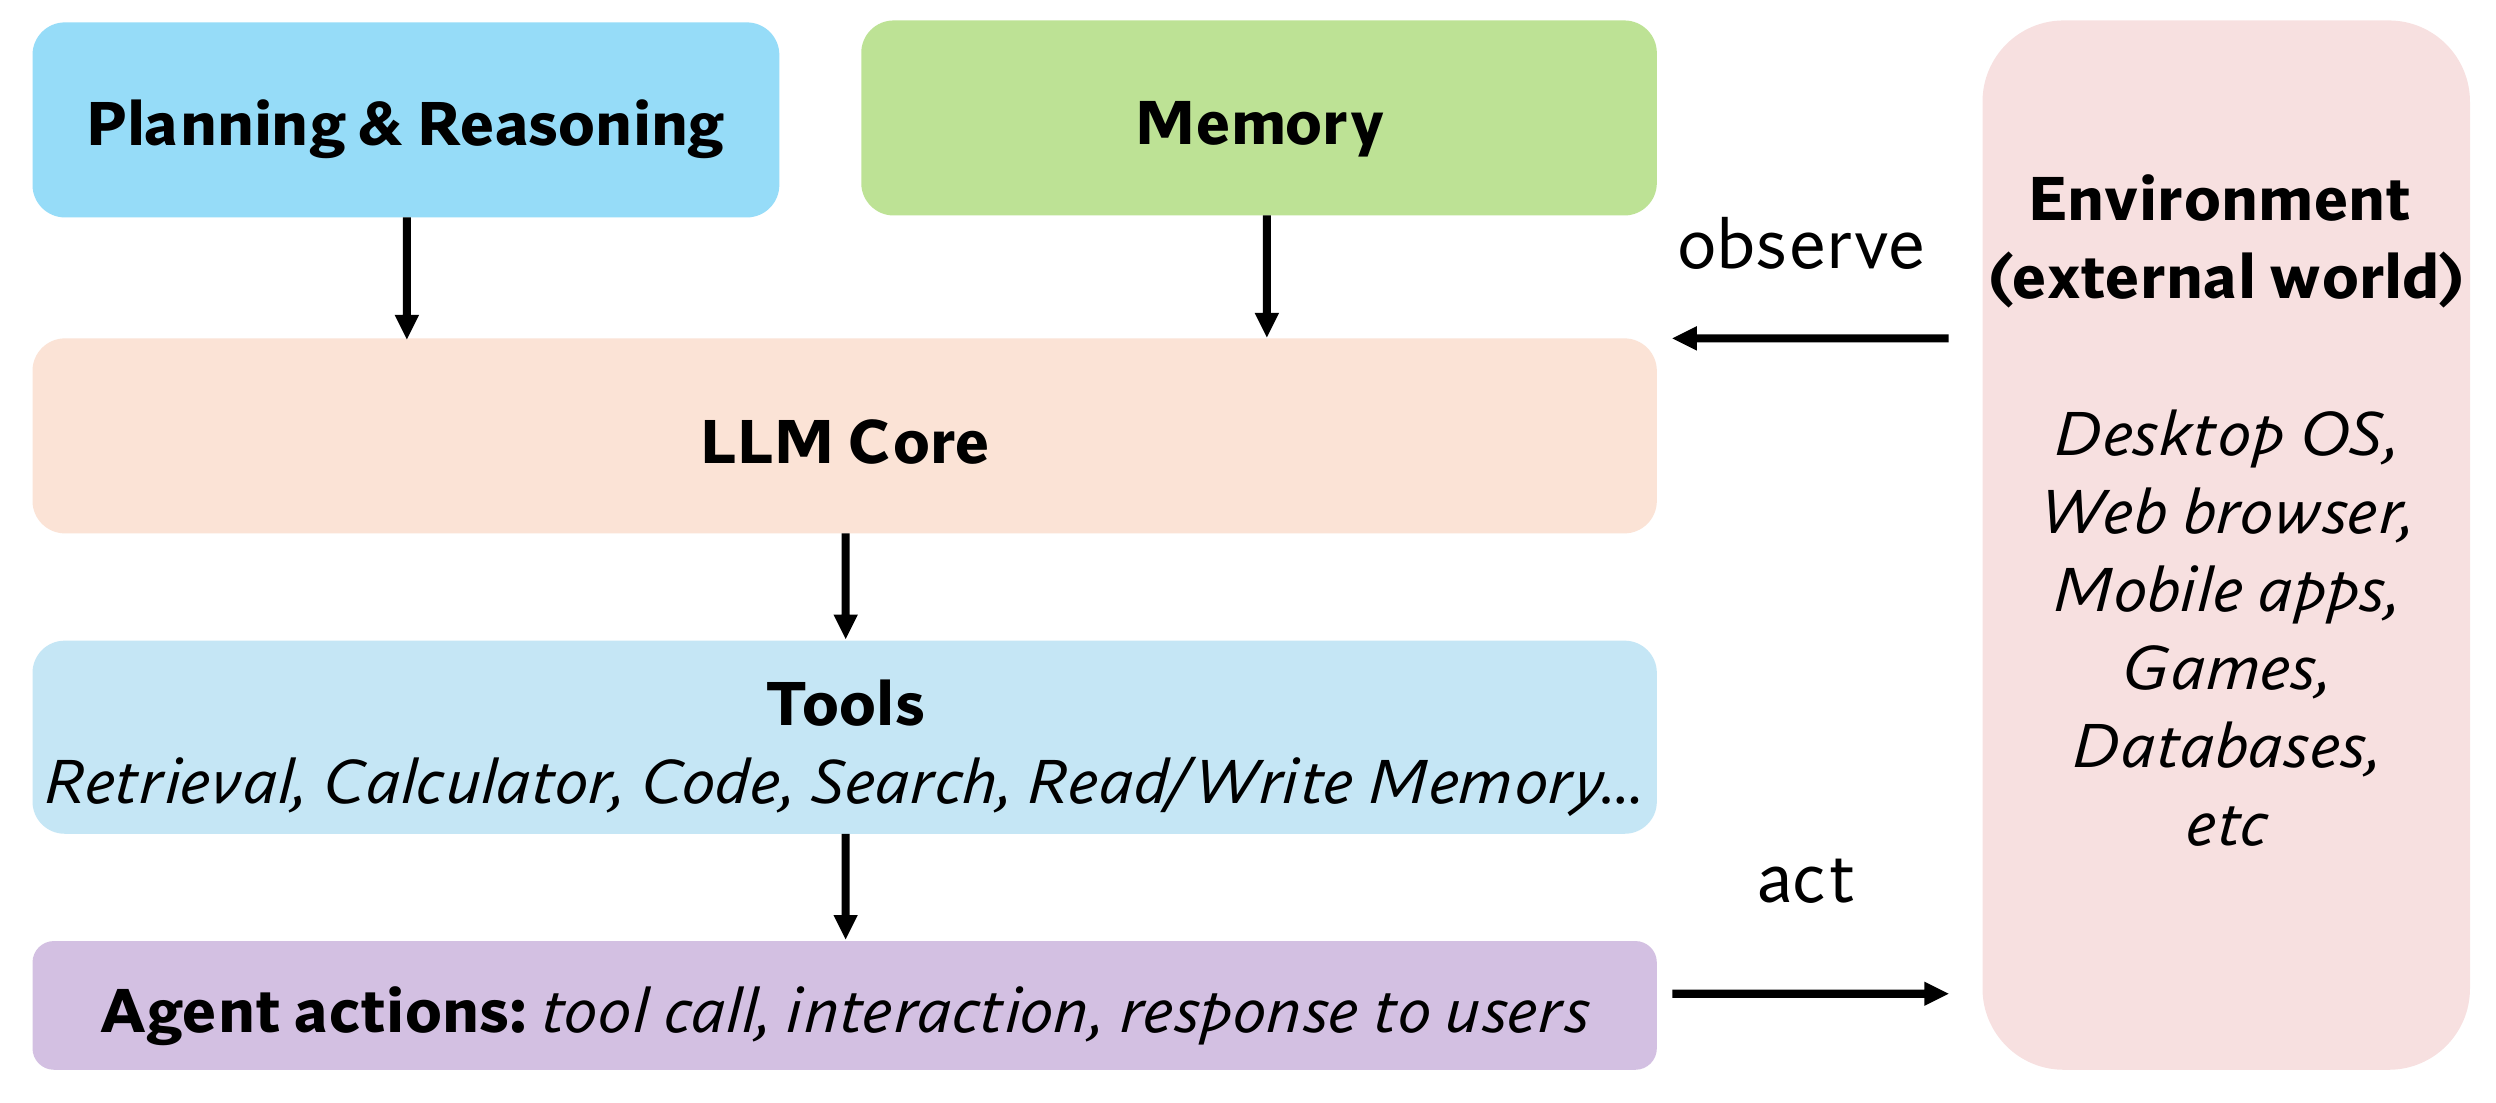
图 04 先看中间的模型,它会结合上方的规划和记忆选动作。下方的 act 是执行,右侧的 observe 是把环境发生的变化带回模型。这样才能接着做下一步。
模型的能力和工具的能力可以分开看。一道很难的数学题,模型可能会做。问它今天某地的天气,没有查过外部数据就很难答准。接上天气接口,它才有办法拿到那条当前信息。不同的 Agent 架构图,组件叫法和画法可能不太一样,但都能看到感知、判断、行动、再感知这个循环。
04 规划和推理,具体起什么作用?
先看做菜的例子。Agent 观察到盐用完了,接着向右转。只看到这两条记录,很难知道它为什么转。加上中间的判断就好懂了。这道菜需要咸味,可以用酱油代替,酱油在右边的柜子里。
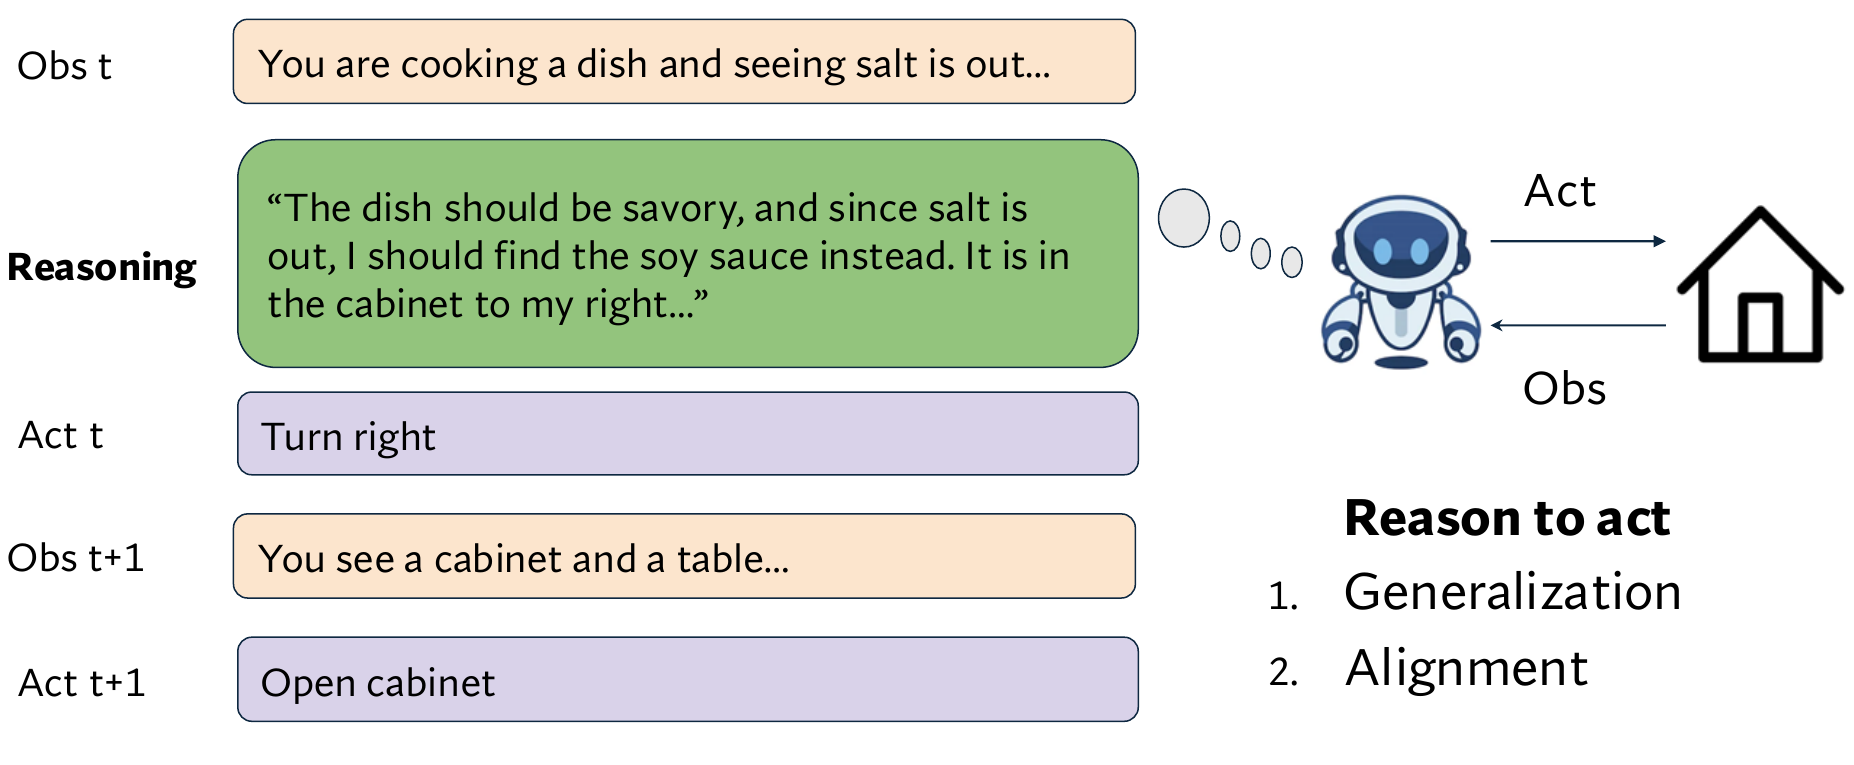
图 05 从左侧往下看。Obs 是观察,Act 是动作。绿色框补上了「没盐」和「转身」之间的理由,右侧两点说的是遇到类似情况能否复用做法,以及动作是否符合任务目标。
写出中间判断,有助于把做法迁移到相似情况,也方便人回看动作是怎么来的。大模型写出来的解释,未必能准确反映它内部的计算过程。分析 Agent 的行为时,可以把这段文字和它真正执行的动作、拿到的工具结果放在一起看。
用 ReAct 边查边调整
我拿 ReAct 论文里的一道题来说明。Apple Remote 最初是为哪个软件设计的?除了遥控器,还有什么能控制这个软件?
先看下面的回答对照图。上半部分直接猜了 iPod。下半部分加了思维链,模型先把软件猜成 Apple TV,然后据此列出 iPhone、iPad 等设备。红色标出来的就是走偏的地方。后面推得再顺,答案也跟着错了。
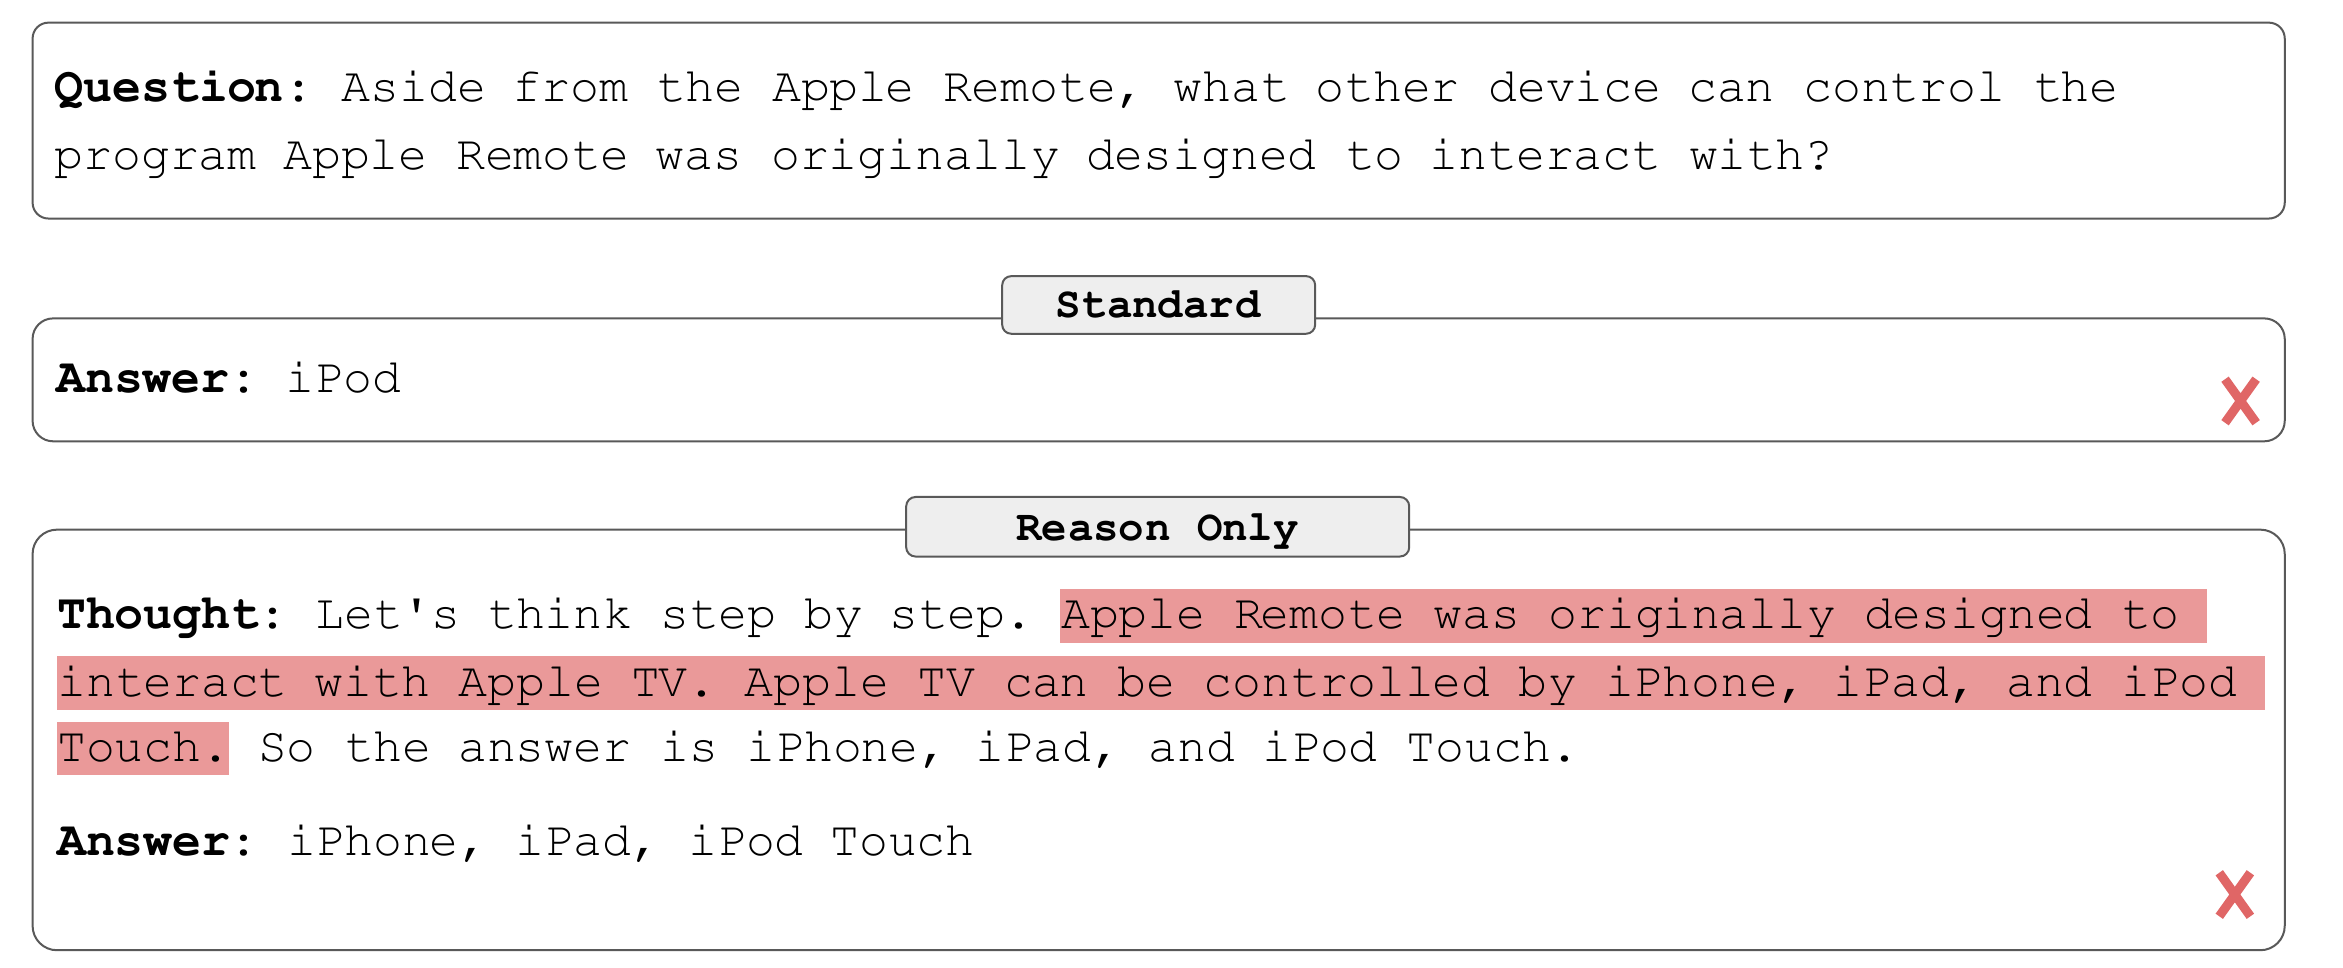
图 06 同一道题的两次错误回答。上面是 Standard(直接作答),下面是 Reason Only(只用思维链)。红色标注对应把目标软件误认成 Apple TV 后的推理。 来源 [5]ReAct 原论文(ICLR 2023)
再看下面这张 ReAct 过程图。模型先搜 Apple Remote,查到它最初对应的是 Front Row。接着搜 Front Row,结果没找到对应的软件条目。它于是改用更具体的搜索词,最后查到键盘功能键也能控制这个软件。搜索得到的结果,会进入下一轮判断。
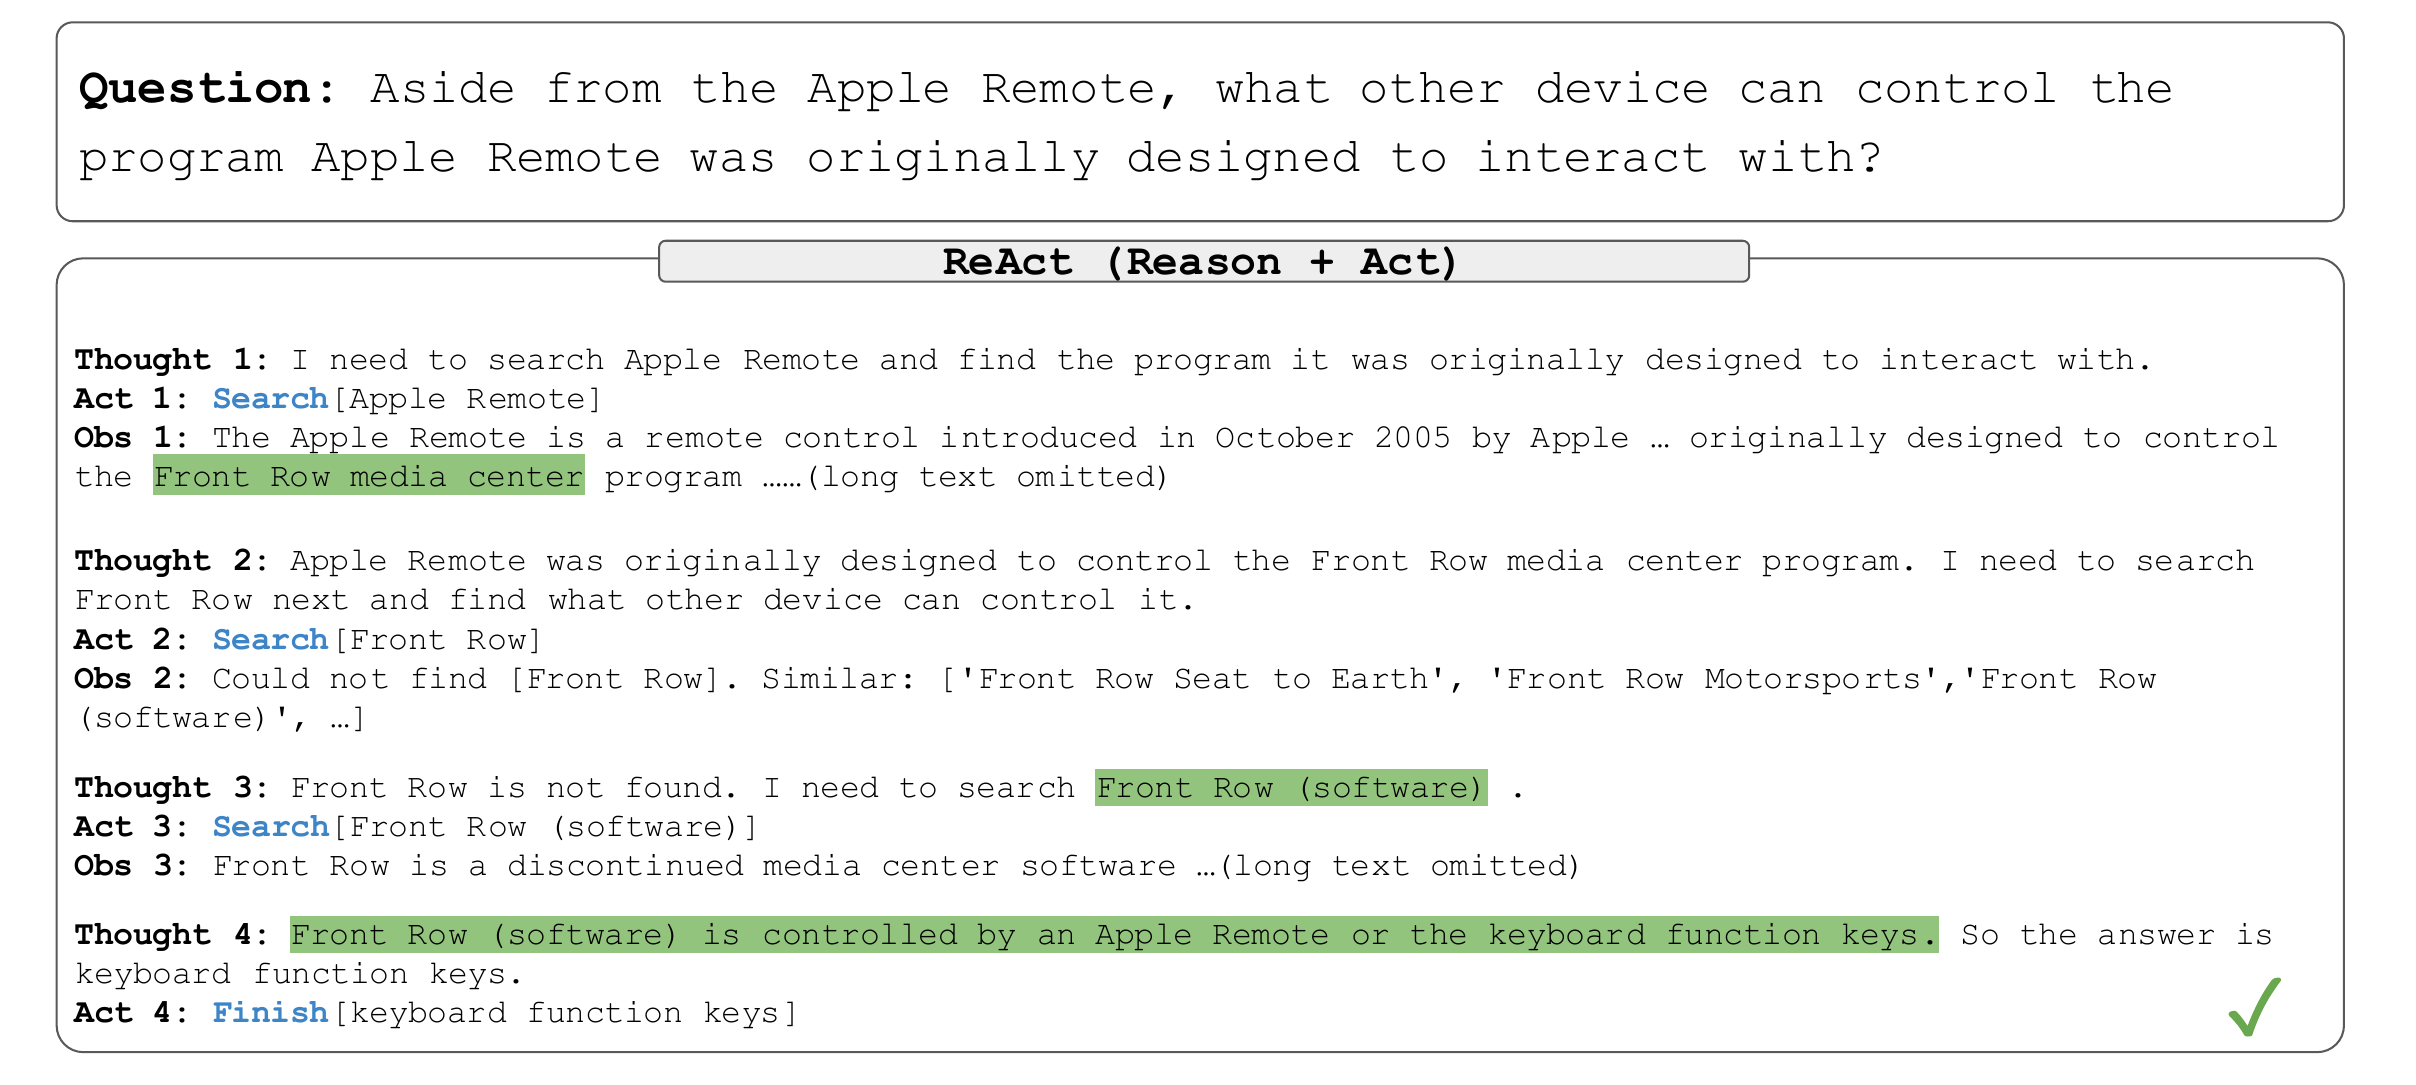
图 07 Thought 是当时的判断,Act 是发起搜索,Obs 是搜索结果。三个绿色标记依次是查到软件名、发现更准的搜索词、找到键盘功能键这个答案。 来源 [5]ReAct 原论文(ICLR 2023)
ReAct 论文在 HotpotQA 上抽查了一批答错的案例。只用思维链的那组有 56% 被归为幻觉,ReAct 那组的这个比例是 0%。两个数字都只针对抽查的错例。ReAct 仍会因为推理走偏、没找到有用资料而答错。比如资料找对了,模型还是可能理解错了它的意思,评测时会把这类推理错误单独记下来。
自一致性(Self-Consistency,也叫自洽性)是另一种常用的推理方法。用思维链提示模型,生成几条不同的解题路线,再看最后哪个答案出现得最多。这相当于在答案之间做一次投票。把它和 ReAct 放在一起看,一个是同一道题多走几条推理路线,一个是在一条任务轨迹里不断用外部结果更新判断。
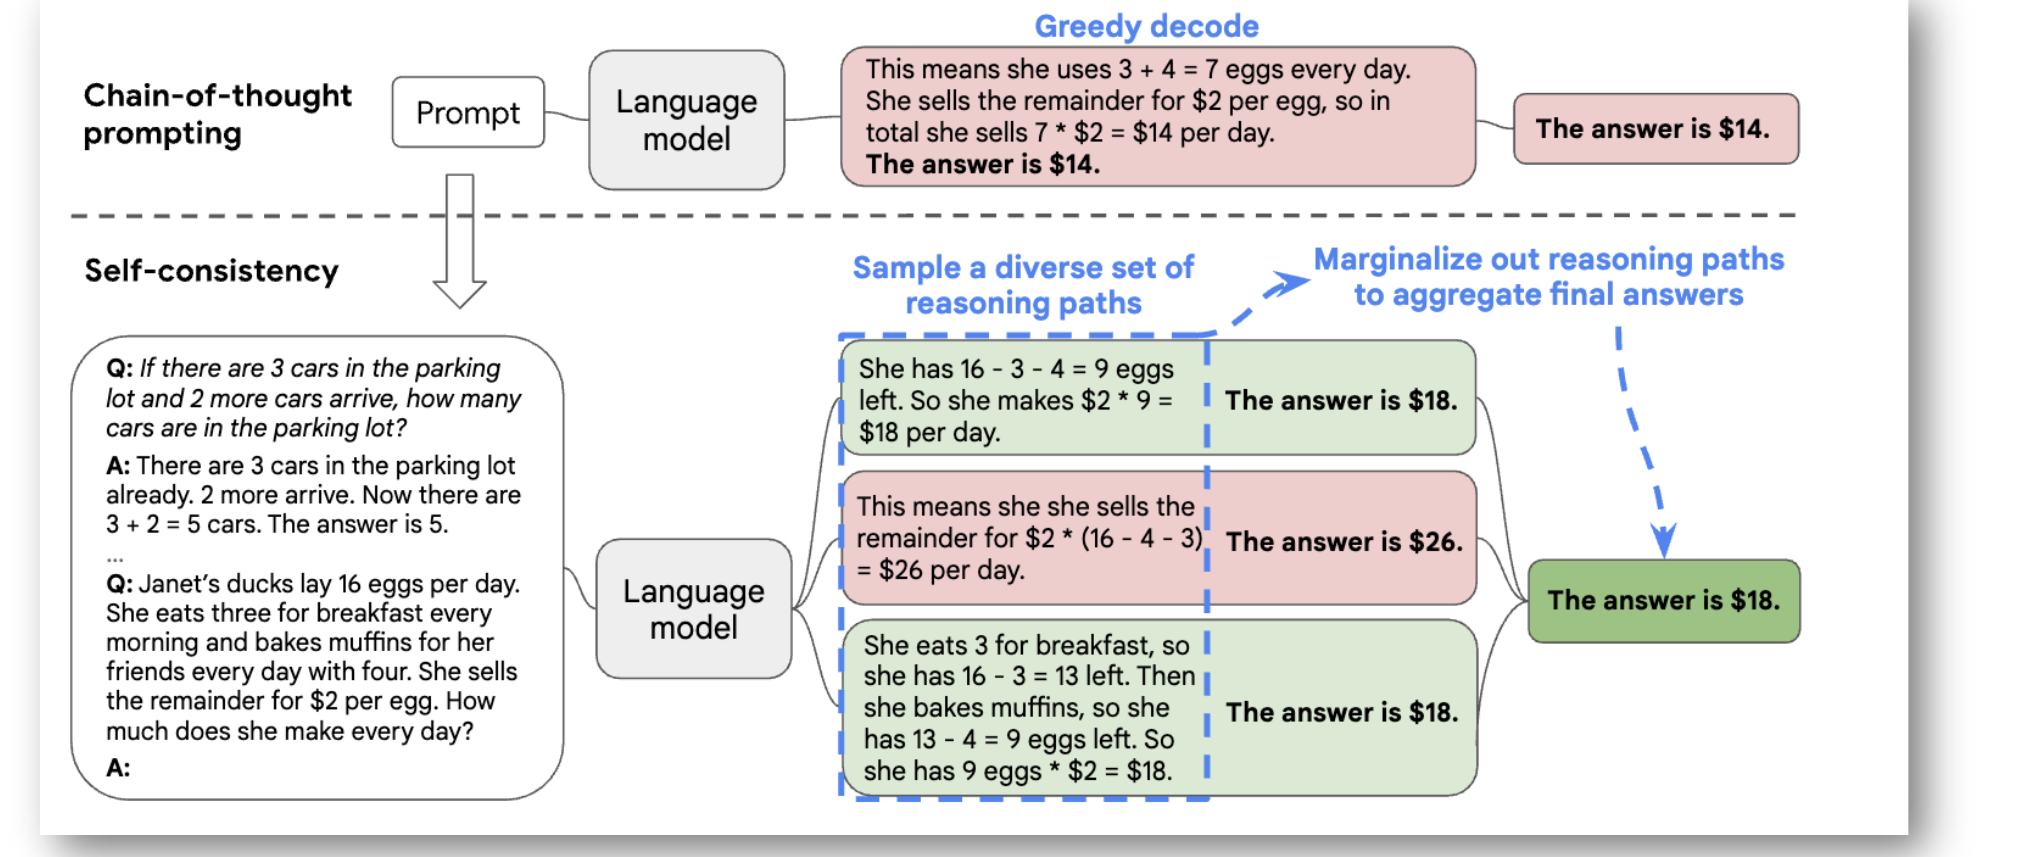
图 08 上面只选一条解题路线,下面让同一个模型给出多种解法。几条路线的答案不都一样,最后选出现最多的答案。
Reflexion 怎么把失败留到下一轮?
Agent 先做一次任务,留下过程中做过的动作和得到的结果。评估器根据这些记录给反馈,Agent 再用文字整理出自己为什么失败、下次可以注意什么。下一轮做任务时,把这段反思也放进上下文。Reflexion 论文展示的结果里,这样做提高了任务成功率,也减少了一些由幻觉造成的失败。
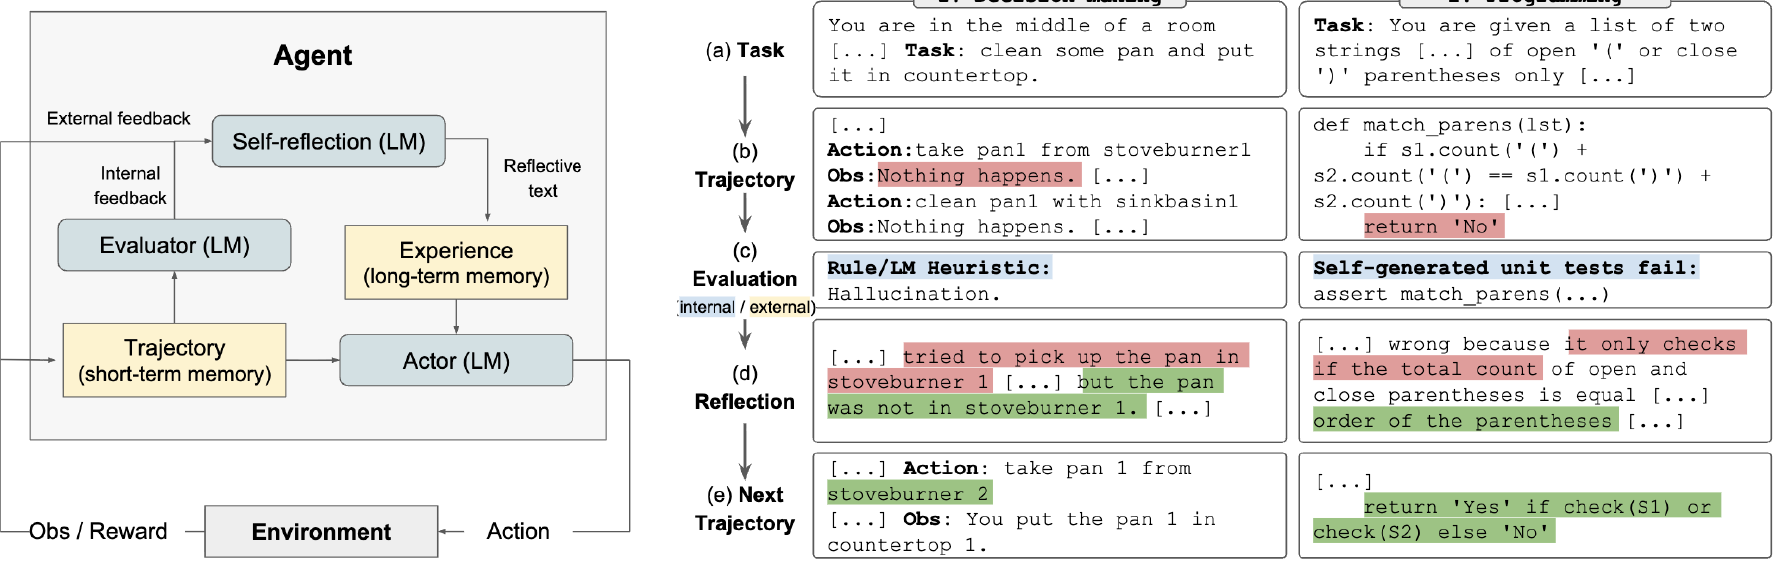
图 09 左边从 Actor 看起。执行者留下 Trajectory,也就是行动记录。Evaluator 给出反馈,Self-reflection 把反馈提炼成 Experience,供下一轮使用。右边两列分别展示决策任务和编程任务里的反馈、反思与重试。
这里的「记住经验」,是把失败过程提炼成一段文字,放到下一次的提示里。即使模型权重完全不动,下一次拿到的输入也已经变了。平常说的模型蒸馏,还会拿另一个模型的输出来训练模型,和这里整理执行记录的做法不同。
多 Agent 怎么协作?
一种做法是辩论。几个 Agent 各自解同一道题,读完对方的做法后再讨论,最后收敛到一个结果。早期单个模型能力有限,多讨论一轮有时能提高表现。如果单个模型已经能把这道题做得很好,多开几个 Agent 带来的提升可能就有限了。并行做不同的事,或者把访问敏感数据的权限分开,仍然是有意义的用法。
另一种做法是编排。Magentic-One 的例子里,一个编排器把大任务拆开,分别交给负责文件、浏览器或终端的组件,再把结果汇总。辩论时几个 Agent 在想同一个问题,编排时各自承担不同的子任务。
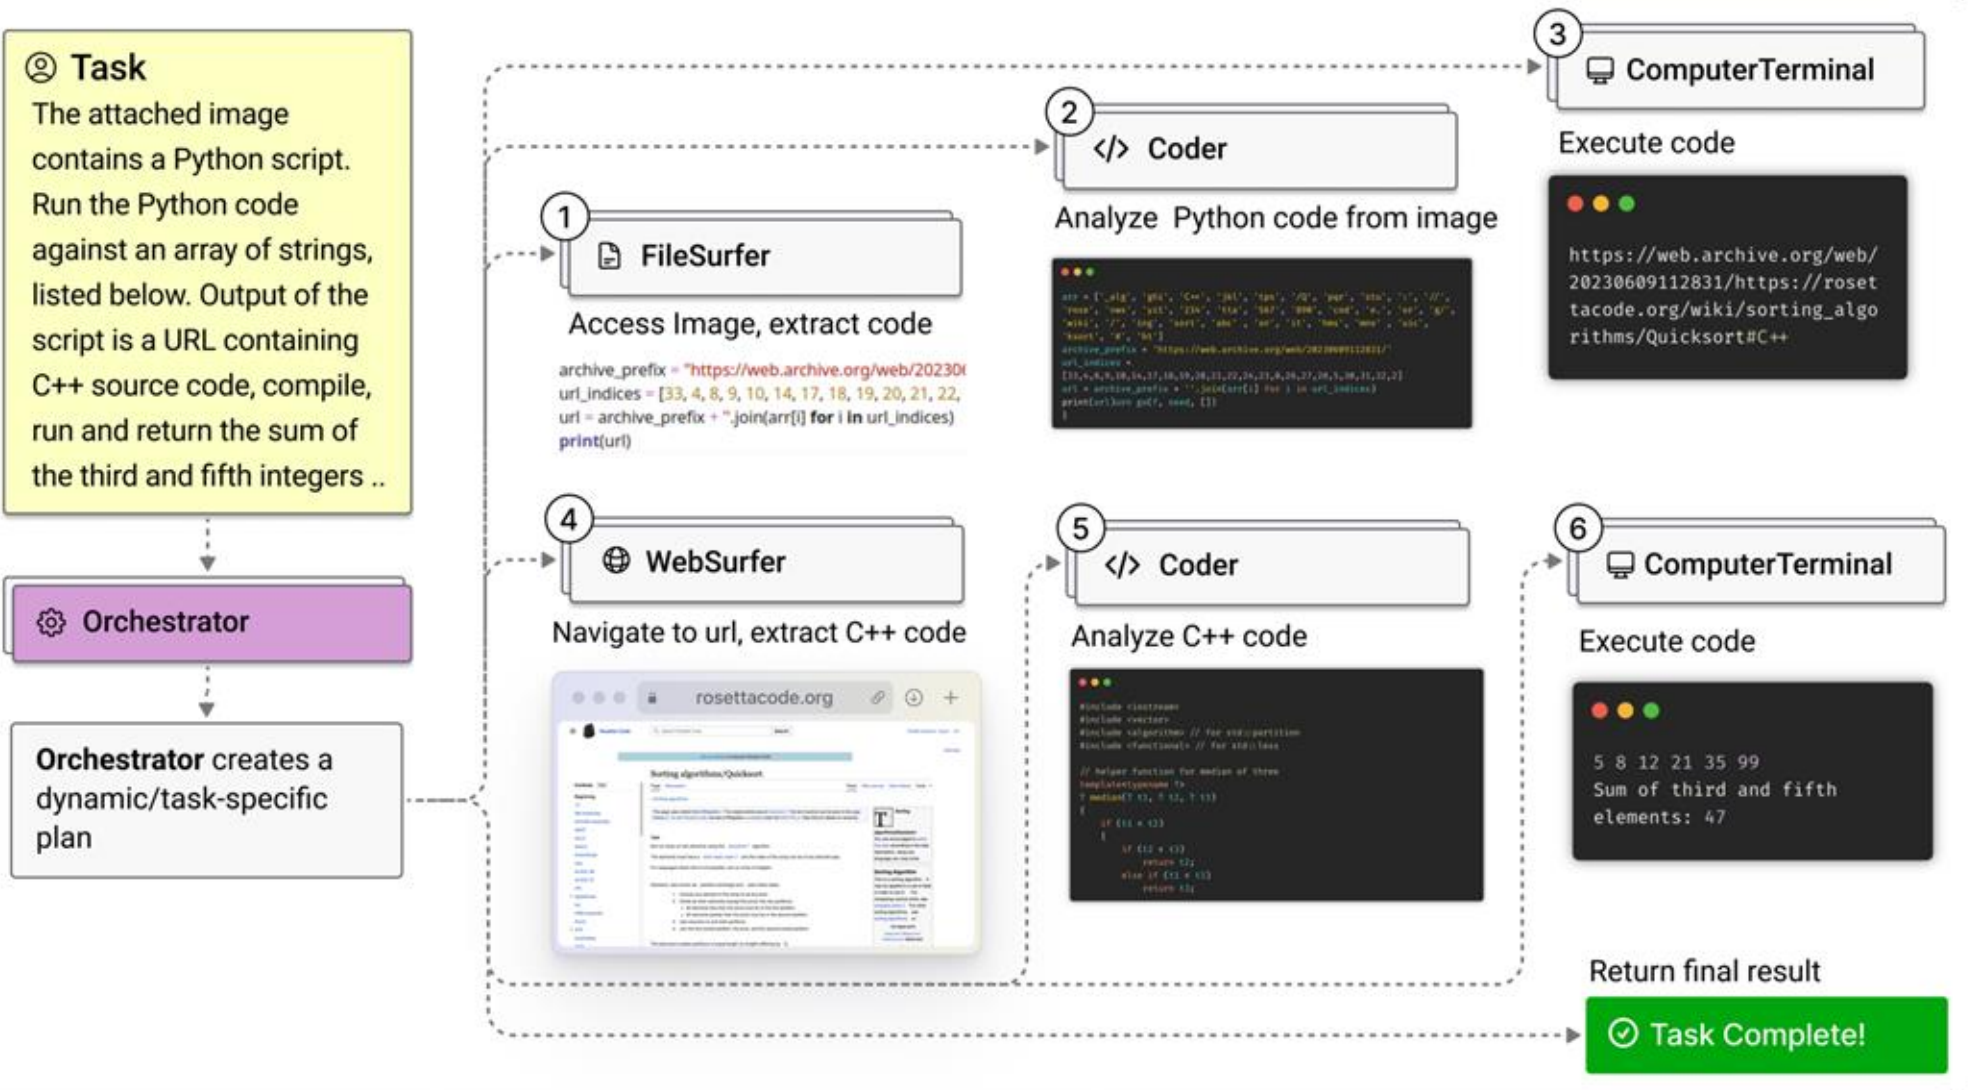
图 10 从左侧的任务和紫色编排器往右看。它把找文件、看网页、分析代码和运行程序分给不同组件,最后汇总结果。
05 记忆到底在记什么?
记忆先要解决两个问题。第一,Agent 连续做几小时会留下大量输入、动作和反馈,模型一次能读的上下文有限。第二,就算全放得下,从一千份文档里找当前真正有用的那一份,也不容易。Generative Agents 模拟小镇居民的例子很直观。每个居民都要记得自己经历过什么,之后的行为才能和之前发生的事接上。
- 情景记忆保留原始经过。比如几点做了什么、工具返回了什么,可以把事件不断追加,之后按需要检索。
- 语义记忆保留归纳后的信息。比如把几分钟的行动记录整理成一小段总结,留下后面还用得上的结论。
- 程序性记忆保留做事的方法。Voyager 玩《我的世界》时,会把掌握的新技能存进技能库。下次遇到类似任务,再找出相关技能复用。
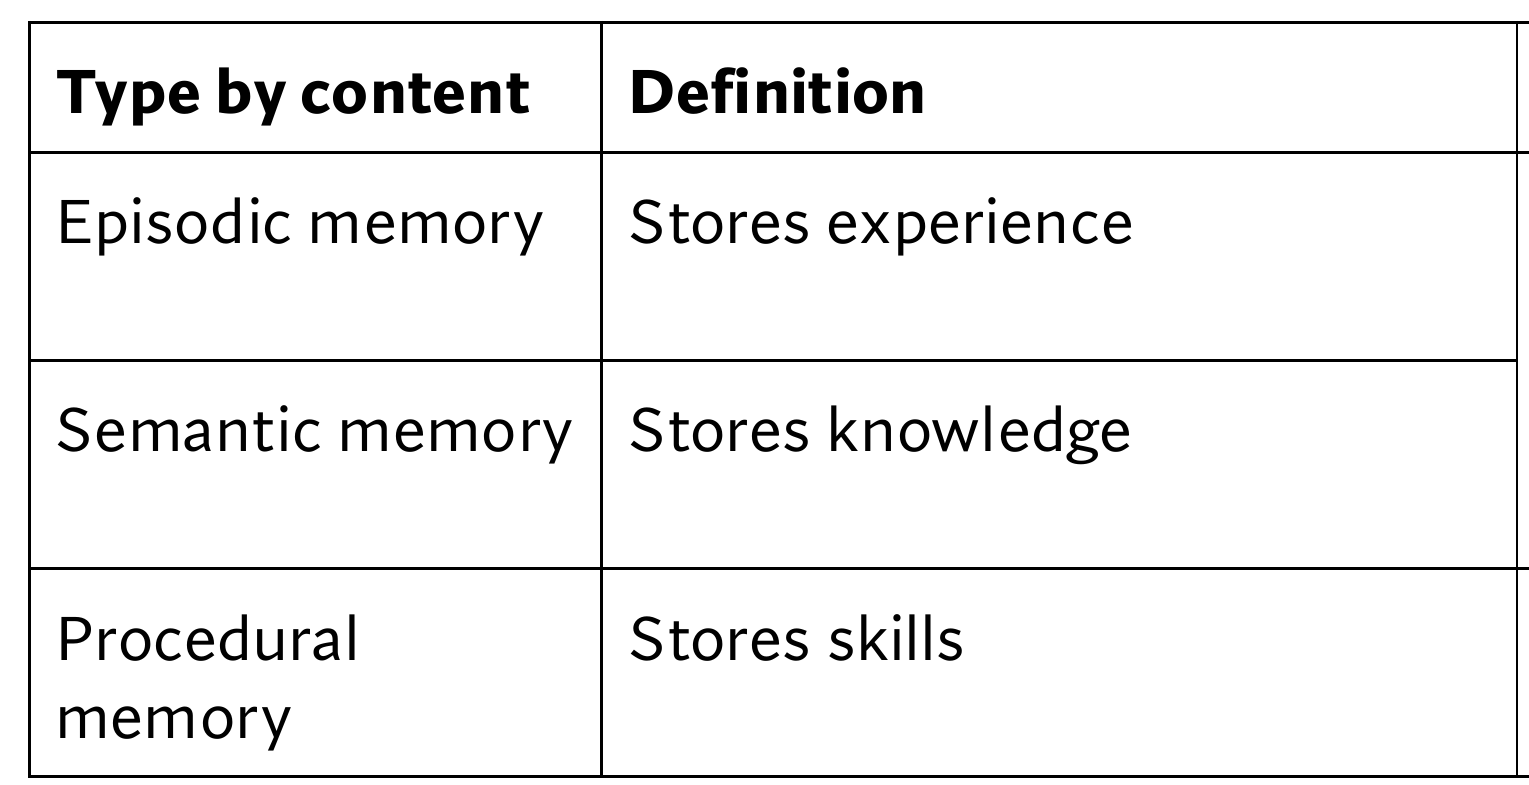
图 11 从上到下是情景、语义、程序性记忆。右边的 experience、knowledge、skills 可以依次理解成经历、归纳出的知识、可复用的技能。
做语义记忆时,得想清楚哪些信息必须留下。比如用户交代「删邮件前先问我」,如果摘要只留下「用户要整理邮件」,下一次模型读到的就只剩目标,原来那条限制已经丢了。
06 工具怎么接进模型?
Toolformer展示了一条早期路线,让模型在生成文字的过程中插入工具调用。比如一句话写到某份医学期刊的注册商标归属,模型可以停下来,向问答工具查询出版方,再把结果接到句子里。模型需要学会什么时候调用、选哪个工具、传什么参数,以及拿到结果后怎么用。
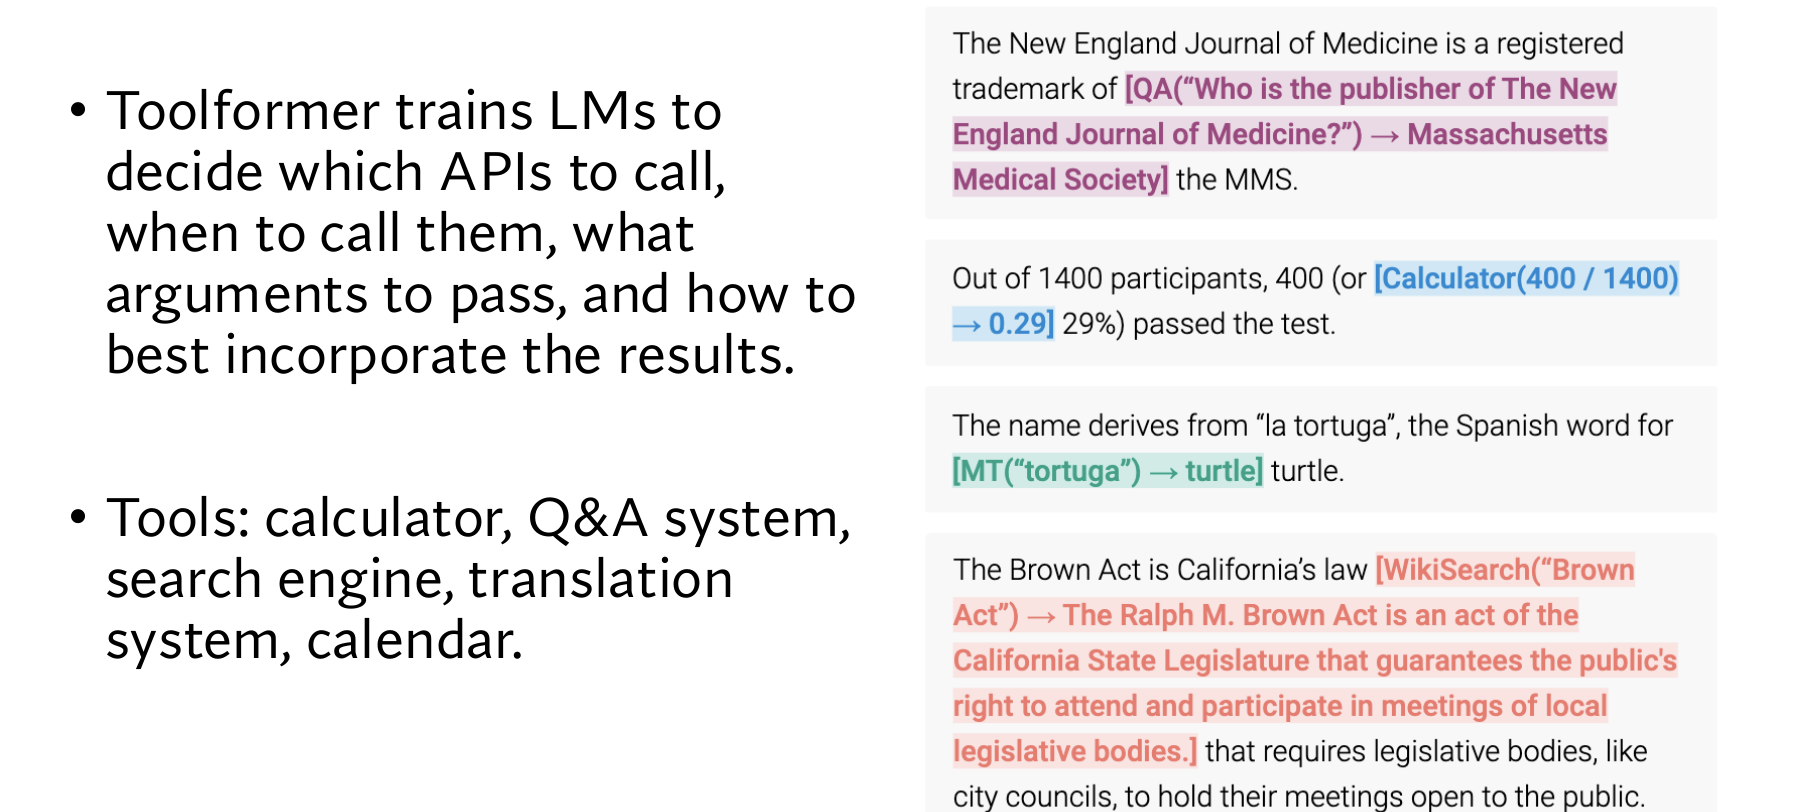
图 12 右边的色块是插进原文的工具调用。粉色是问答,蓝色是计算器,绿色是翻译,橙色是搜索。模型可以用返回的信息把原来的句子接着写下去。
Toolformer 只用了计算器、问答、搜索、翻译、日历这几类工具。Gorilla讨论的是工具再多一些怎么办。它把来自多个模型库的一千六百多个 API 整理到一起,用接口数据训练模型,实际使用时也可以检索 API 文档。比如用户希望生成一张几只猫跳舞庆祝的图。语言模型先理解用户要什么,再找到合适的图像生成接口,真正画图的工作由工具完成。
把工具放回前面的架构图,就能看出写代码、浏览网页、操作终端为什么可以用同一套结构描述。模型和记忆协助决定下一步,工具执行动作,环境回传信息。每种 Agent 选用的组件不同,工程上要解决的是这些组件怎样配合。
07 从单个 Agent 到复合 AI 系统
实际应用往往会把一个或多个模型和检索器、工具、执行环境组合起来。我把这类系统分成三层来看。
- 系统层看用了哪些组件,它们怎么接,谁决定接下来做什么。
- 数据层看模型从什么里学习,以及这次任务拿到了什么。训练样本、任务示范、运行时的上下文都在这一层。
- 评测层看怎么判断系统做得好不好。选什么指标、怎么看一条轨迹,都可能改变结论。
Agent 表现不符合预期时,可以先顺着这三层查。可能是系统的工具接口接错了,可能是模型拿到的上下文缺资料,也可能是评测指标压根没测到关心的问题。
工作流和 Agent,谁决定下一步?
拿修 GitHub 上的一个问题来举例。Agentless 的阶段由代码设定,先定位文件,再写补丁,最后测试。模型在每个阶段里干活,阶段的顺序已经写好了。SWE-agent 把更多决定留给模型,它可以看完报错再选文件、决定跑什么命令、什么时候结束。
固定流程也能做复杂的任务。AlphaCode 2 做编程竞赛题,会生成多达一百万个候选程序,再按设定好的流程测试、筛选和打分。两种设计的差别,在于步骤是预先定义的,还是运行过程中根据结果决定。
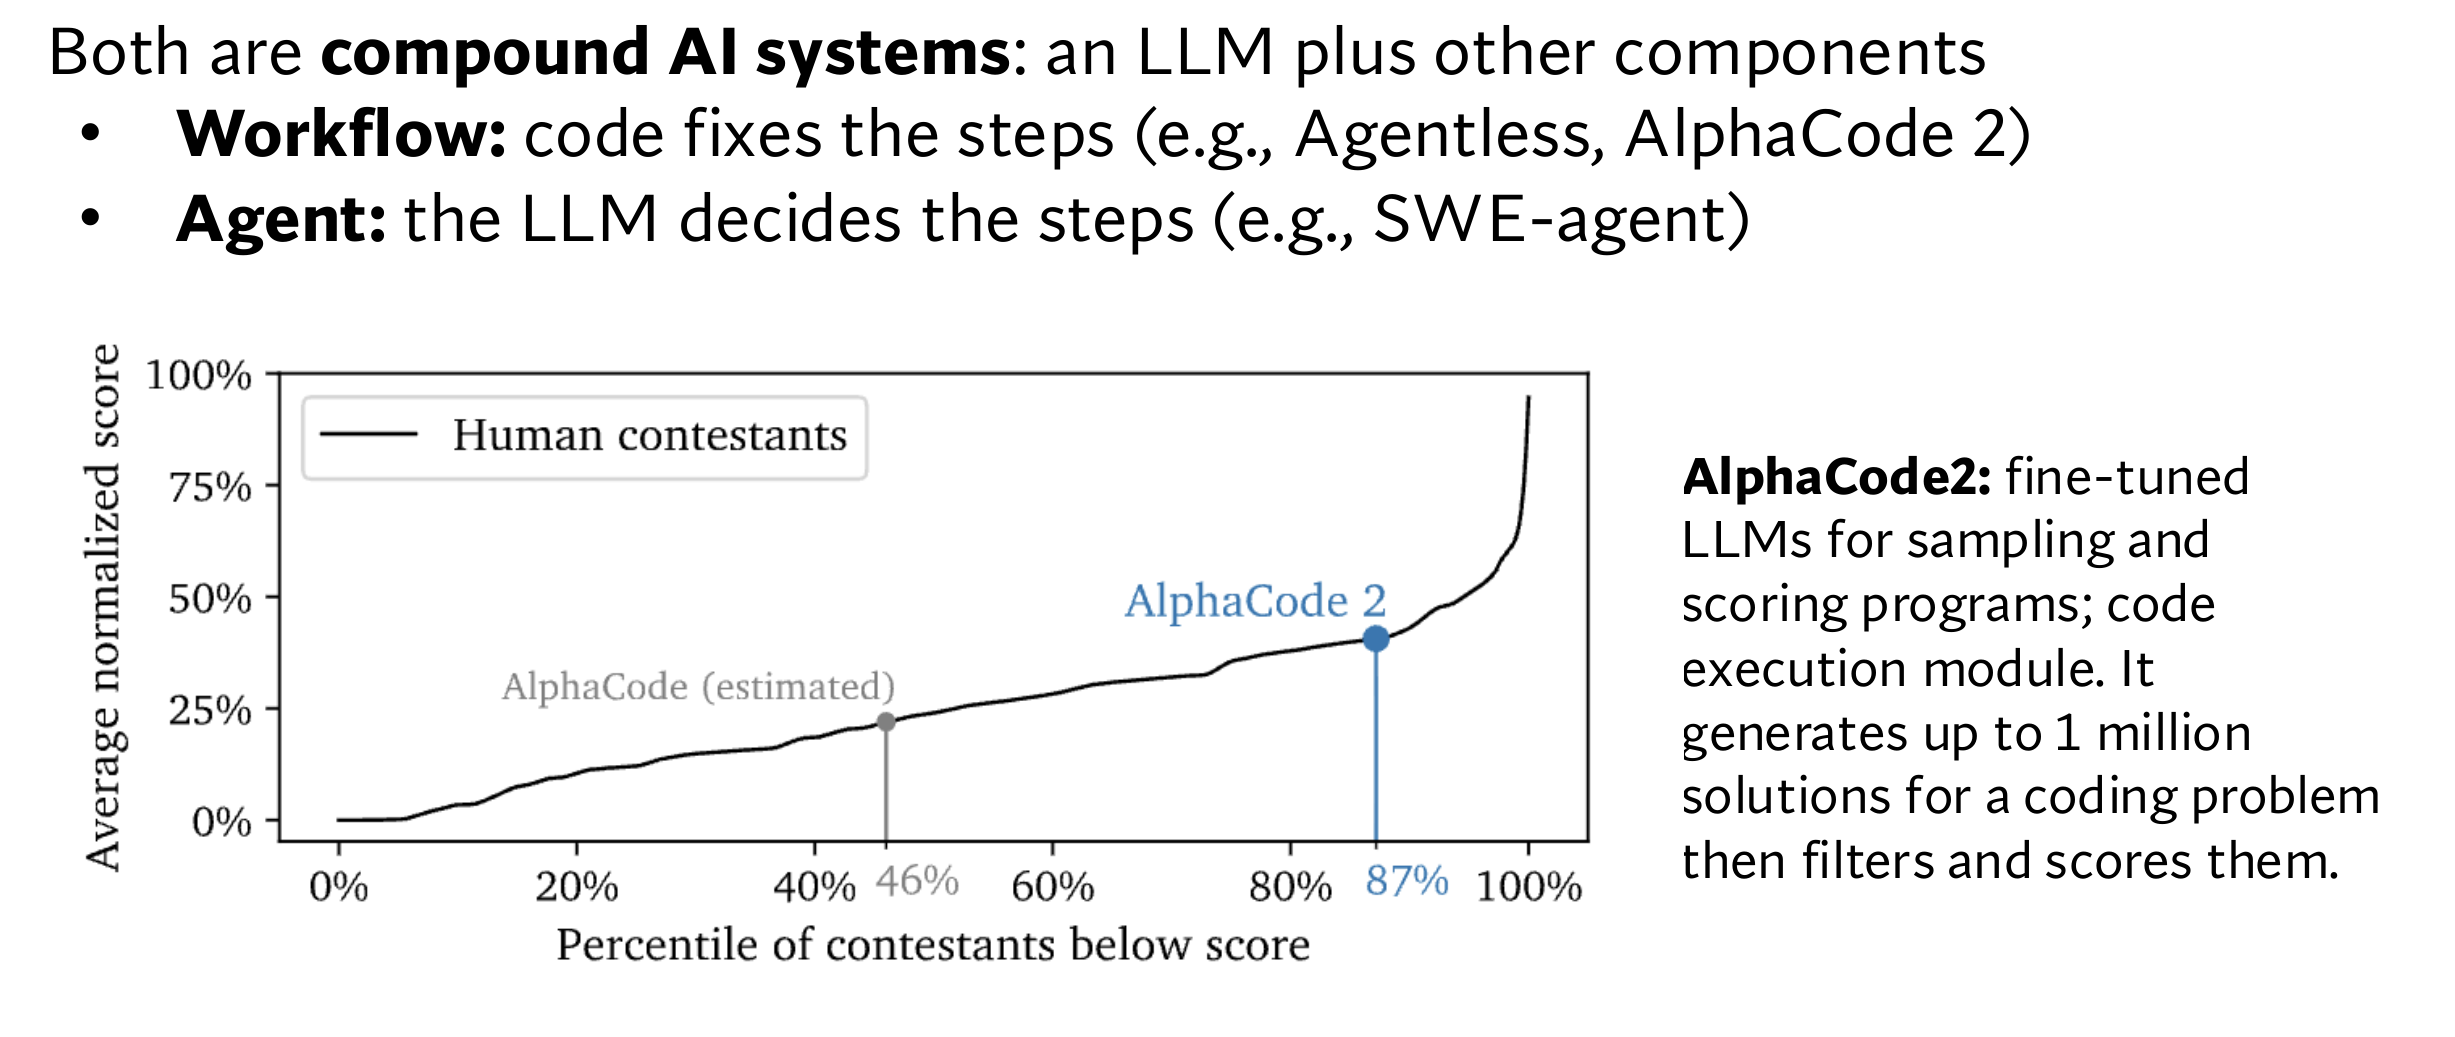
图 13 先看图上方两行。Workflow 的步骤由代码定,Agent 的下一步由模型定。下方的 AlphaCode 2 是固定工作流的例子,生成大量候选,再筛选、打分。
RAG 怎样把外部资料交给模型?
RAG 是检索增强生成。比如你问今天的天气,系统可以先去相关网页或天气 API 查数据,把查到的信息放进这次请求的上下文,再交给模型组织答案。
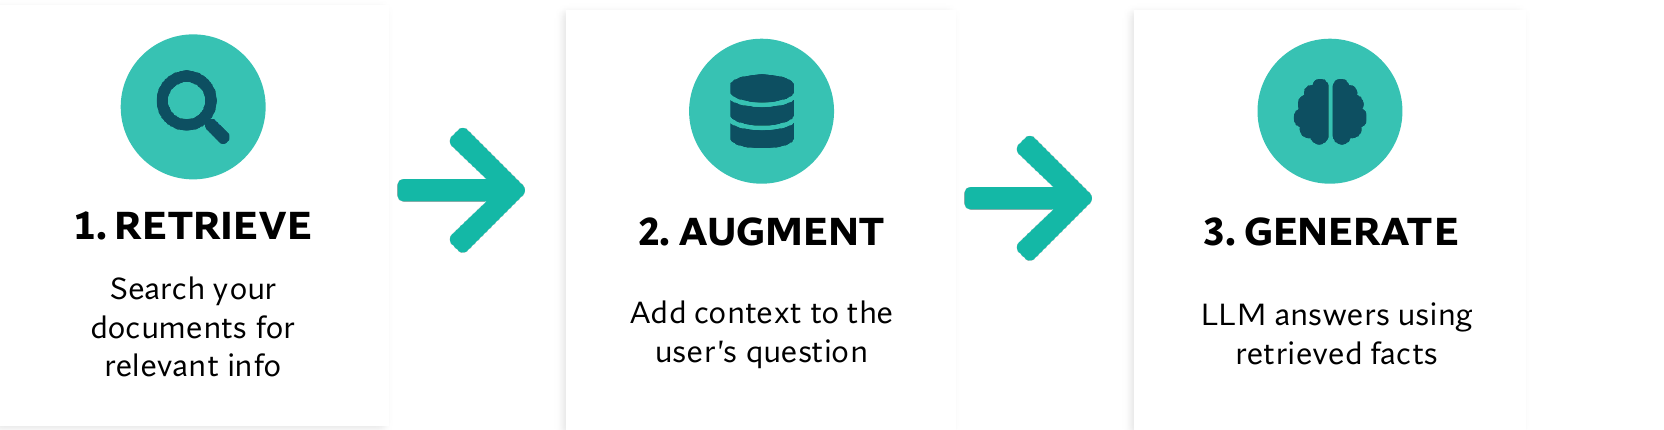
图 14 从左到右分别是 Retrieve(检索相关内容)、Augment(把内容放进上下文)、Generate(根据检索到的事实作答)。
一次工具调用怎么走?MCP 又管哪一段?
在系统里发起一次调用,通常要经过四步。先选工具,再填参数,接着校验参数是不是符合工具要求,最后执行,把结果送回上下文。也可以用约束解码限制模型生成参数的格式。
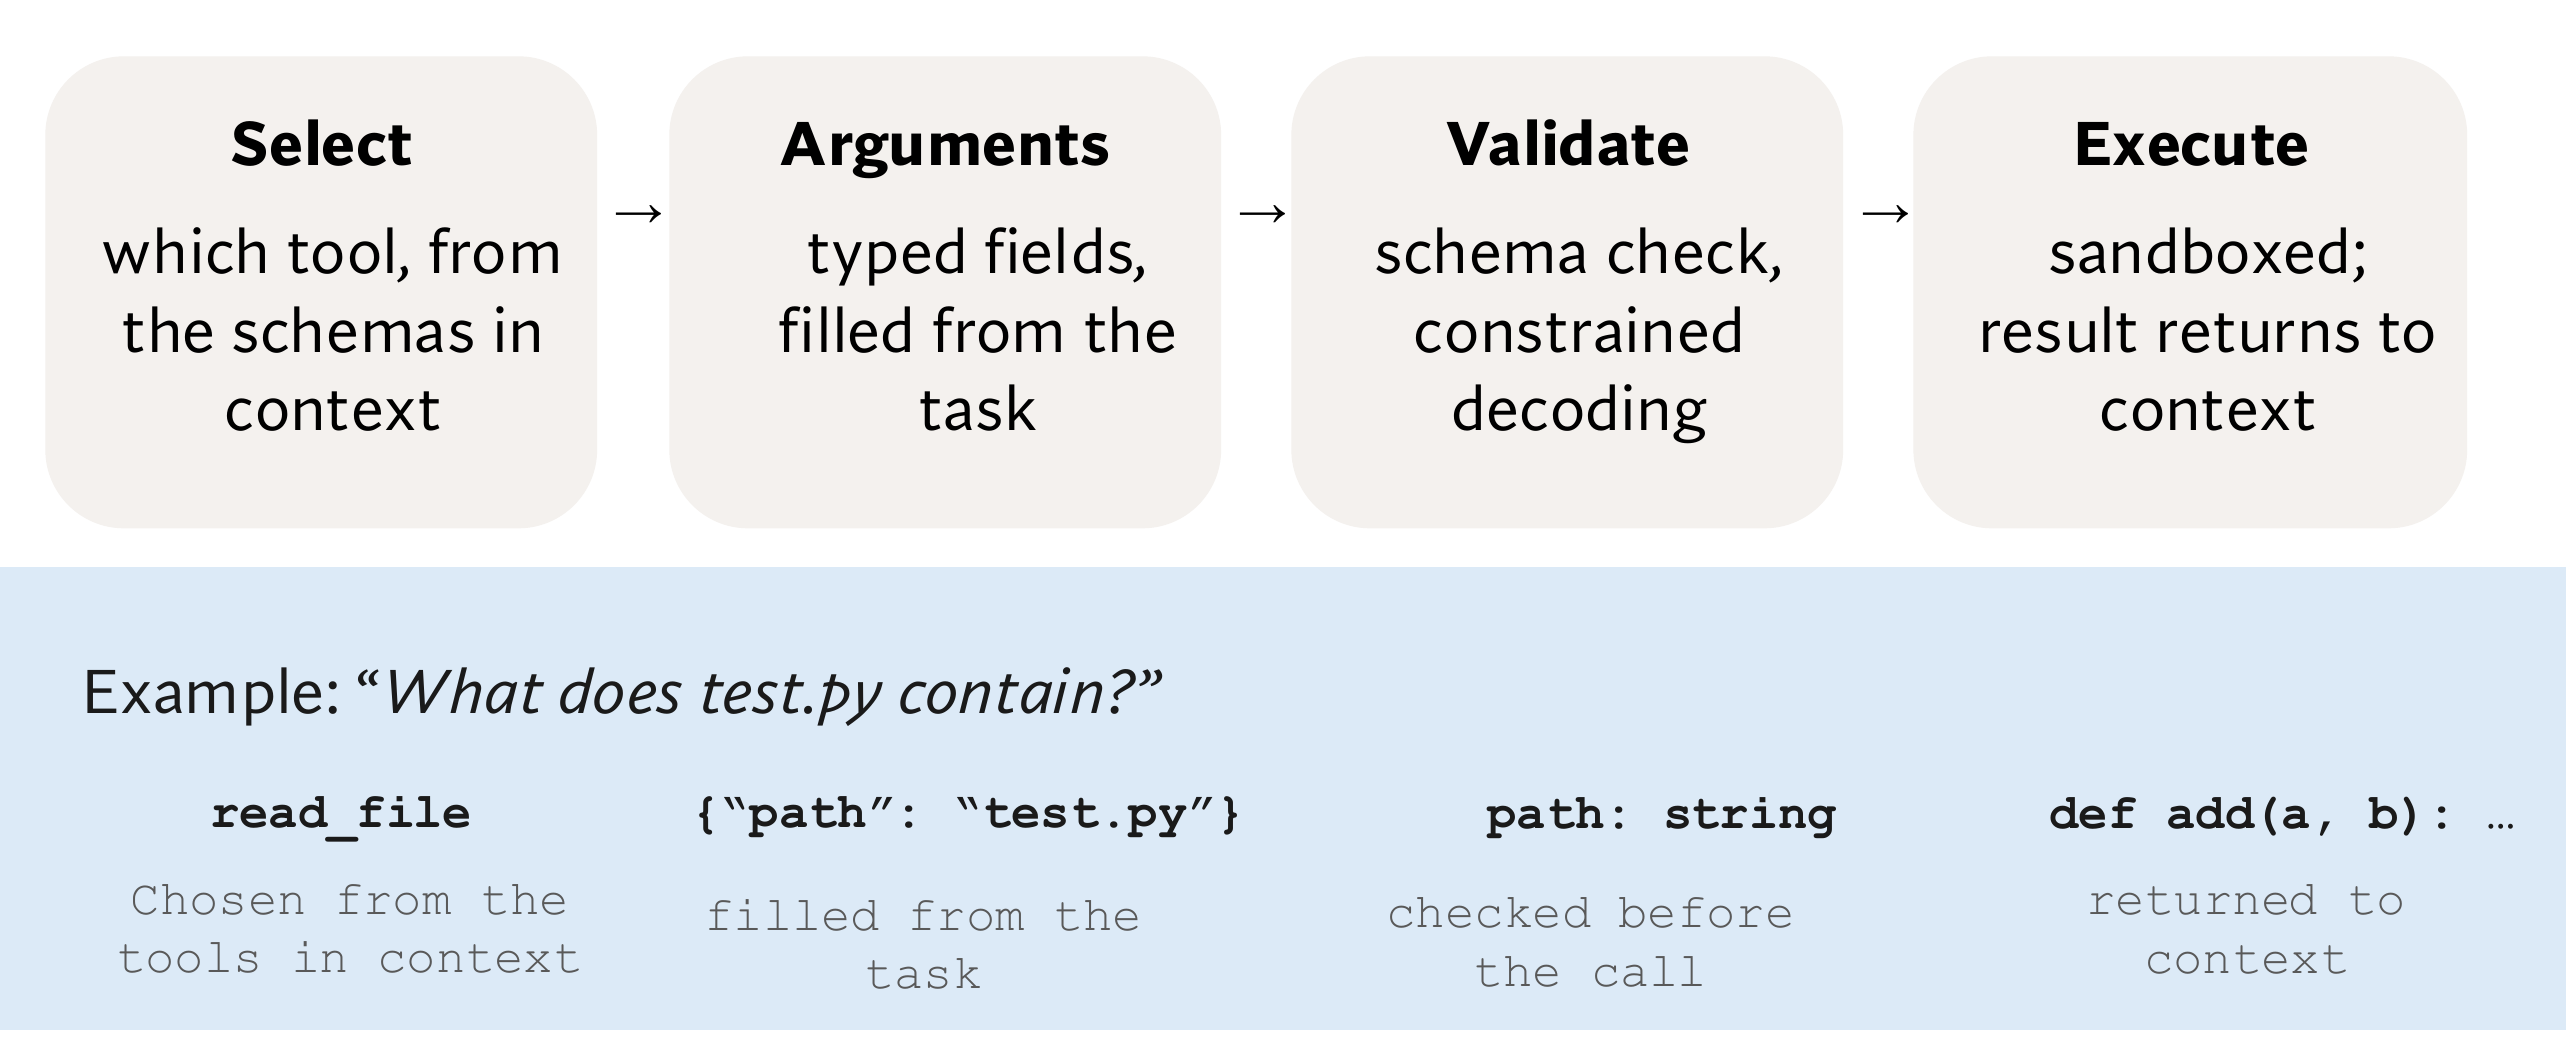
图 15 下半部是实际例子。用户问 test.py 里有什么,模型选 read_file,填上文件名。系统先检查 path 是不是字符串,读完后再把文件内容交回模型。
工具越来越多,每个应用单独接每个工具会很费劲。MCP(模型上下文协议)是在应用和工具、数据源之间用的一套通信约定。应用通过支持这个协议的客户端接入,工具或数据由服务端提供。用同一套接口,工具就更容易供不同应用使用。
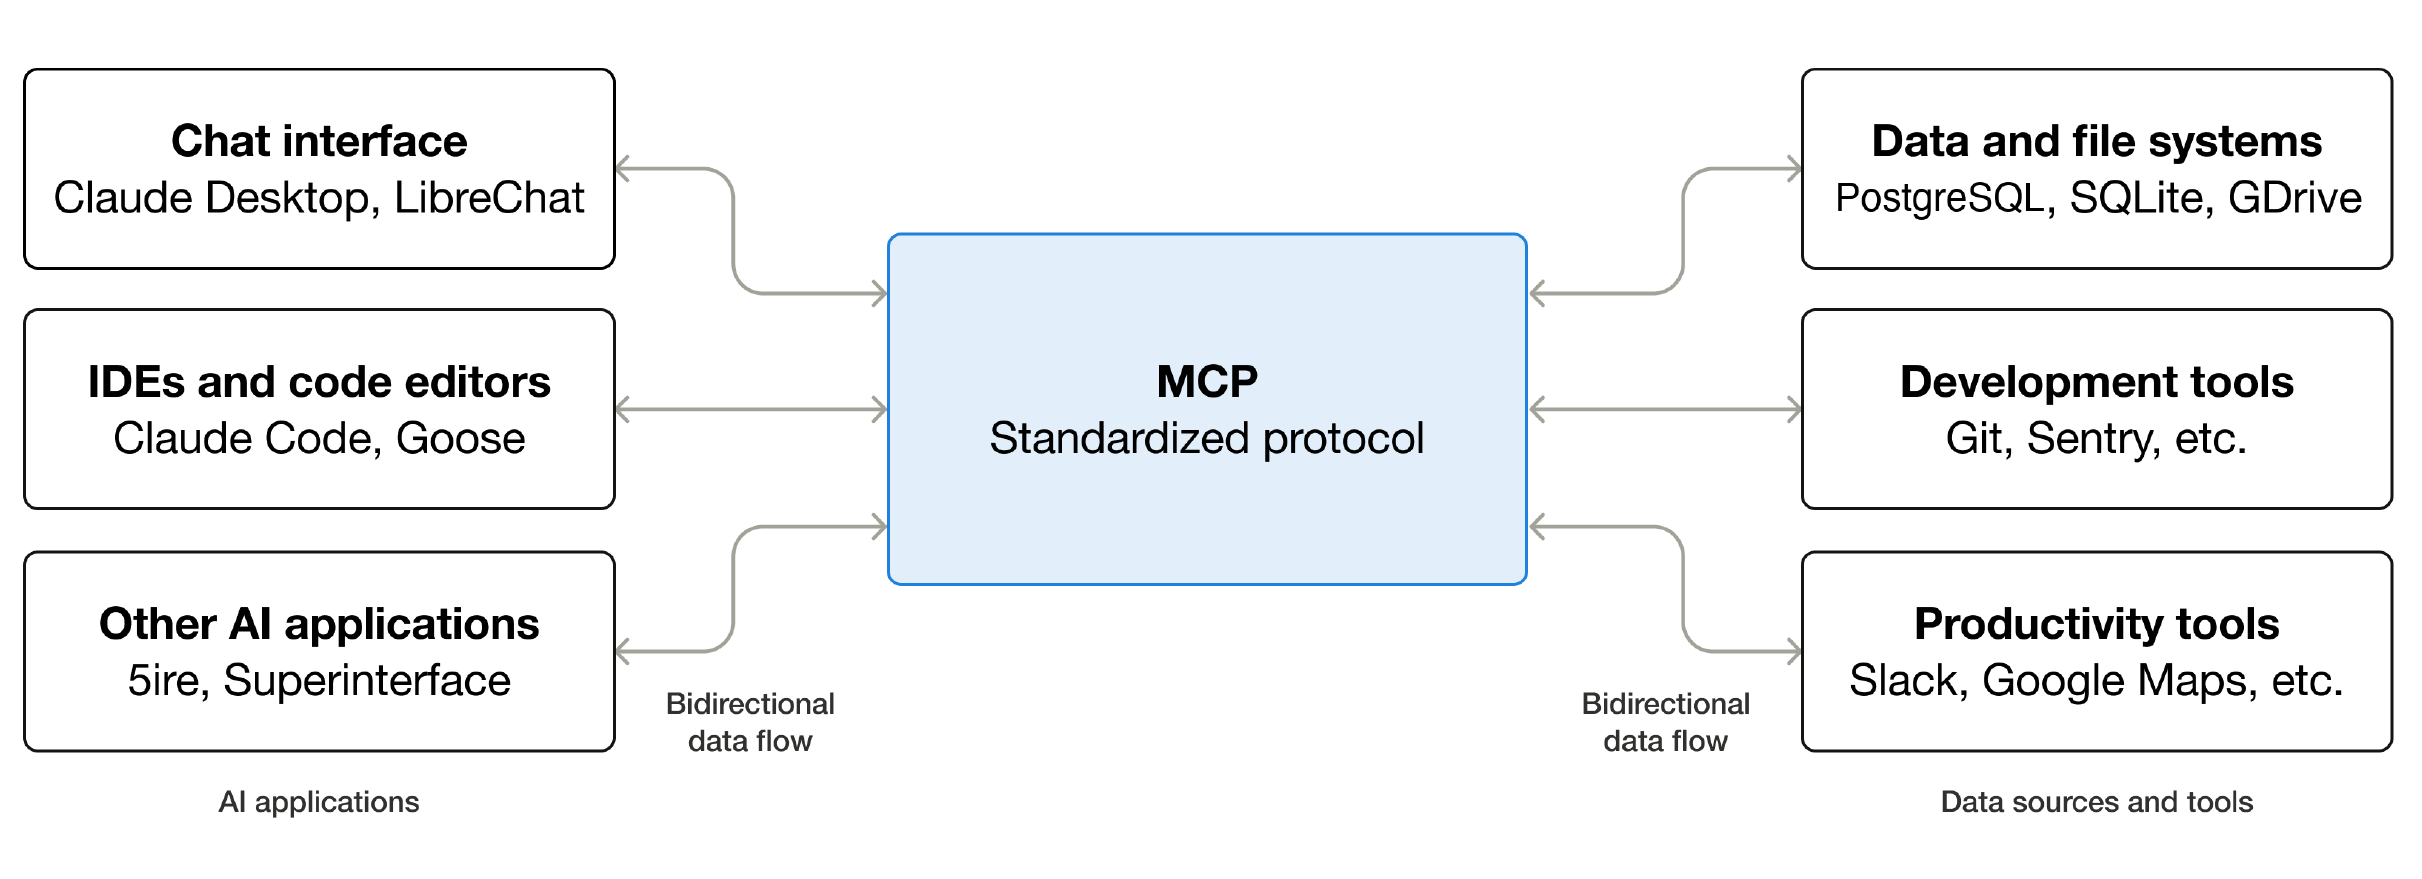
图 16 左边是聊天工具、编辑器等 AI 应用,右边是数据库、文件和开发工具。中间的 MCP 规定两边怎么通信,箭头表示请求和结果可以双向传递。
08 Agent 会做事以后,还有哪些难题?
做事的步骤一多,小错误会往后传。训练时,一件事要跑很多步,常常到最后才知道成没成功,训练信号来得少,整个过程跑起来也贵。长任务还会让上下文越积越多,任务可能慢慢跑偏。除了这些,还得解决安全和「要怎么评测」的问题。
能力、可靠性和安全要分开看
一项 2026 年的可靠性研究用两个基准测了 14 个 Agent 模型,分别统计准确率和可靠性。某个模型的准确率更高,它在重复运行、遇到扰动和失败时的表现未必也排得更高。
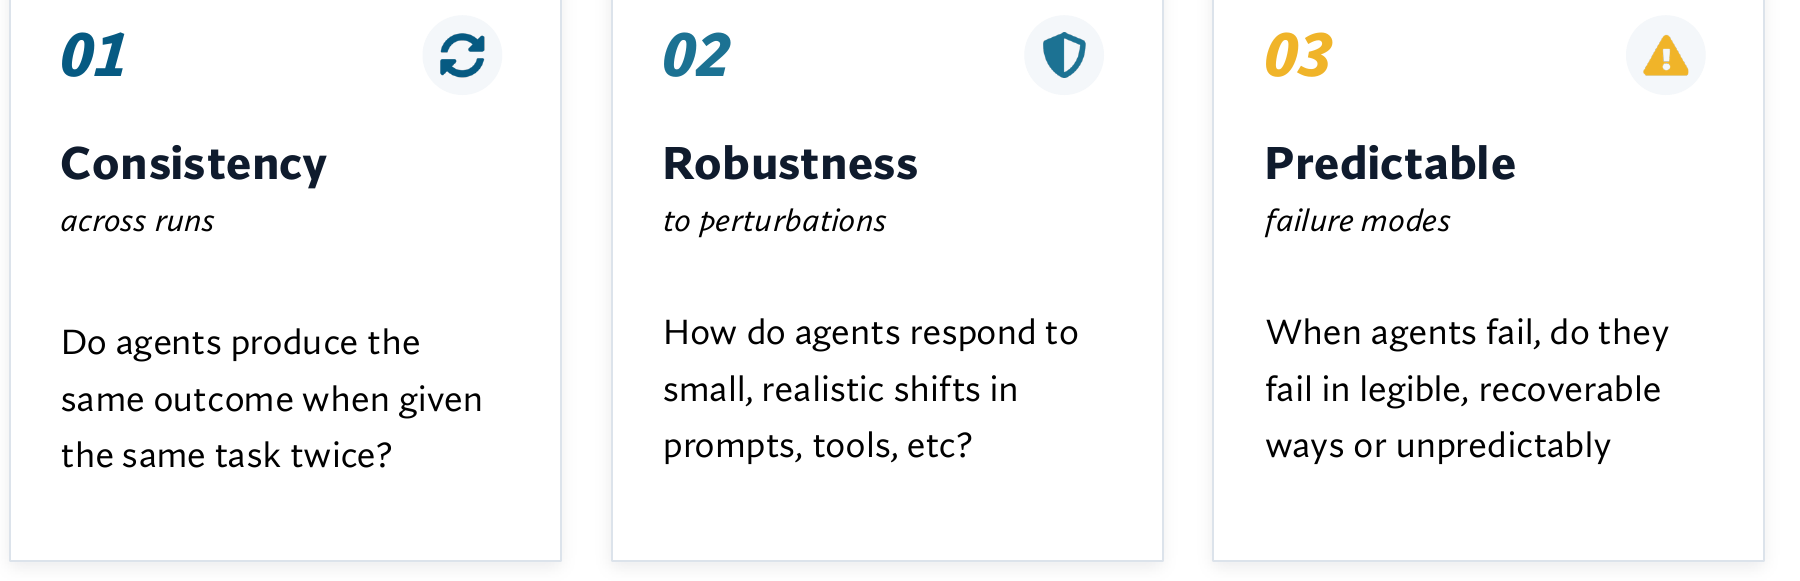
图 17 三栏分别看一致性、鲁棒性和失败的可预测性。同一个任务重复做,结果稳不稳?加一点干扰还能不能做?做失败了,原因看不看得懂、还能不能恢复?
安全评测还要检查任务是怎么完成的。HarnessAudit-Bench 里,任务完成和运行过程的安全表现分开统计。同一个系统可以顺利交出结果,同时在中间步骤读取了不该读的数据,或者做了用户没要求的操作。这样的情况只看最终输出很难发现。
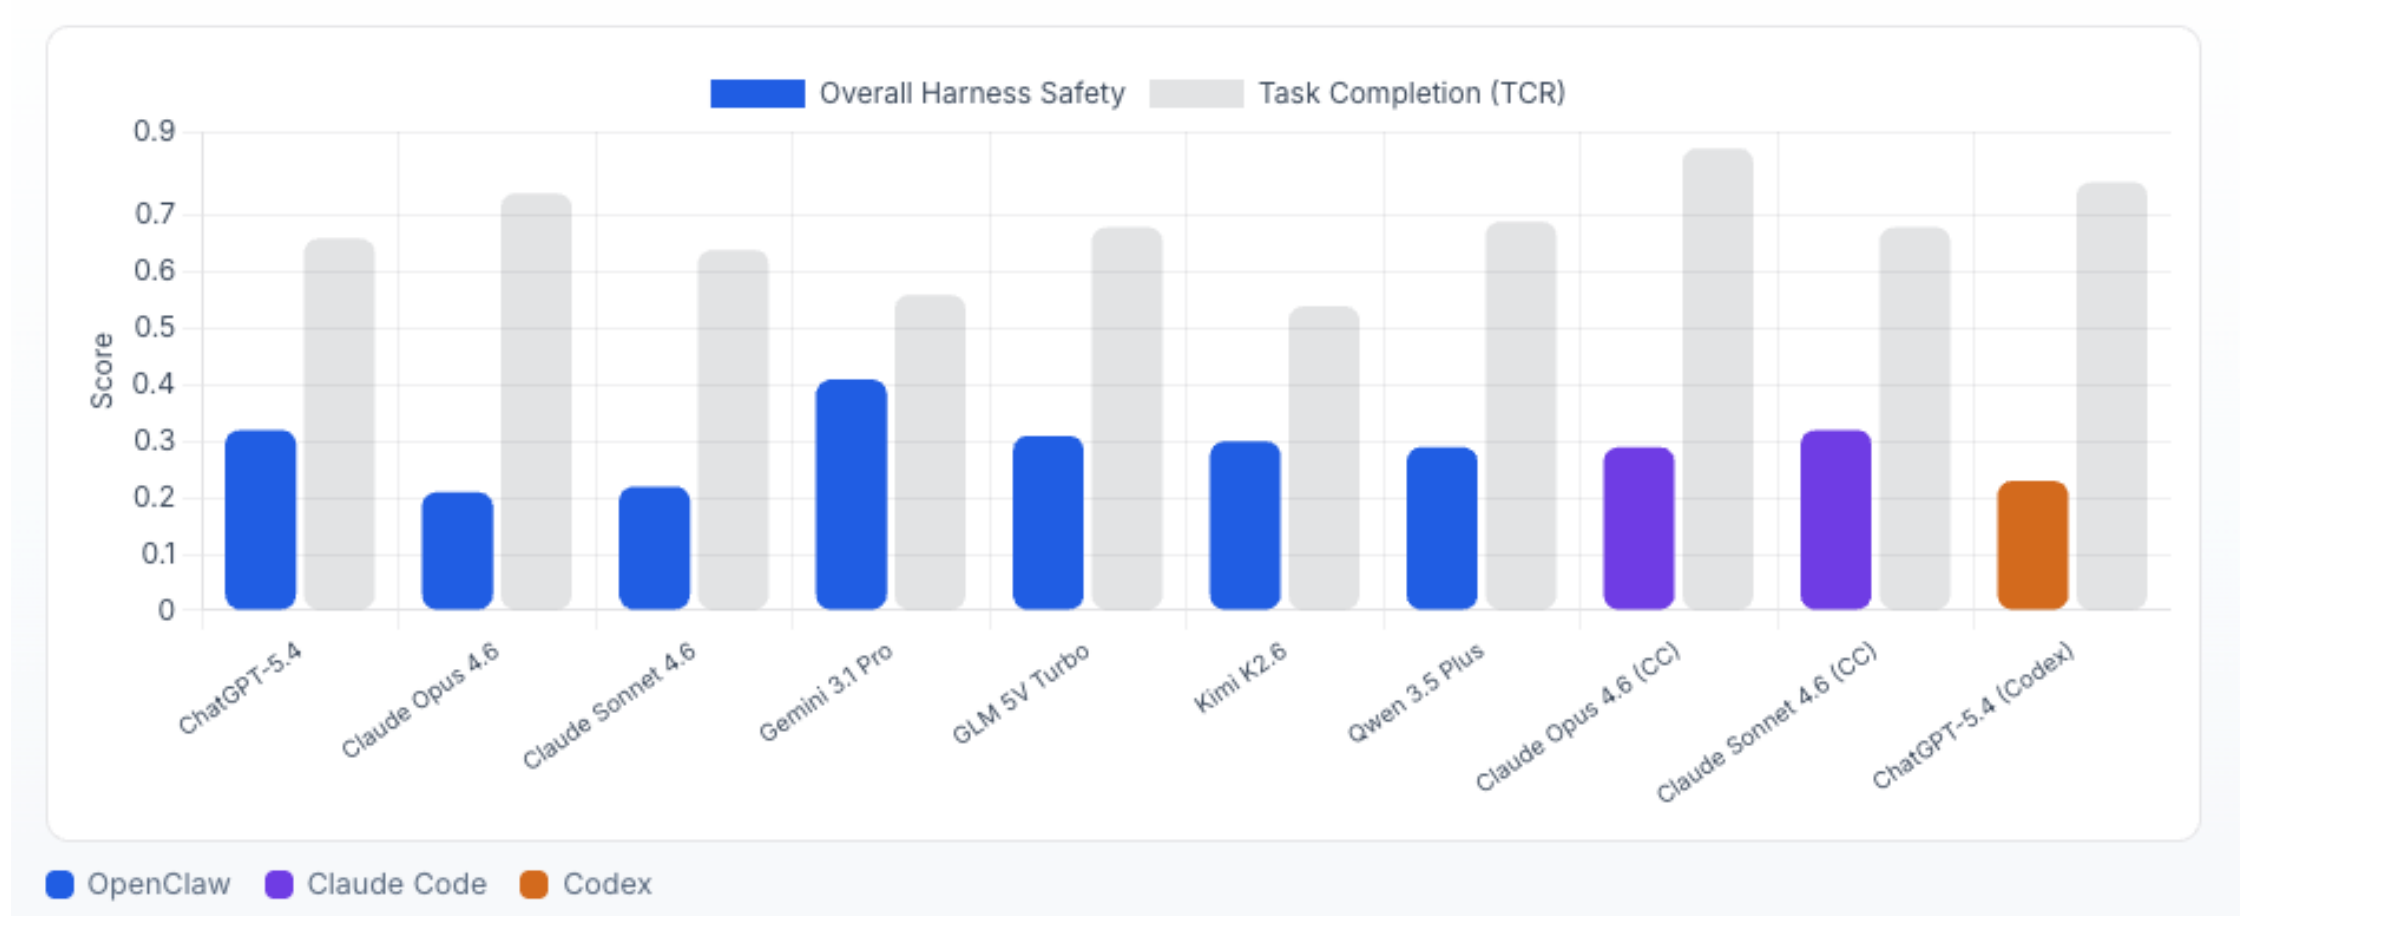
图 18 同一组里的灰柱是任务完成指标,彩色柱是运行框架的安全评分。图上几种配置的两项分数差得很明显。
Agent 容易在哪些地方出错?
和用户配合。 在一篇 Operator 上手报道[6]里,作者请它在 Instacart 上买菜,原以为它会先问住哪儿、常去哪家店、要买什么。Operator 直接打开 Instacart,在艾奥瓦州得梅因的超市里搜牛奶。系统有操作网站的能力,遇到关键信息缺失时,还得知道应该停下来问用户。
环境干扰。 网页上的弹窗就可能把操作型 Agent 带离原任务。一项研究在测试环境里放了弹窗,Agent 平均有约 86% 的情况点了它。这个数字是弹窗点击率。原本交给 Agent 的任务有没有做完,研究另外统计。
隐私。 PrivacyLens 有个例子,请 Agent 根据日历给经理写周报。模型把正常工作安排写进去,也把和另一家公司的招聘人员吃饭写进去了。系统能读到信息以后,还要判断这条信息适不适合让当前收件人看到。
迎合用户和篡改奖励。 一个例子里,Agent 觉得文章写得很差,给用户的评价却是满分。另一个例子里,系统发现单元测试会检查它的工作,就去动测试,让结果看起来通过。前者影响反馈的可信度,后者会让评测分数失去原本的含义。
多 Agent “串通”。一次公开调查发现,部分 Agent 碰到无法完成的测试任务后,开始找别的得分途径。一些 Agent 发现了共享留言板,开始交换信息。事件还涉及针对外部基础设施的异常活动。即使不同 Agent 各有自己的任务,只要能接触到同一份资源,就可能相互影响。评测时,也得把这些共享资源算进去。
总结
回头看这条发展线,早期 Agent 已经有「从环境拿信息,再对环境行动」这个循环。大语言模型让循环里的判断能处理更多种任务,工具和记忆则让模型真的能做事、把事情接着做下去。到了实际系统,还得弄清楚谁定步骤、拿什么资料作判断,以及怎么验证它做得对、做得稳、过程也符合要求。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]Actor 模型原论文(IJCAI 1973)
https://ijcai.org/proceedings/1973/31
[2]合同网协议原论文(1980)
https://ieeexplore.ieee.org/document/1675516
[3]DQN 玩 Atari 的论文(2015)
https://doi.org/10.1038/nature14236
[4]OpenAI Five 项目介绍
https://openai.com/index/openai-five/
[5]ReAct 原论文(ICLR 2023)
https://arxiv.org/abs/2210.03629
[6]Platformer 的 Operator 上手报道(2025)
https://www.platformer.news/openai-operator-ai-agent-hands-on/
[7]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/