TechGuide「AI Agent 面试专题」第 2 篇 · 大模型与上下文工程
正文约 4600 字 · 预计阅读 10 分钟
大家好,我是声哥。
上一篇聊了 Agent 怎么决定下一步。这篇接着看做决定的模型。同一个 Agent,换个模型为什么速度就变了?明明给了一堆资料,它为什么还会漏掉最关键的一段?我从模型怎么选下一个 token 讲起。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
01 大模型是怎么选下一个 token 的?
语言模型做的一件基本工作,是在给定前文时,为下一个 token 算出一组概率。Token 是模型读写文本的基本单位,可以是一个词、一段词,也可以是标点。一整句文本出现的概率,可以拆成每一步条件概率连乘。句子一长,大家口头说的「模型给这句话打分」,背后就是这一串预测。
这也解释了语言模型为什么能生成文本。分类模型通常在给定标签里做选择,生成式语言模型可以从词表里逐个选 token,再把选出来的内容接到前文后面,继续算下一步。模型输出的是一组分数,经过 softmax 转成概率,接下来还得有个规则选词。
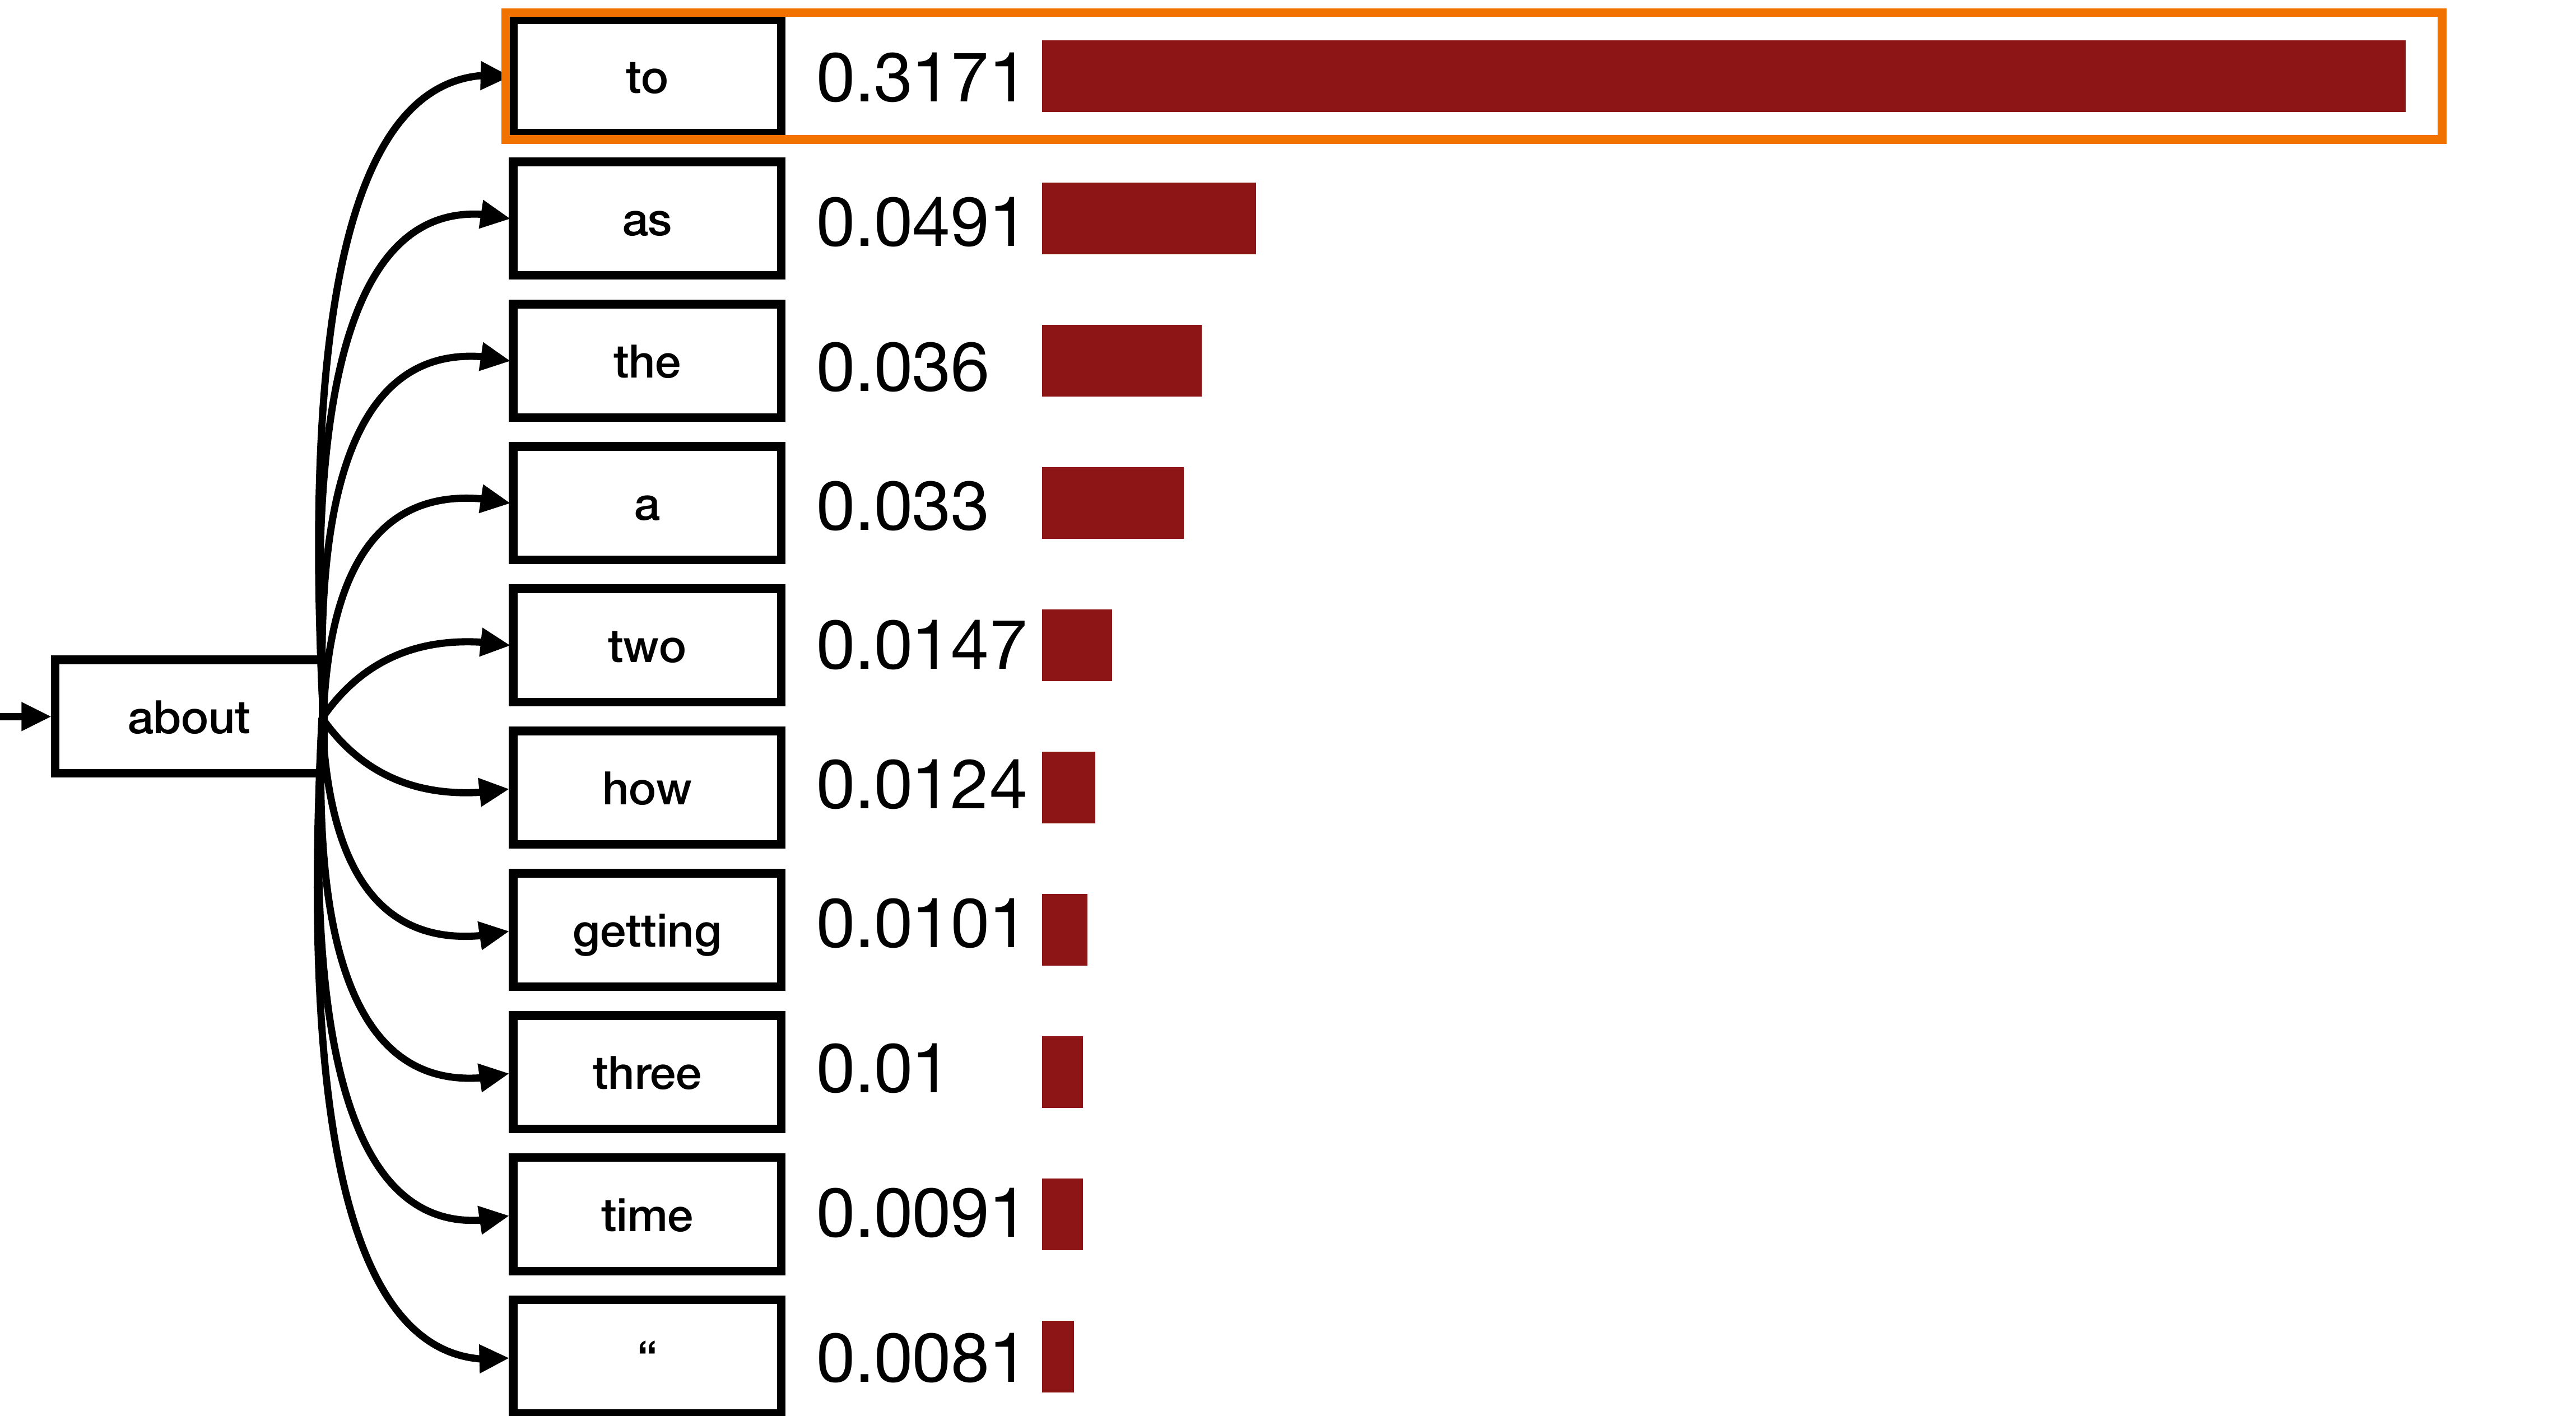
图 01 图中给出了同一个前缀后的一组候选。最上面的 to 概率最高,下面的 how 也有概率。实际选哪一个,要看解码方式。
贪心解码每步拿概率最高的词,简单直接。随机采样按分布抽取,概率大也只是更容易抽到。调温度就是在调这组概率有多集中。实现上是先把 softmax 之前的分数,也叫 logits,除以温度,再做 softmax。温度低时,高分候选更容易压过其他候选。温度高时,低分候选也有更多机会。
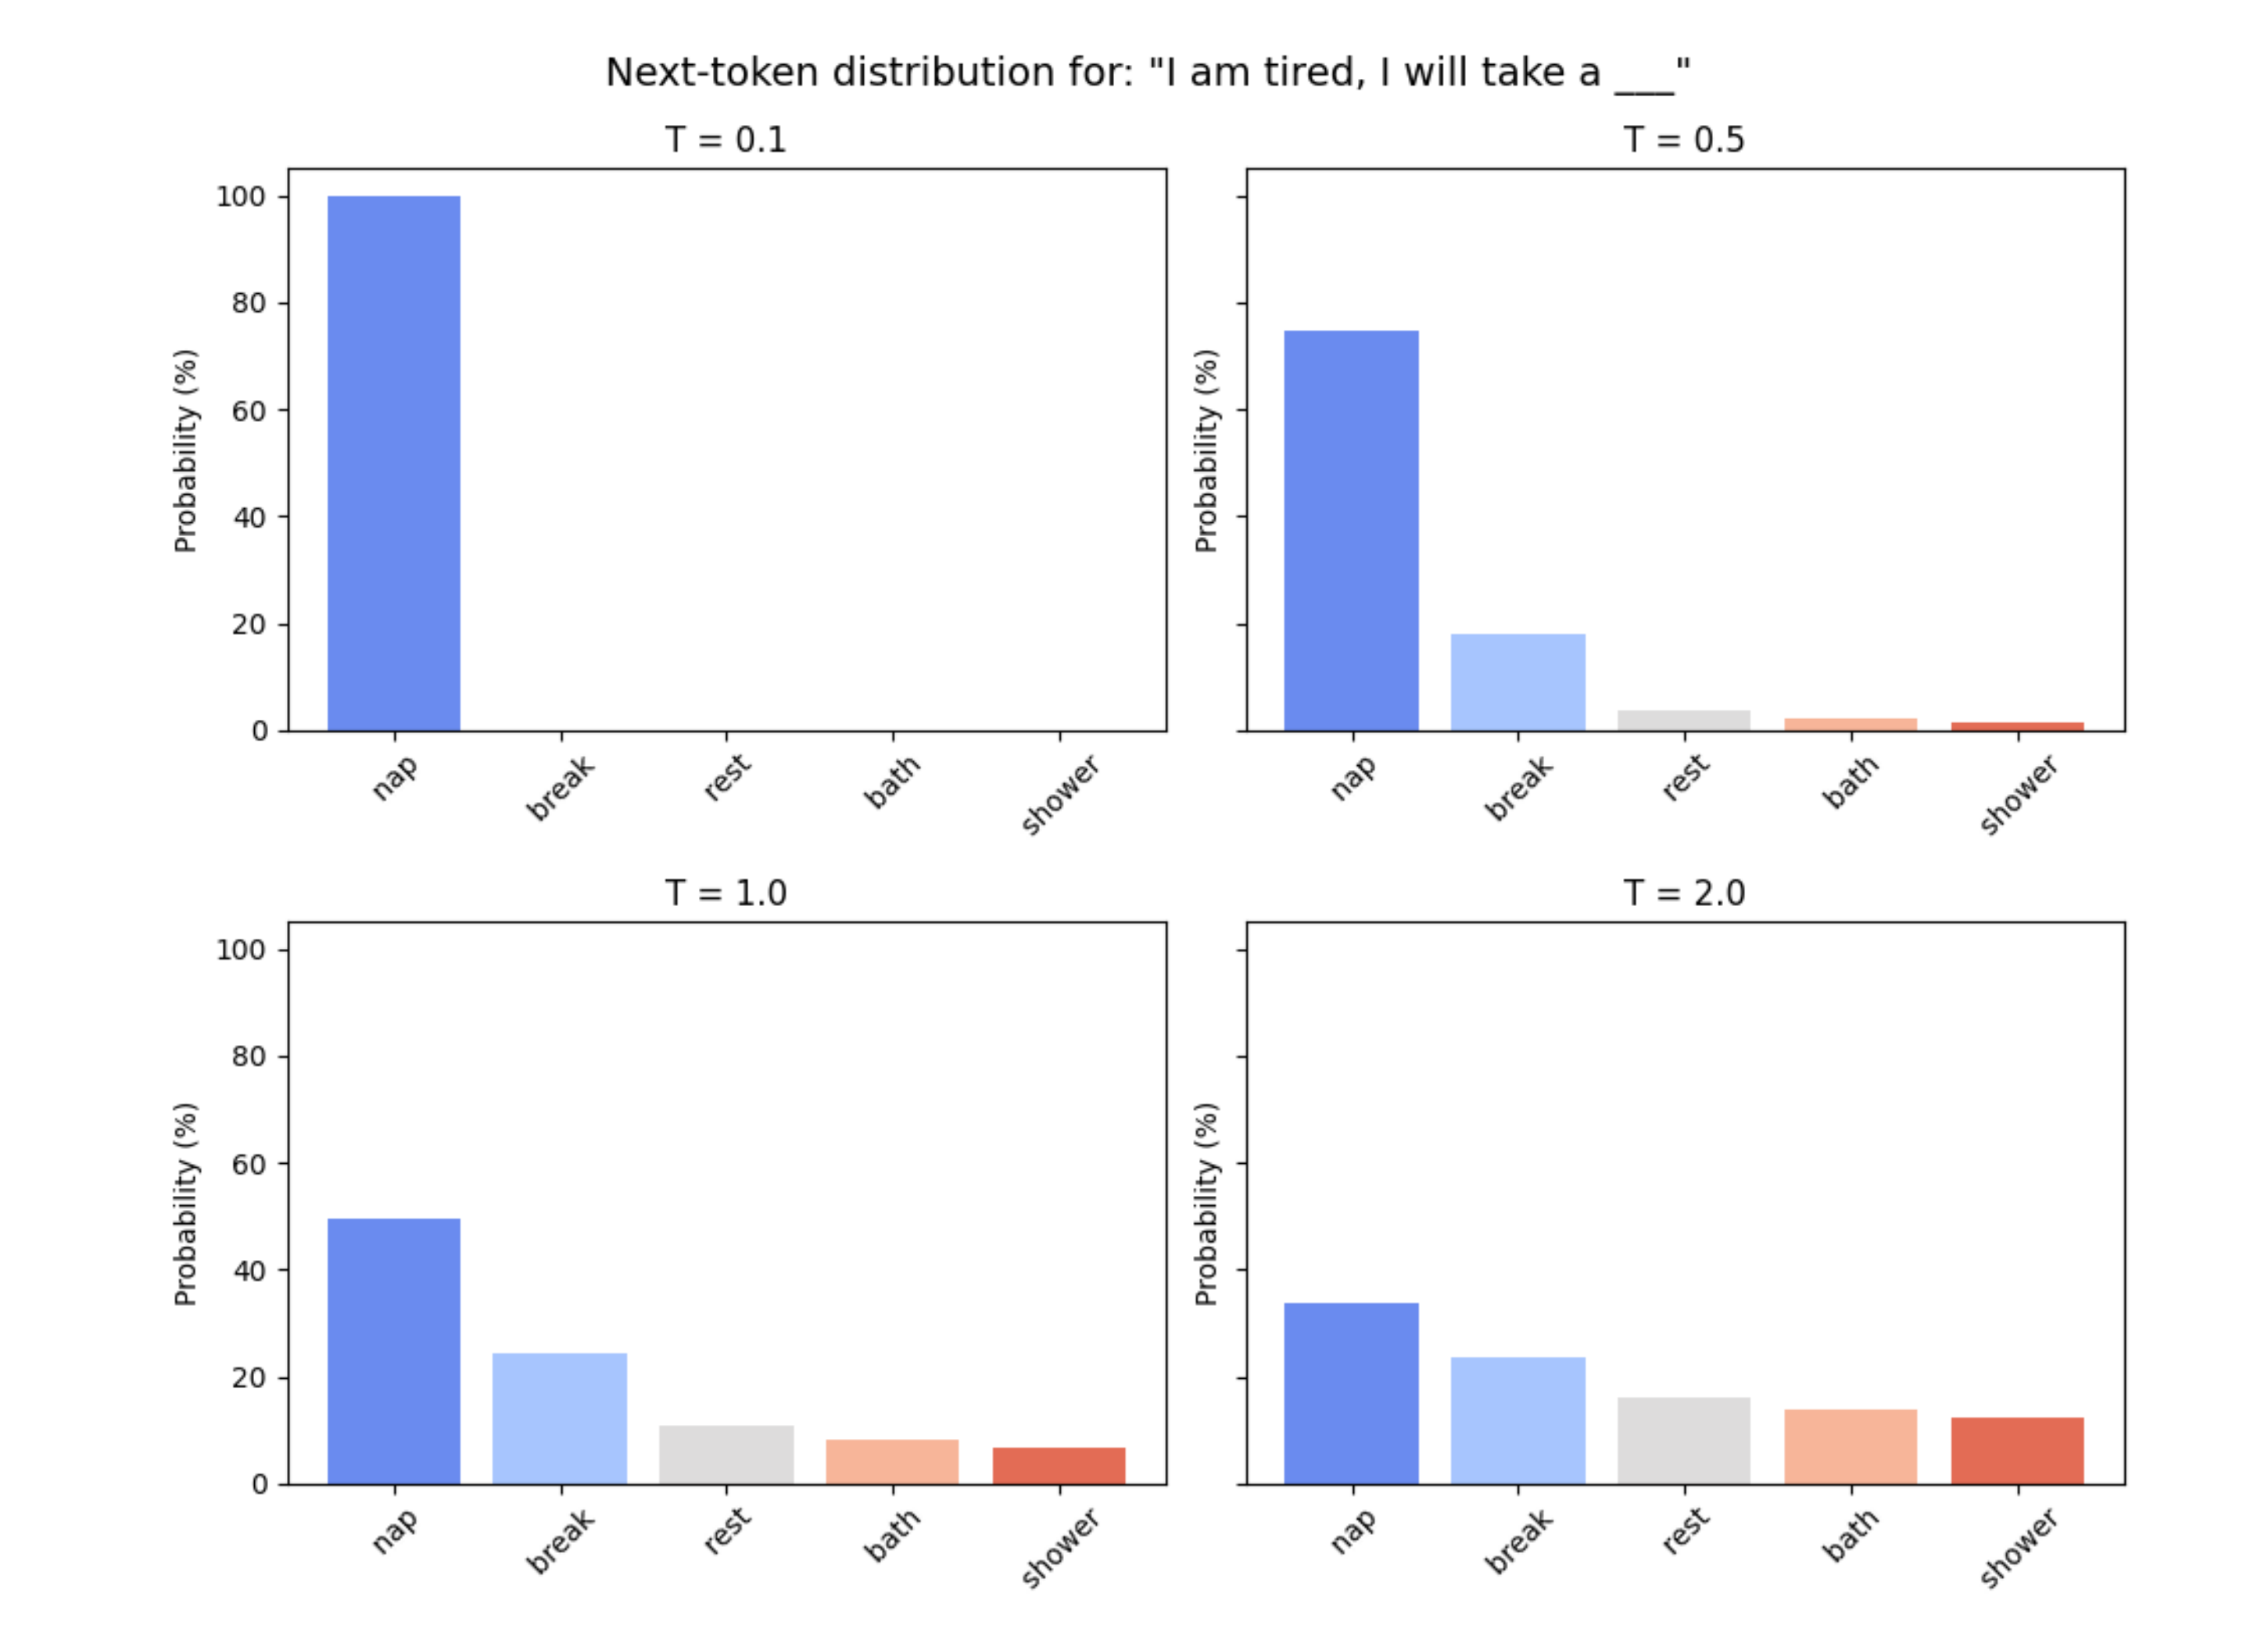
图 02 四个小图都是在同一组候选上调温度。温度低的时候,概率几乎集中在第一个候选上。温度升高后,后面几项的柱子越来越高。
Top-k 和 Top-p 都是先缩小候选范围。Top-k 固定保留概率最高的 k 个,Top-p 按概率从高到低累加,够到阈值就停,保留的候选数会随分布变。束搜索(Beam Search)每一步保留几条累积分数较高的路线,走到下一步再一起排。它能同时看几种可能的开头,也会多占内存和计算时间。
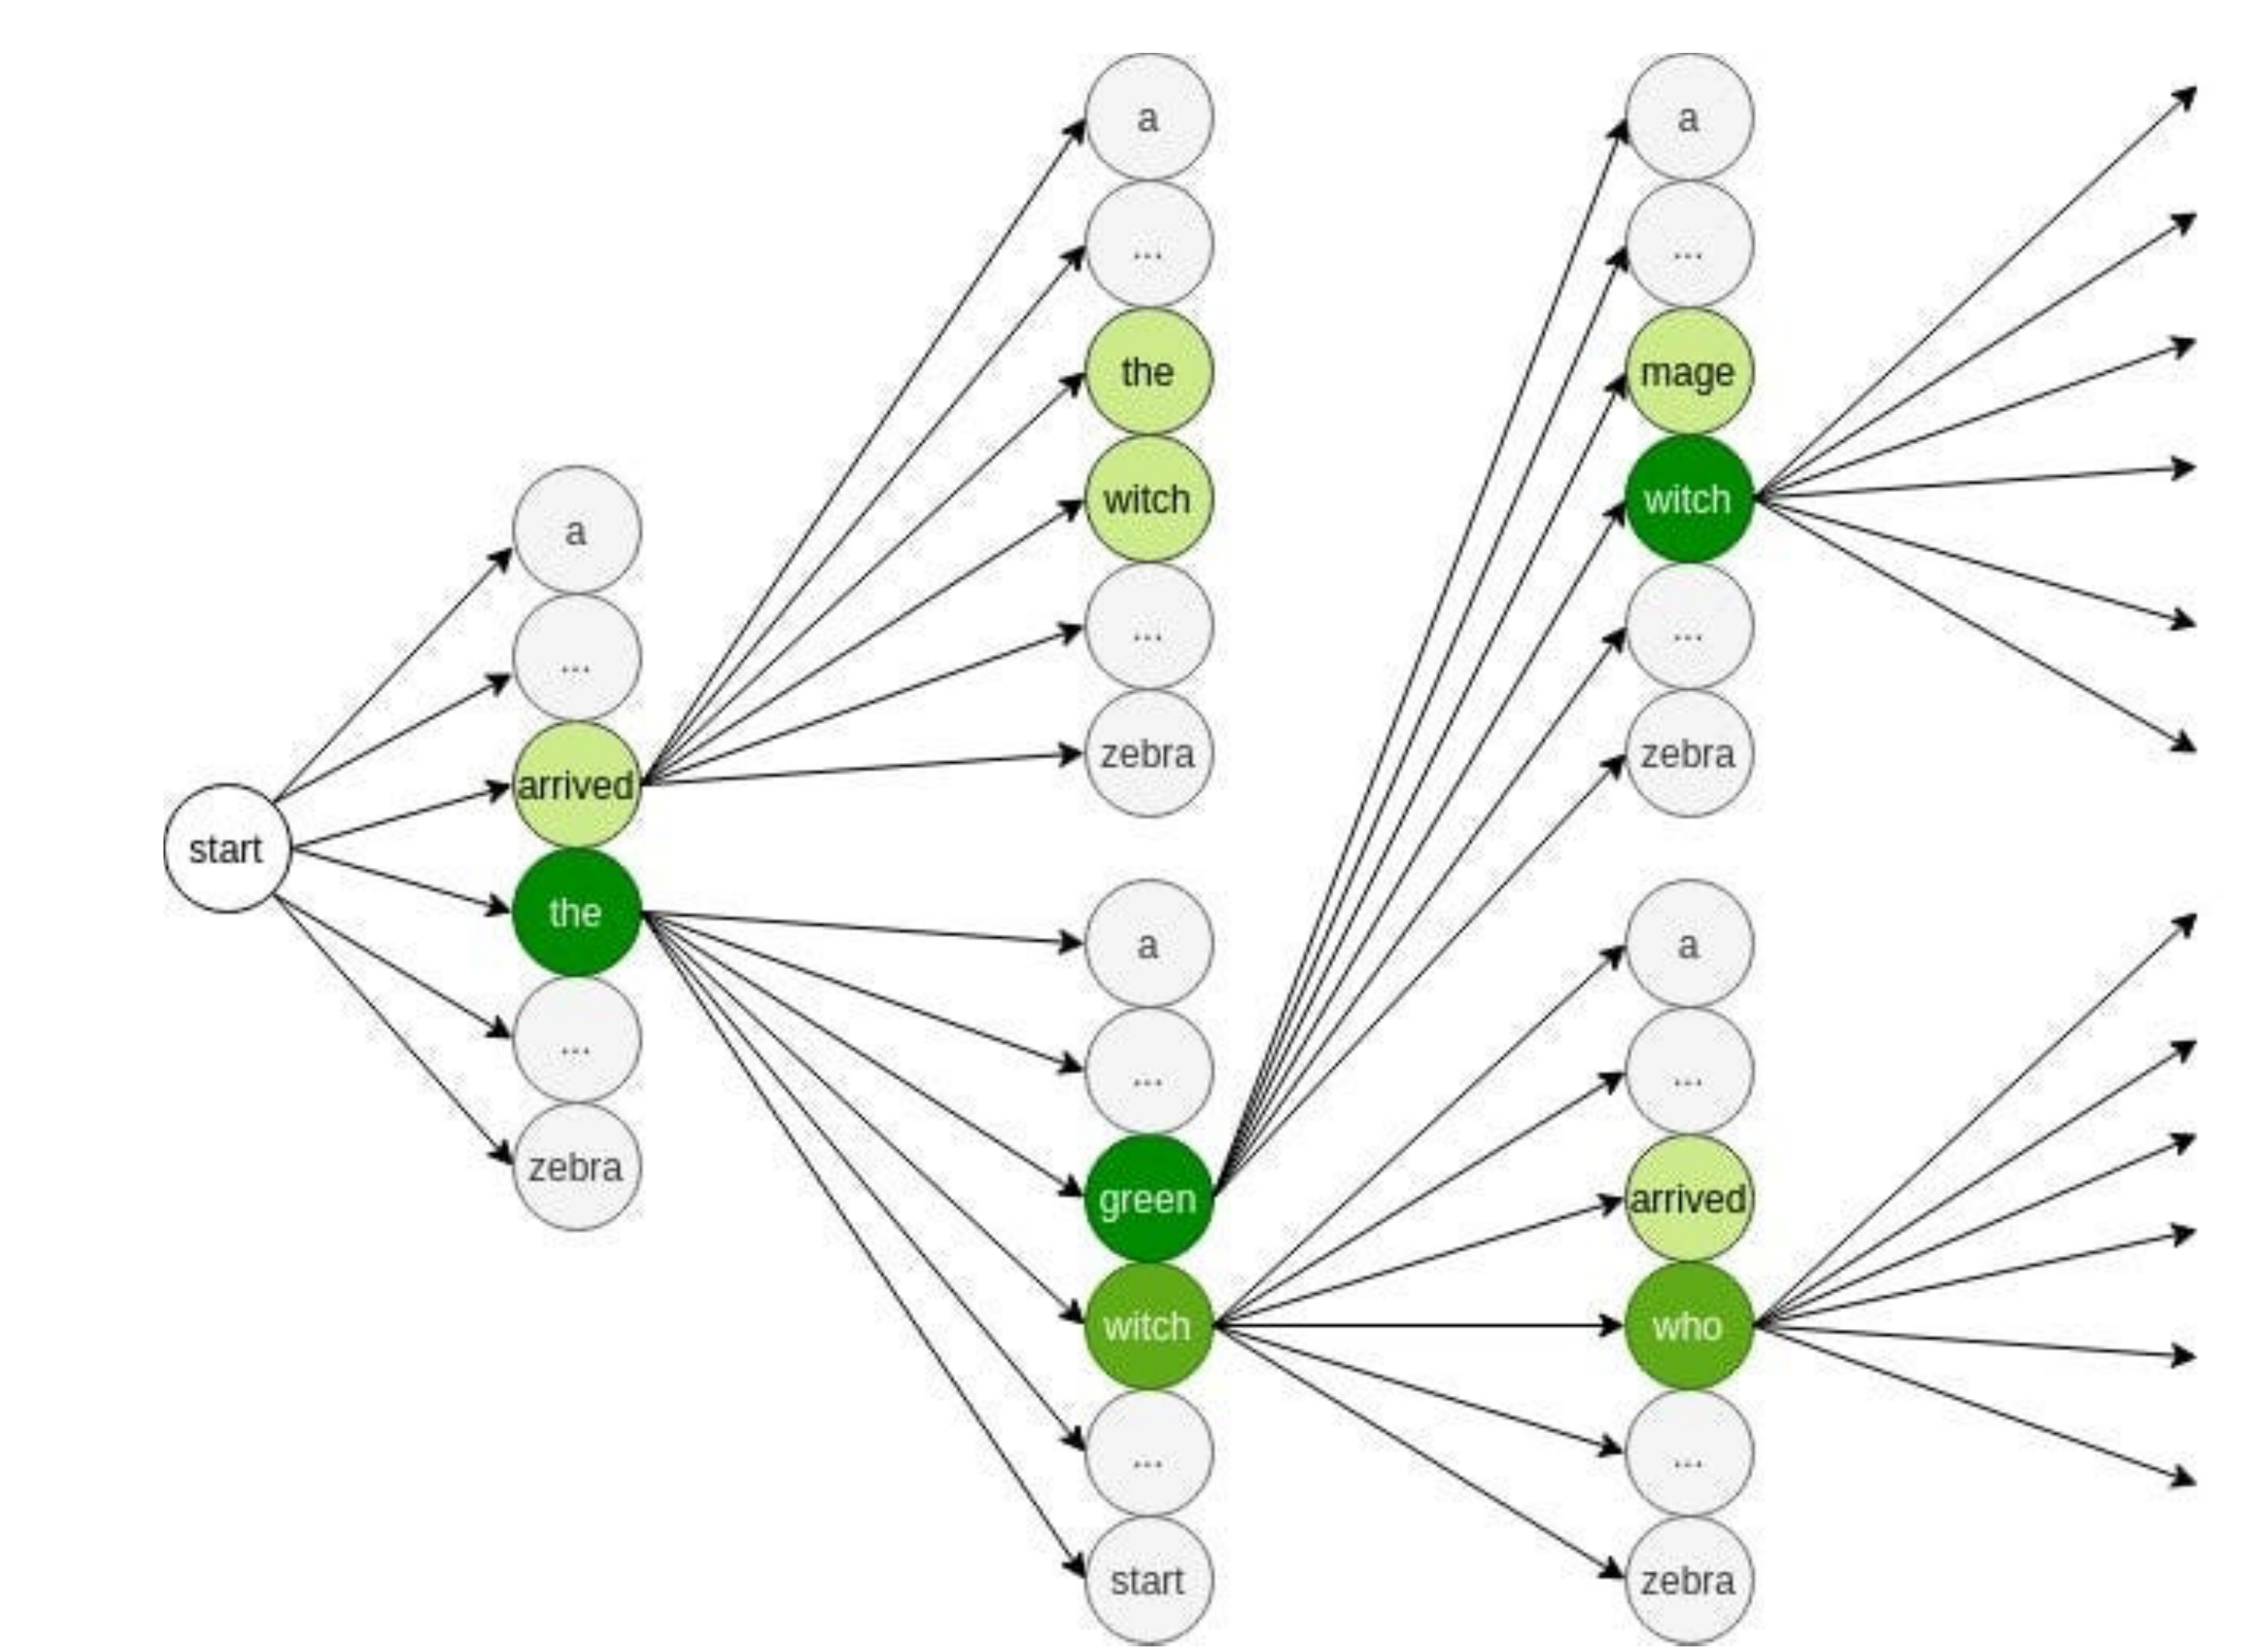
图 03 树上的绿色节点是每轮留下的路线。跟只挑一个词的做法相比,它会让几个候选继续往下长,再比较整条路径的分数。
写故事时,多一些候选可能更有意思。写代码和做计算时,往往更看重稳定。温度能改变选词的随机性,答案对不对仍然要另外验。
02 为什么是 Transformer?注意力在算什么?
早期的 n-gram 模型主要看前面有限的几个词。RNN 和 LSTM 会带着一个不断更新的状态往后读,能记住更多前文,但每个位置要等前一个位置先算完。Transformer 把重点放到了注意力上,同一层里的多个位置可以并行计算。做生成时,因果遮罩限制每个位置只看自己和前面的 token。
可以把每个 token 想成一行向量。进模型前还要加上位置信息,否则「狗咬人」和「人咬狗」里面明明有同样的字,模型却很难仅靠这些字区分顺序。以常见的 Decoder-only Transformer 为例,大体的链路是词向量和位置表示进入多层 Transformer Block,再由输出层给下一词打分。
Q、K、V 怎么理解?
我喜欢从一个位置看起。当前这个位置先生成一个查询向量 Q(Query),意思是「我现在需要什么信息」。前面的各个位置各自有 K(Key) 和 V(Value)。Q 和 K 做点积,算出匹配程度,再把分数缩放和归一化。最后按权重混合各个 V,拿到当前这个位置需要的信息。
多头注意力是在同一层里做几套这样的计算。各个头有自己的投影参数,可以学到不同的关联方式。做完后把结果合到一起,再继续过前馈网络等组件。残差连接和归一化会贯穿这些层,最终才得到词表上每个候选的分数[2]。
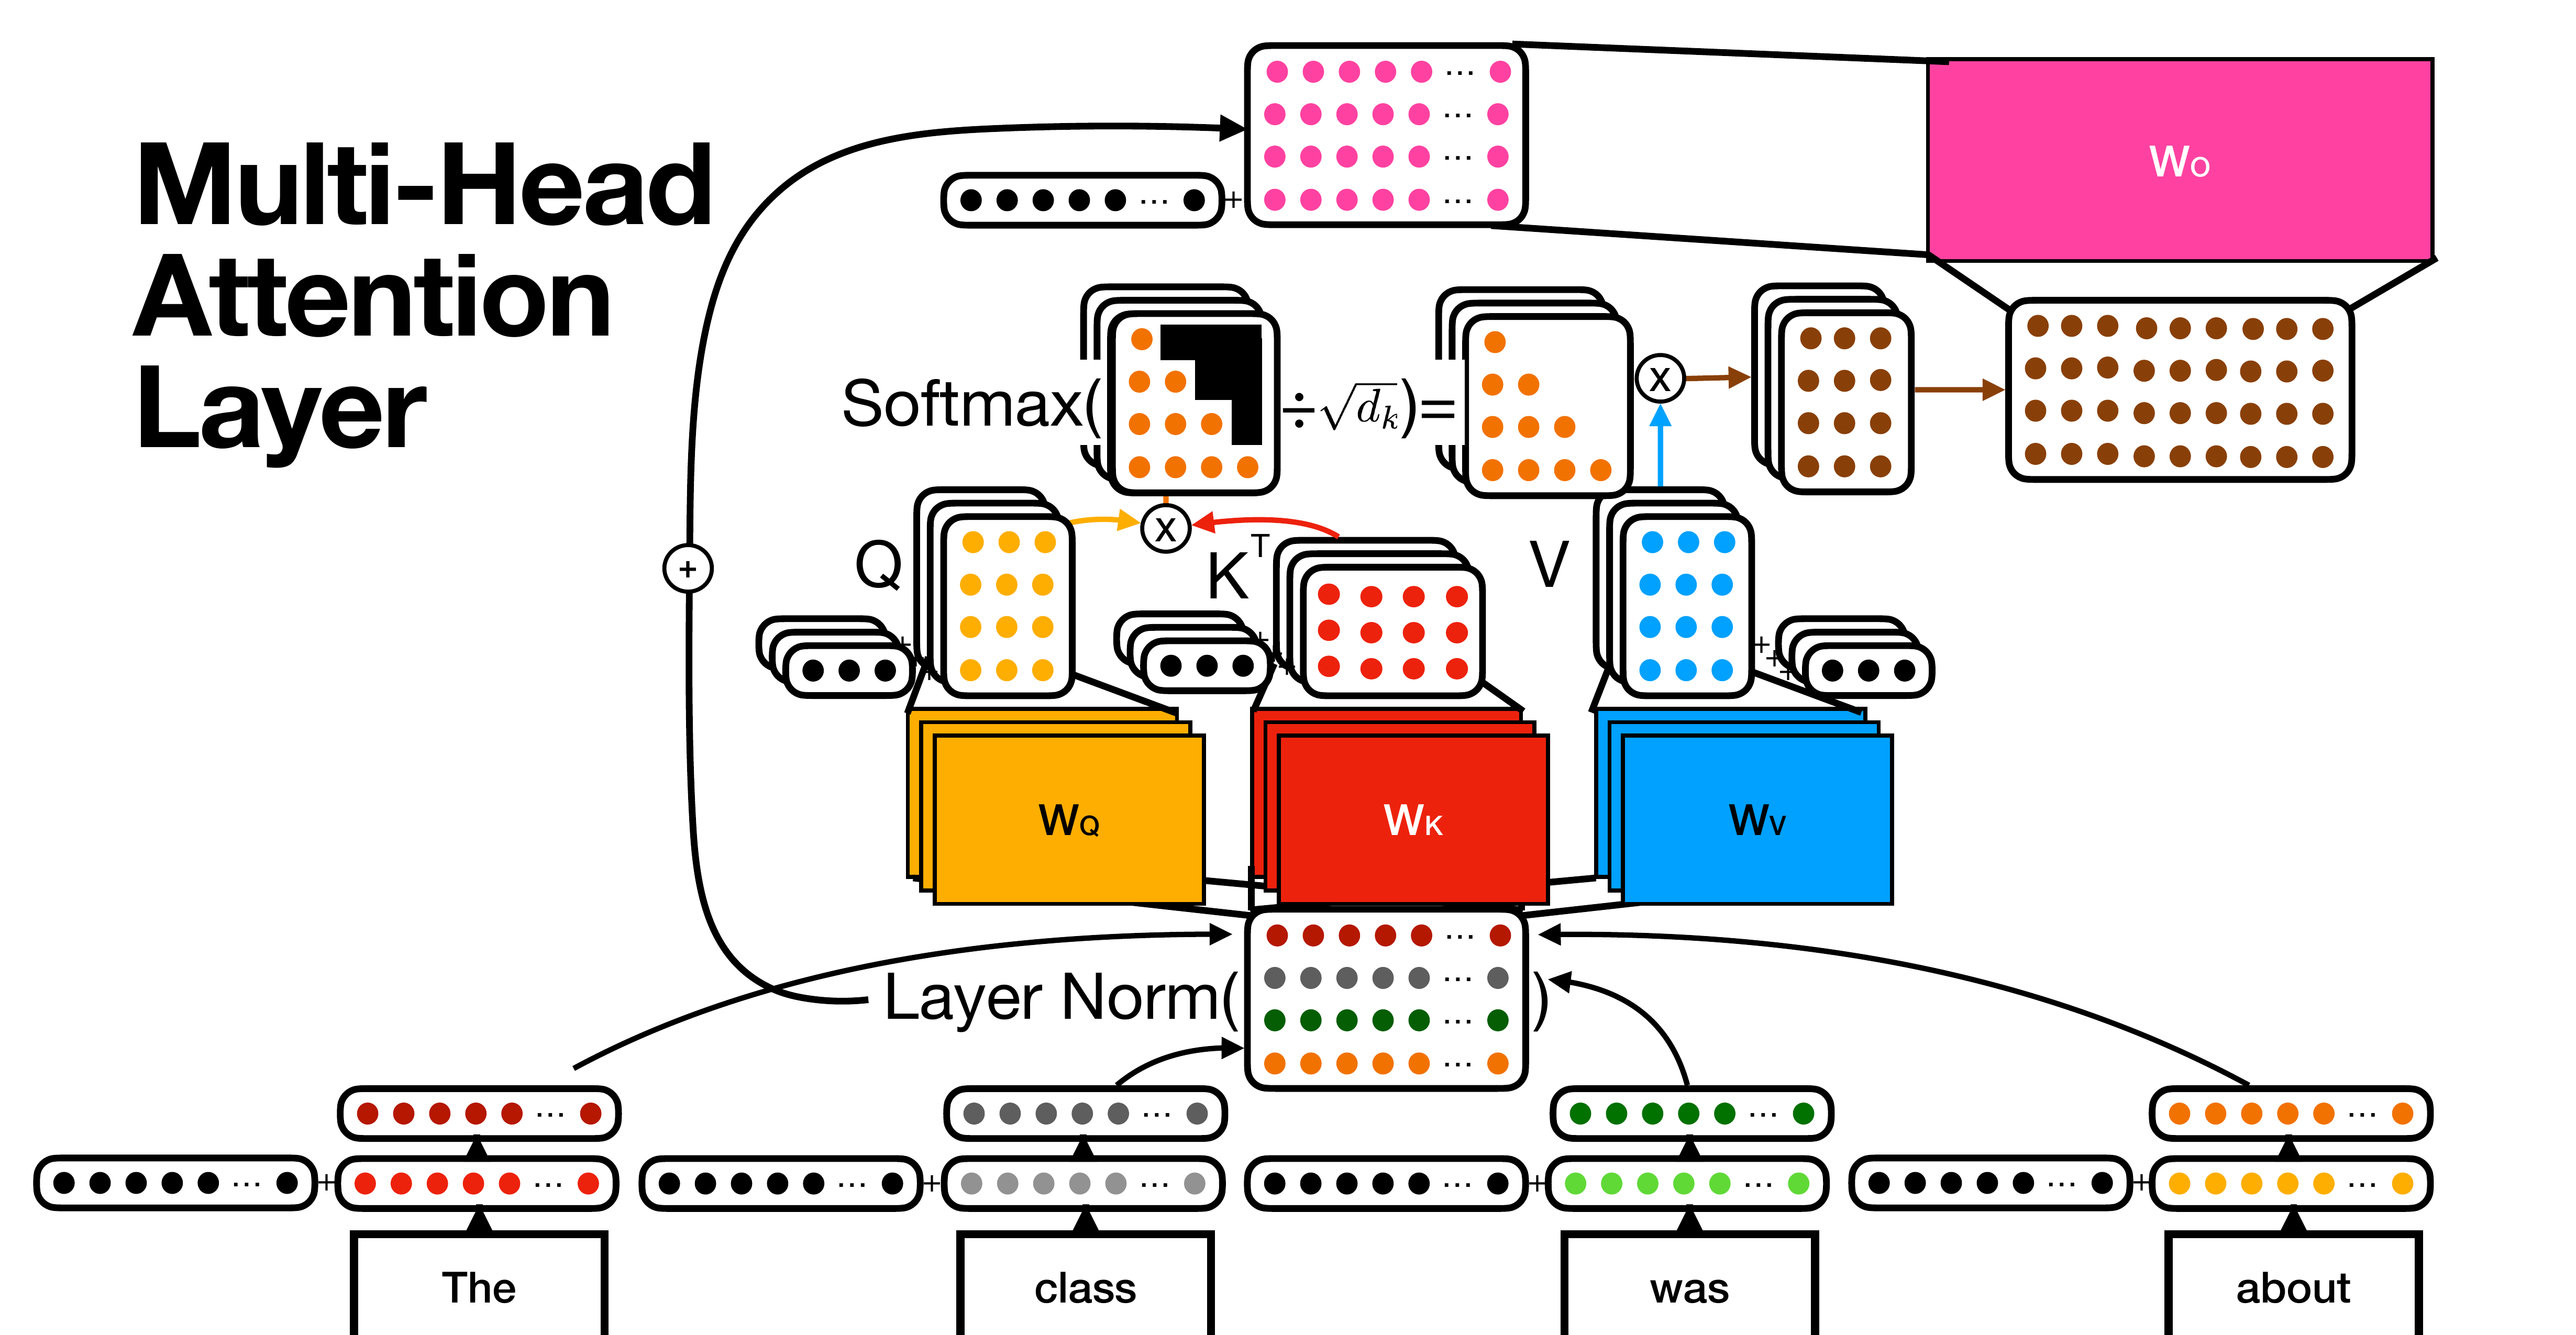
图 04 先看图下方的 token,再往上找 Q、K、V。不同的头各算一套匹配和加权,最上方的 Wₒ 再把结果投影回同一套表示。 来源 [2]Attention Is All You Need(Transformer)
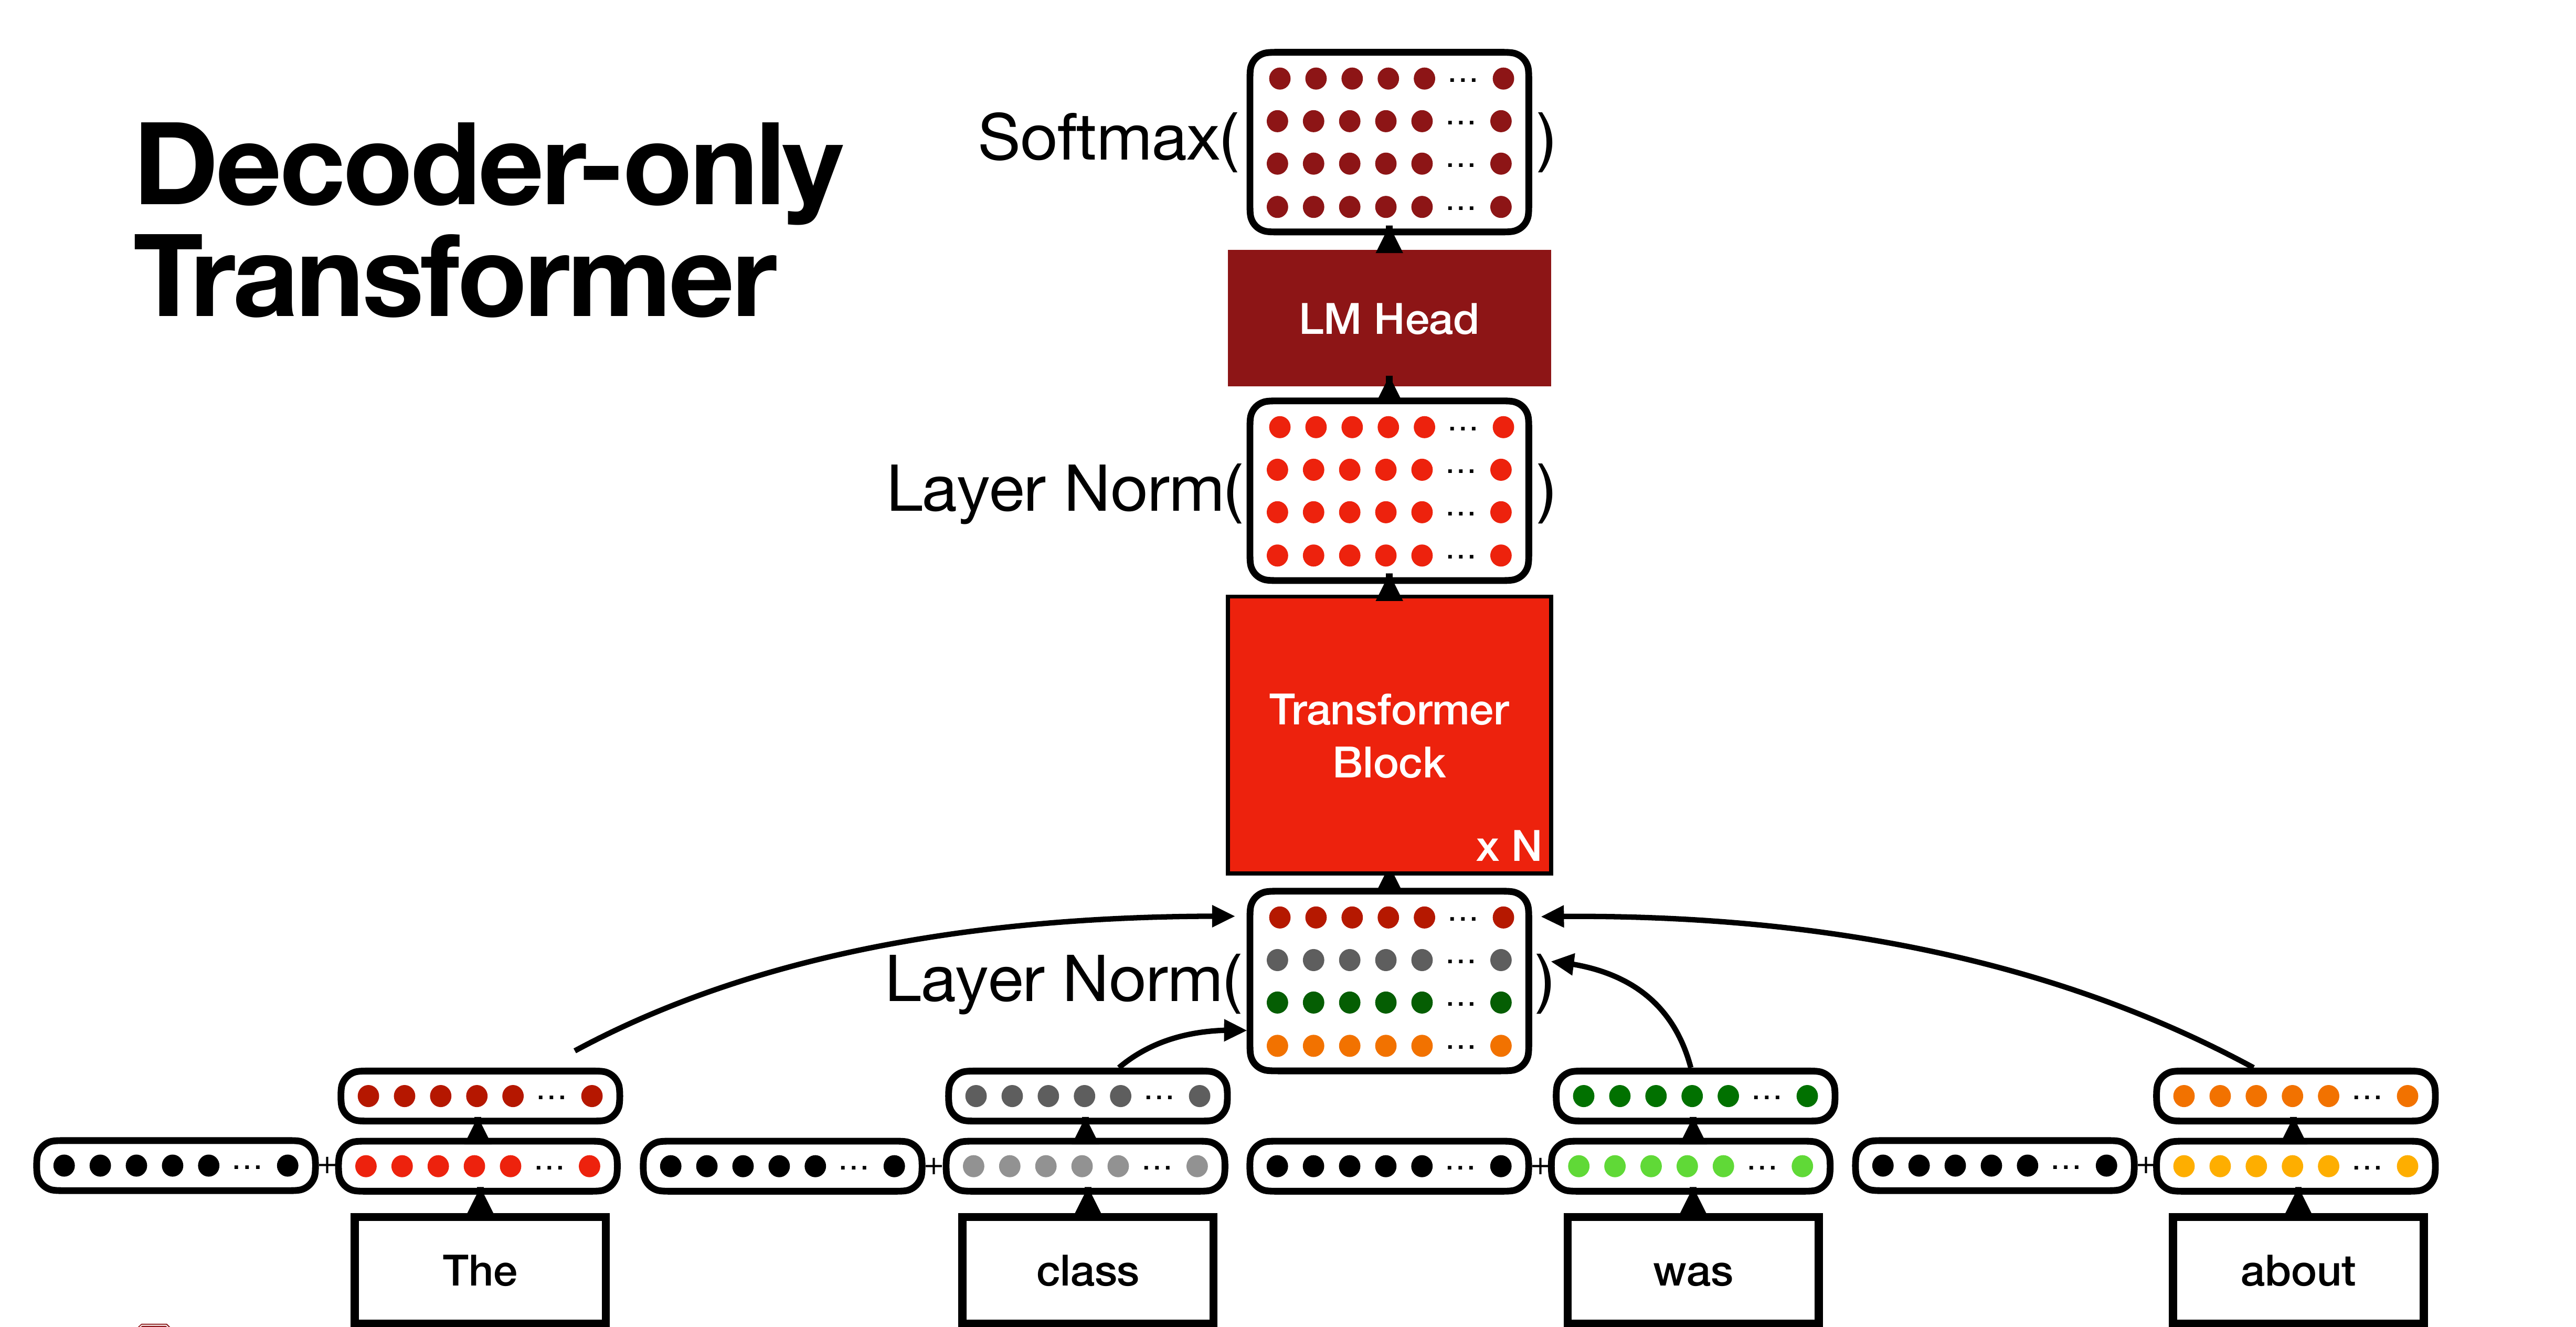
图 05 从下往上读。Token 先变成向量,经过多层 Transformer Block,最上层的 LM Head 给词表打分,softmax 再把分数转成概率。 来源 [2]Attention Is All You Need(Transformer)
全注意力、线性注意力和混合做法
标准全注意力可以让位置直接找历史上的各个位置。处理 n 个 token 时,成对的注意力计算量随长度大致按 n² 增长。推理时还会保留历史 Key 和 Value,缓存大小随 token 数增长。做长任务时,几千行日志和多轮工具结果都会体现在成本上。
一类线性注意力做法是把历史信息更新进一个压缩状态,新 token 用这个状态算输出。固定模型和状态维度后,处理序列的总工作量可以随长度线性增长,生成时每层保持固定大小的状态。代价是细节都要经过压缩,特别长的输入里,要找回某个具体信息会更难[3]。
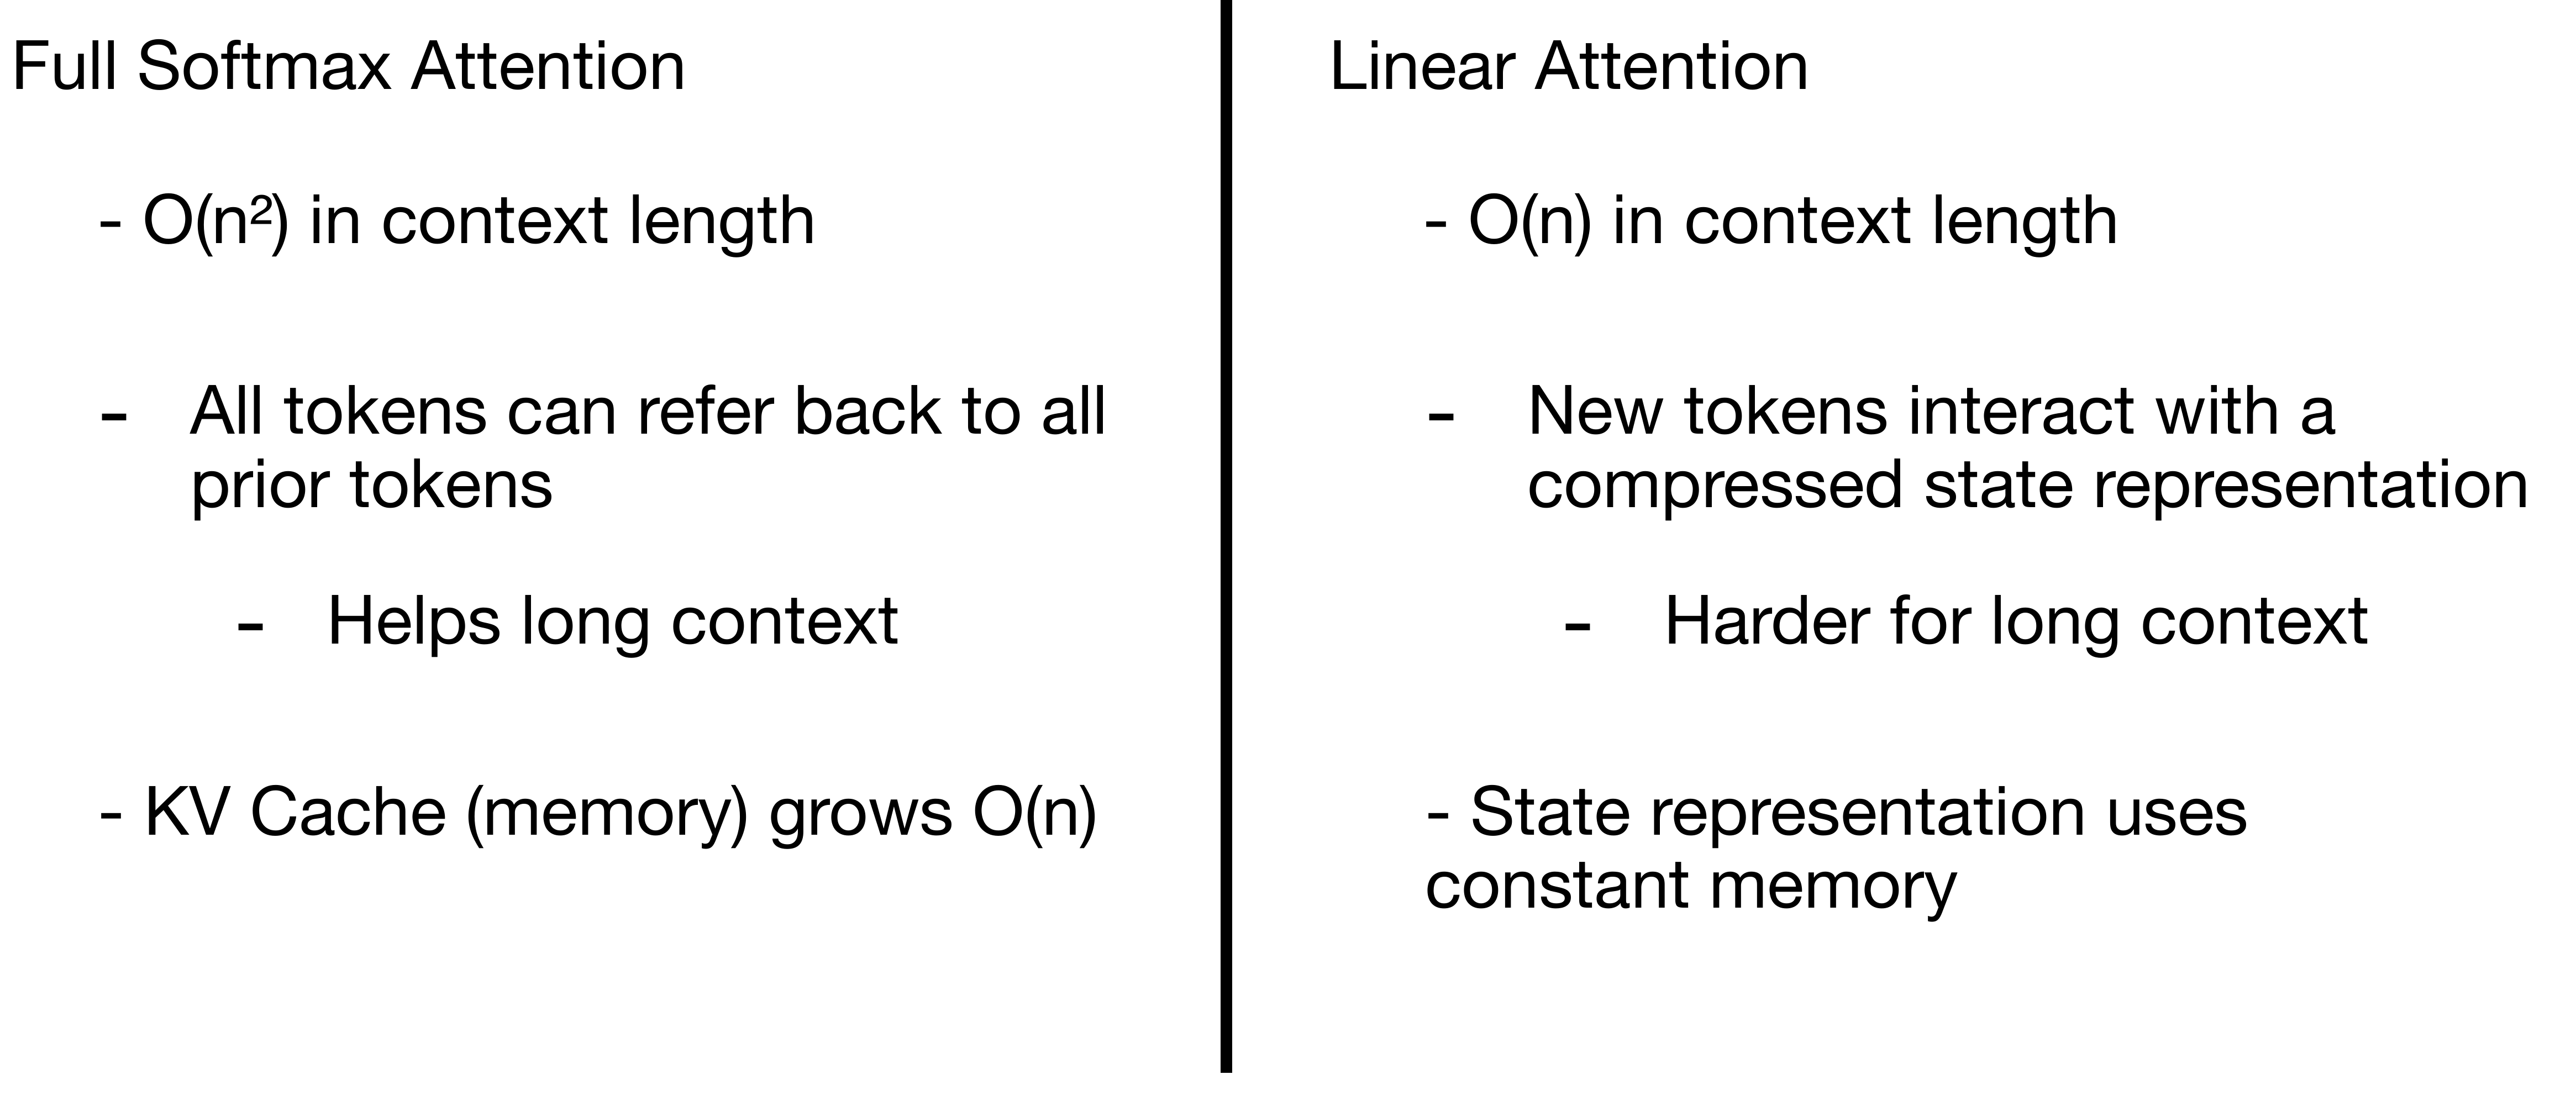
图 06 左边为历史 token 保留可直接访问的信息,右边把历史信息更新进压缩状态。图里比较了计算量、历史访问和缓存占用。 来源 [3]Transformers are RNNs(线性注意力)
所以会有混合架构。部分层用全局注意力保留远距离访问,其他层用窗口注意力或线性机制省成本。Kimi K3 的技术报告提供了一个例子,从图上能看到两类注意力层混合使用[4]。
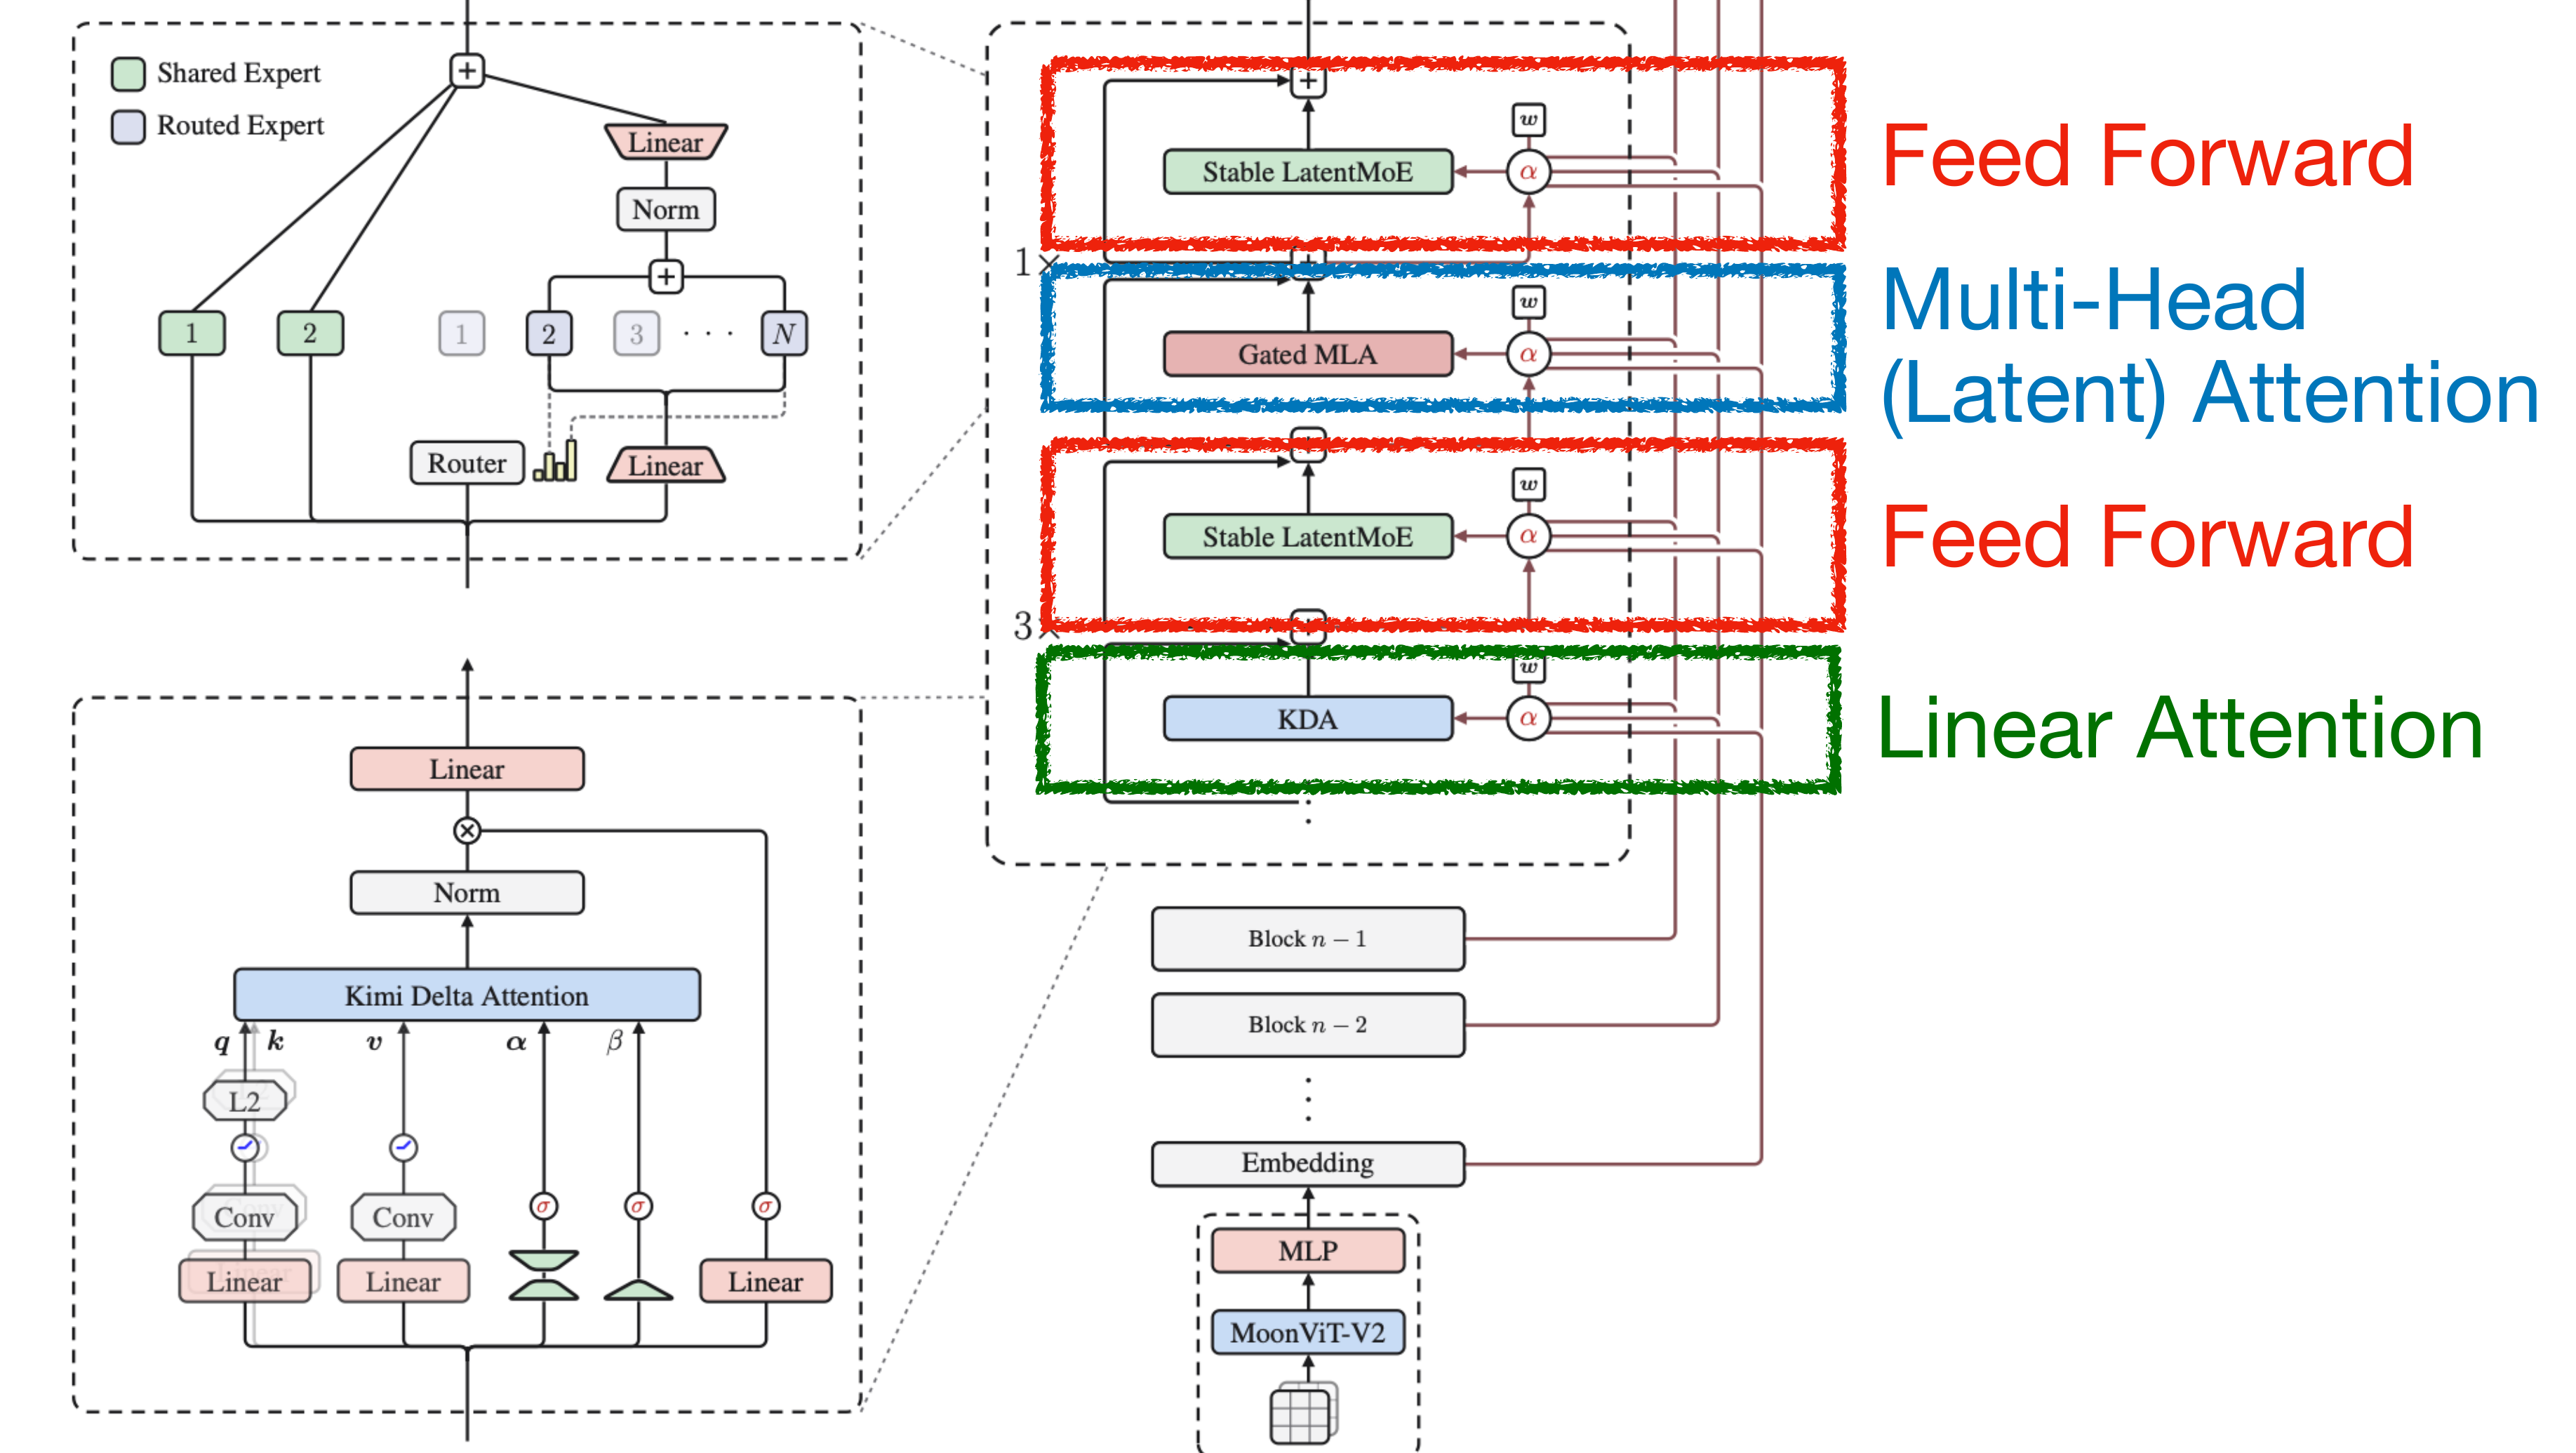
图 07 看右侧蓝色和绿色标记。蓝色对应多头潜在注意力,绿色对应线性注意力,两种层安排在同一模型中。 来源 [4]Kimi K3 技术报告
模型的标称上下文范围,还和训练时使用的长度、位置编码等有关。训练长上下文模型时,常会用更长的样本继续训练,让模型适应更远的位置范围。做 Agent 选模型时,我会把「能放进去多少」和「放进去之后能不能找对、用对」分开看。
03 训练分哪几步?
先说最底层的目标。训练数据里已经知道接下来应该是什么 token,模型给它的概率越低,交叉熵损失越大。用一段真实文本当练习,模型每步都被要求给真实下一个 token 更高的概率。大规模重复这个过程,就得到基础语言能力。
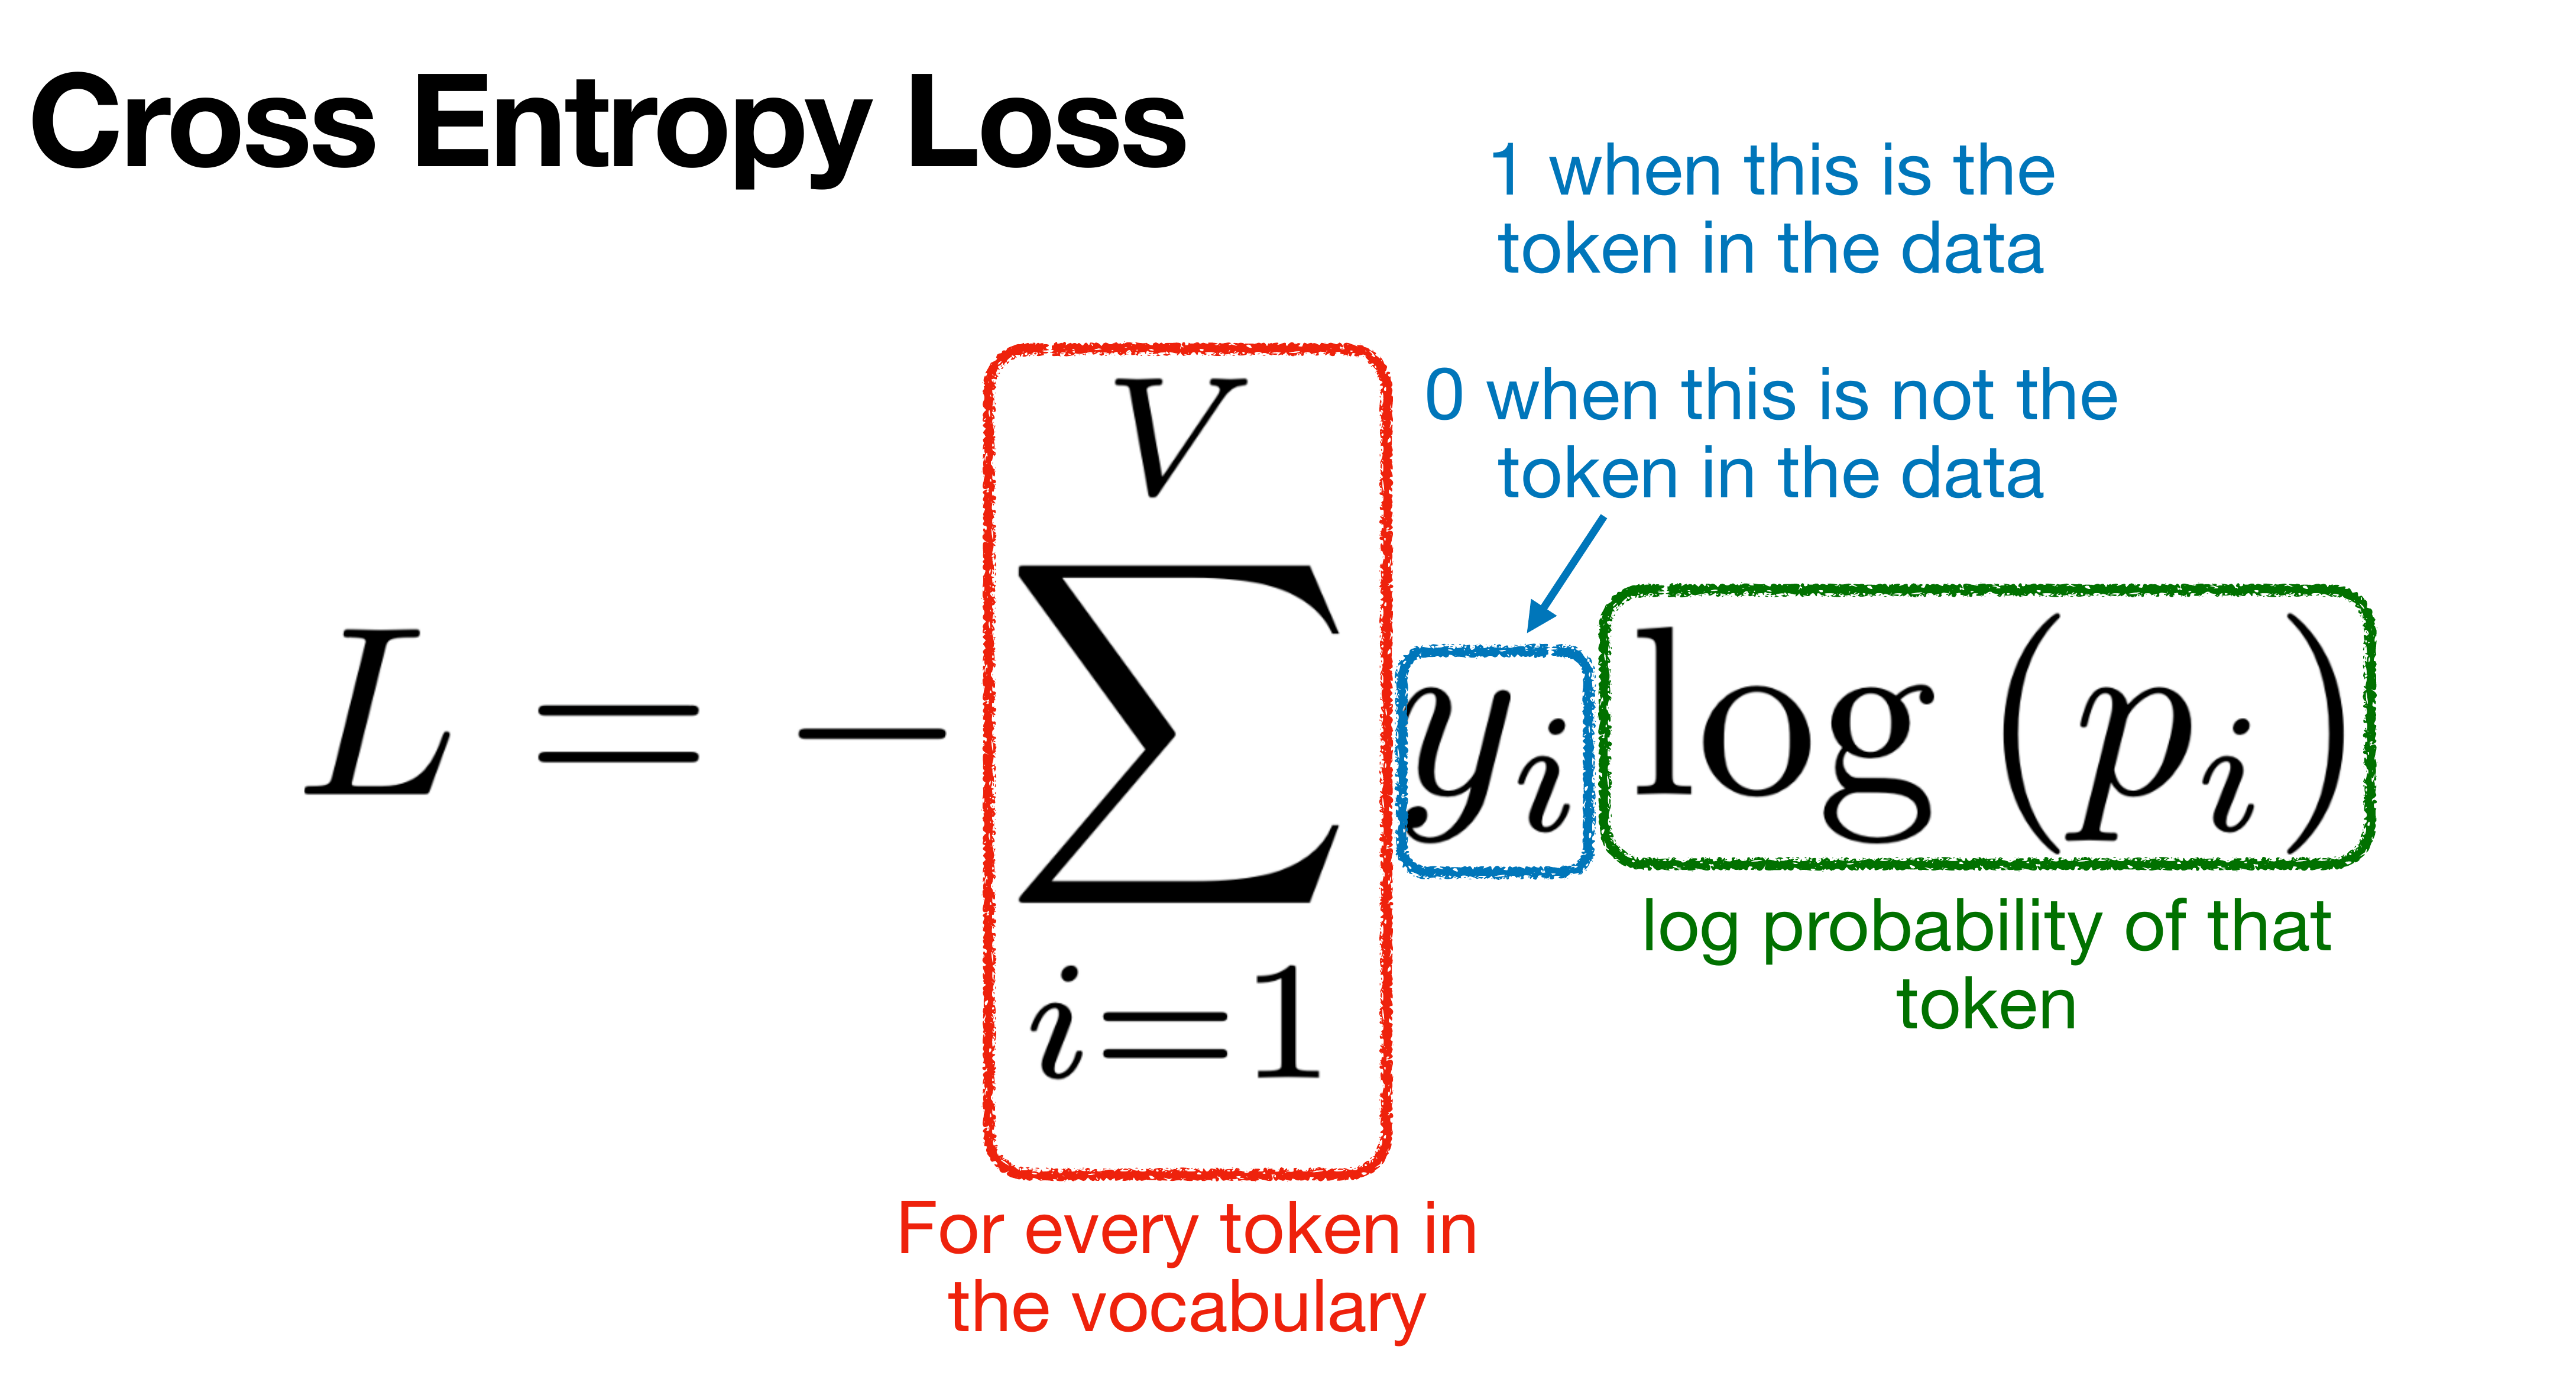
图 08 公式里 yᵢ 是真实标签,只有正确 token 对应的那一项为 1。求和化简以后,就是对正确 token 的概率取负对数。
预训练、中期训练和后训练
预训练先用大规模数据打基础。网页并不会原封不动进模型,通常要提取文本、识别语言、做规则和质量过滤、去重。论文、网页、代码、数学资料各占多少,也是训练选择的一部分。配比变了,同一个训练预算可能换来不同的能力。做数据配比研究时,也可以先训练几组规模较小的模型,测出不同配比在目标任务上的差异,再决定大规模训练用哪一组。
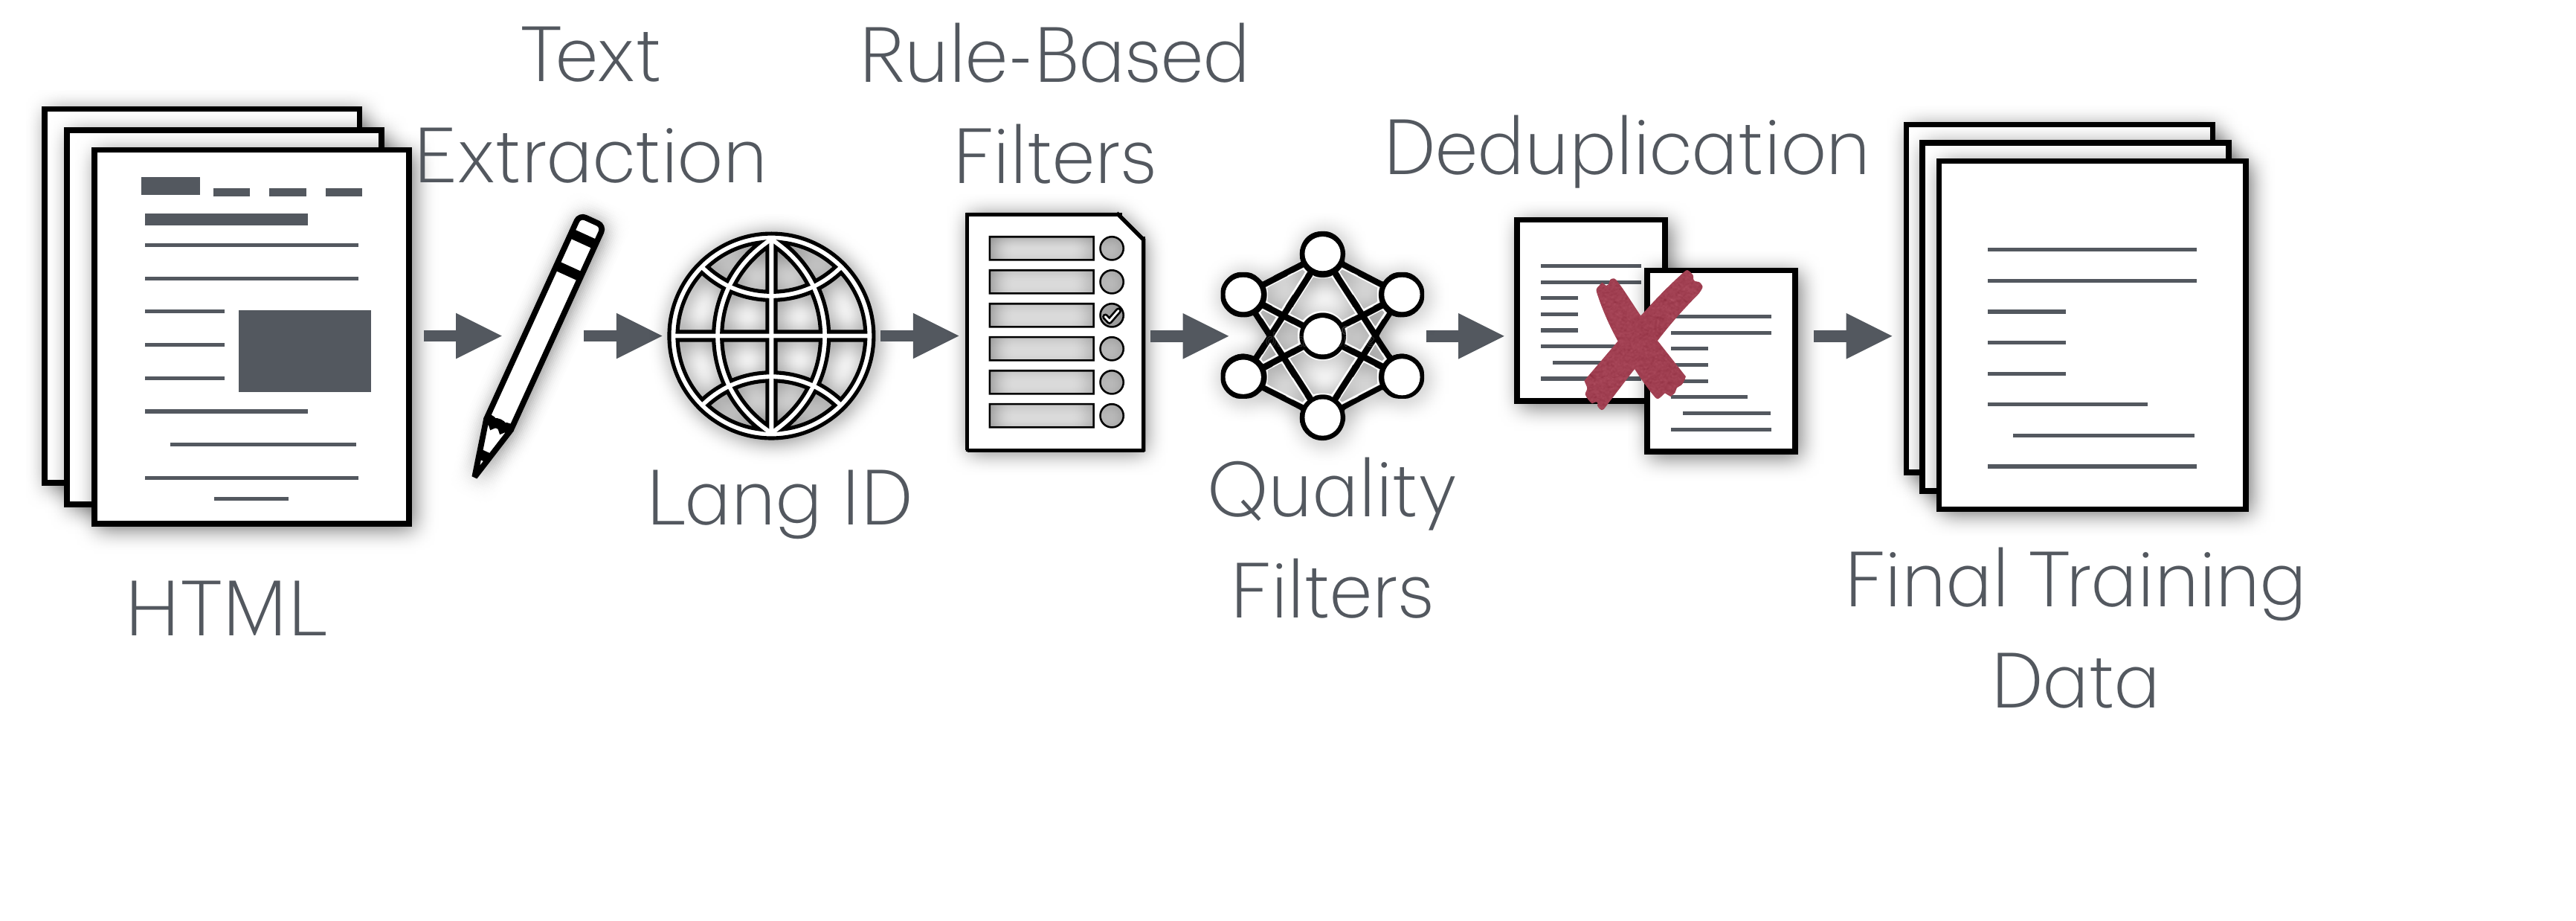
图 09 从左往右是网页提取、规则过滤、语言识别、质量过滤和去重。筛出来的文本才进入训练集合。
中期训练(Midtraining)会在通用预训练之后进一步调整数据配比,比如增加目标领域的数学、代码或高质量长文。它既沿用继续训练的目标,又把重点向后面的任务靠近。要保留多少通用数据、何时提高领域数据占比,都需要实验[5]。
后训练让基础模型更像一个能被人使用的系统。指令微调用「指令、示范回答」教它按要求作答。基于人类偏好的方法给同一问题的多个回答排序,训练模型更倾向于人偏好的输出。经典 RLHF 可以先训练奖励模型,再做强化学习,DPO 则直接用偏好对优化模型[6]。
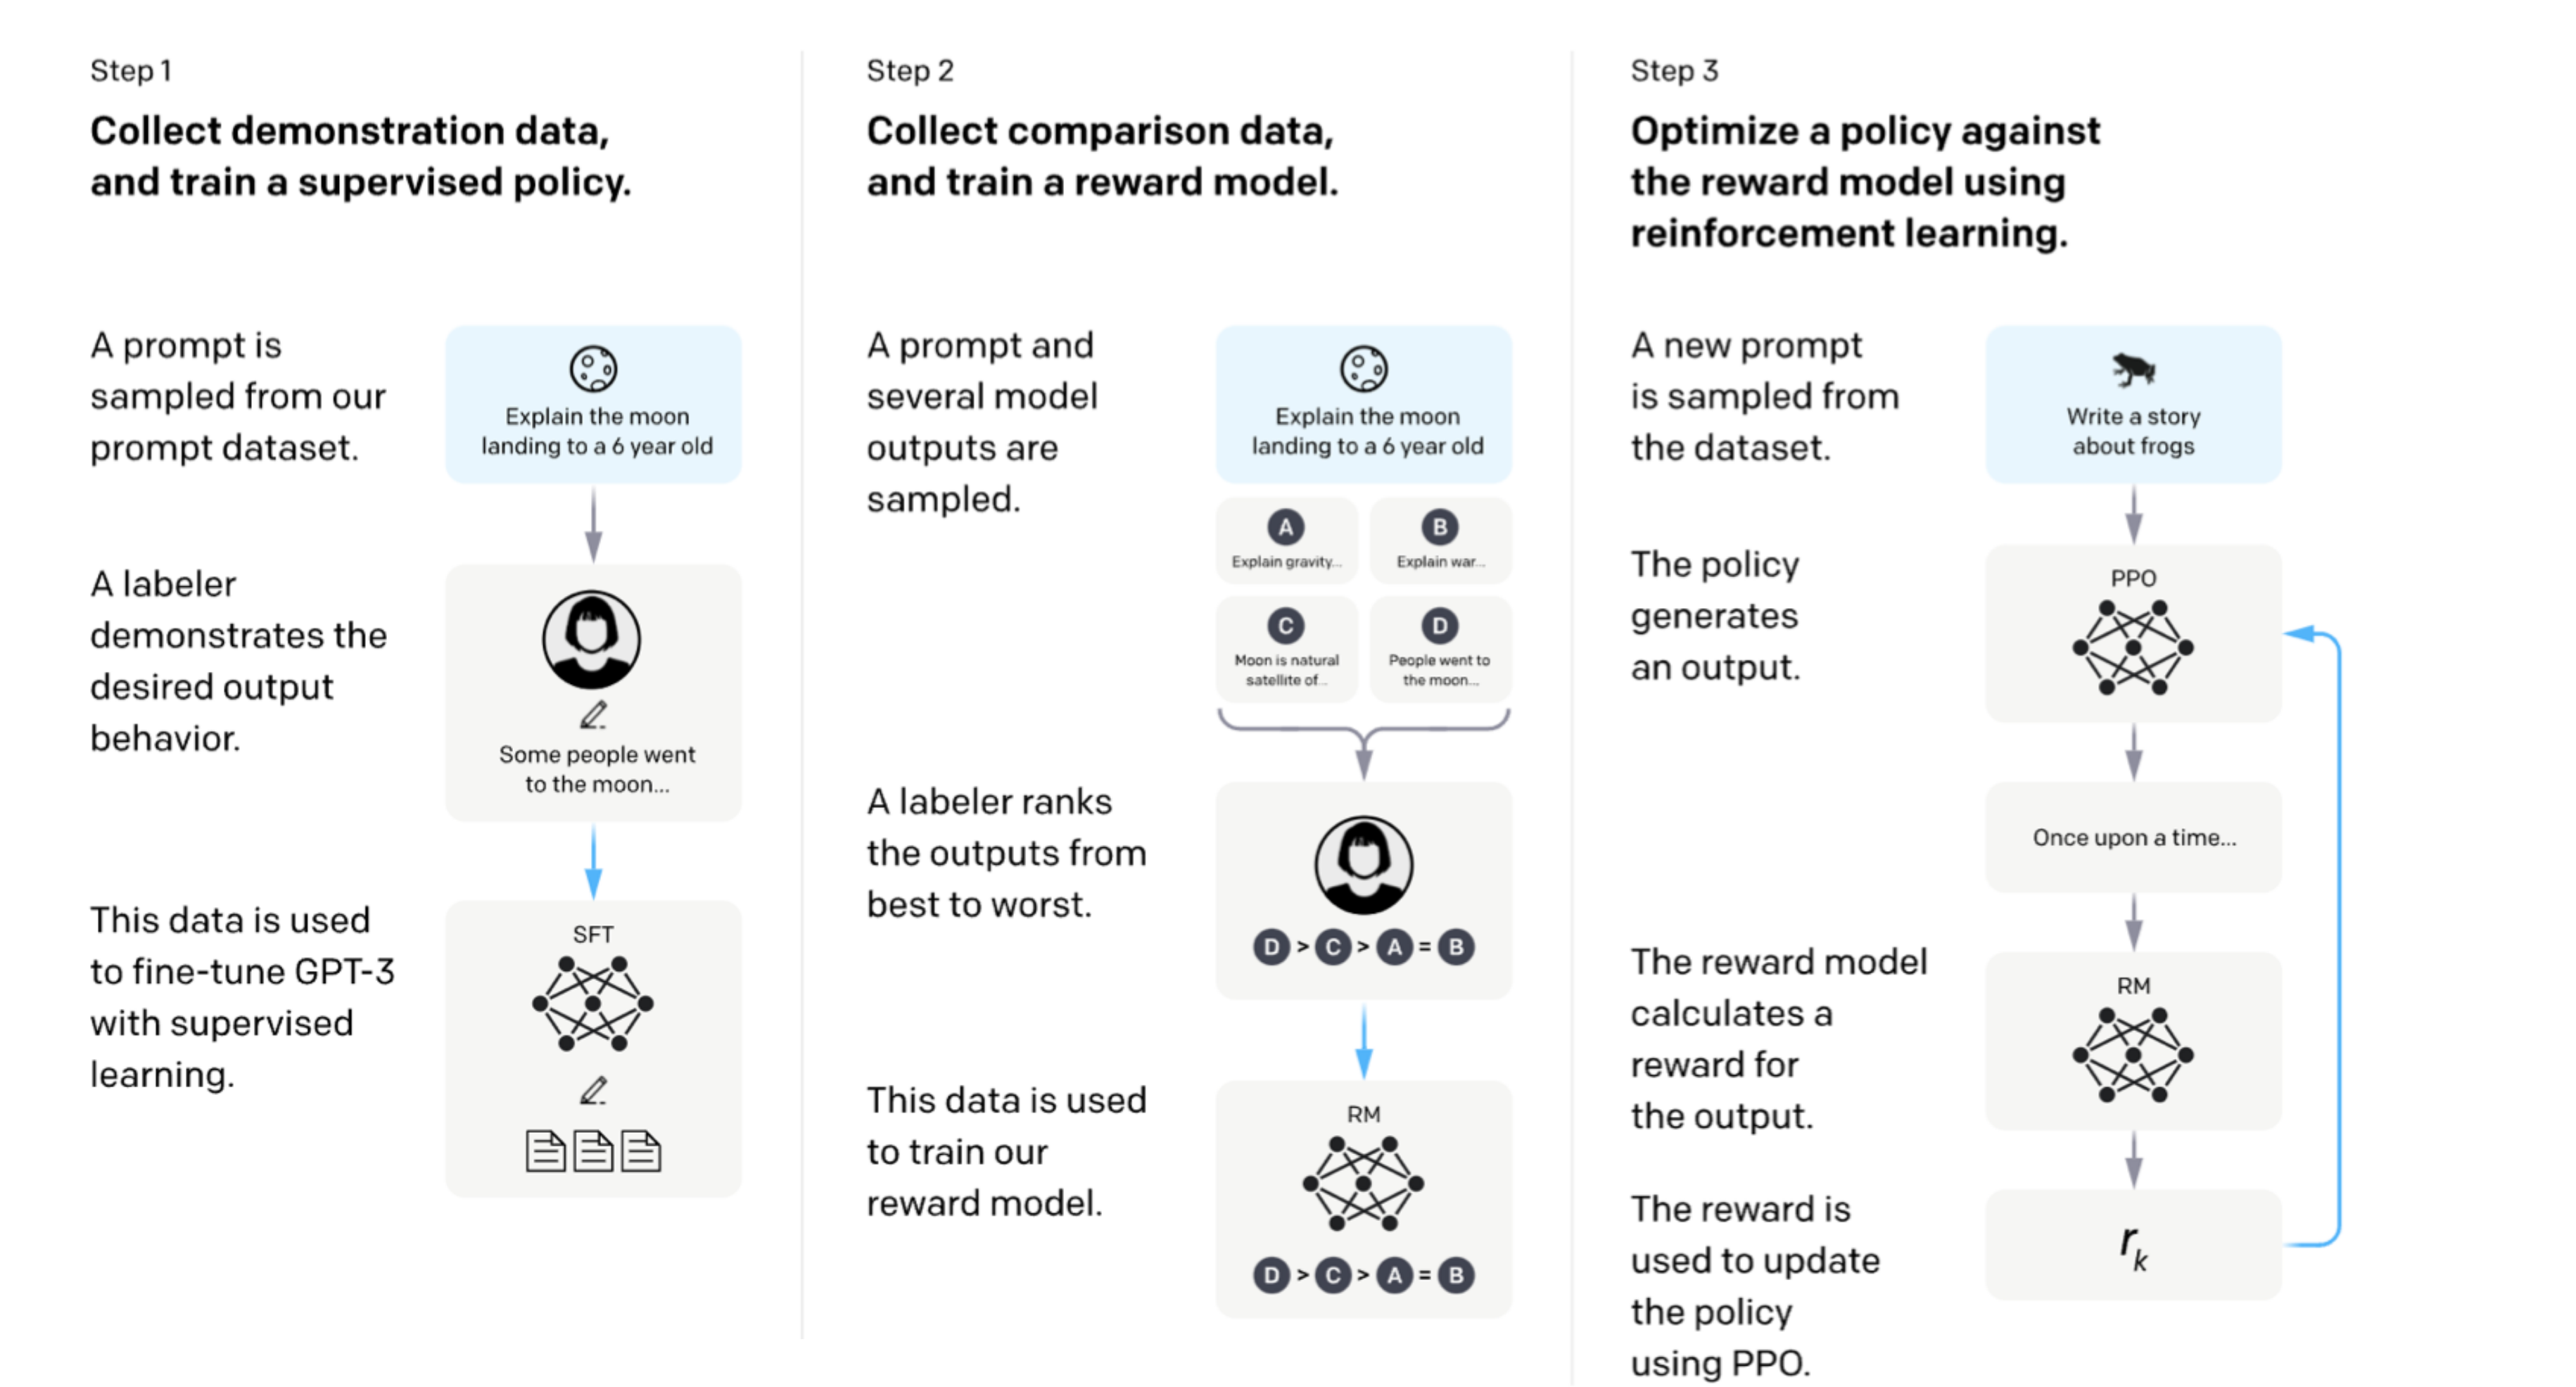
图 10 图从左到右画了示范数据训练、收集偏好并训练奖励模型、再用奖励优化模型的过程。这是一种经典 RLHF 流程。 来源 [6]Training Language Models to Follow Instructions with Human Feedback
人给的偏好可能不一致,也可能偏爱自信、好听的回答。可验证奖励的强化学习(RLVR)把部分偏好换成程序可检查的结果。数学可以看最终答案或证明,代码可以跑单元测试,Agent 还可以核对环境的最终状态。验证器设计得有漏洞,模型得到高分以后,任务仍可能没按预期完成。
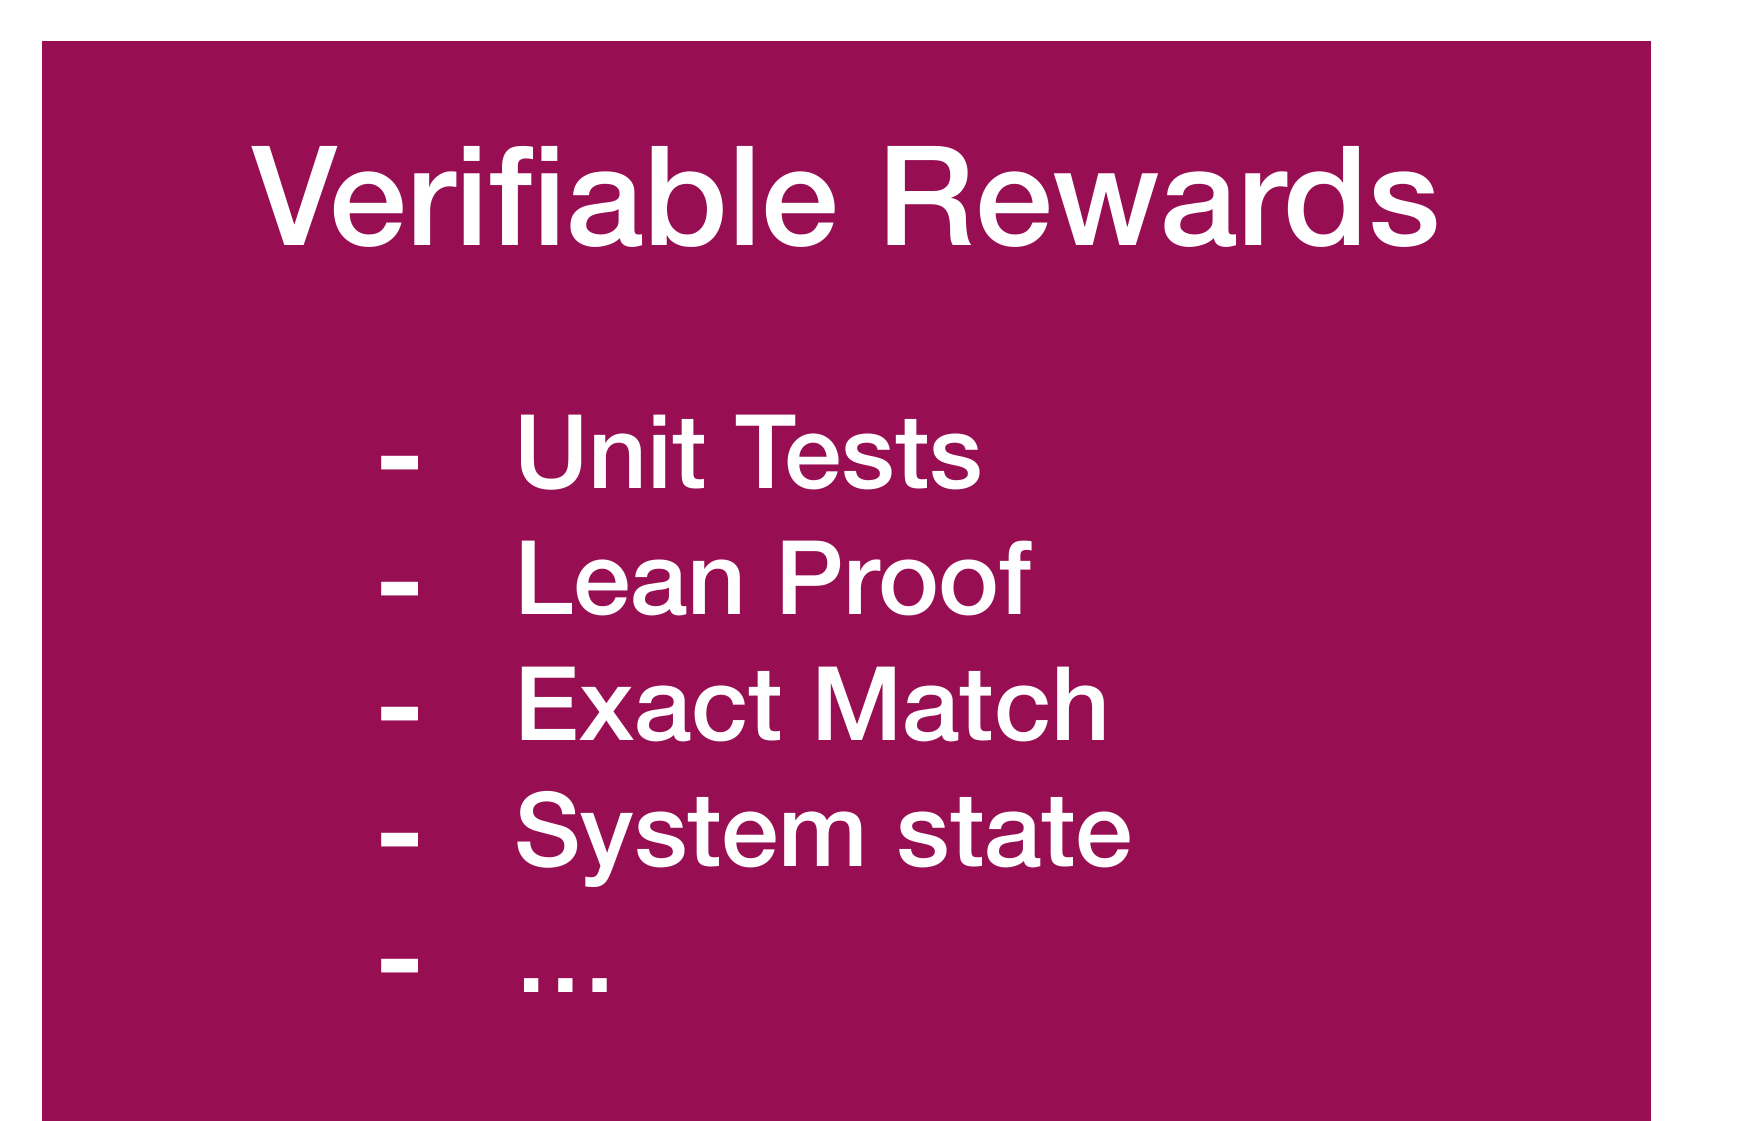
图 11 右侧列了单元测试、形式化证明、答案精确匹配、环境状态等可验证信号。实际训练要把奖励定义与希望得到的结果对上。 来源 [7]DeepSeekMath 技术报告
要训编程 Agent,还要提供真正能动手的任务环境。SWE-Smith从开源仓库构造可执行、可测试的软件工程任务,让 Agent 在仓库里产生行动轨迹,再用这些数据改善编程能力[8]。这类训练里,拿到题目的第一句话只是开始,环境能不能装起来、修改后能不能跑测试,同样关键。
04 一次推理分成 Prefill 和 Decode
用户发来的整段输入,模型先做一次 Prefill(预填充)。已知的输入 token 可以批量处理,顺便把各层历史的 K 和 V 算好。接下来是 Decode(解码),模型输出一个 token,把它接回去,再生成下一个。后面生成的每一步都依赖前一步,里面有一段串行过程。
KV Cache存的是已经处理过的 token 在各层的 K 和 V。生成新 token 时,当前查询可以直接用这些缓存,历史 token 的 K 和 V 就不用重新算一遍。上下文更多,缓存也更大。对于多轮 Agent 来说,反复往请求里放工具日志,除了输入更长,也会增加这一部分开销。
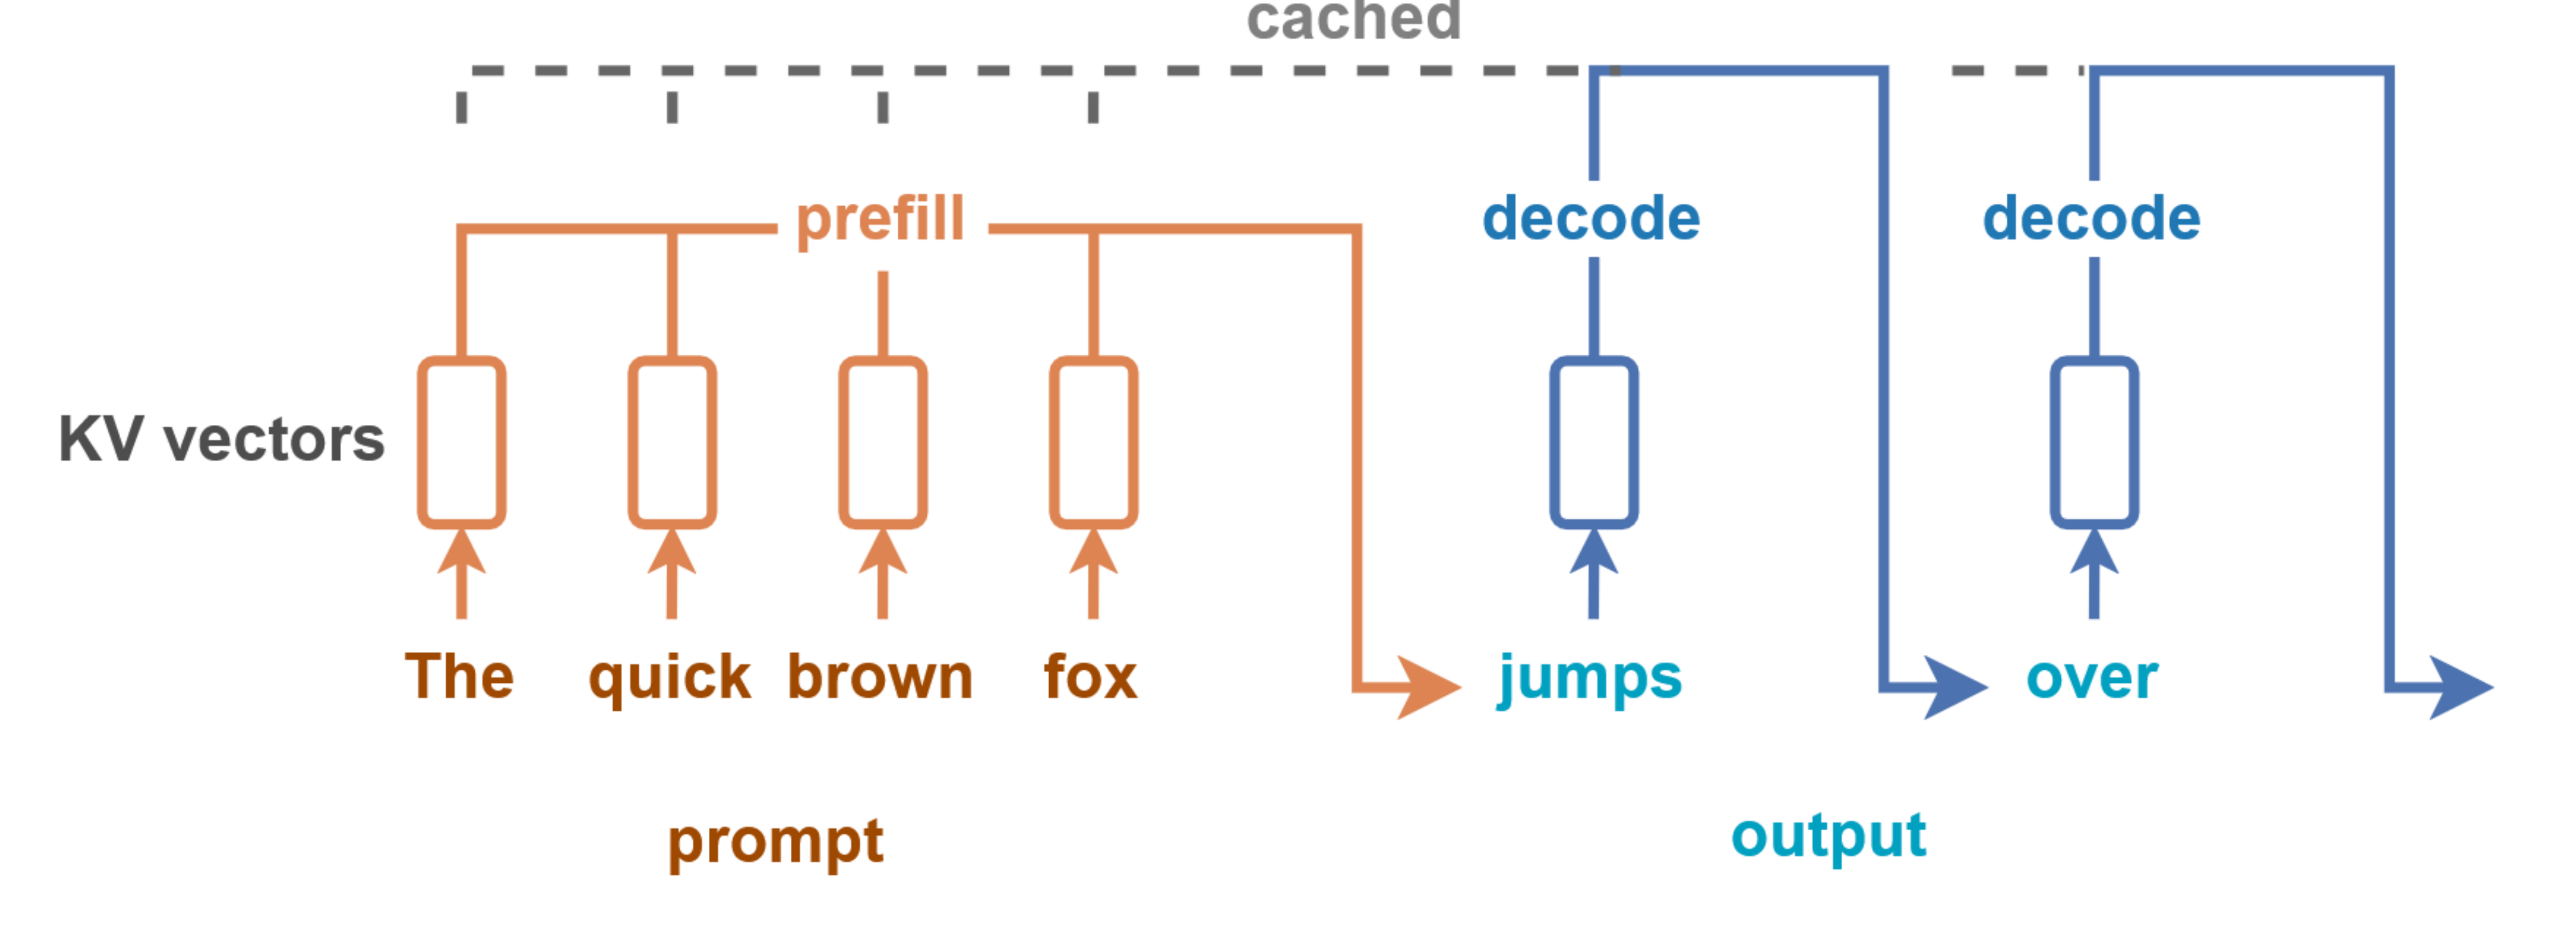
图 12 橙色部分是已知输入一起预填充。蓝色部分每次只新生成一个 token,前面算好的 KV 向量会被缓存,下一步可以继续用。
从 GPU 的角度看,Prefill 里大批矩阵运算往往更容易把计算单元用起来。Decode 一次新处理的 token 少,仍然要从显存读入模型权重和缓存,典型情况下更容易碰到显存带宽的限制。到底卡在哪,还会随批大小、模型和硬件变化。
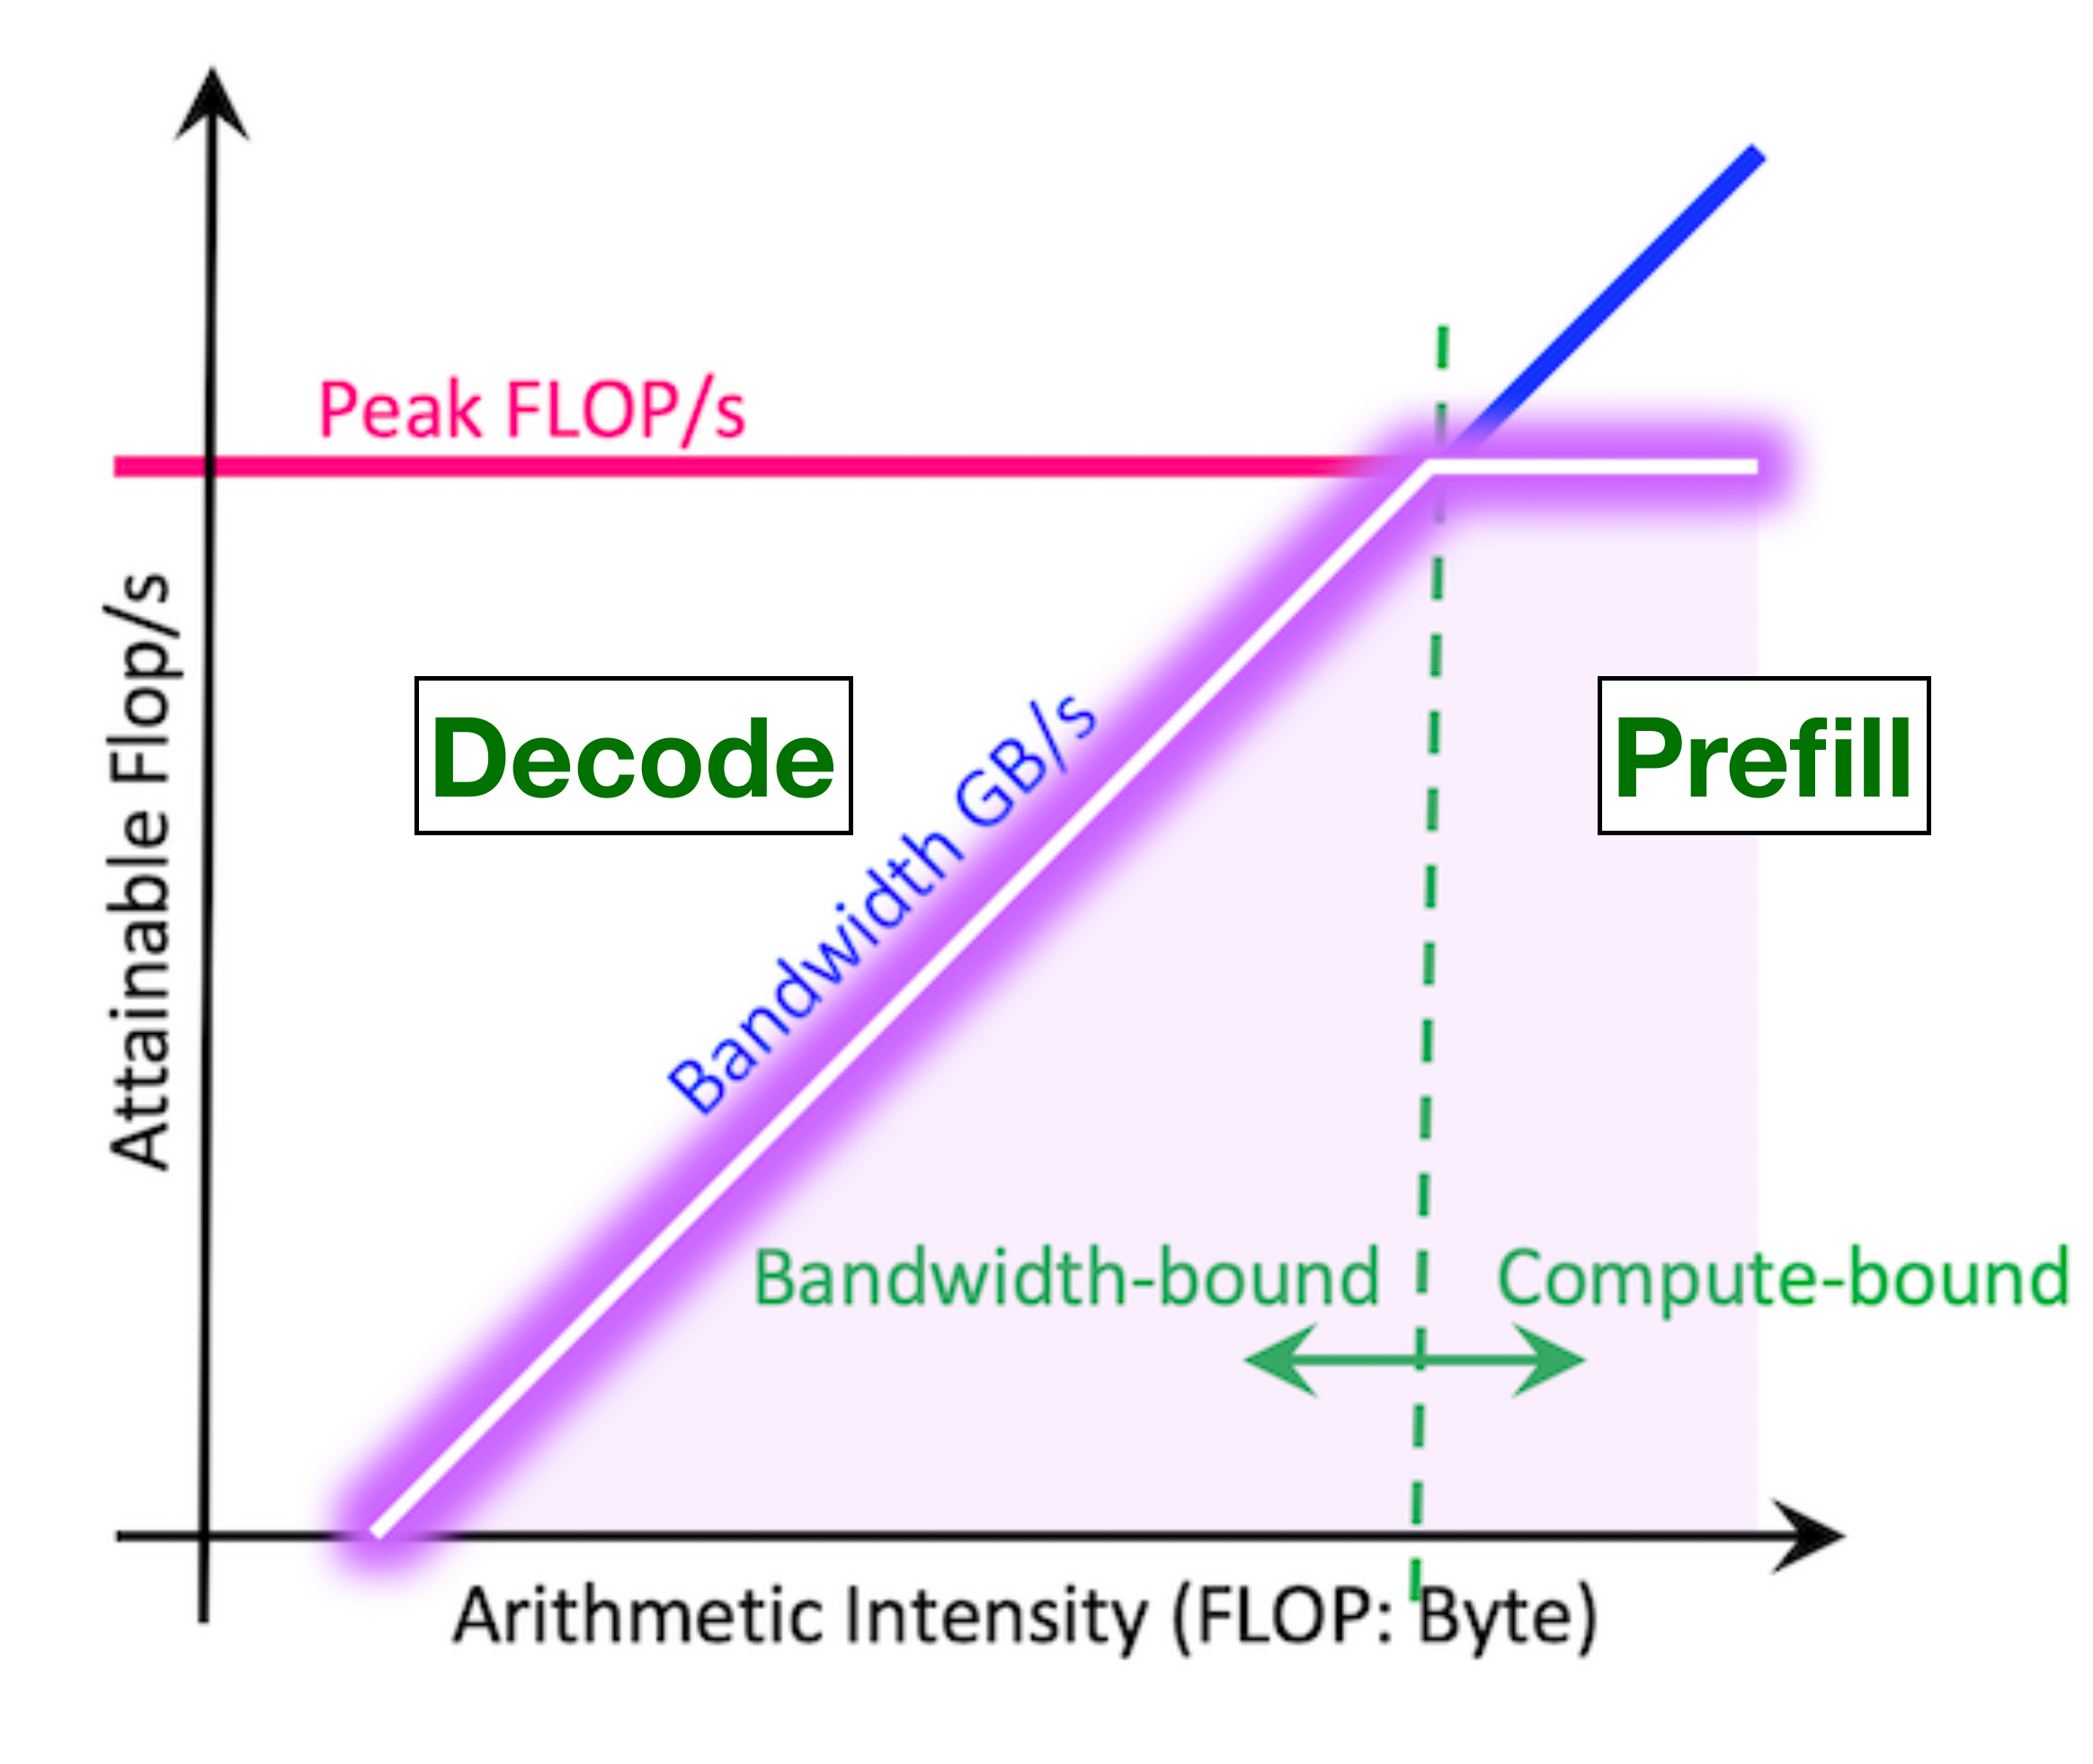
图 13 横轴是每读写一份数据能做多少运算。斜线一侧更容易受带宽限制,达到水平上限后更容易受算力限制。图里给出 Prefill 和 Decode 常见的位置。
看一款推理服务的性能,最好问清是哪个指标。首 token 延迟(TTFT)是发出请求以后多久看到第一点输出。每 token 耗时(TPOT)关注开始输出后每个后续 token 的节奏。吞吐量则是服务整体单位时间能处理多少。Agent 一次任务可能调用模型很多遍,两头的延迟都会累积。
投机解码如何提速?
投机解码让小模型先草拟几个 token,大模型一次验证一串候选。候选能被接受,就省下逐个用大模型生成的轮数。遇到不接受的候选,从不匹配的位置按相应规则继续。原论文里的校验规则可以保持目标模型的采样分布[9],提速多少和草稿的接受率、验证成本有关。
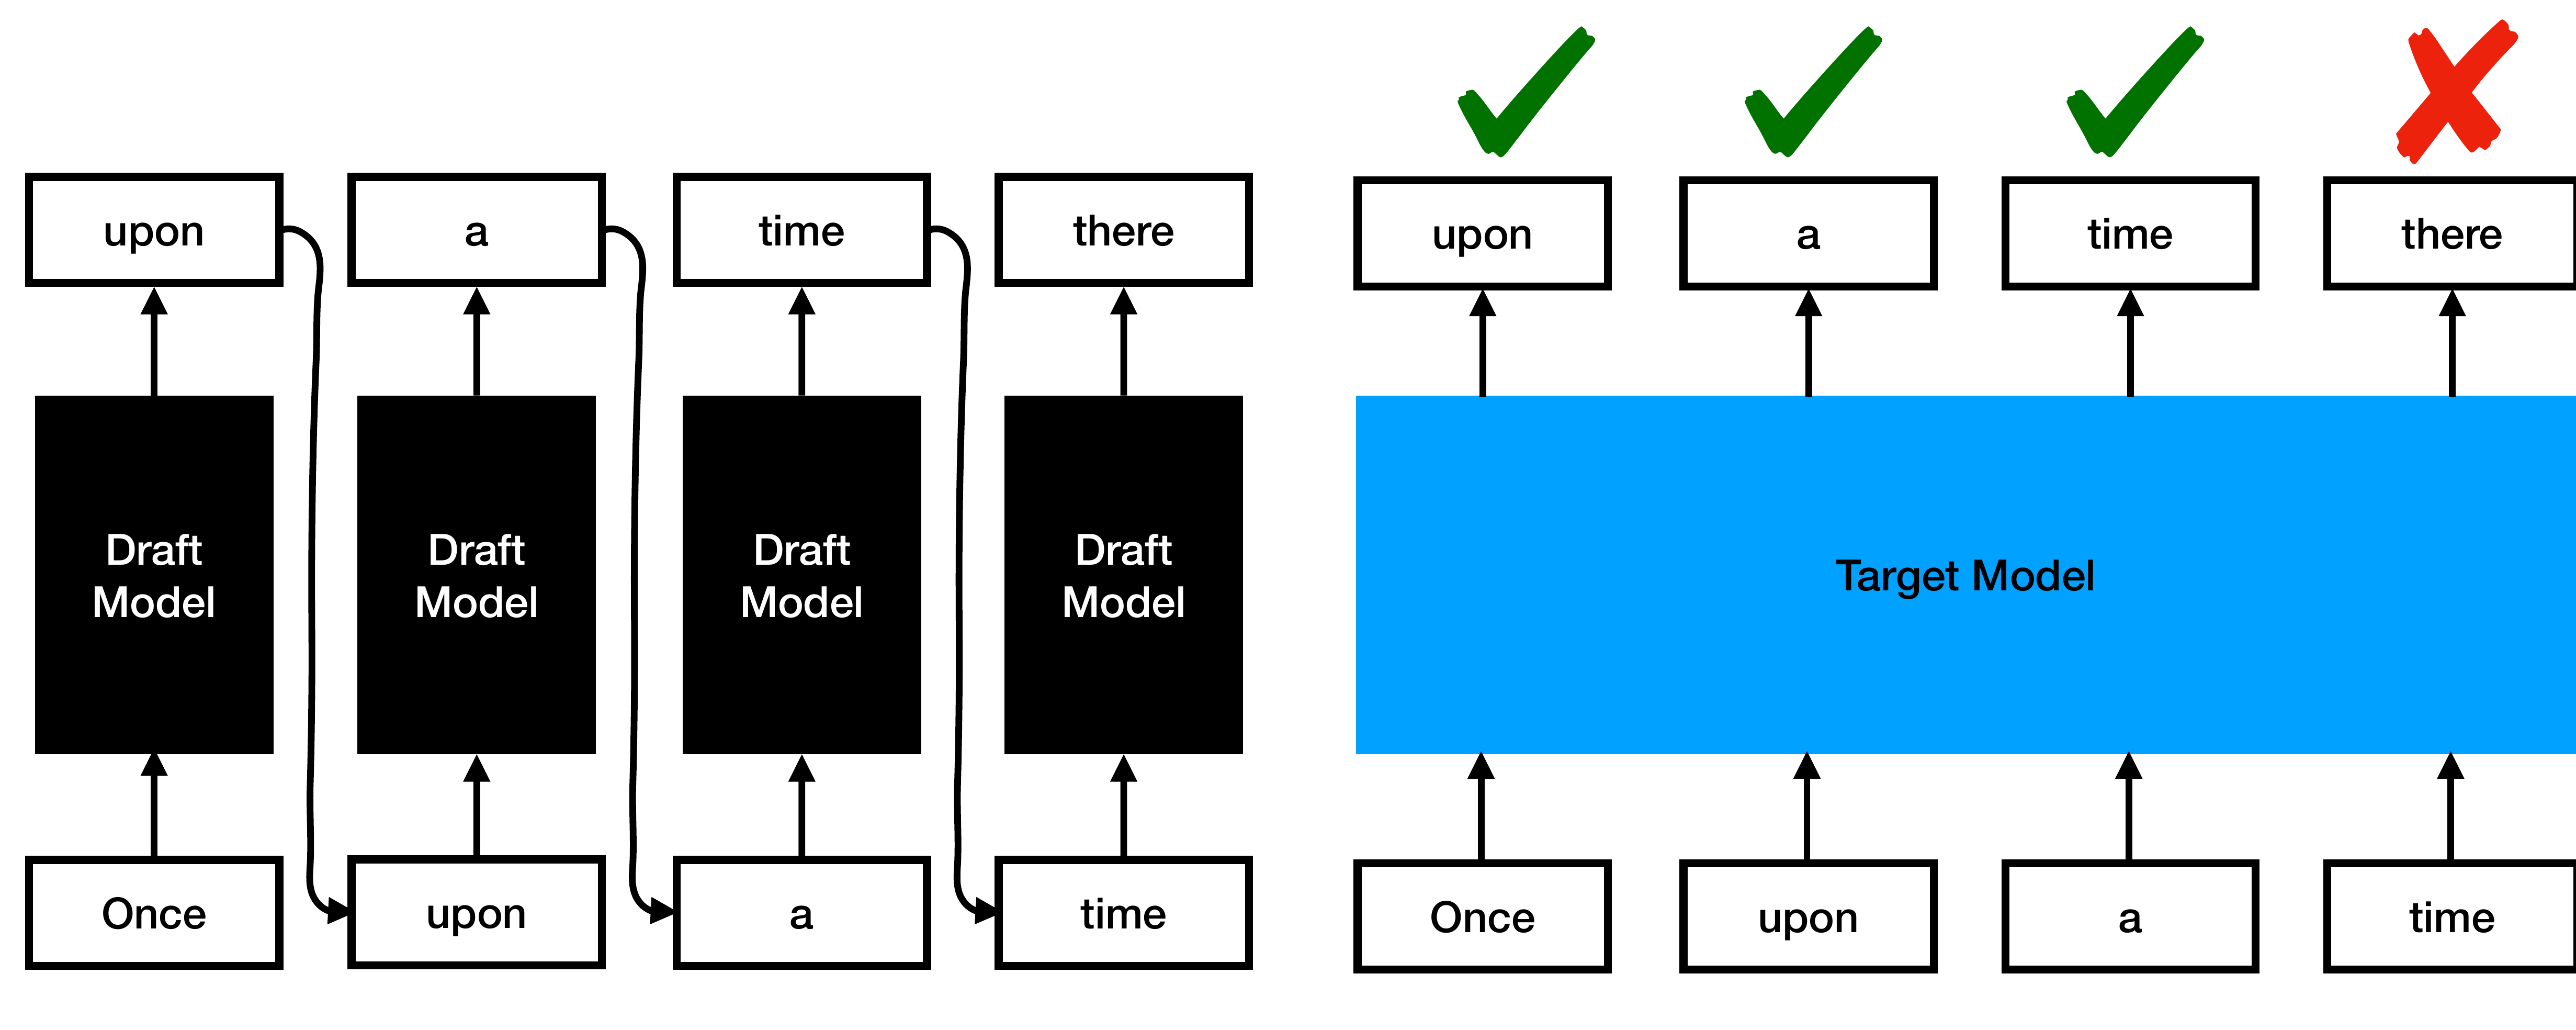
图 14 左边的小模型连续写出草稿,右边的大模型并行检查。绿色勾是被接受的候选,红叉之后就不能沿用那段草稿。 来源 [9]Fast Inference from Transformers via Speculative Decoding
05 测试时多算一点,算在哪里?
测试时扩展(Test-time Scaling)说的是同一套模型权重,解题时投入更多计算。有一种做法是给一次回答更多推理预算,让模型把步骤写长一点、检查几轮。有的模型提供低、中、高几档推理强度。更长的输出会带来更多延迟和 token 消耗。
还有一种做法是同一道题采样多次。如果会写验证器,就分别检查,留下通过的答案。比如代码能跑测试,题解可以跟标准答案比较。如果暂时没有好用的验证器,可以用第一篇讲的自一致性,让模型走几条解题路线,从结果里选更常见的答案。投票能筛出一致意见,几次回答一起犯同一个错误时,它也会把错答案投上去。
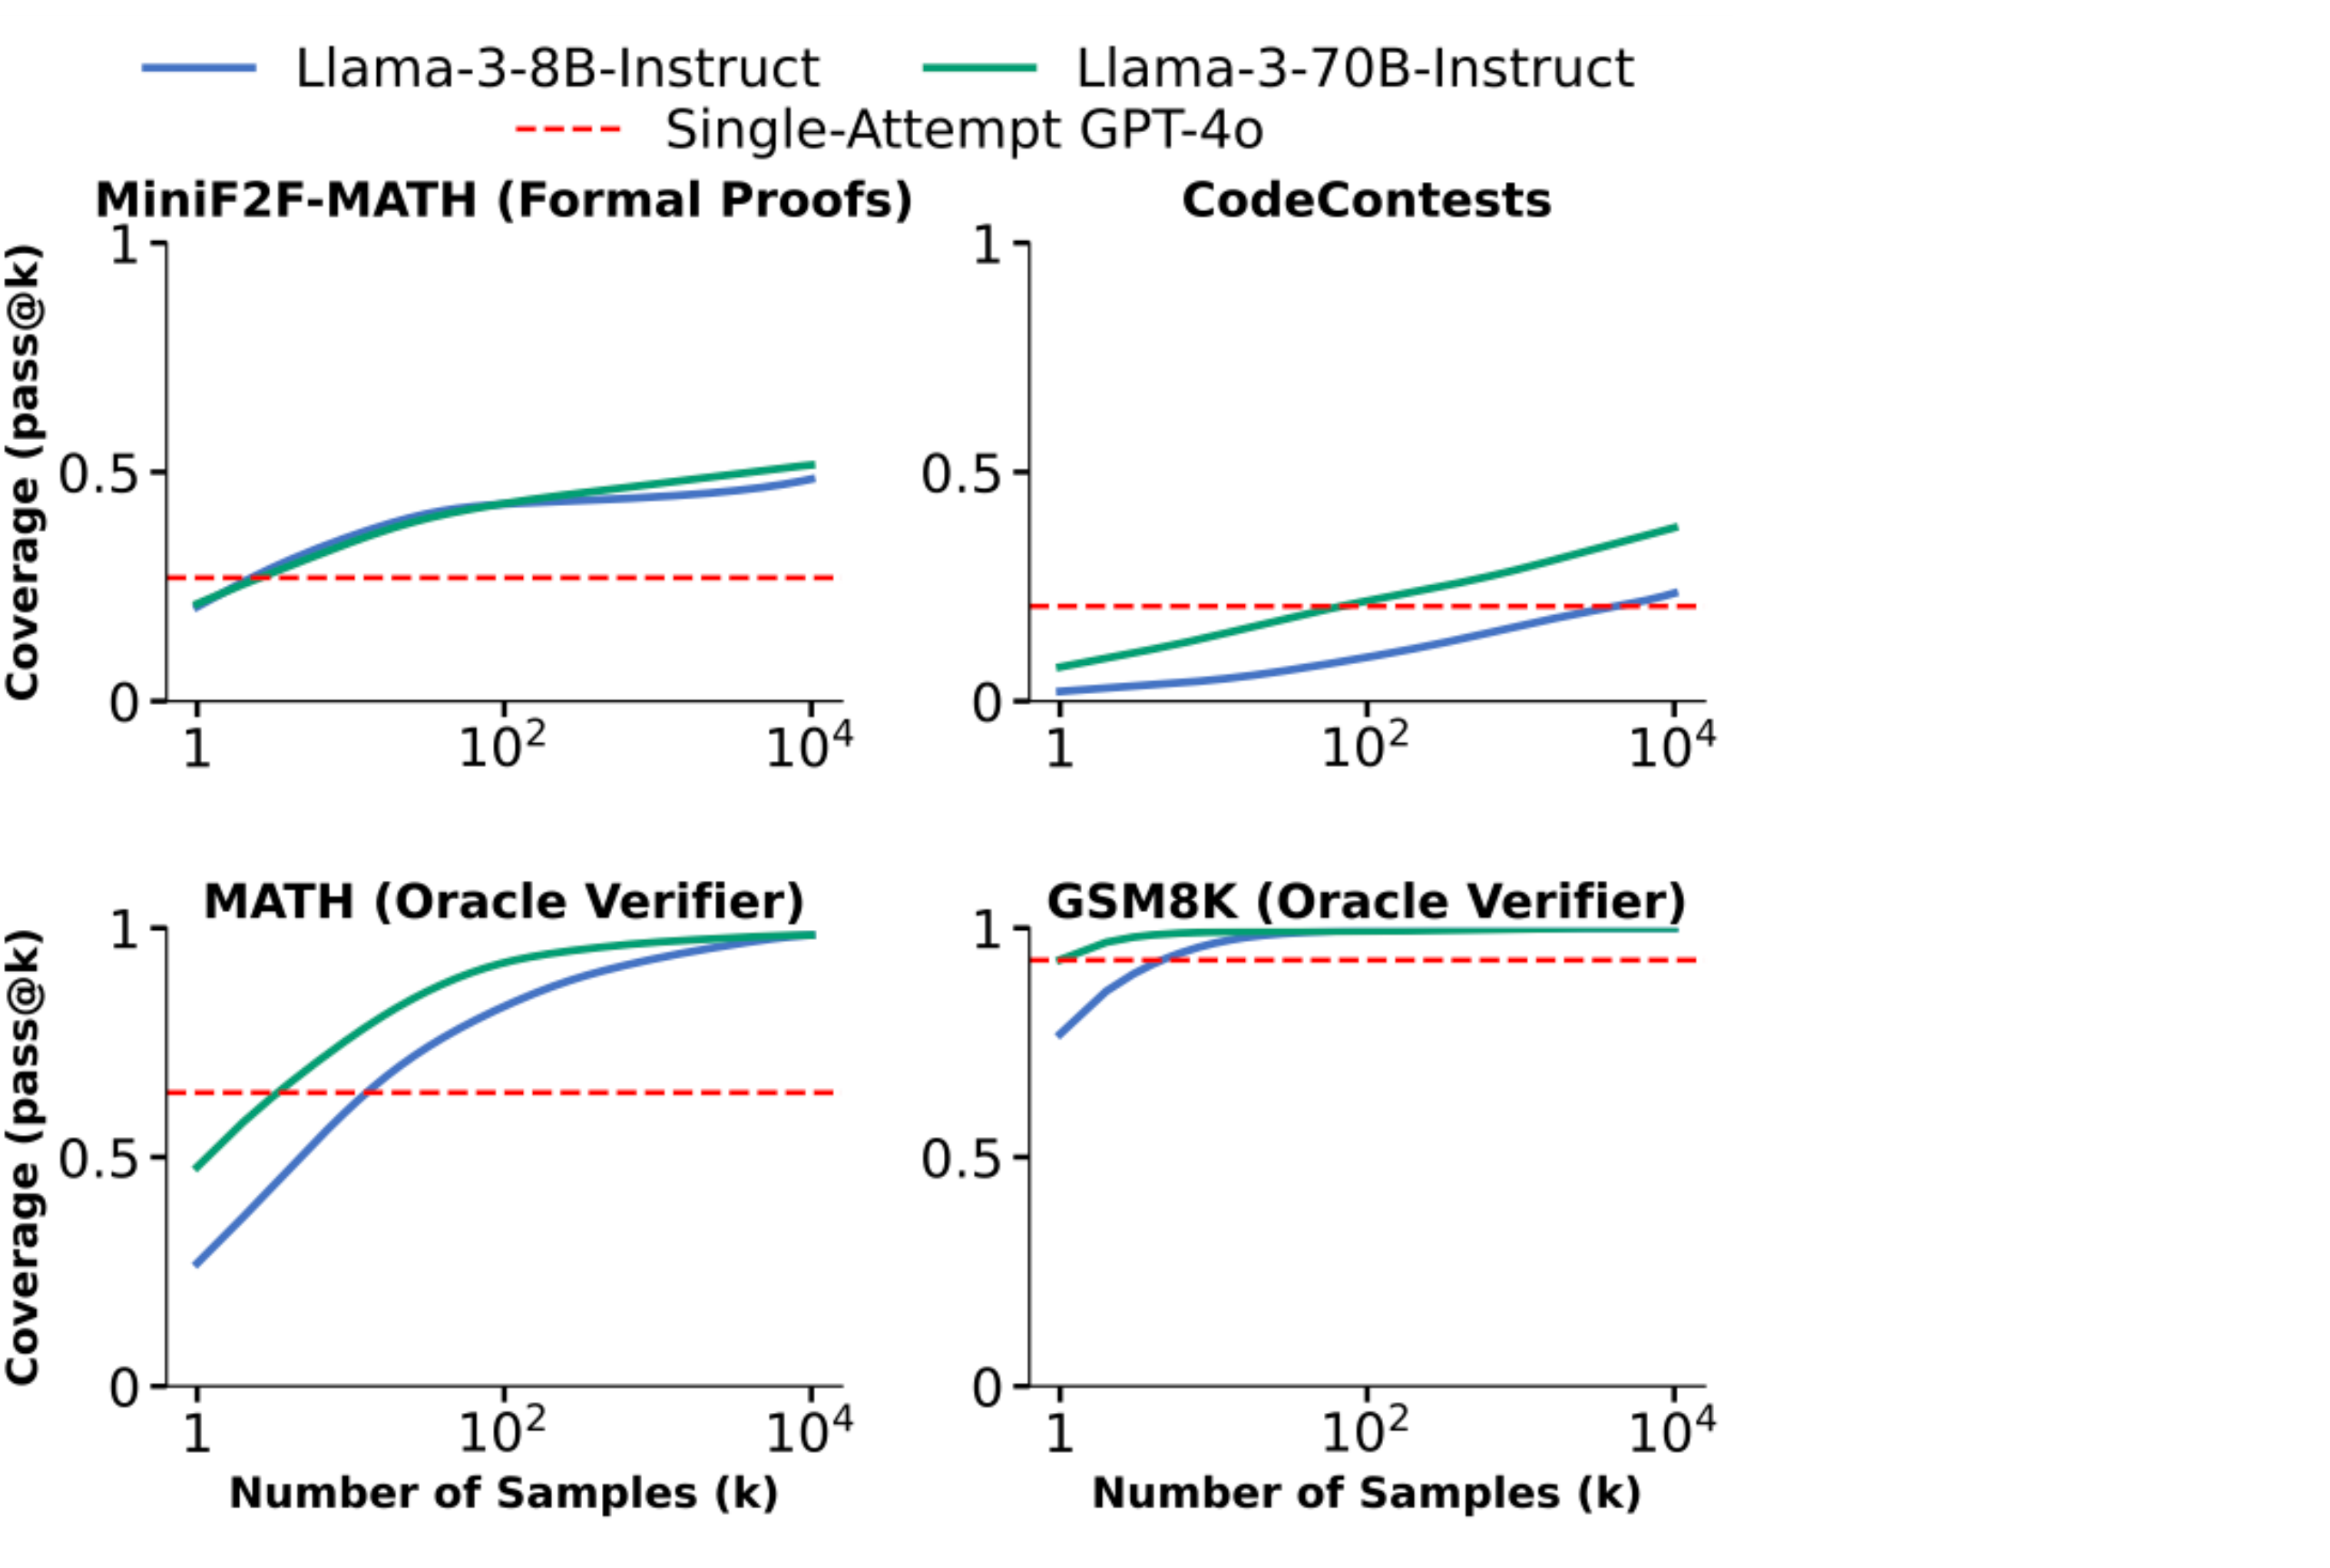
图 15 横轴是采样次数,纵轴看样本里至少出现一次正确解的比例。多试几次能增加遇到正确解的机会,实际还要有办法从候选中选出来。 来源 [10]Large Language Monkeys(重复采样)
06 模型接进程序,输出得能被程序读懂
Agent 经常要让一个组件把东西交给另一个组件。比如从邮件里抽出联系人和意图,后面还要分派给程序。光在提示里写「请输出 JSON」有时仍会产出额外文字,或者把本来要在几个选项里取的值写成自造标签。
结构化输入输出先定义好这个交接约定。比如 DSPy 的 Signature 可以声明有哪些输入、输出字段和字段类型,框架再据此组织提示和解析输出。约束解码往前走一步,在生成时按语法筛掉不合法的 token。类似 SGLang 的方案能用状态机跟踪当前位置允许写什么[11]。
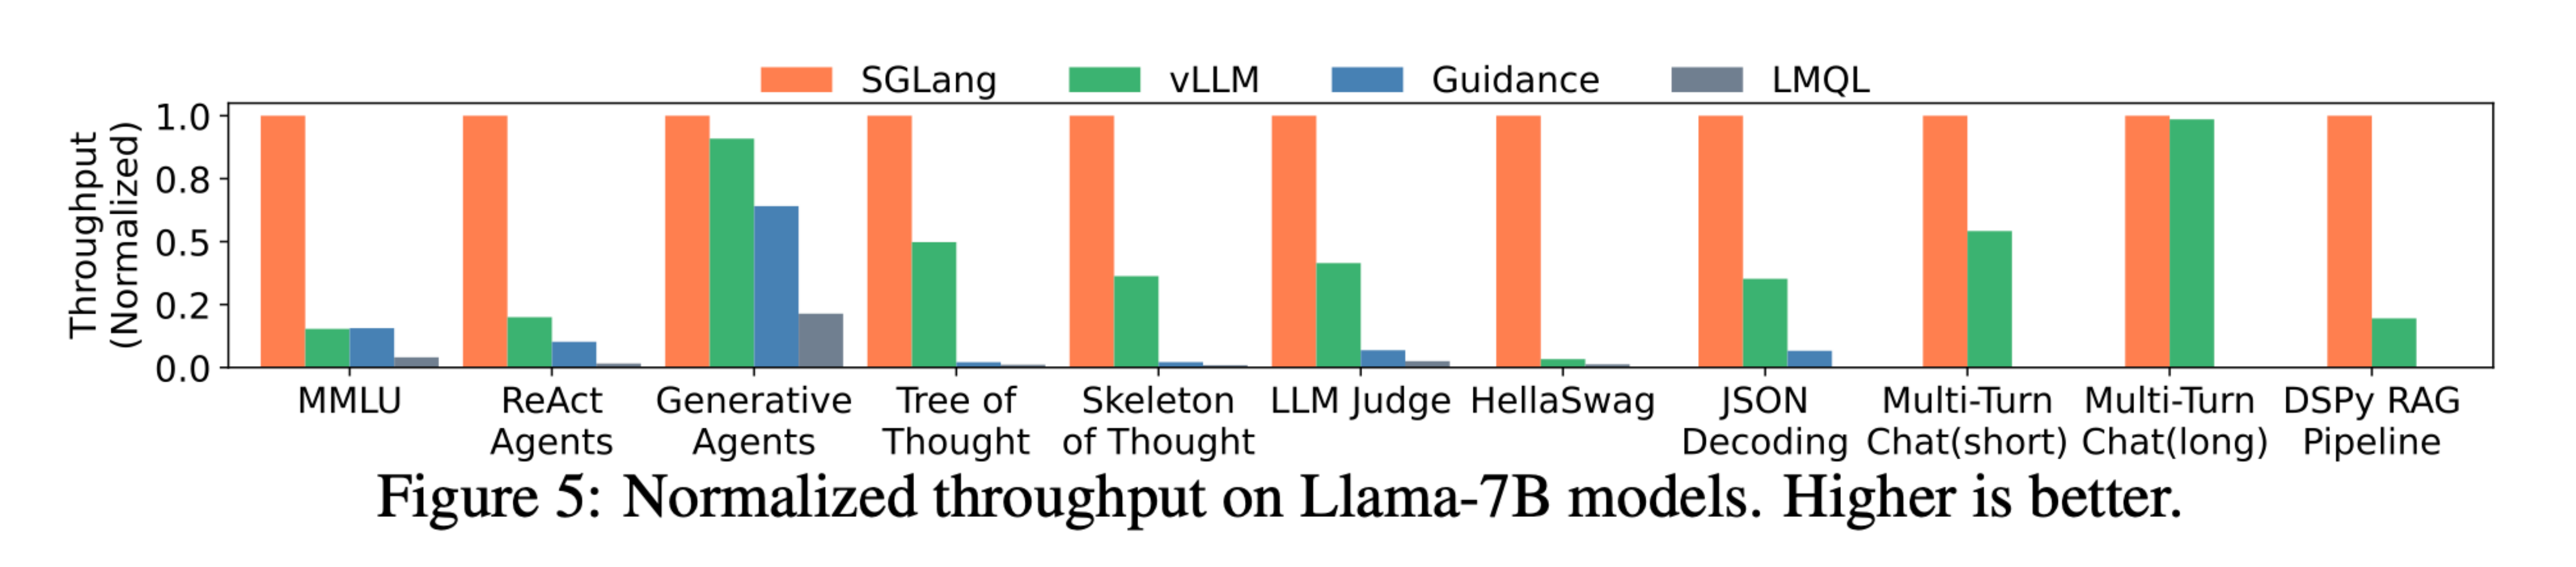
图 16 图里比较了不同运行方式在若干结构化任务上的吞吐。它对应的是按指定结构生成的过程,作者使用有限状态机等方式实现约束和加速。 来源 [11]SGLang 论文
格式合法之后,内容还要再验。假如工具参数里要求一个字符串,校验通过只代表字段类型对了。这个字符串写的是不是正确文件、Agent 有没有权限去读,得由应用和工具检查。分类任务也可以直接用分类器,候选动作有限时可以用只在候选里做选择的决策模型,省去生成一整段再解析的开销。
07 上下文工程,决定这一轮让它看到什么
上下文是模型这一轮实际读到的 token。系统提示词、历史消息、工具定义、工具返回值、记忆、检索到的资料和附带文件,都可能占空间。调提示词可以把指令说清楚,上下文工程还管选择哪些材料、在什么时候放进去、旧材料怎么维护[12]。
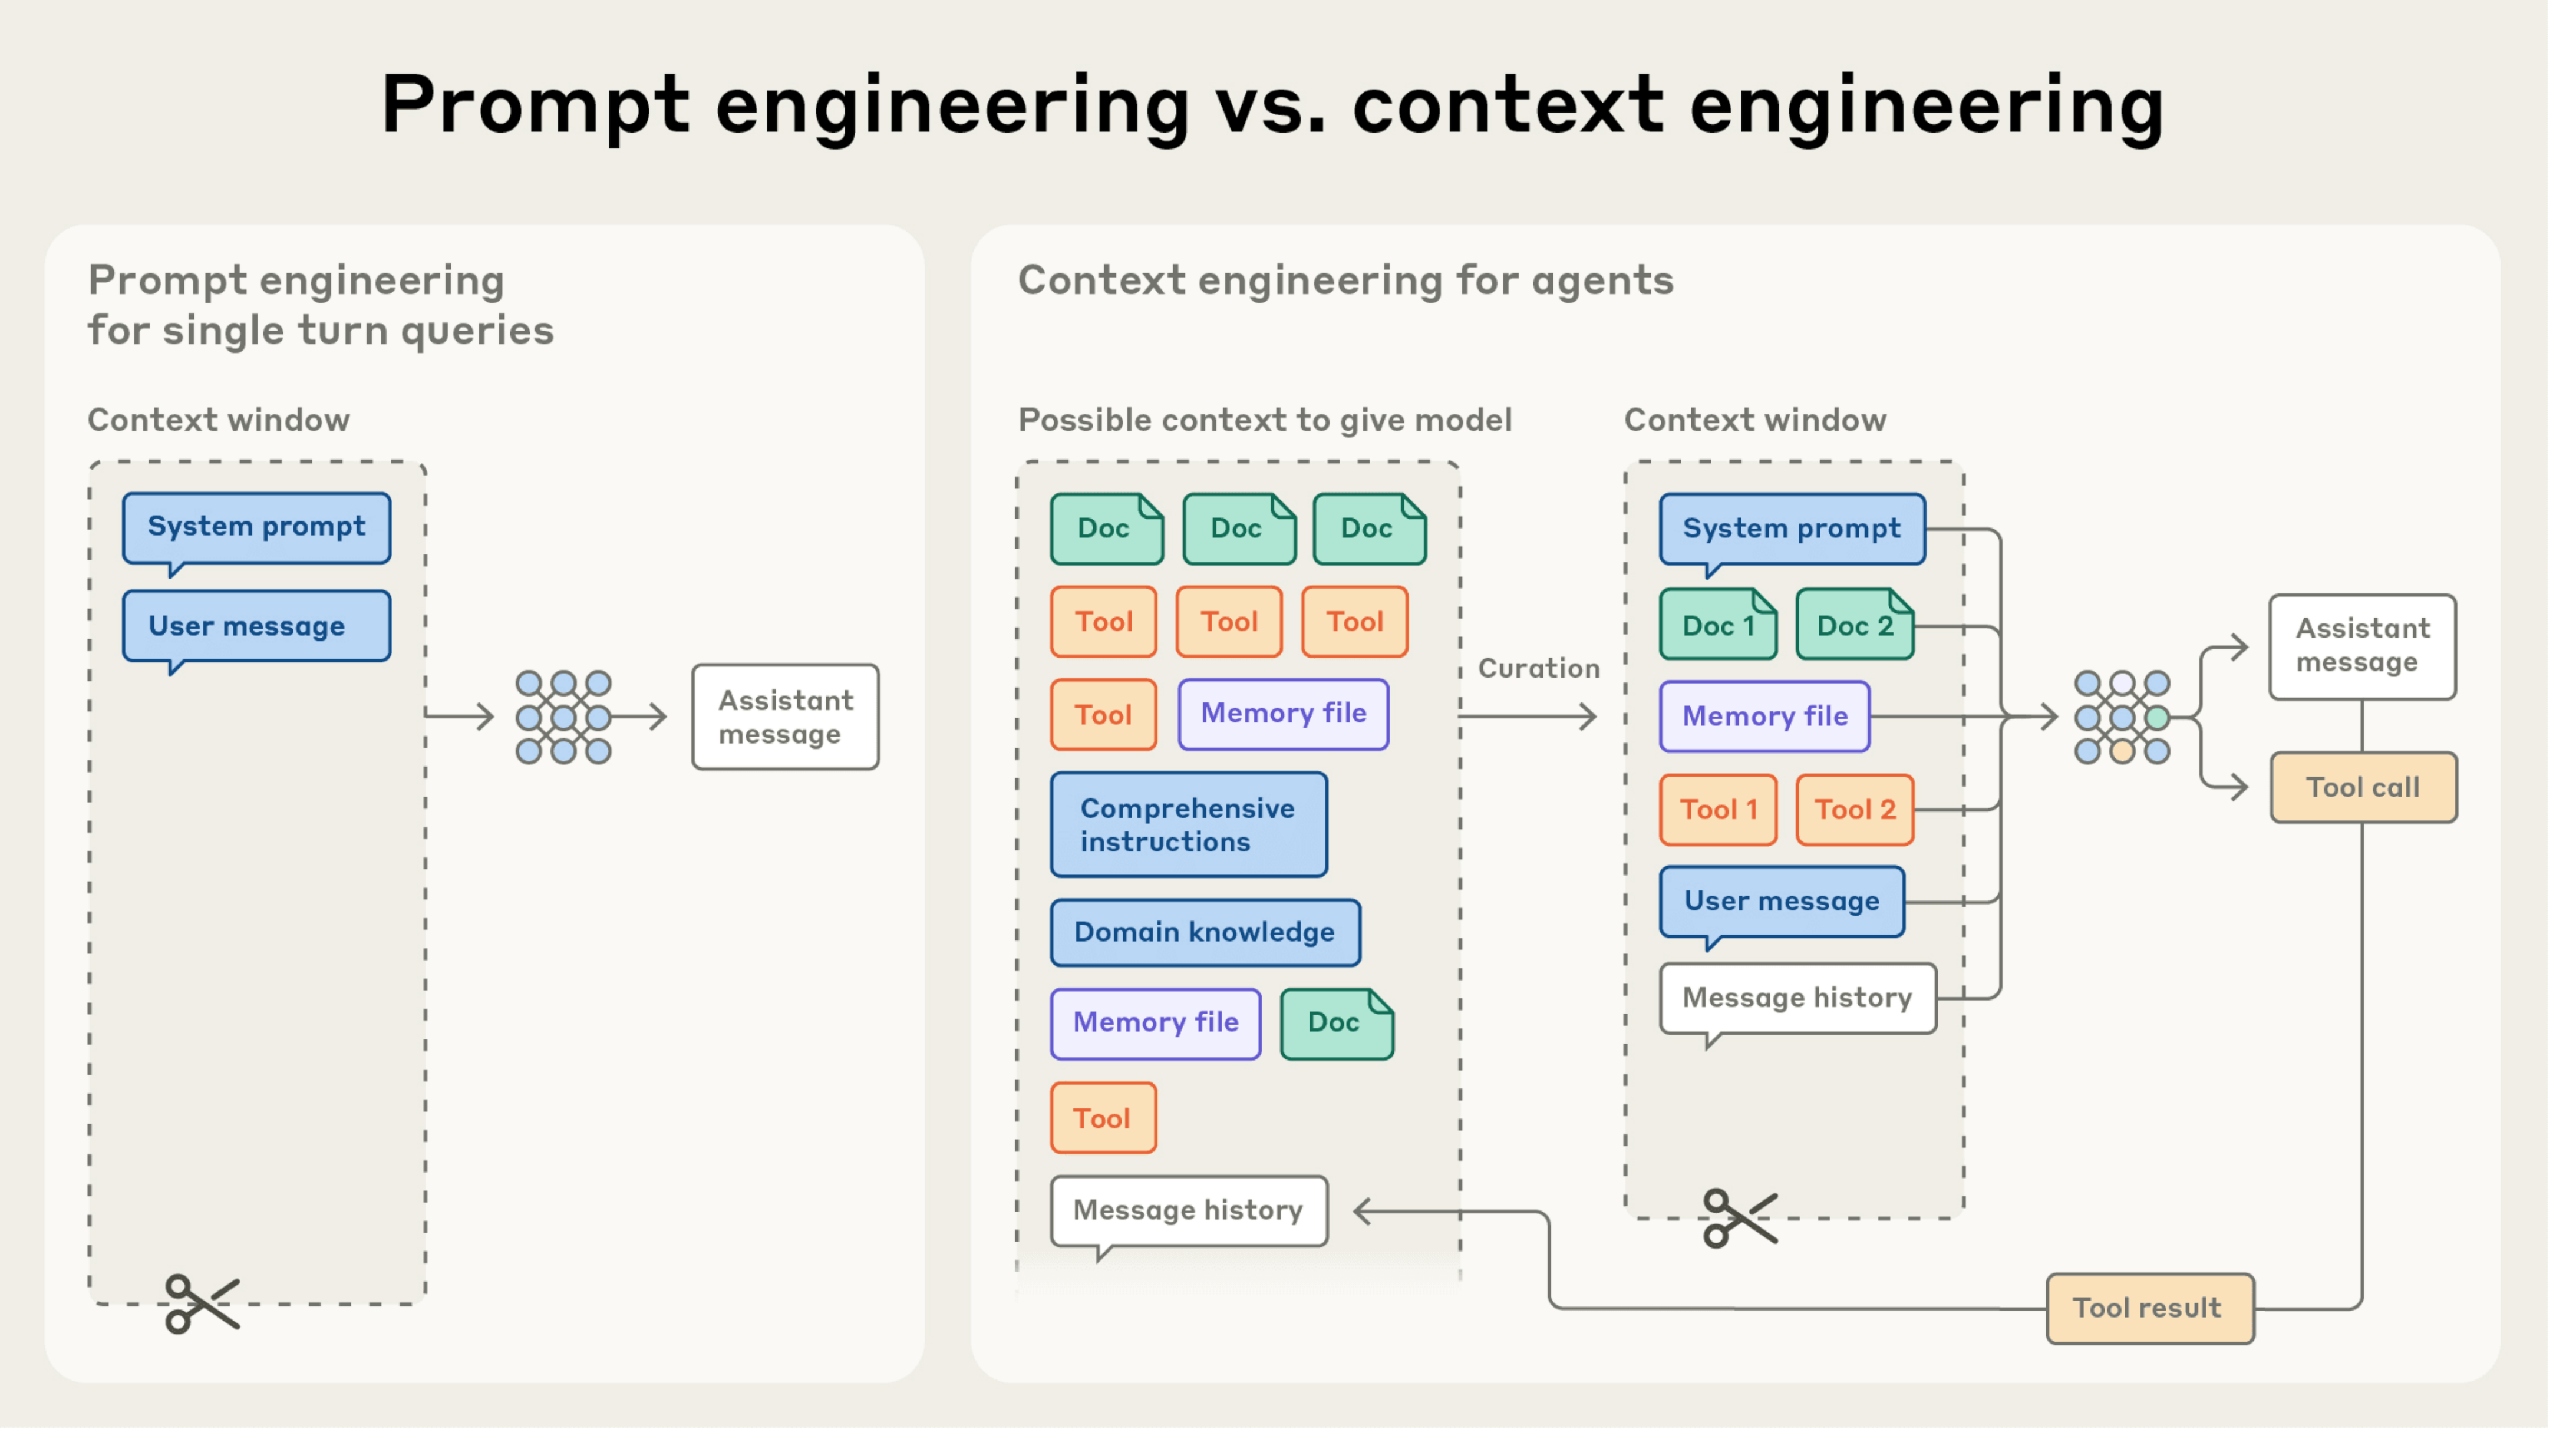
图 17 左边是单轮问答的系统提示和用户消息。右边多了工具、记忆、知识与历史消息,Agent 需要选择其中用得上的内容。 来源 [12]Anthropic 的 Agent 上下文工程指南
材料放得越多,模型越容易被干扰。上下文腐化(Context Rot)说的就是输入拉长以后,有用信息依旧在里面,模型却不一定能稳定找齐、正确归纳。OOLONG 在长上下文聚合任务上展示了这种现象,各模型随长度变化的幅度也不同[13]。比如在一堆新闻里统计哪个月的经济报道更多,模型得先给每篇文章分类,再按时间汇总。这个任务比在长文里找一句话更依赖持续追踪和聚合。
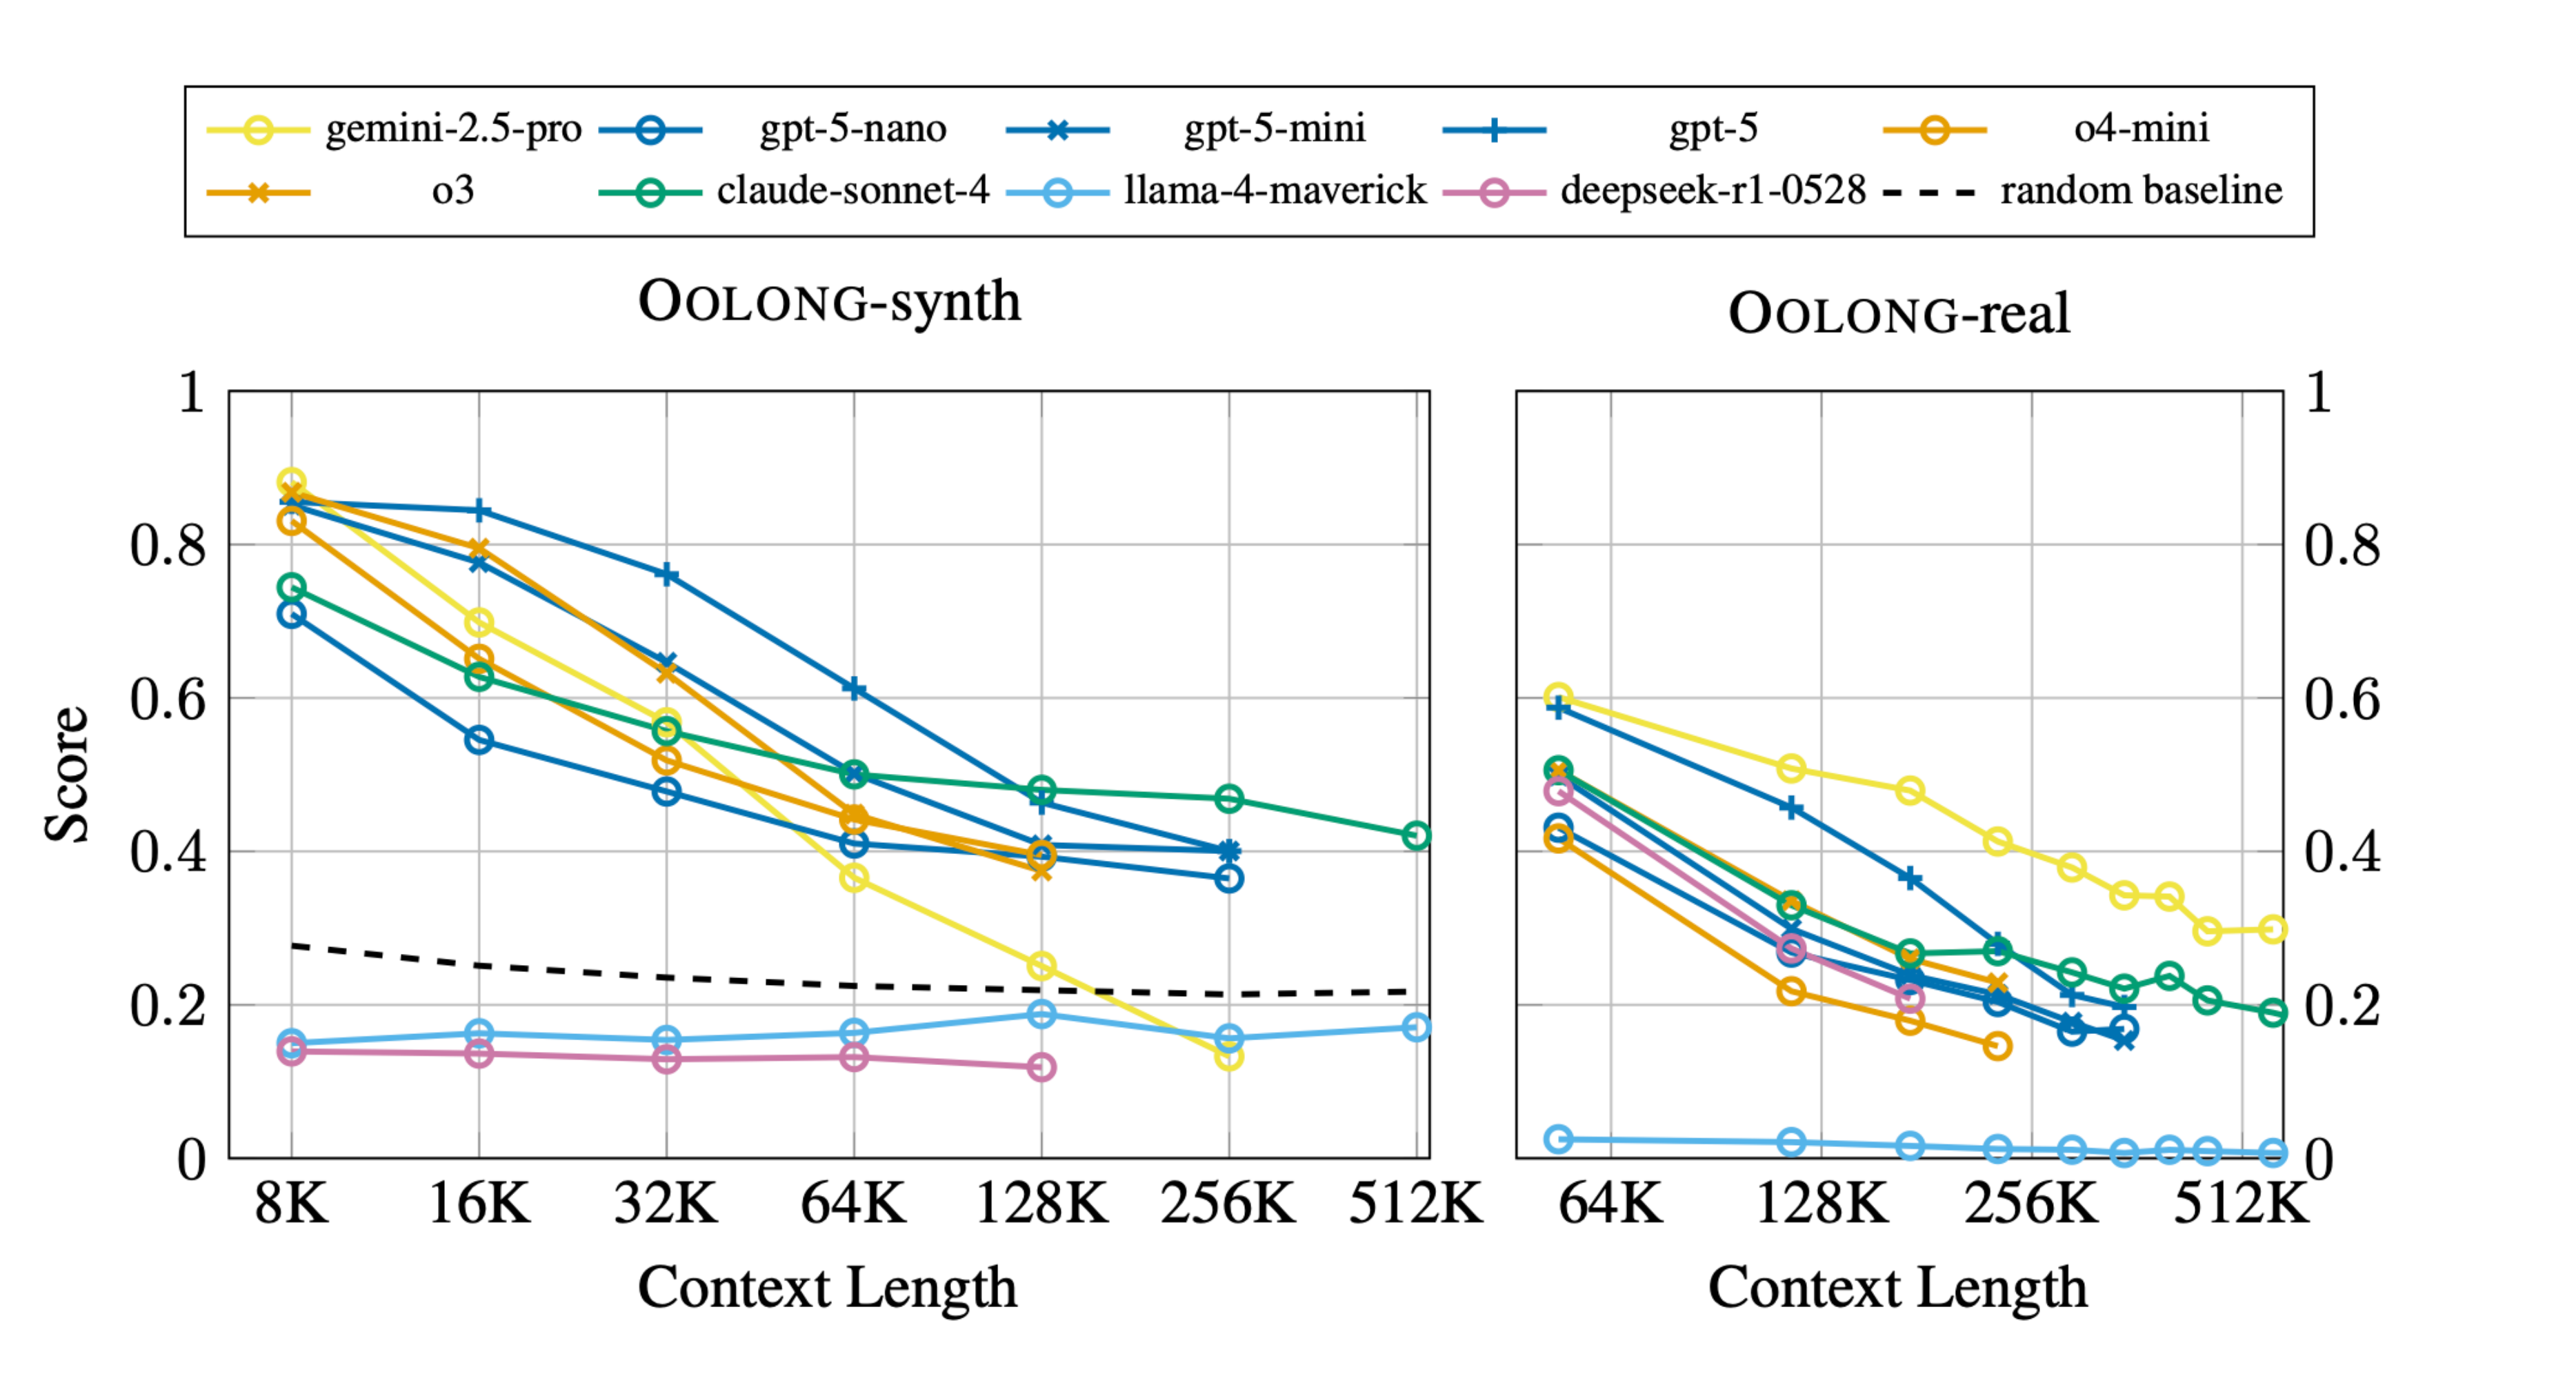
图 18 横轴是上下文长度,纵轴是任务得分。两组实验里,不少模型的曲线随长度增加往下走。 来源 [13]OOLONG(长上下文推理与聚合评测)
我会从下面四件事下手。
- 按需取信息。 旧文档和记忆可以放外面,需要时再检索。工具列表也可以精简,先让模型看到和任务相关的工具。
- 尽量追加。 服务支持前缀缓存时,已有内容保持原顺序,在末尾加新消息,更容易复用缓存。往前面插字、改老消息会让后面的缓存很难继续复用。
- 需要时压缩。 把已经发生的事整理成短摘要,保住任务目标、用户限制、已经尝试的动作和关键证据。留得太多,没过几轮又得压。留得太少,Agent 会忘掉决定后续行动的条件。
- 做回归评测。 同一批任务分别跑修改前后的上下文配置,看看成功率、延迟、成本和错误类型变没变。只试一个顺手的例子,很难判断改动有没有用。
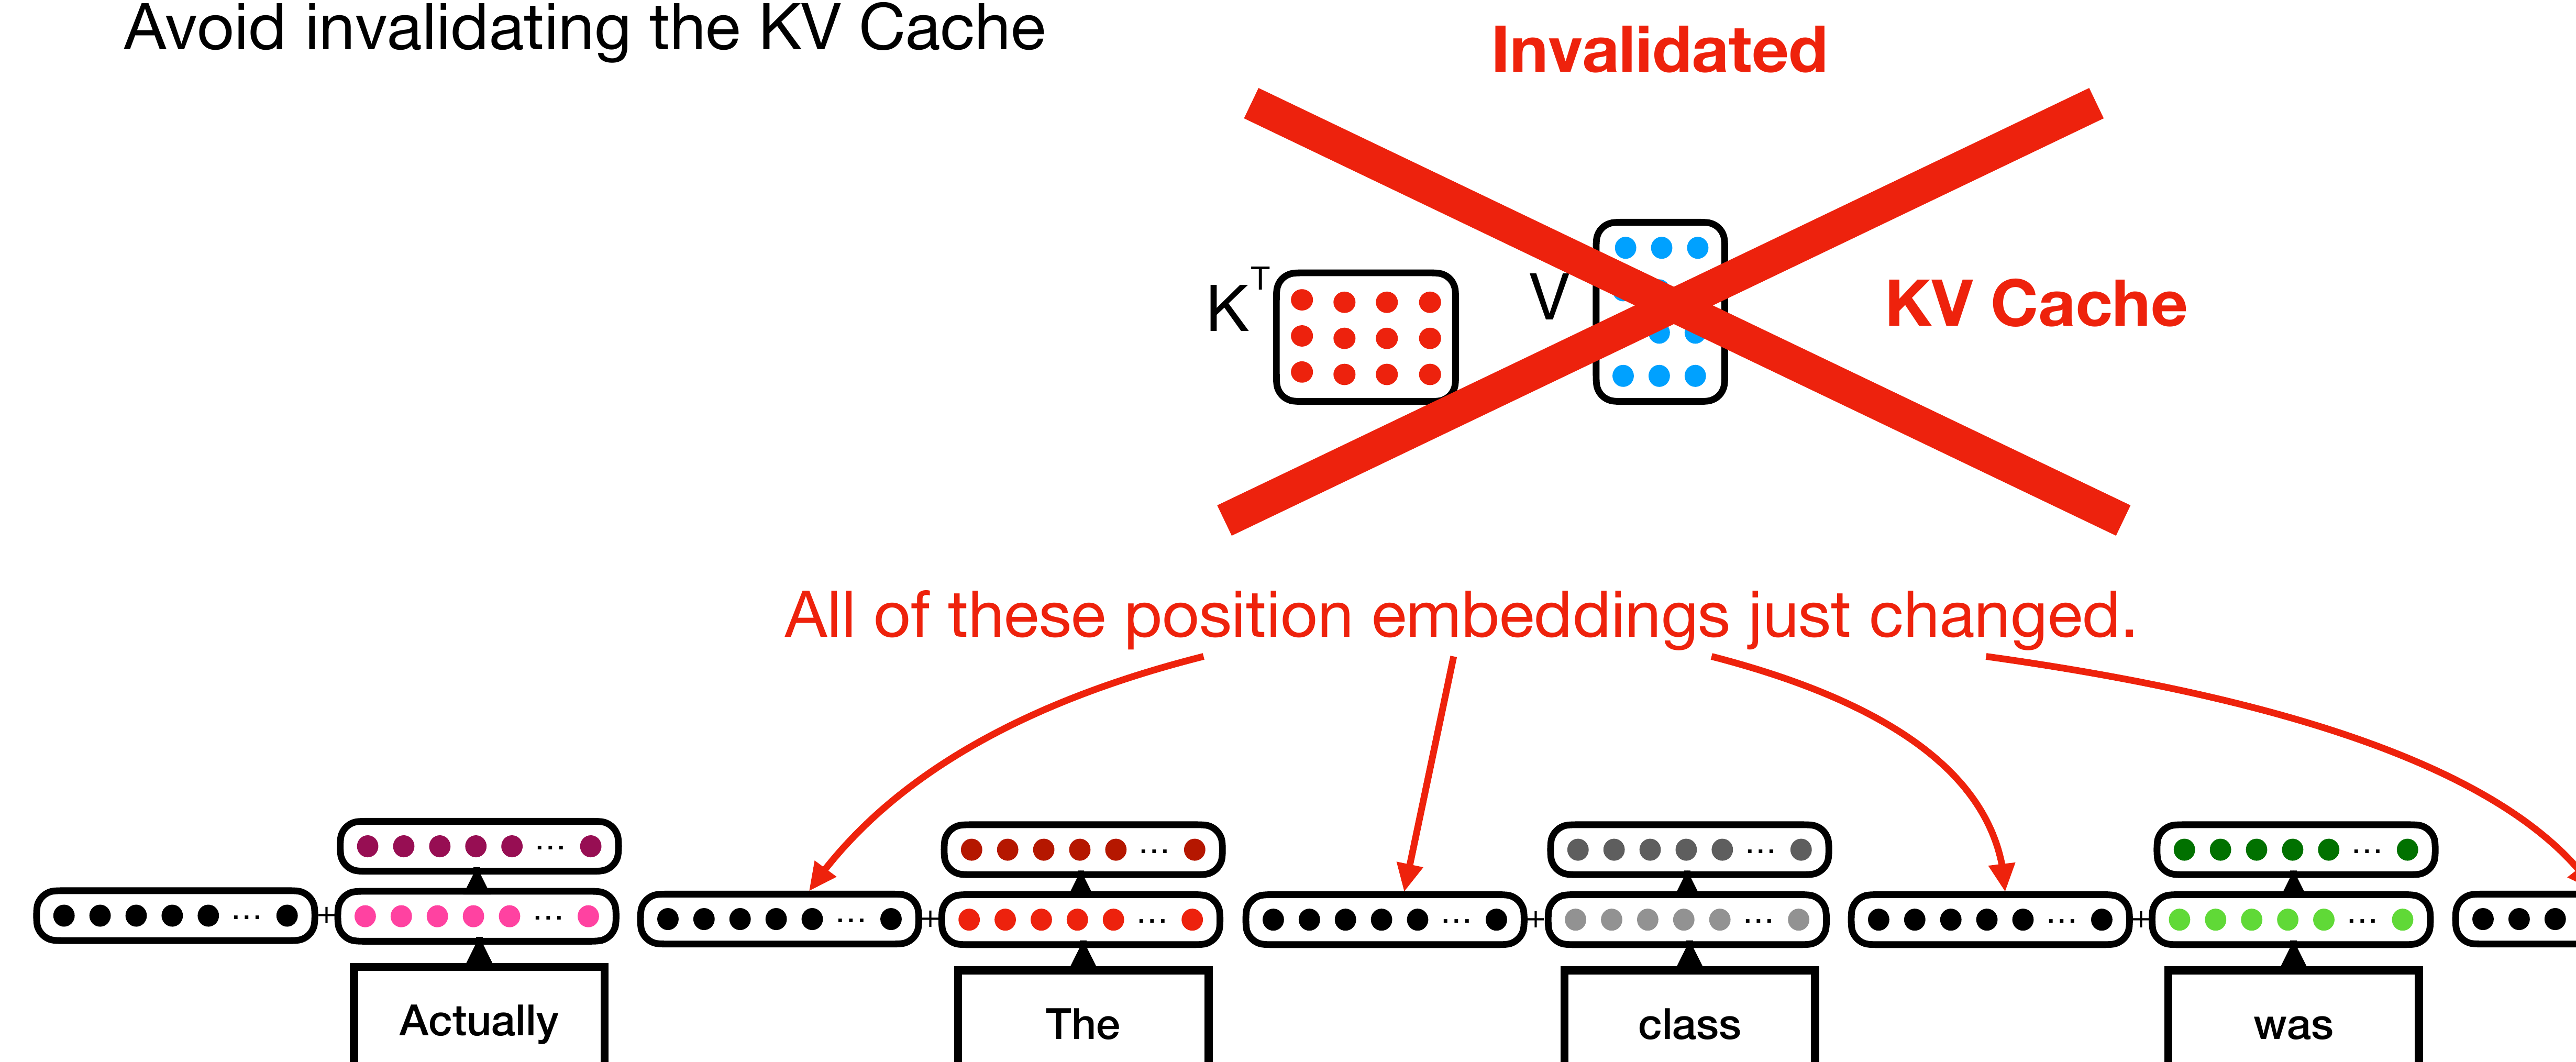
图 19 图里把 Actually 插到了最开头,后续 token 的位置变了,先前的 KV 缓存不能直接复用。追加新内容时可以保住原来的前缀。
递归语言模型(RLM)提供了另一条思路。把很长的输入放到外部执行环境里,让模型先检查、切片、搜索,再把小块材料交给自己或子调用处理,最后合起来[14]。这和一次把全文放进上下文的成本结构不同,代价会转移到调用次数、执行环境和结果汇总上。
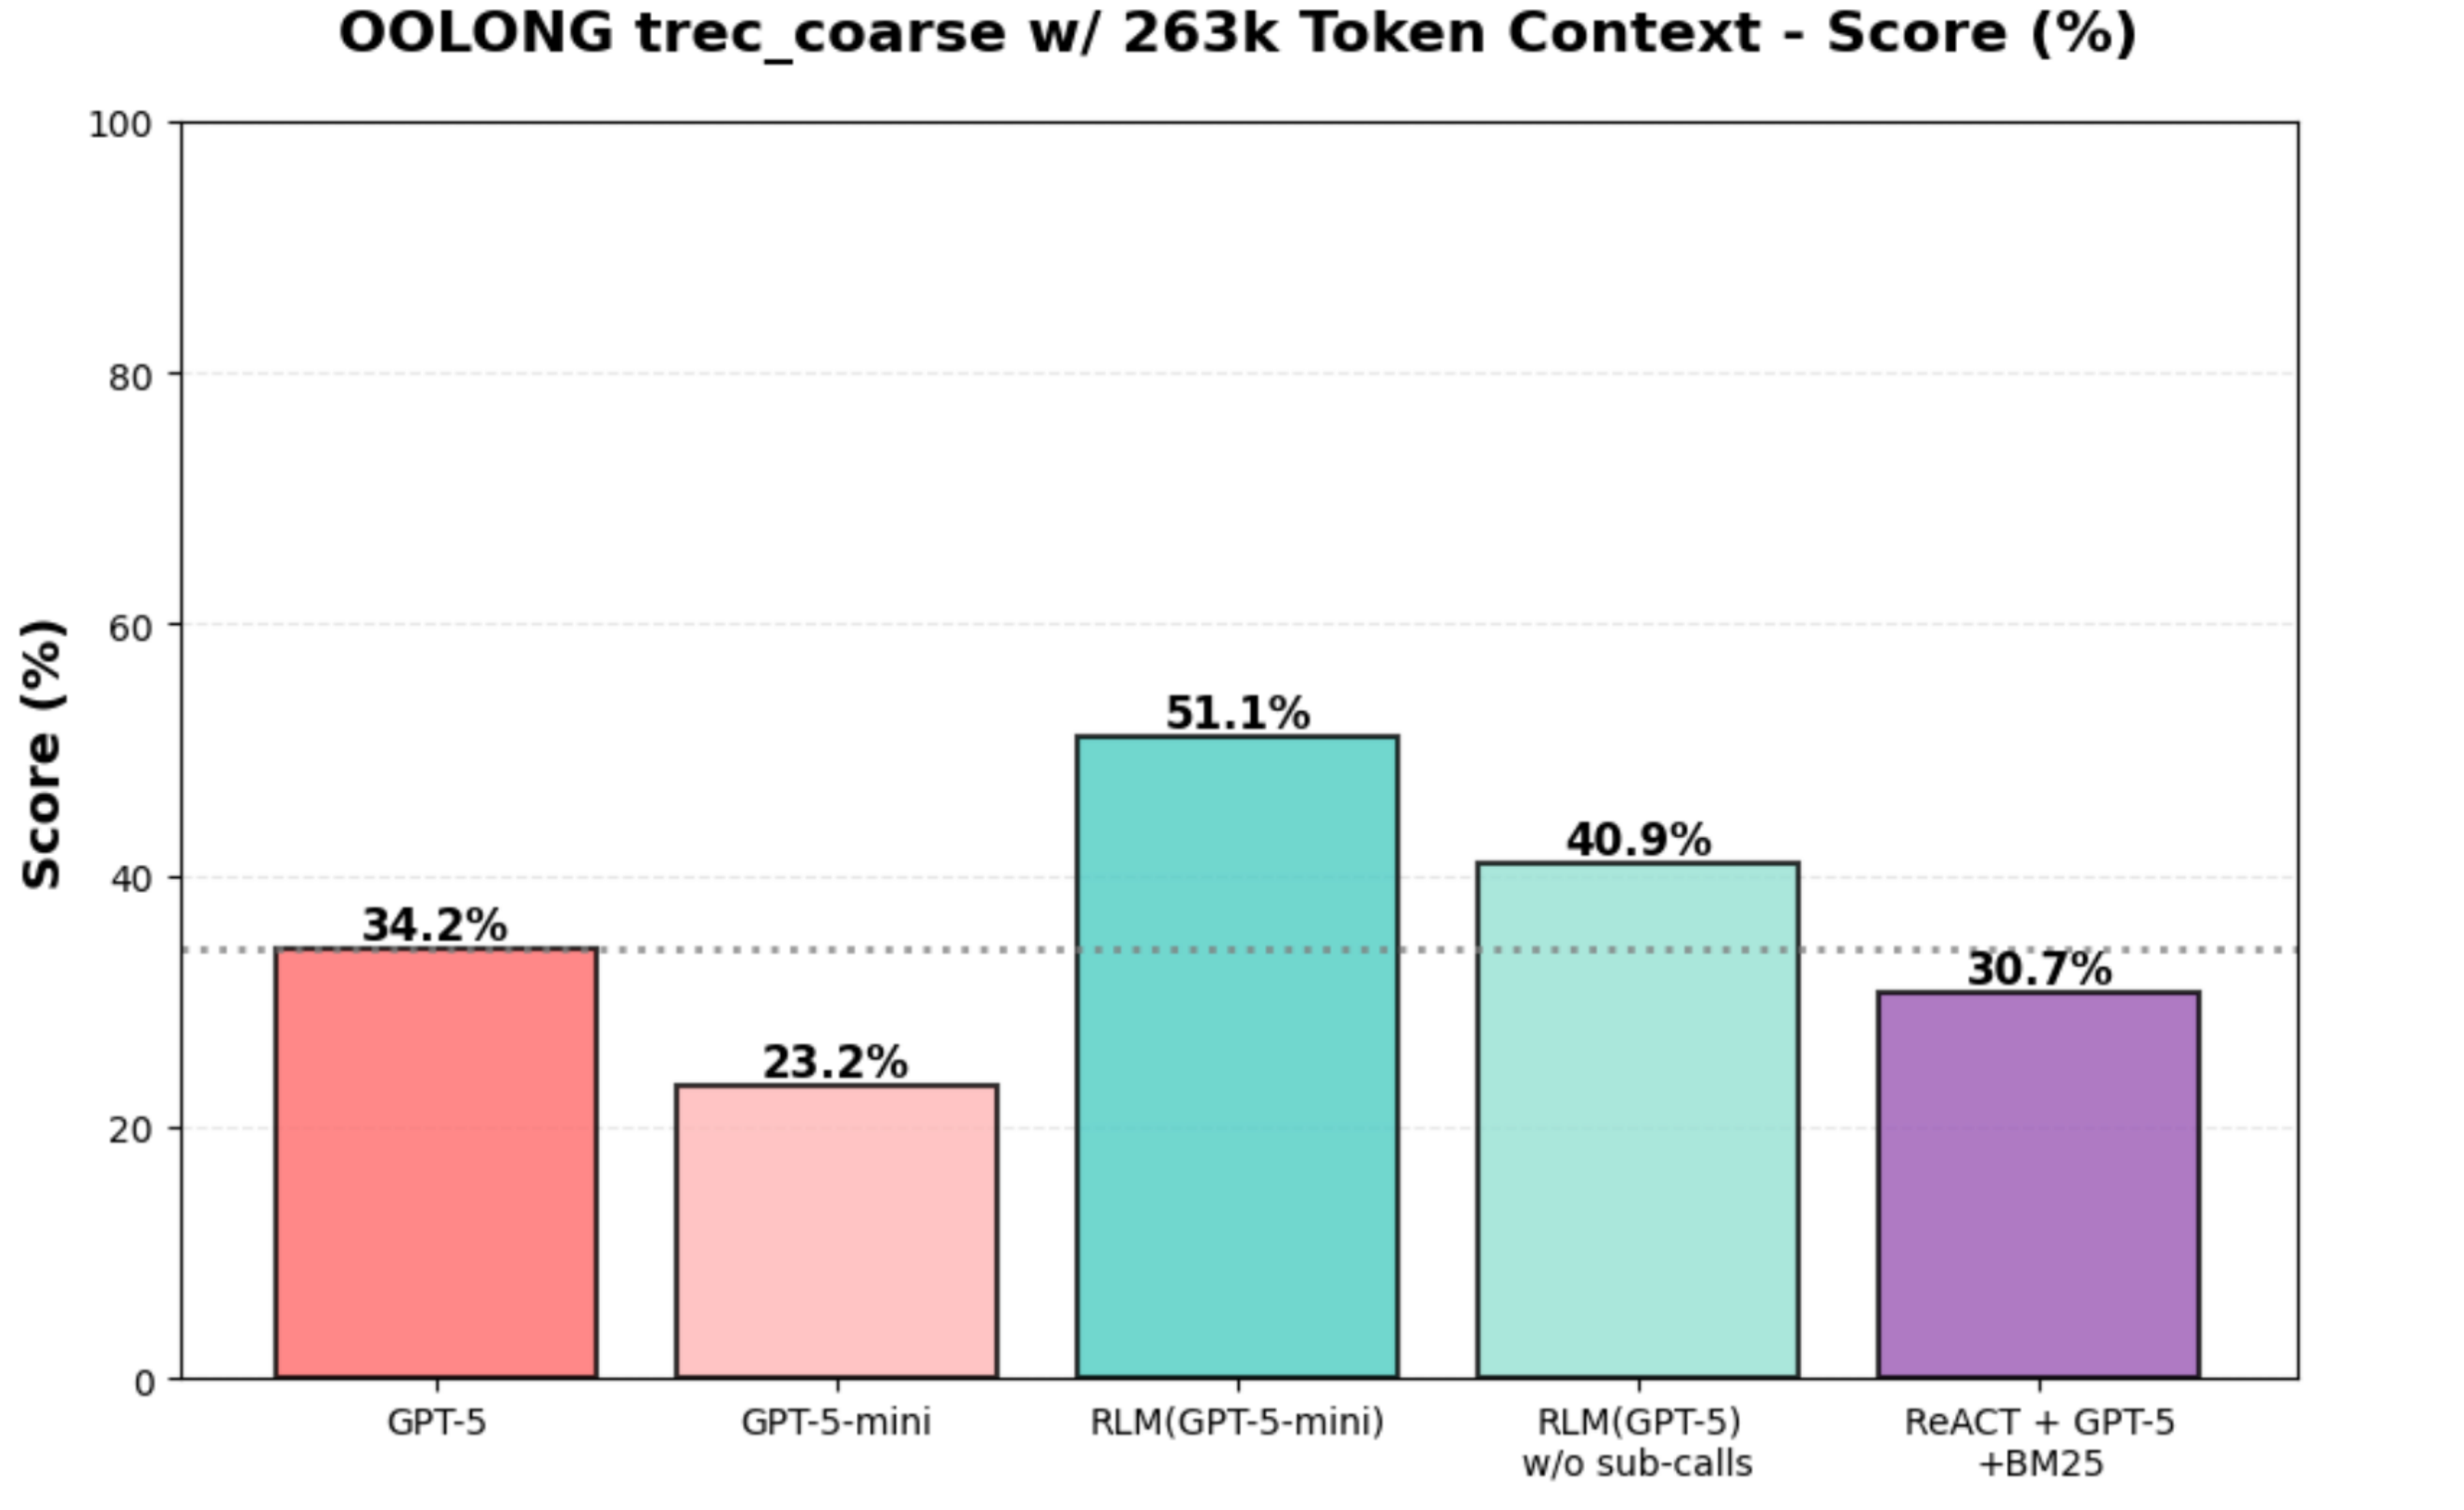
图 20 图里是在同一长上下文任务上比较直接用模型和加入递归机制后的结果。柱子的得分只对应图中的任务和配置。 来源 [14]Recursive Language Models
总结
面试问上下文太长怎么处理,我会先讲清它造成了什么问题,是成本上升,还是重要信息被淹没。成本上去,就看前缀能否复用、哪些东西值得按需检索。任务进度不能丢,就确定压缩时保留什么。最后用同一批任务重跑一遍,验证压缩后还能把原来的活做对。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]Attention Is All You Need(Transformer)
https://arxiv.org/abs/1706.03762
[3]Transformers are RNNs(线性注意力)
https://arxiv.org/abs/2006.16236
[4]Kimi K3 技术报告
https://arxiv.org/abs/2607.24653
[5]Midtraining Bridges Pretraining and Posttraining Distributions
https://arxiv.org/abs/2510.14865
[6]Training Language Models to Follow Instructions with Human Feedback
https://arxiv.org/abs/2203.02155
[7]DeepSeekMath 技术报告
https://arxiv.org/abs/2402.03300
[8]SWE-smith(编程 Agent 训练数据)
https://arxiv.org/abs/2504.21798
[9]Fast Inference from Transformers via Speculative Decoding
https://arxiv.org/abs/2211.17192
[10]Large Language Monkeys(重复采样)
https://arxiv.org/abs/2407.21787
[11]SGLang 论文
https://arxiv.org/abs/2312.07104
[12]Anthropic 的 Agent 上下文工程指南
https://www.anthropic.com/research/effective-context-engineering-for-ai-agents
[13]OOLONG(长上下文推理与聚合评测)
https://arxiv.org/abs/2511.02817
[14]Recursive Language Models
https://arxiv.org/abs/2512.24601