TechGuide「AI Agent 面试专题」第 4 篇 · 工具使用与函数调用
正文约 5000 字 · 预计阅读 10 分钟
大家好,我是声哥。
上一篇聊的是 Agent 怎么查资料。要是用户让它算一笔账、查实时天气,甚至改一笔订单,接下来谁替它动手?这篇从一次函数调用讲起,也把面试里容易混在一起的 Function Calling 和 MCP 摆到同一条链路上。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
01 资料塞进去了,模型就会用吗?
上篇把 RAG 拆成了两步,先用检索器找资料,再让模型读资料。要定位错误,我会先问两句。含有答案的文档有没有进候选集?进去了之后,模型有没有用对?还有几类错误也会出在这个接口上,相近却不相关的资料可能让模型跑偏,检索环节如果没按用户权限过滤,也可能把不该读到的文档送进来。评测时,检索和阅读两段的错误要分别记下来。
《Lost in the Middle》做了一个很直观的实验。同一批文档,把含有答案的那份挪到不同位置,评测问答准确率。好几个模型在文档排在开头或末尾时表现更好,移到中间就下来了。还有一组实验多取了一些候选文档,检索器更容易把答案找回来,模型端的准确率却很快趋于平缓。这个结果对应论文里的任务和模型,放到自己的系统里,值得重新测一次候选数量和排序[2]。
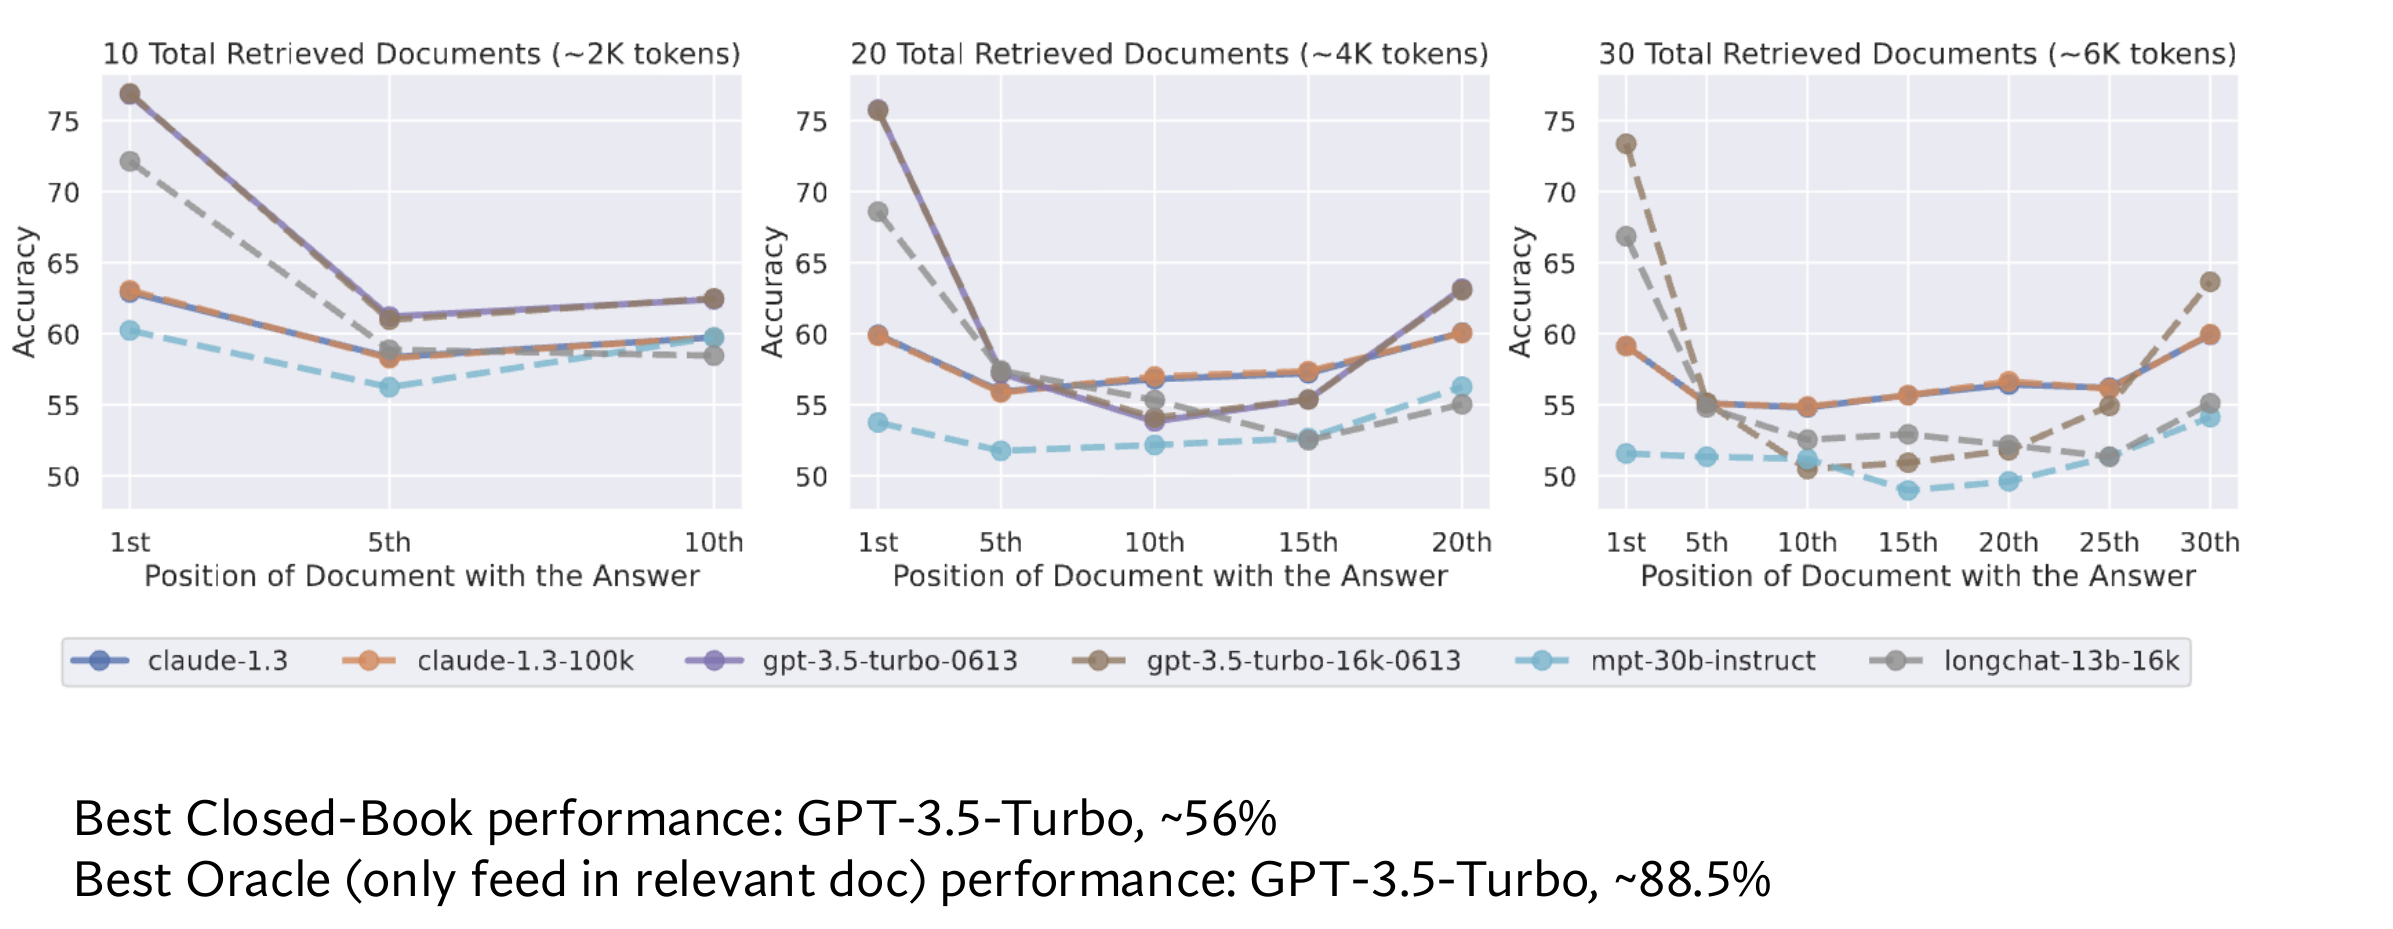
图 01 三个小图分别给模型 10、20 和 30 份文档。每张图的横轴都是答案文档的位置,纵轴是答对的比例。看同一颜色的曲线,就能比较文档在开头、中间和末尾时的表现。 来源 [2]Lost in the Middle 长上下文研究(2023)
引用也得单独查。比如一条回答带了三个链接,引用精确率看的是,这三个链接各自能不能支持它们旁边的说法。引用召回率关心的是,回答里需要有证据的那些说法,有多少得到了充分支持。前者能抓到张冠李戴,后者能抓到说了一半有依据、另一半全靠猜。2023 年有一项研究评估了当时的四个生成式搜索产品,人工核查下来,约 74.5% 的引用支持对应句子,约 51.5% 的生成句子有充分的引用支持[3]。
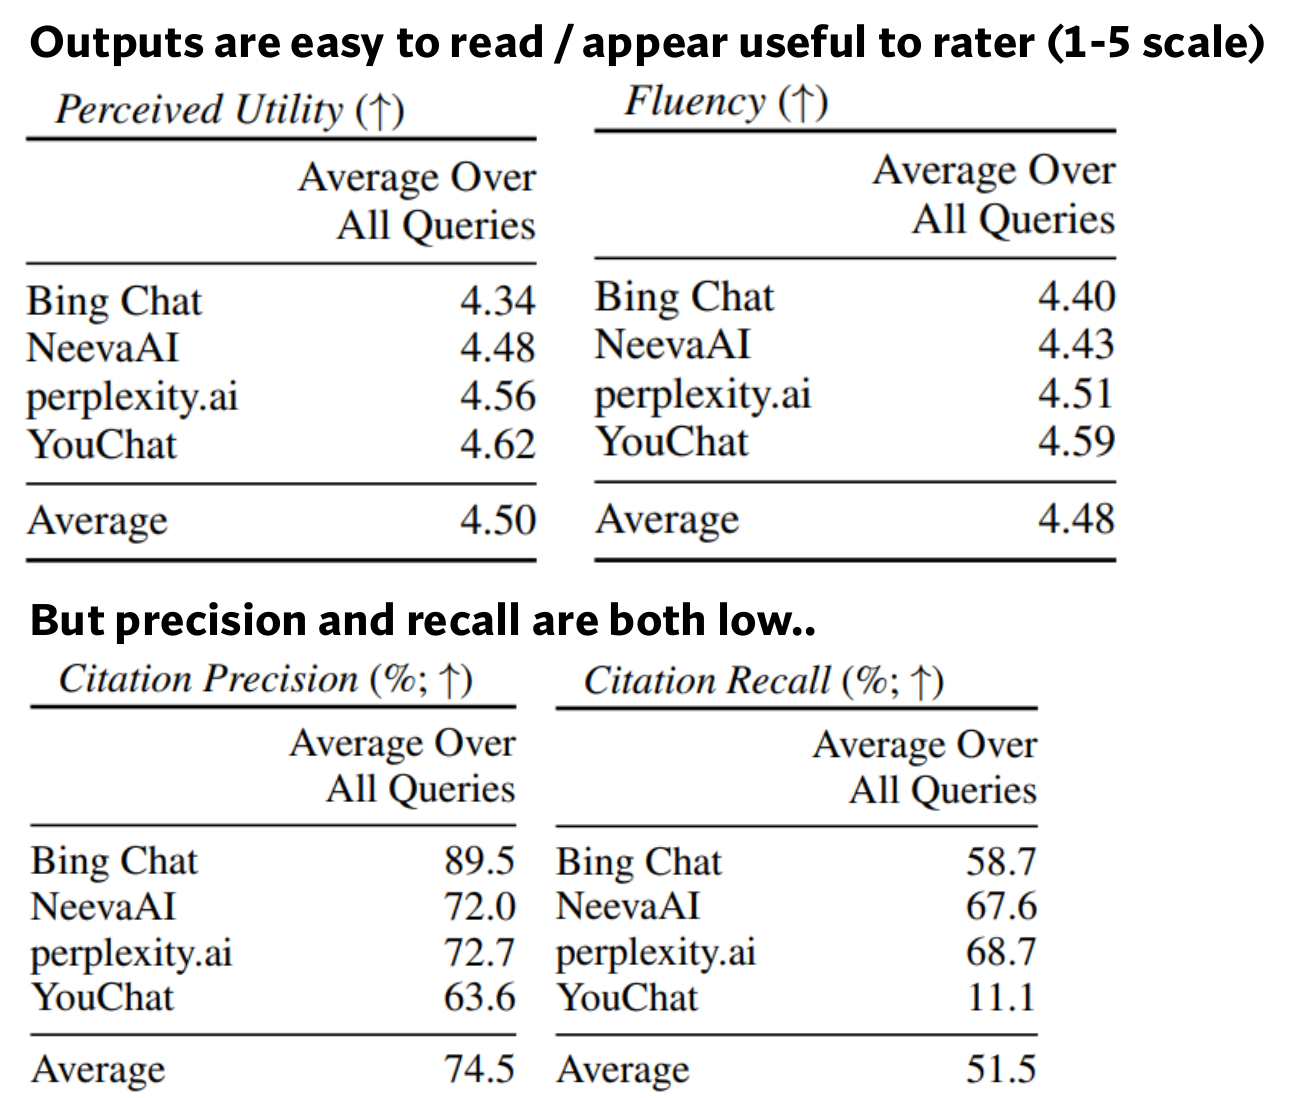
图 02 看右下两列。左列核查单条引用能不能支持对应说法,右列核查生成句子有没有得到充分支持。上半部分的流畅度是另一个指标。 来源 [3]生成式搜索的可验证性研究(2023)
还有一种常见演示叫大海捞针(Needle in a Haystack)。先把一条事实埋进很长的文本,再问模型能不能把它找出来。坐标换成不同的上下文长度和事实所在位置,就能测一圈。这个测试有助于判断模型能不能找到某一条信息。业务上如果需要把三份文档拼起来推导结论,还得拿这类任务另做评测。
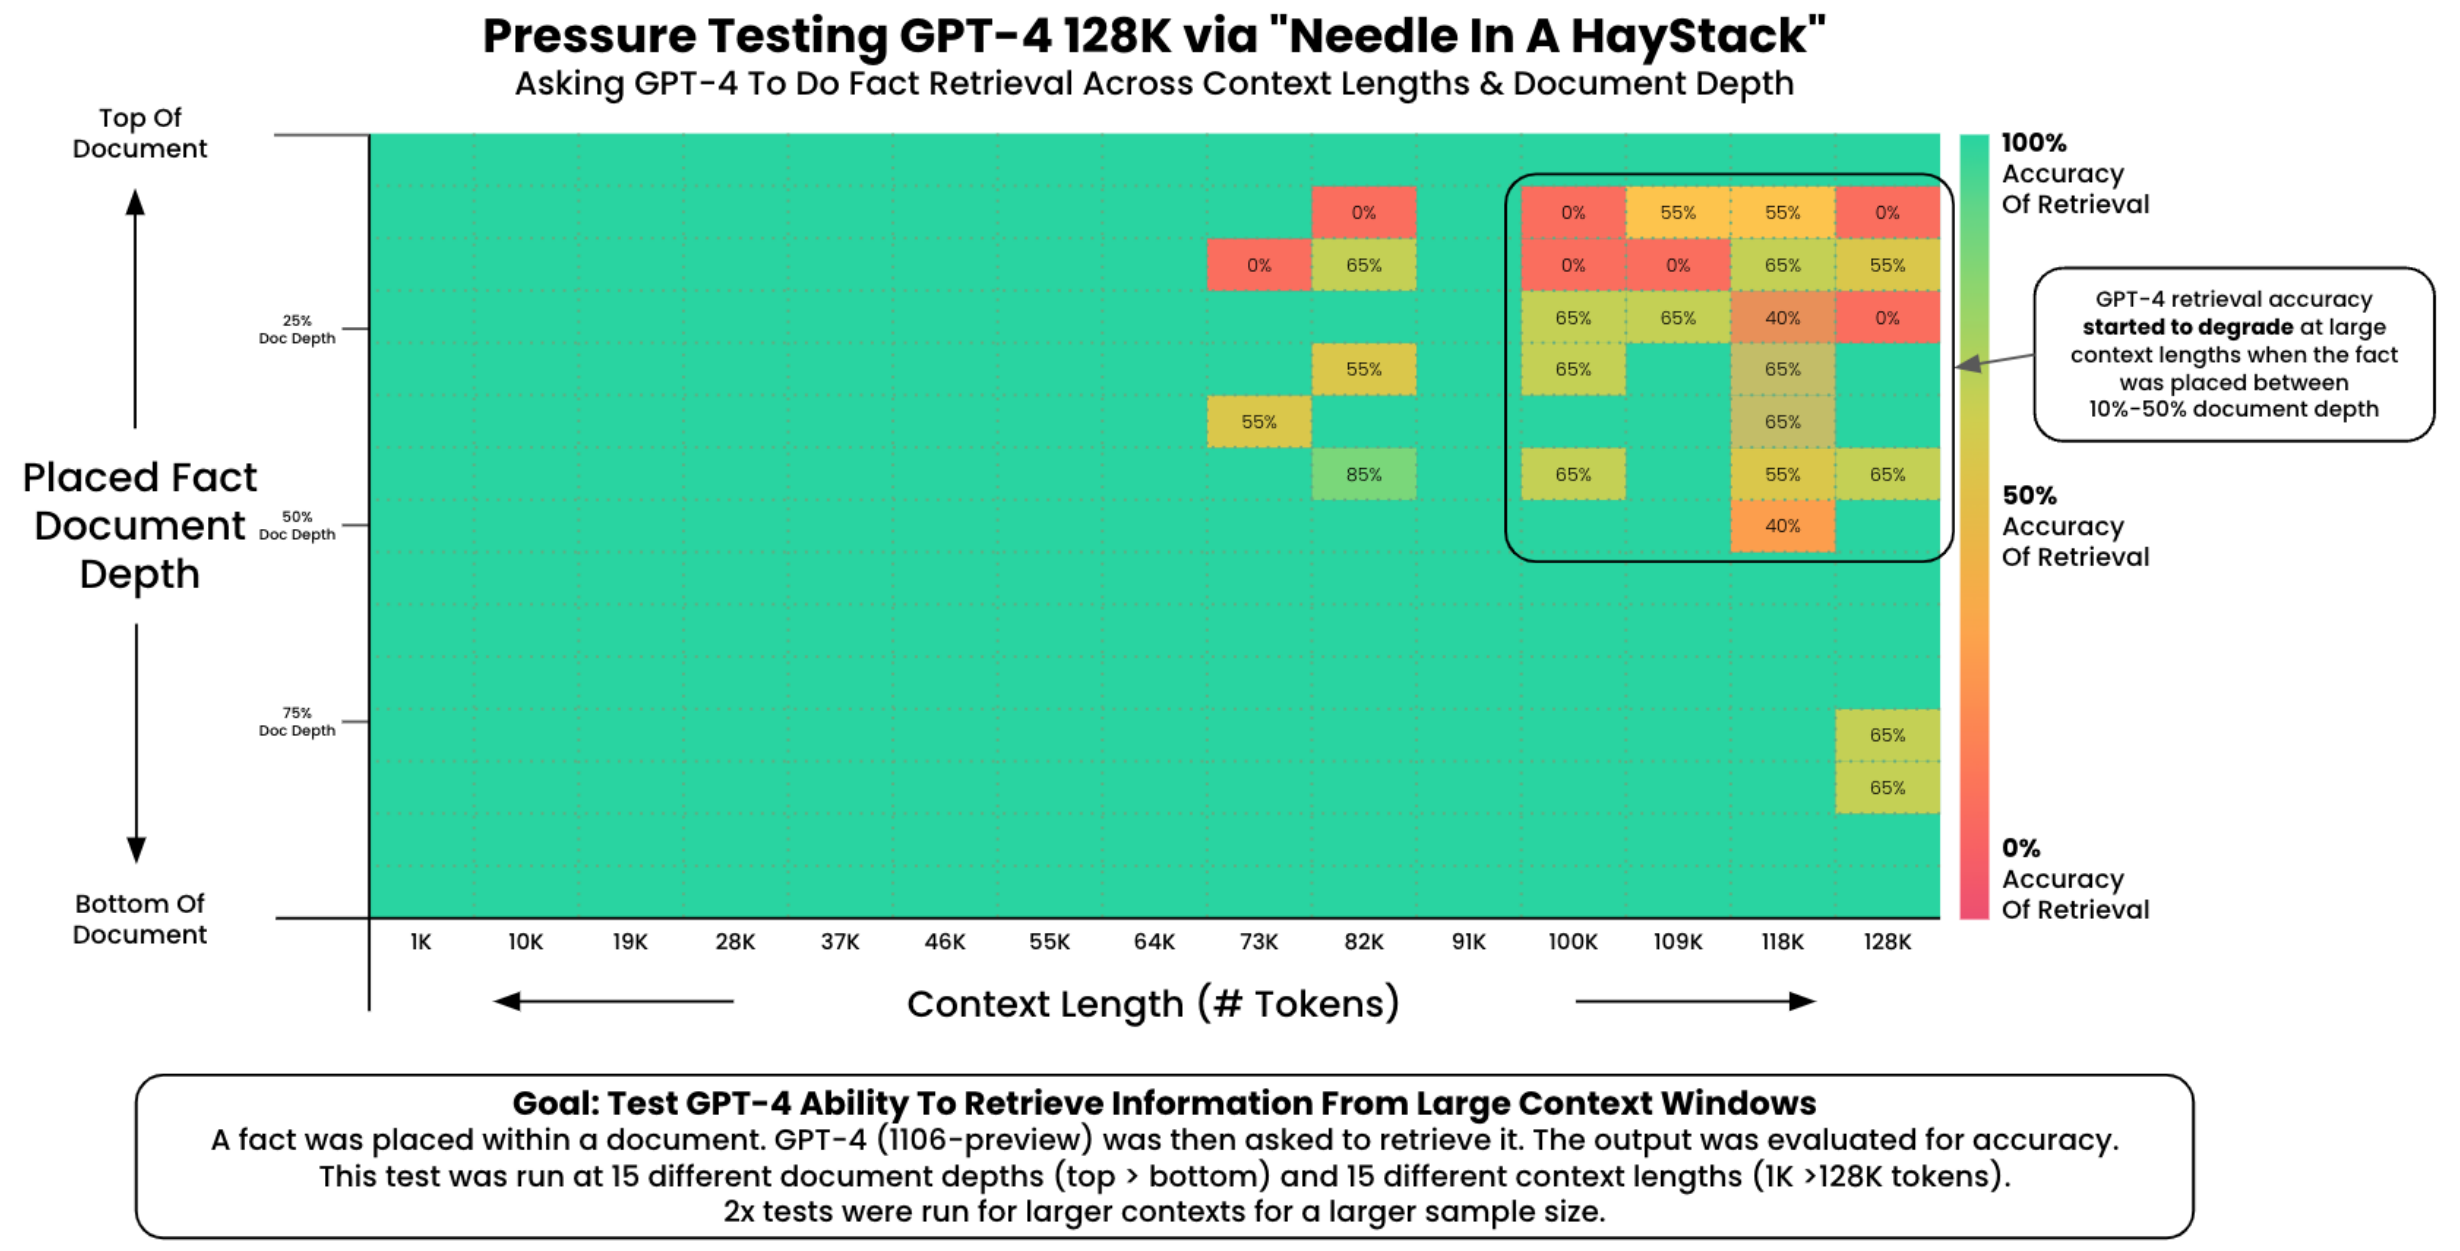
图 03 横向看输入长度,纵向看事实埋在文本的哪一段。颜色表示这个位置的检索效果。先明确测试要求是找回单条事实,再看图中的绿块能说明多少。 来源 [4]Needle in a Haystack 原始测试项目
02 工具帮模型做哪几类事?
我把需求分成三类。第一类是有确定执行过程的活,比如精确算术、运行代码、用规则校验一个结果。第二类是训练时没见过的信息,比如今天的天气、刚更新的订单状态、公司内部的资料。第三类是需要和外部系统发生交互的活,比如改日程、提交表单、控制设备。上一讲的文档检索也能封成一个工具,Agent 需要资料的时候再去调用。
难度上来后,旧模型做乘法、逻辑题和动态规划题的表现都可能掉得很快。面对精确计算,一个好理解的分工是,让模型把人话转成数值和表达式,由计算器执行。举个具体的例子,模型发出计算 17423 × 892 的请求,程序返回 15541316,模型再把数字说给用户听。天气也是一样,模型要决定查哪个城市、用什么单位,当前气温由天气服务提供[5]。
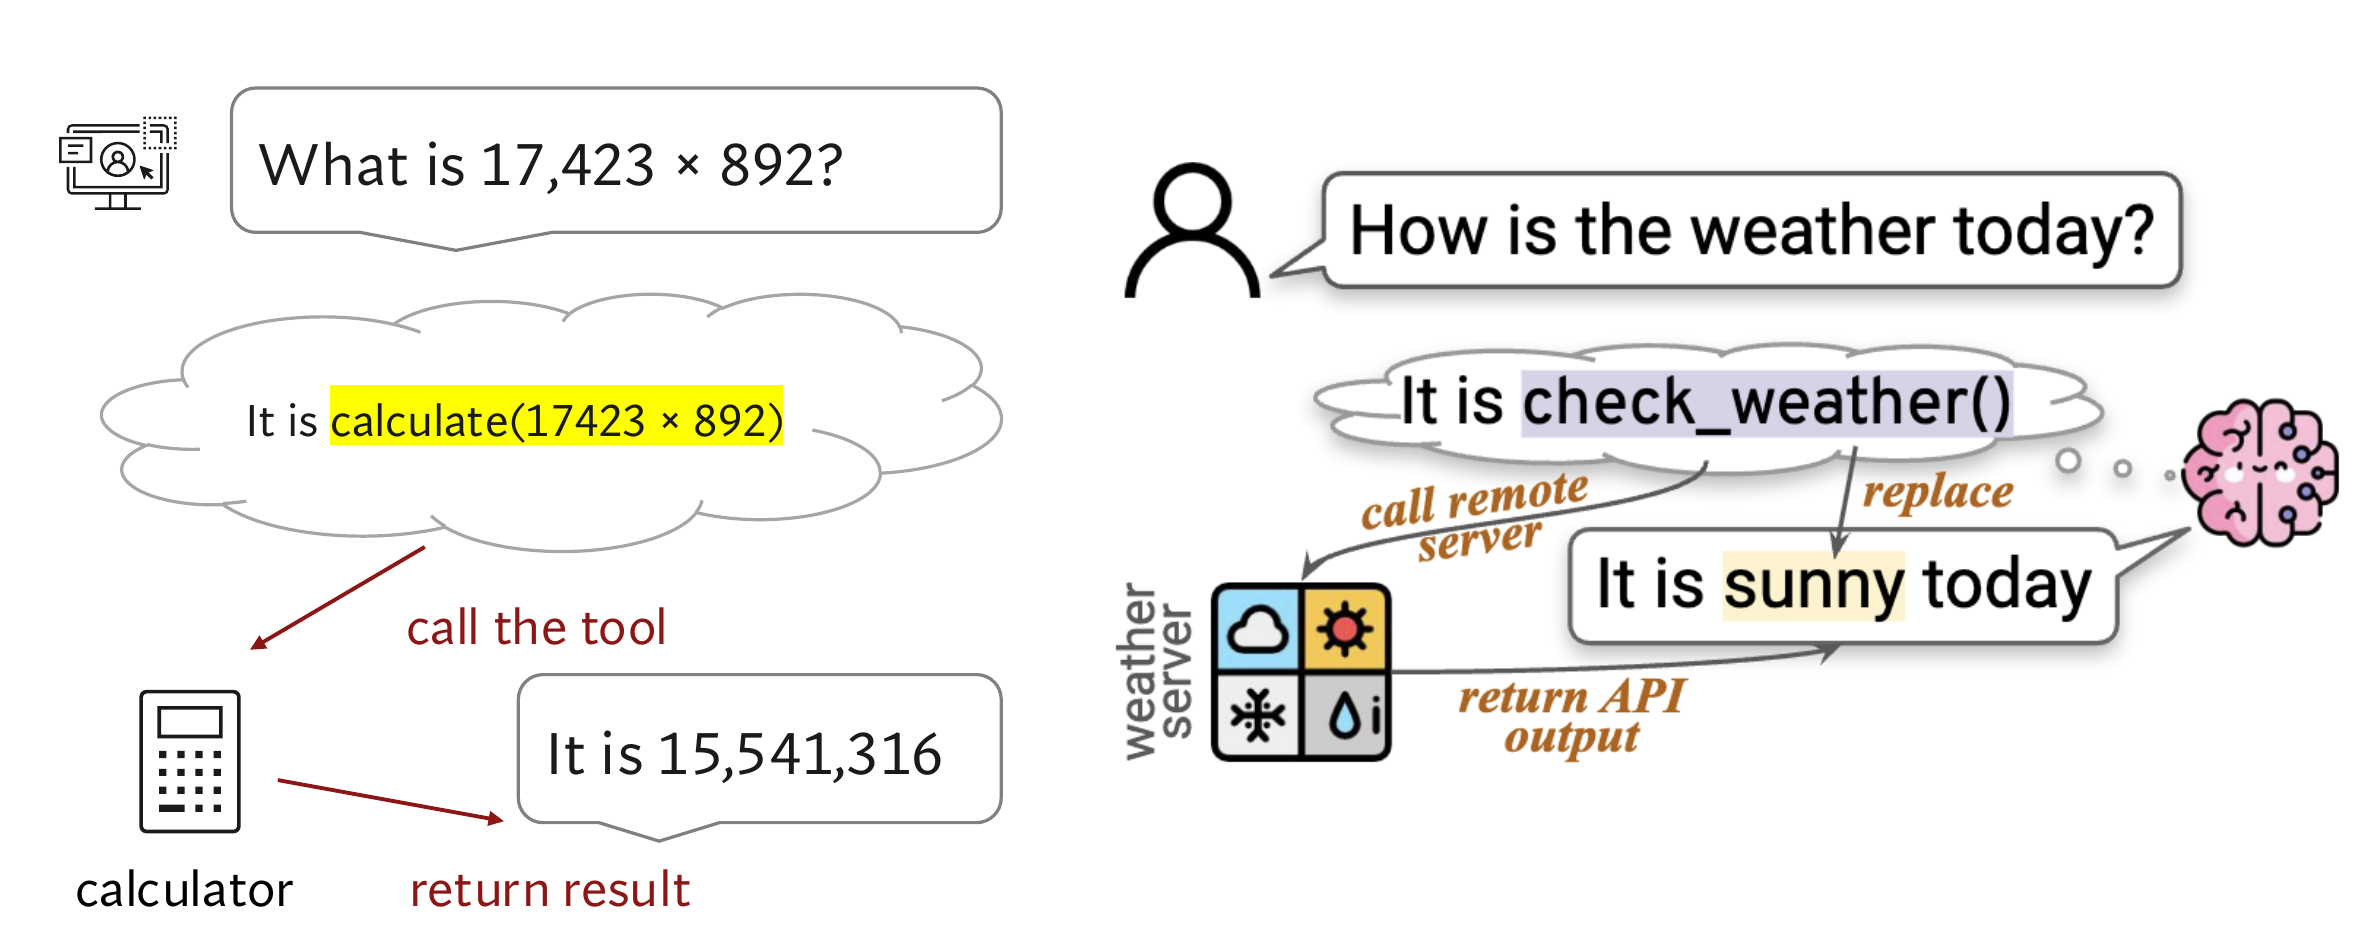
图 04 左边的黄色框是计算请求,外部计算器返回乘积。右边把「今天天气怎么样」变成天气查询,模型收到服务返回的结果才继续答。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
这里的工具通常是一个函数接口,背后有模型之外运行的程序。一个最小循环是,应用给模型提供工具名、说明和参数要求;模型输出工具名和这一轮的参数;应用检查后执行;执行结果回到下一轮上下文。是否需要继续查、继续算,或者可以答复,由这一轮的结果和系统规则共同决定。
如果把动作放在业务系统里,类型检查只管得了一部分。一个城市名是字符串,这个字段就通过了类型检查。它究竟指的是哪个城市,接口接收的是摄氏还是华氏,仍然要靠清楚的工具契约、参数约束和必要的追问。当模型发来一个格式完全正确的修改请求,应用也还要检查发起人有没有权限。
03 模型怎么学会在正确的时候调用工具?
Toolformer 先试用,再挑有帮助的调用
Toolformer 是一个早期方案。它想让模型学会判断三个问题,什么时候插一次工具调用,用哪个工具,参数怎么填。原论文用了五类工具,包括计算器、问答、搜索、翻译和日历。准备少量例子告诉模型调用长什么样,接下来让模型自己给现成文本补调用,再用筛过的数据微调 GPT-J 6B[6]。
拿「匹兹堡又称钢铁之城」这句话举例。写到「匹兹堡又称」时,可以问问答工具「匹兹堡还有什么名字」,也可以问「匹兹堡在哪个国家」。两个问题都有答案,只有前一个的结果能帮模型接着写下「钢铁之城」。训练数据筛的就是这种区别。
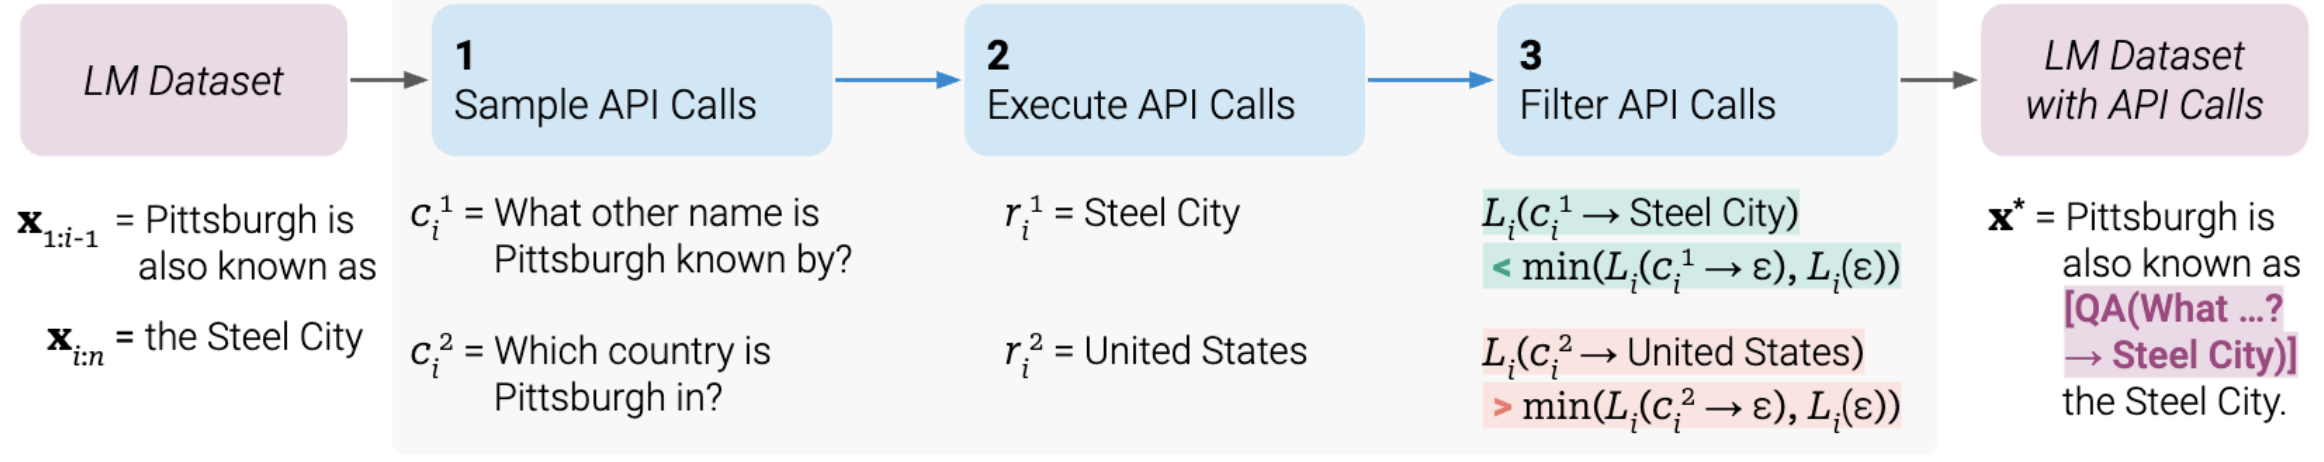
图 05 从左往右读。先给普通文本采样几个可插入的调用,再实际运行得到返回值,最后保留对后续文本有帮助的调用。 来源 [6]Toolformer 论文(2023)
具体怎么比较?先找适合插调用的位置,再试候选参数,把工具跑一遍。对同一段后续真实文本,分别算三次预测损失。一种不加调用,一种只加调用本身,一种把调用和返回结果都加上。第三种得比前两种里更好的那一种改善得足够多,才留下。紧跟调用的 token 权重更大,越往后权重越小。这样光靠调用里的提问碰巧提示了答案,通常过不了这一关。
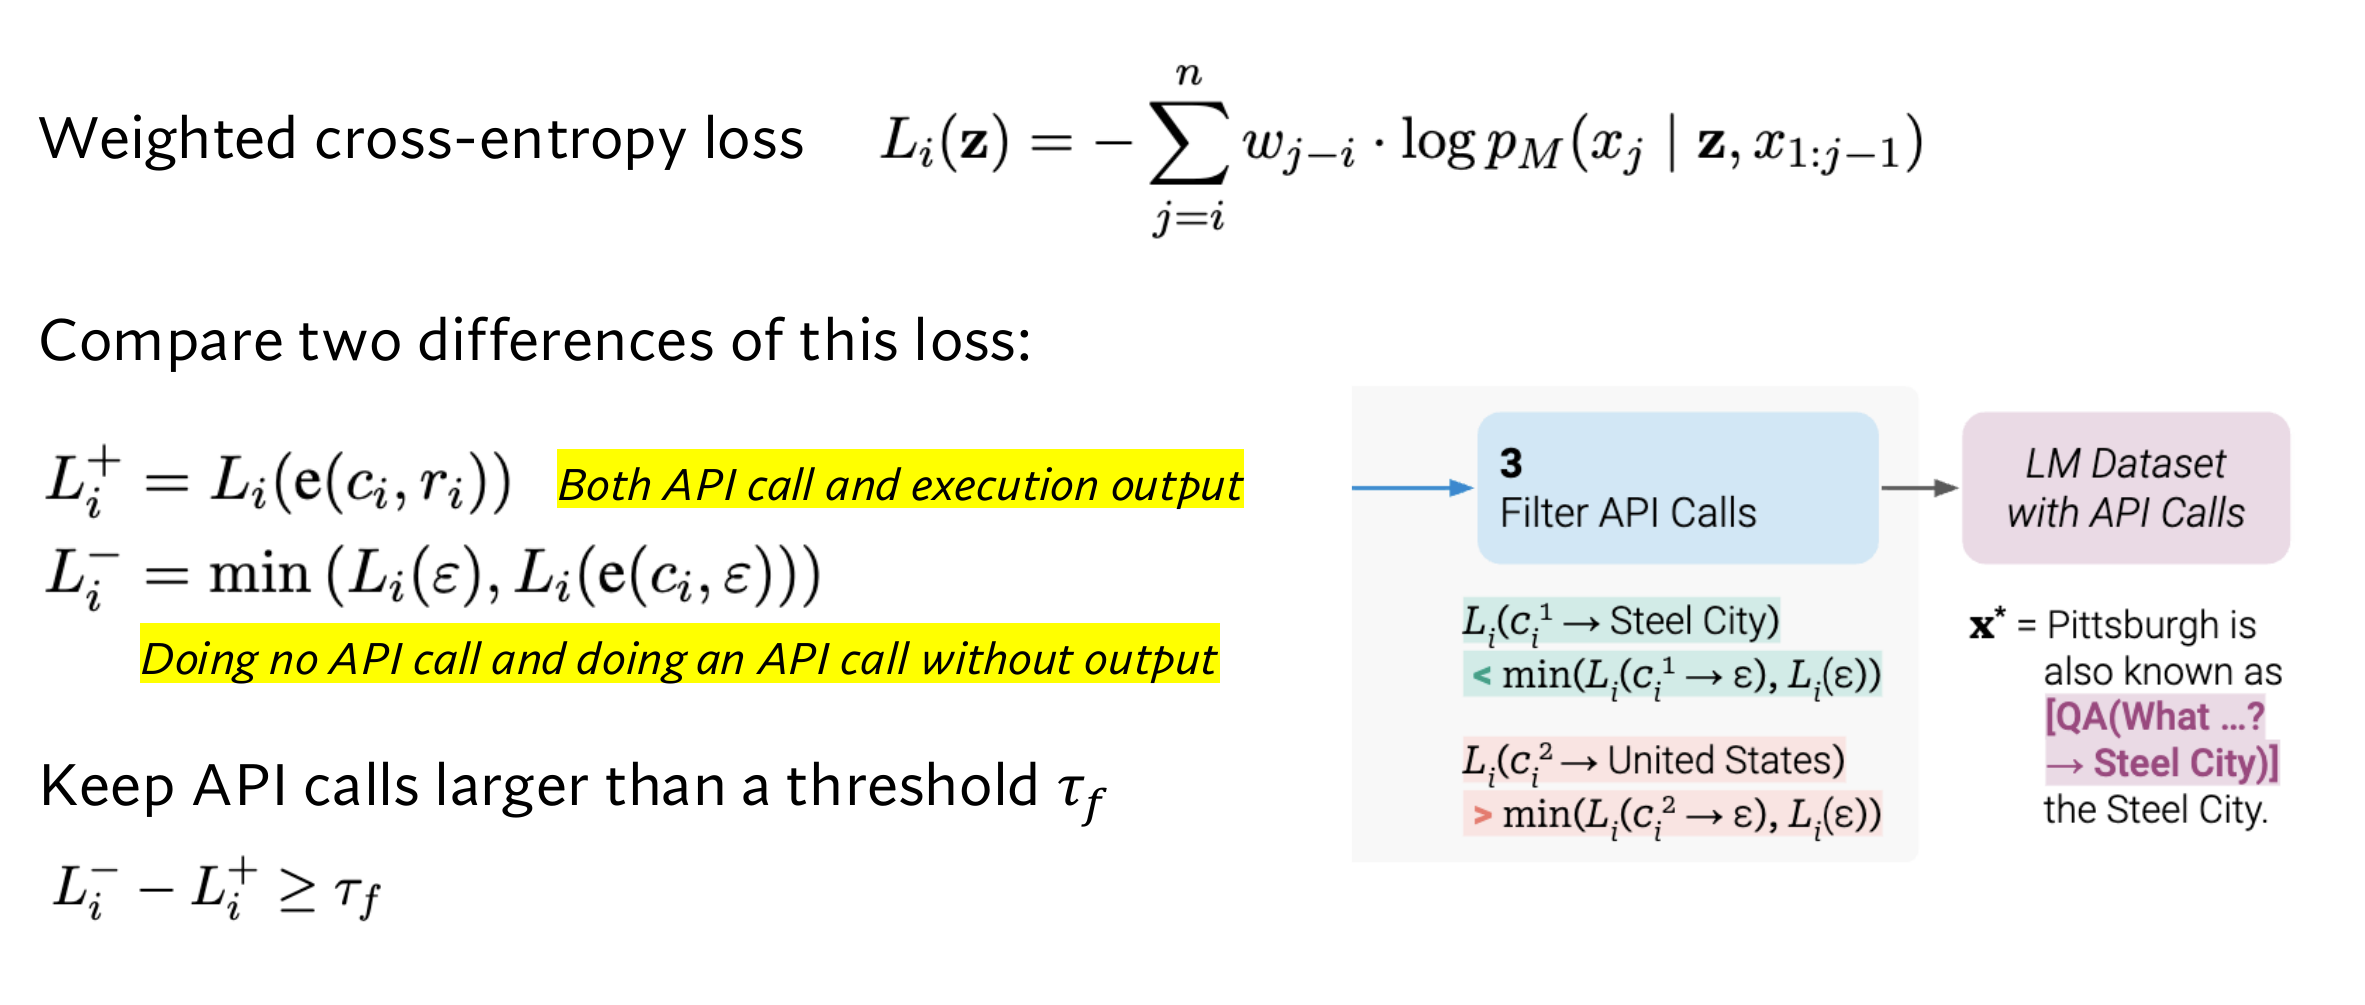
图 06 黄色标注的是两组条件。上面有调用和执行结果,下面取不调用、调用但没给结果两种条件中的较小损失。两者差值超过阈值才保留这一条。 来源 [6]Toolformer 论文(2023)
论文里的模型在问答、算术、时间敏感任务等基准上有改善,幅度因任务而异。训练办法要先能离线运行工具,也要有能用来衡量帮助的后续文本。今天做应用时可以直接使用支持工具调用的模型。理解这段训练过程,有助于区分「拿到了结果」和「结果对接下来的任务有帮助」。
ToolkenGPT 把选工具变成预测特殊 token
ToolkenGPT 换了一个思路。给每个工具单独分一个特殊 token,叫 toolken。模型预测下一个 token 时,可以接着写普通文字,也可以选中某个工具 token。基础模型参数冻结,额外学习工具 token 的嵌入向量[7]。
一旦预测出工具 token,就切换到工具模式。系统把当前上下文和少量参数示例拼成新的提示,模型在里面填参数。工具执行完返回数值,再回到原来的生成过程。举例来说,要算一个平方,工具 token 决定要用平方函数,接下来的提示决定把哪个数填进去。论文用带正确调用的样本或合成数据来学工具嵌入,并在多种工具规模下比较效果。
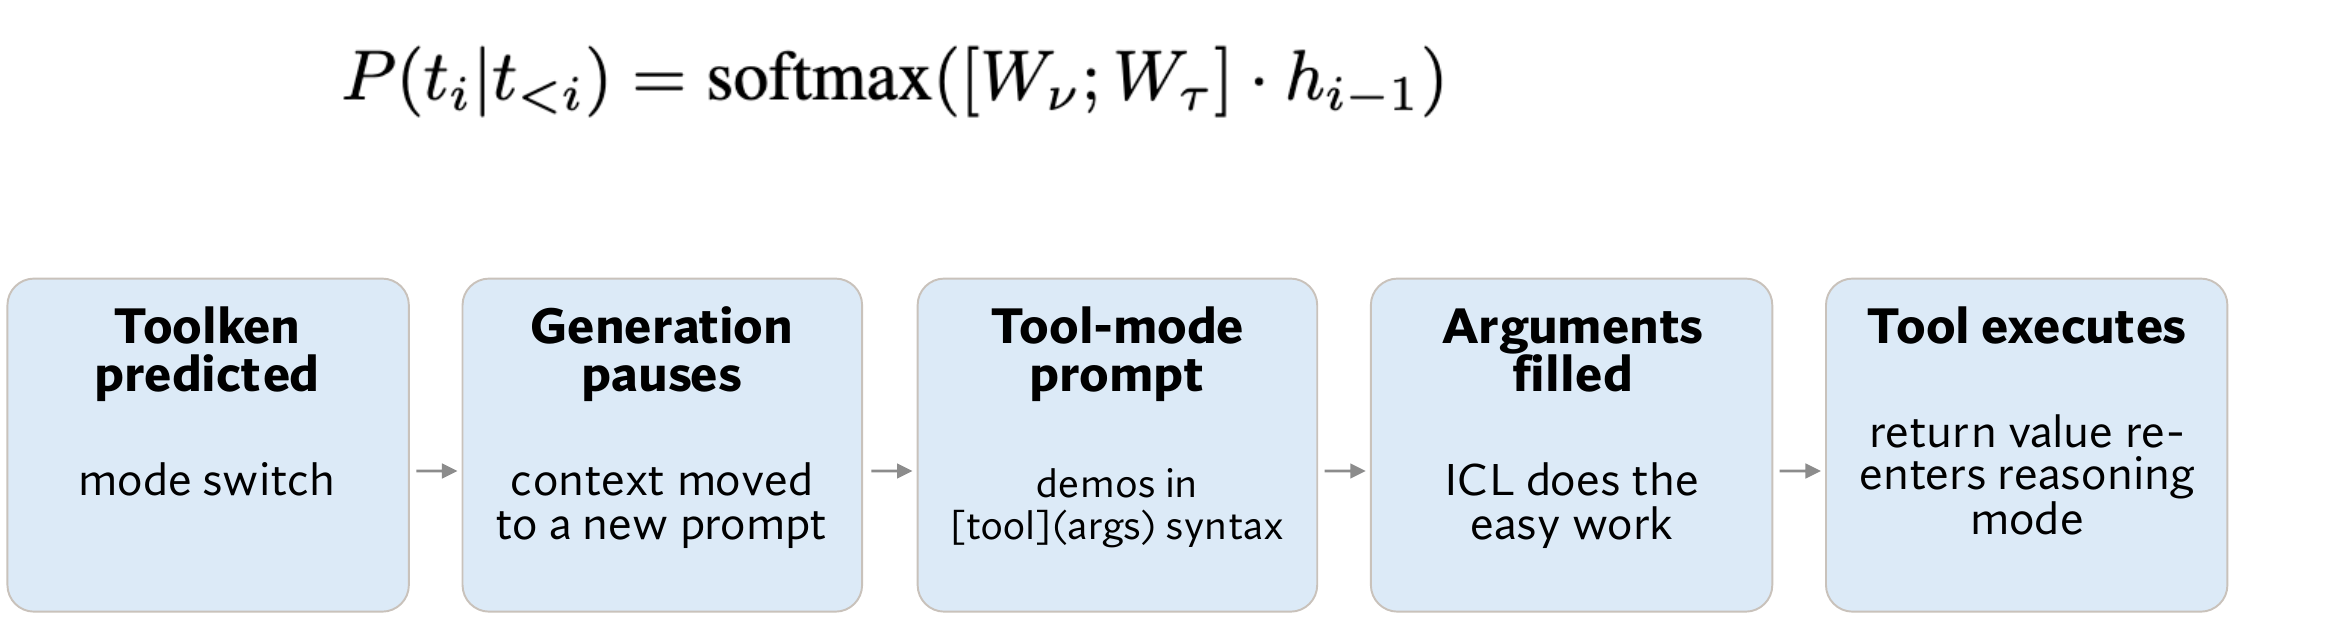
图 07 从左到右依次是预测工具 token、暂停普通生成、切换提示、填参数、执行。执行结果回到原本的生成过程。 来源 [7]ToolkenGPT 论文(2023)
04 有上千个 API,先把候选工具找出来
工具扩到几千个,定义全塞进上下文很占地方,还会增加相似名称之间的混淆。现在可以把 RAG 的想法拿回来,先检索和任务有关的 API,再让模型从候选中选工具。
ToolLLM 从 RapidAPI 收集了 16,000 多个 API。研究者为候选 API 生成用户指令,借助能访问工具的模型找可用的调用路径。遇到走不通的分支可以退回上一步换条路,把成功的多步轨迹留下来,用来微调 LLaMA,得到 ToolLLaMA。推理时可以接上一个工具检索器,先为用户请求找候选。ToolBench 是这套工作构建的工具使用数据与评测资源,既有单工具任务,也有需要把几个接口串起来的任务[8]。
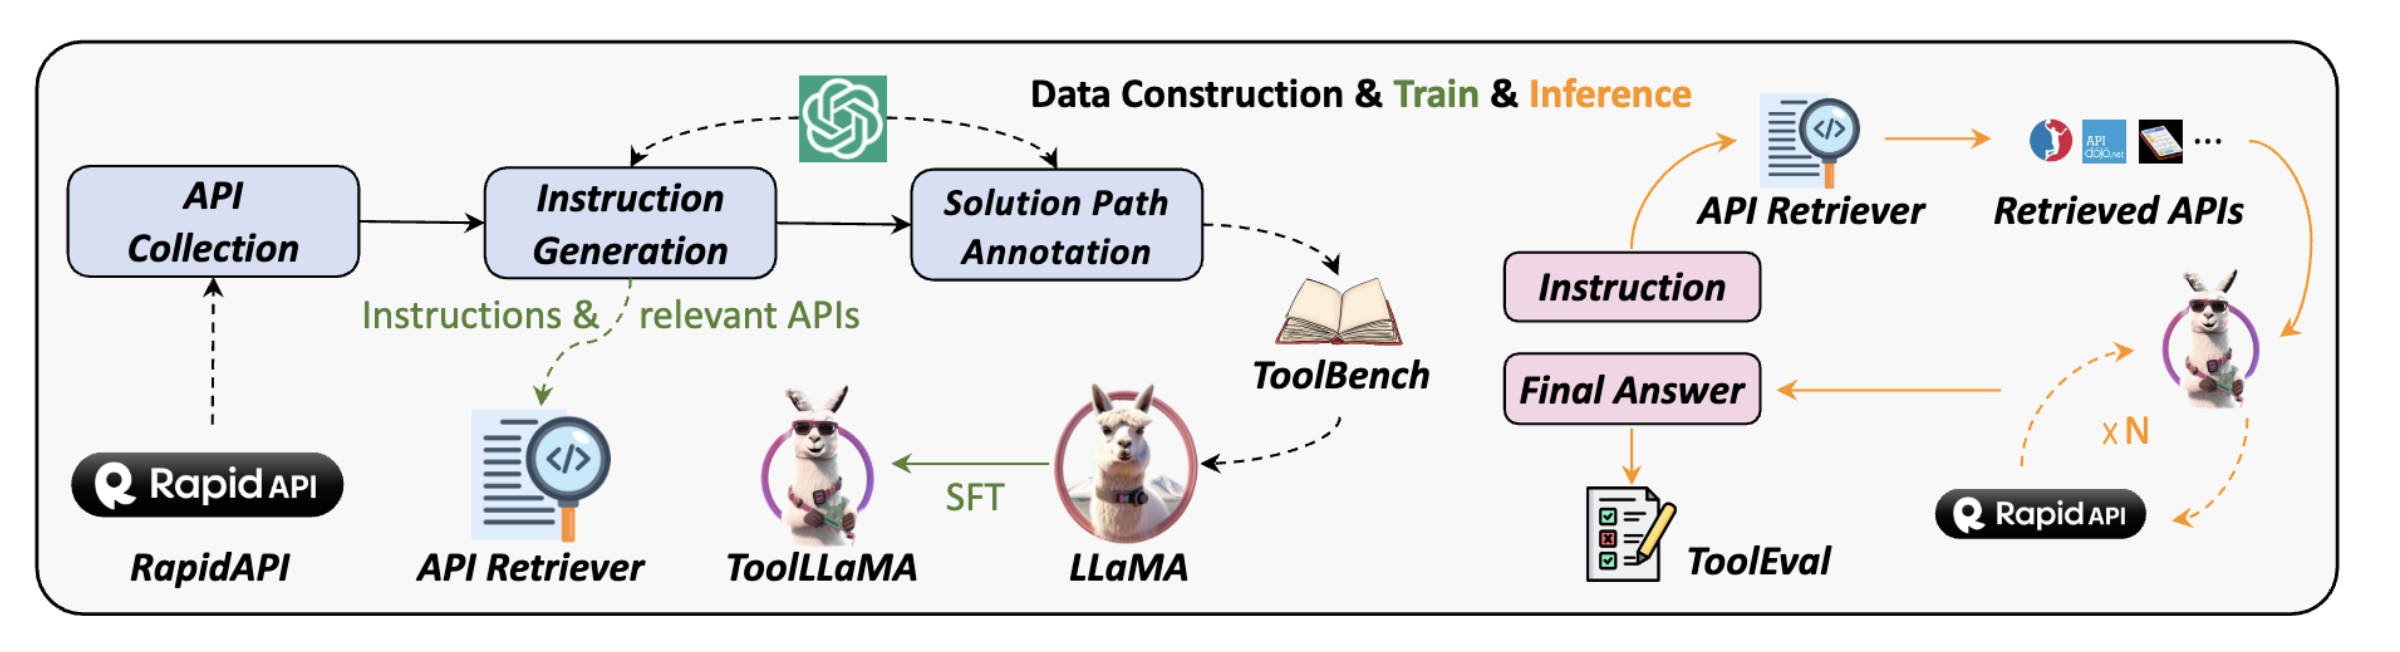
图 08 左半边收集 API、构造请求和调用路径,再做监督微调。右上角是实际推理,检索器先给出与请求相关的候选 API,再交给模型。 来源 [8]ToolLLM / ToolBench 论文(2023)
Gorilla 集合了 Hugging Face、PyTorch Hub 和 TensorFlow Hub 的 1,645 个 API 调用,用合成的指令训练模型生成 API 代码。它一个比较值得看的做法叫检索感知训练。训练时既有检索对了文档的例子,也有检索偏了的例子。模型要学会用有用的文档,同时提高对低质量检索结果的抵抗力。接口迁移或签名变化后,也可以在推理时提供更新过的文档[9]。
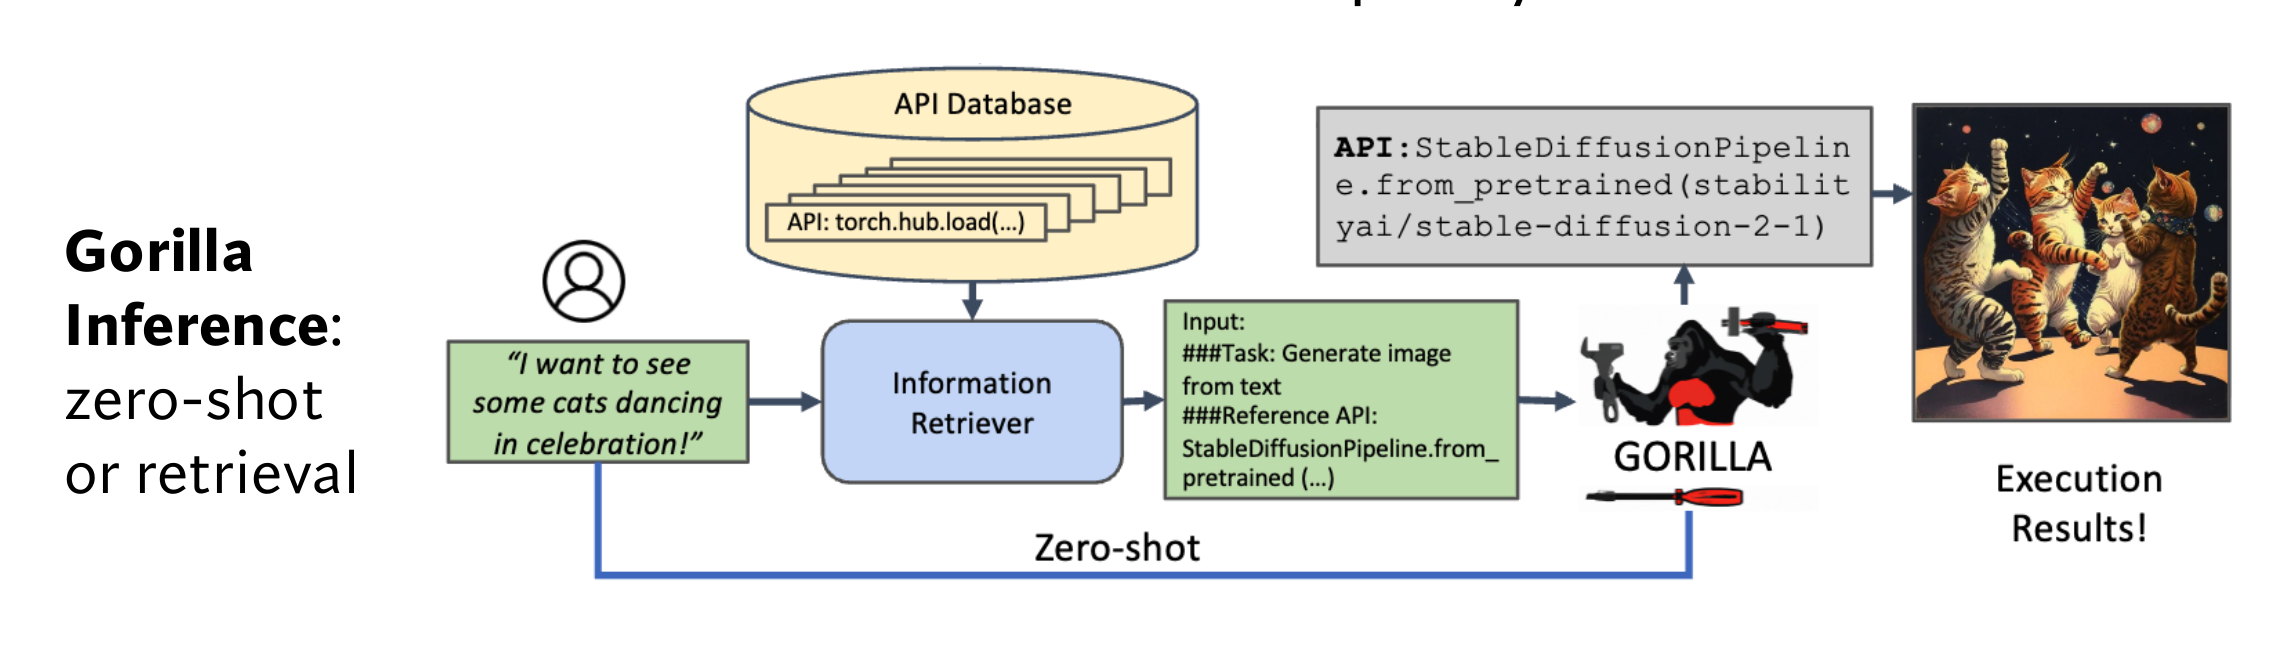
图 09 蓝色框是检索器,从工具库里找 API 文档。它把文档交给右边的模型,模型结合用户请求生成 API 调用。下面的线表示没有检索文档的对照方式。 来源 [9]Gorilla 论文(2023)
这项工作还关心怎么算「编了一个 API」。把生成的调用代码解析成 AST(抽象语法树),可以按调用的结构对照,而少受换行、空格这些表面差异影响。生成结果要是连已知 API 的结构都匹配不上,和调用了一个确实存在的 API 但用错参数,是两种不同的错误。AST 匹配可以做离线检查,也有自己的覆盖边界,调用实际执行之后是否满足任务,还得另外评估。
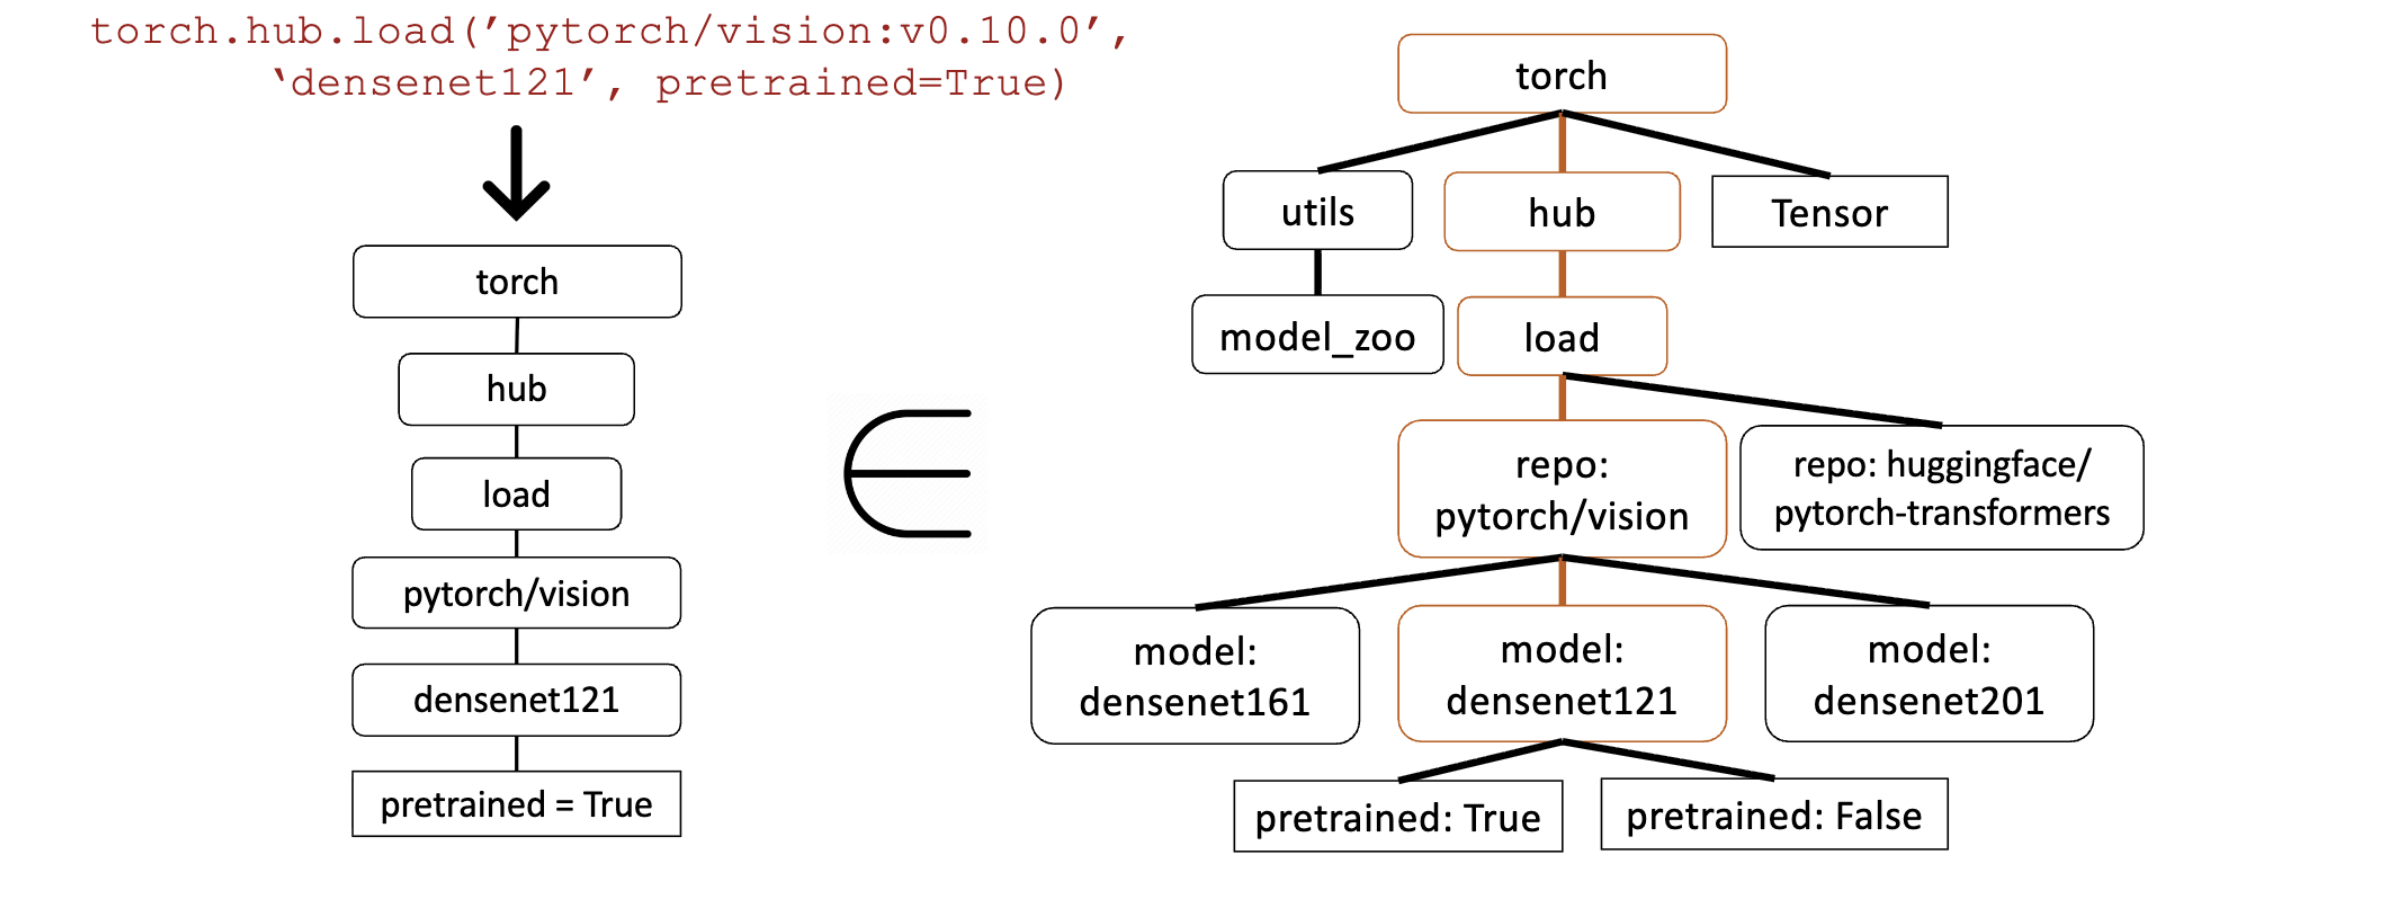
图 10 左边把一条模型生成的调用展开成树,右边是已知 API 的候选结构。沿着树比对函数名、参数和取值,能把结构性错误跟排版差异分开。 来源 [9]Gorilla 论文(2023)
05 REST、Function Calling、MCP 各管哪一层?
想象有一个天气服务。REST API 是服务对外的 HTTP 接口,开发者知道路径、方法和参数,就能按文档发请求。模型也可以在理解文档后生成请求所需的信息。应用要接许多工具时,可以统一告诉模型每件工具叫什么、参数怎么填,这就到了 Function Calling 这层。
Function Calling(函数调用) 是模型和应用之间表达调用意图的方式。系统一般用 JSON Schema 之类的结构描述输入,例如查天气要传一个字符串类型的城市。模型返回函数名和参数,运行代码去校验、调度、执行,再把结果交还给模型。工具本身依然可以通过 REST 调用,或者是进程里的普通函数。拿到一段结构合法的输出,只代表拿到了可以进一步判断的请求。
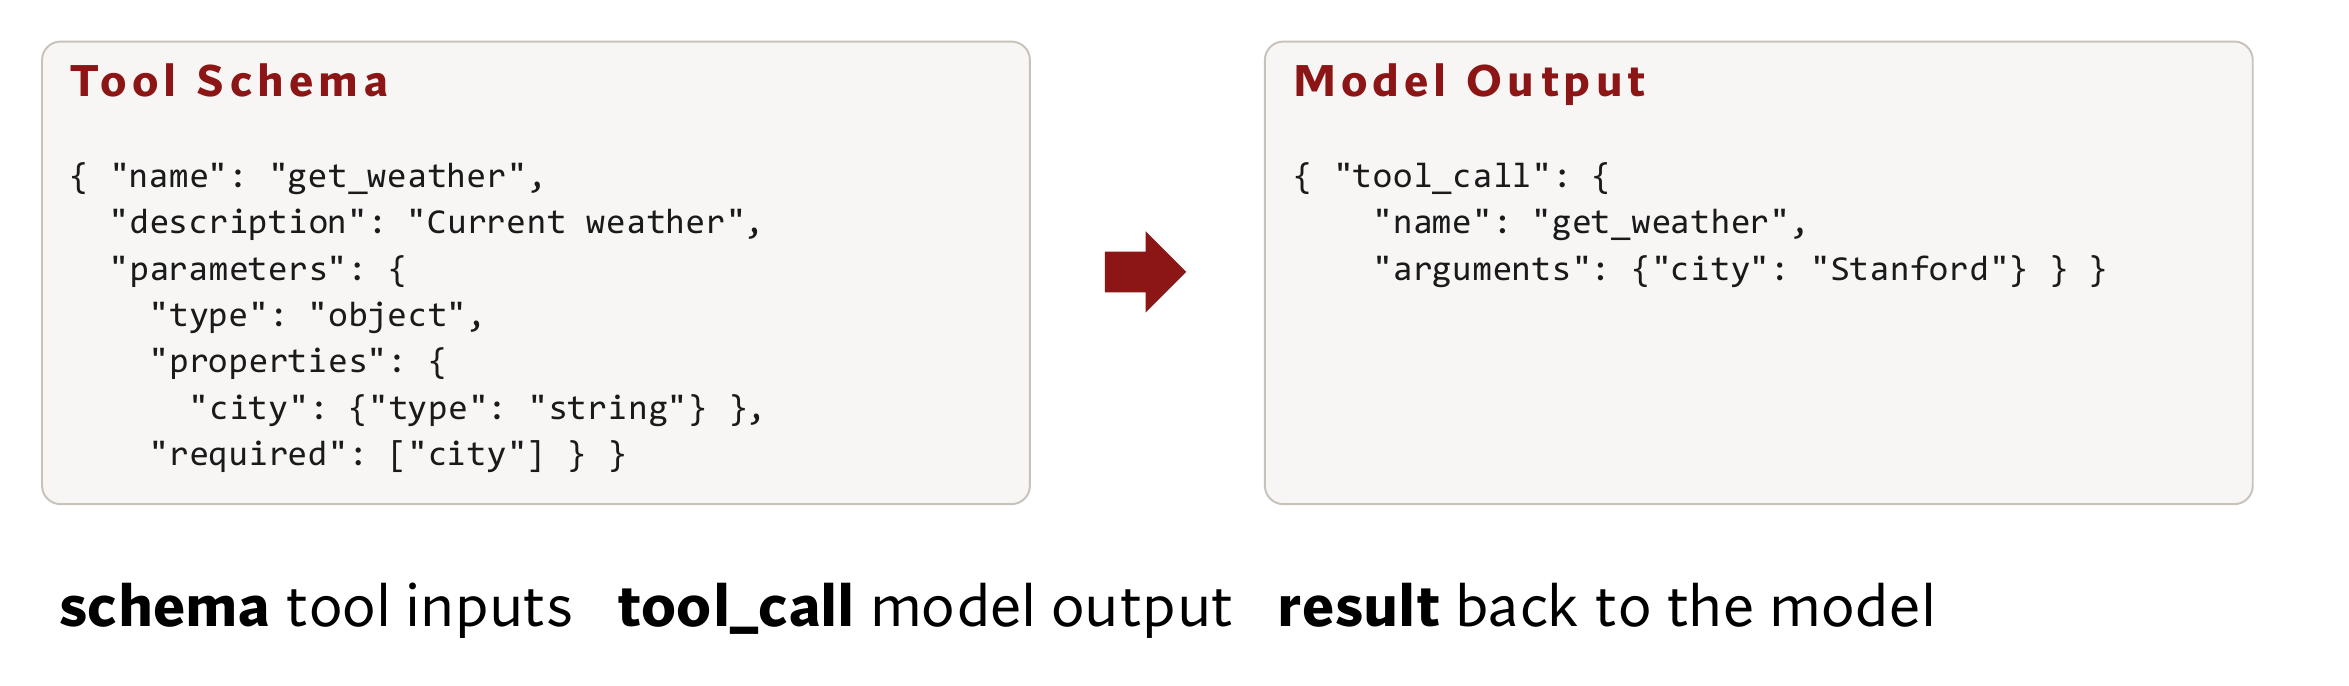
图 11 左边是应用传入的工具定义,包含名称、说明和参数规则。右边是模型选出的名称和实参。真正的执行结果还要由应用另行传回。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
MCP(Model Context Protocol,模型上下文协议)解决的是 AI 应用和外部能力怎么按约定连接。可以理解成,天气工具提供方按协议暴露工具,同一实现就可以接到不同的支持 MCP 的应用上。MCP 还支持资源和提示等能力。拿工具来说,模型这一侧仍然可以用 Function Calling,应用连接工具服务时用 MCP,MCP 服务再去调底层 REST API。
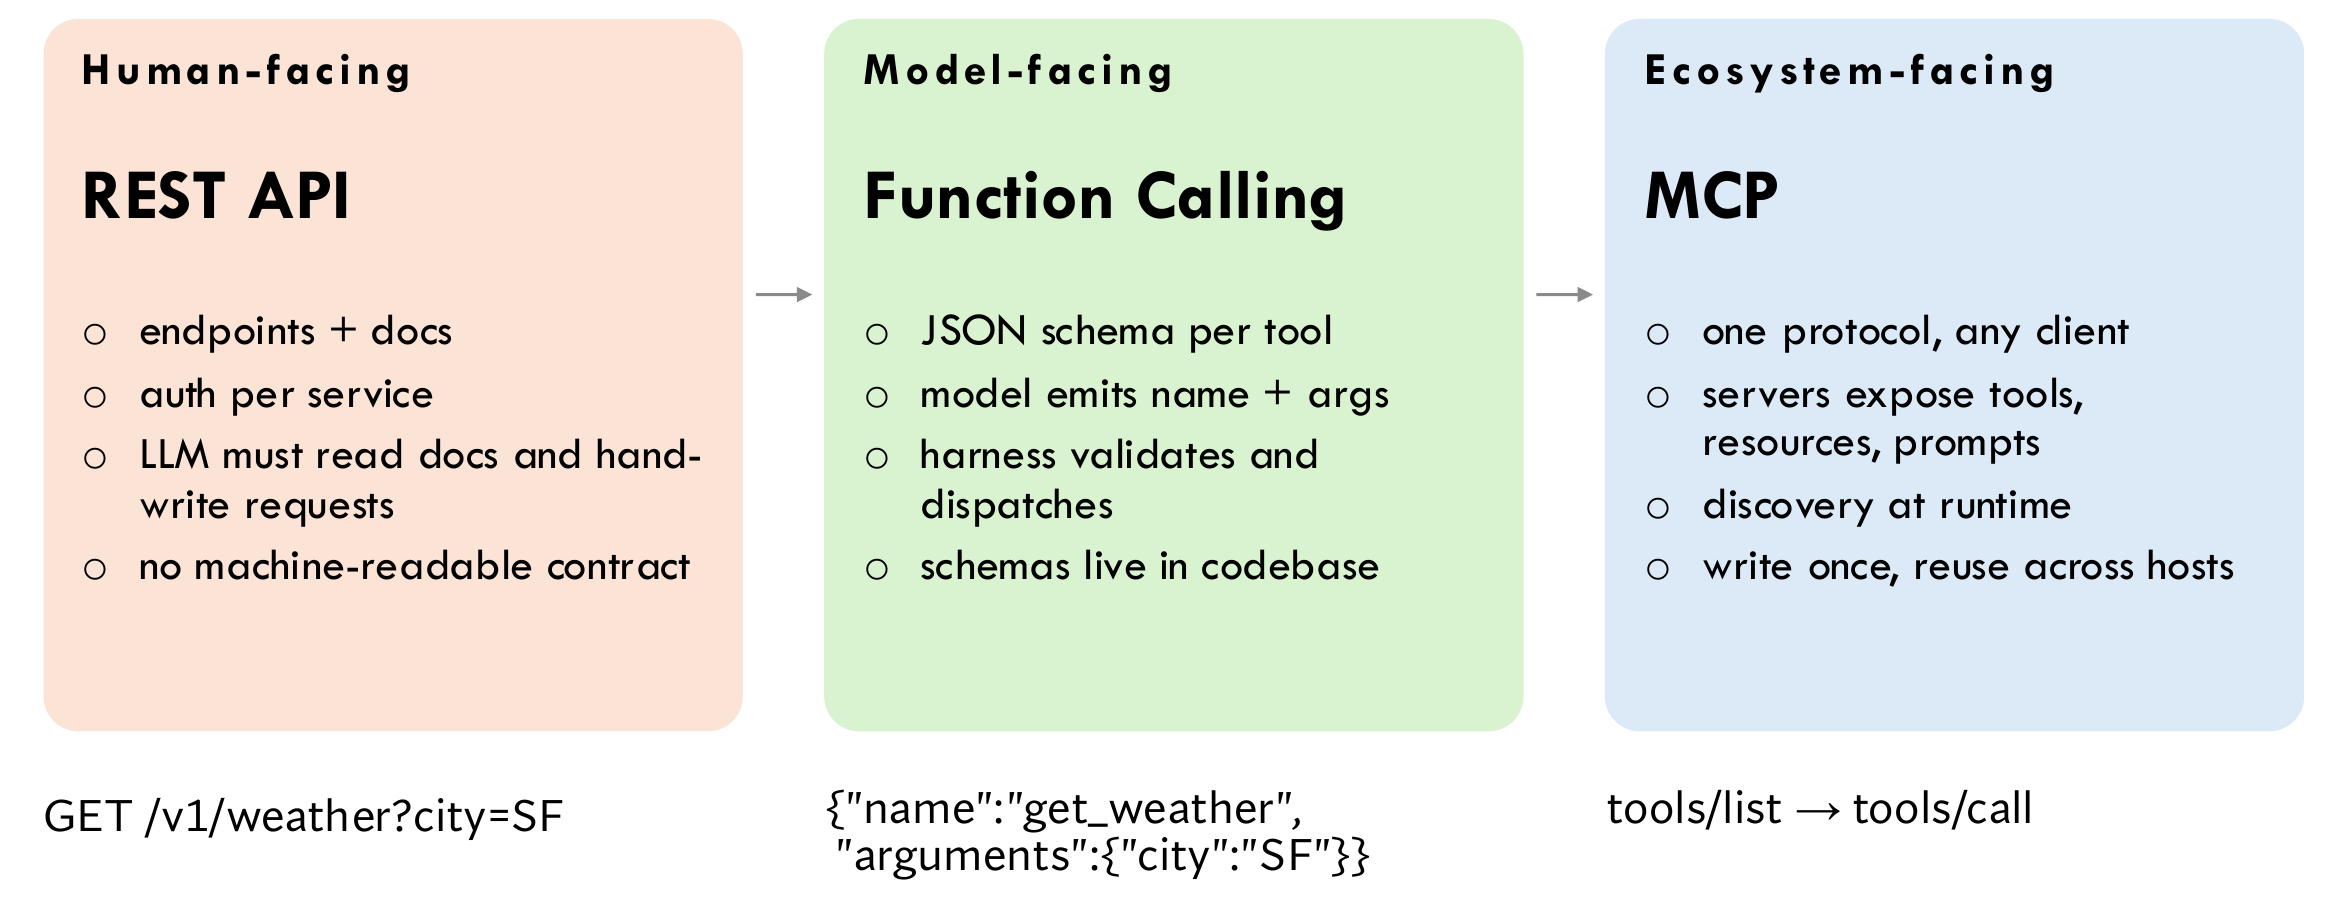
图 12 三列的阅读顺序是服务接口、模型输出接口、应用和能力提供方的连接协议。三层能放在同一条调用链里,分别解决各自的问题。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[10]MCP 官方架构文档
MCP 架构里,Host 是运行 Agent 的应用,里面管理一个或多个 Client。Client 和对应的 Server 通信。Server 可以在本机,也可以远程运行,暴露它愿意提供的能力。Host 决定提供哪些上下文和权限,会话内容也无需自动转给所有工具服务[10]。
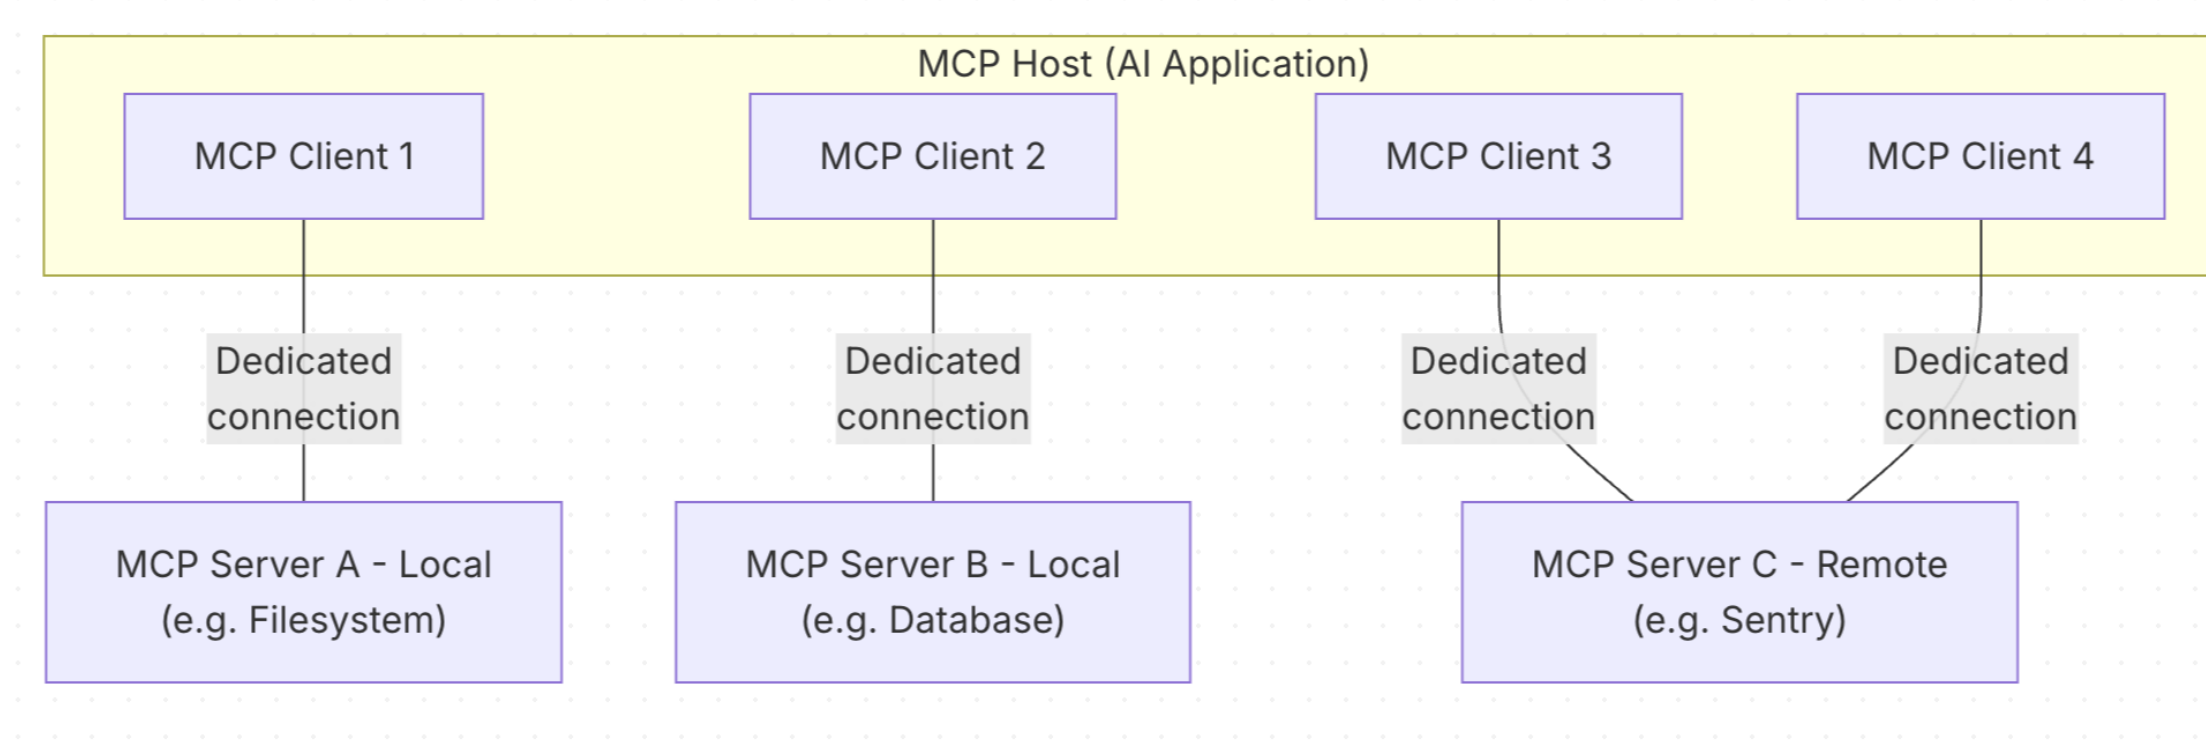
图 13 上面的 Host 管理多个 Client。每条竖线代表一个 Client 到 Server 的连接,图中同时有本机服务器和远程服务器。 来源 [10]MCP 官方架构文档
找工具和用工具也是两次不同的交互。应用通过 tools/list 获取工具名、说明以及输入 Schema,可以把合适的工具提供给模型。模型选好工具、填好参数后,Client 发 tools/call,里面带工具名和参数。Server 执行后返回内容,比如一段天气信息。两个方法通过 JSON-RPC 消息表达,问「有什么工具」和请它「执行这一把」各有自己的请求。
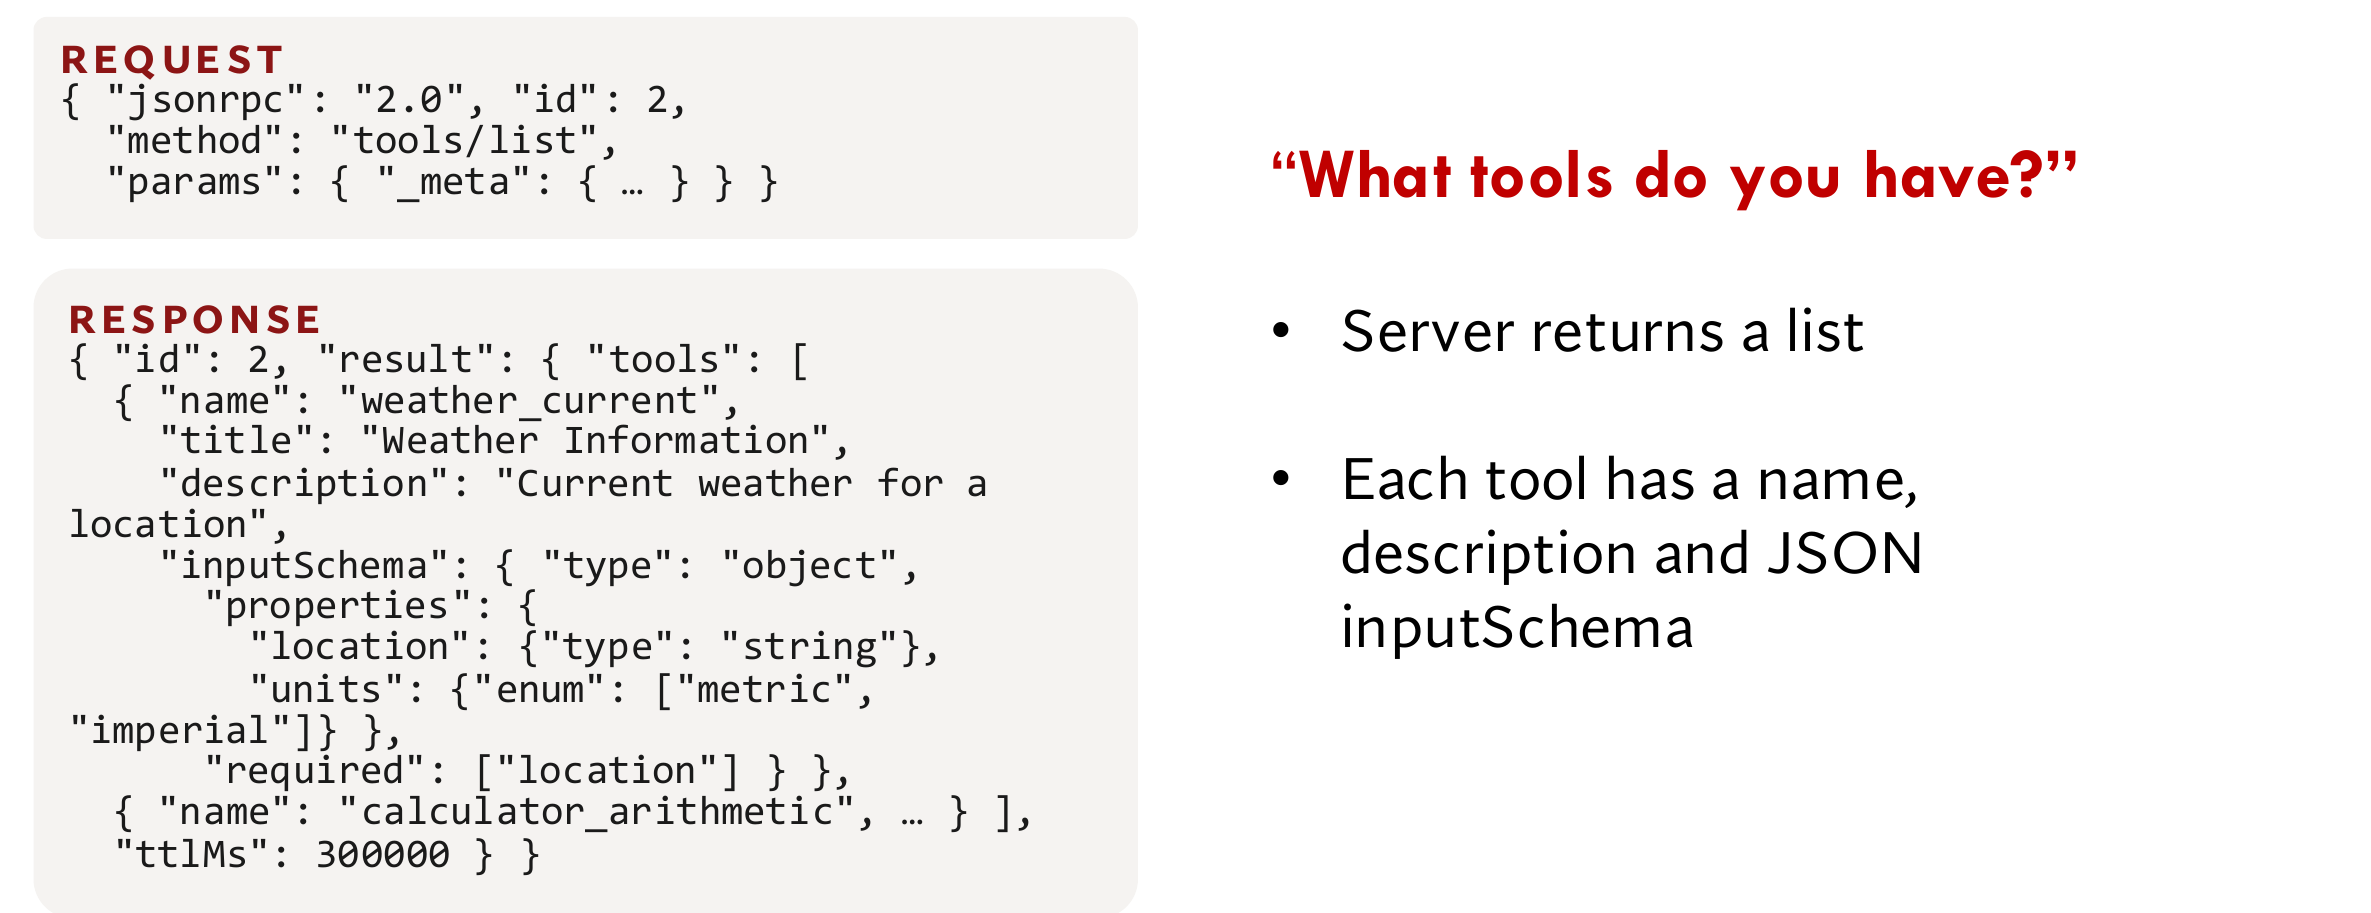
图 14 左上是 tools/list 请求,左下是返回的工具定义。重点看 name、description 和 inputSchema,客户端可以从这里知道工具叫什么、怎么传参数。 来源 [10]MCP 官方架构文档、[11]MCP 官方工具协议规范
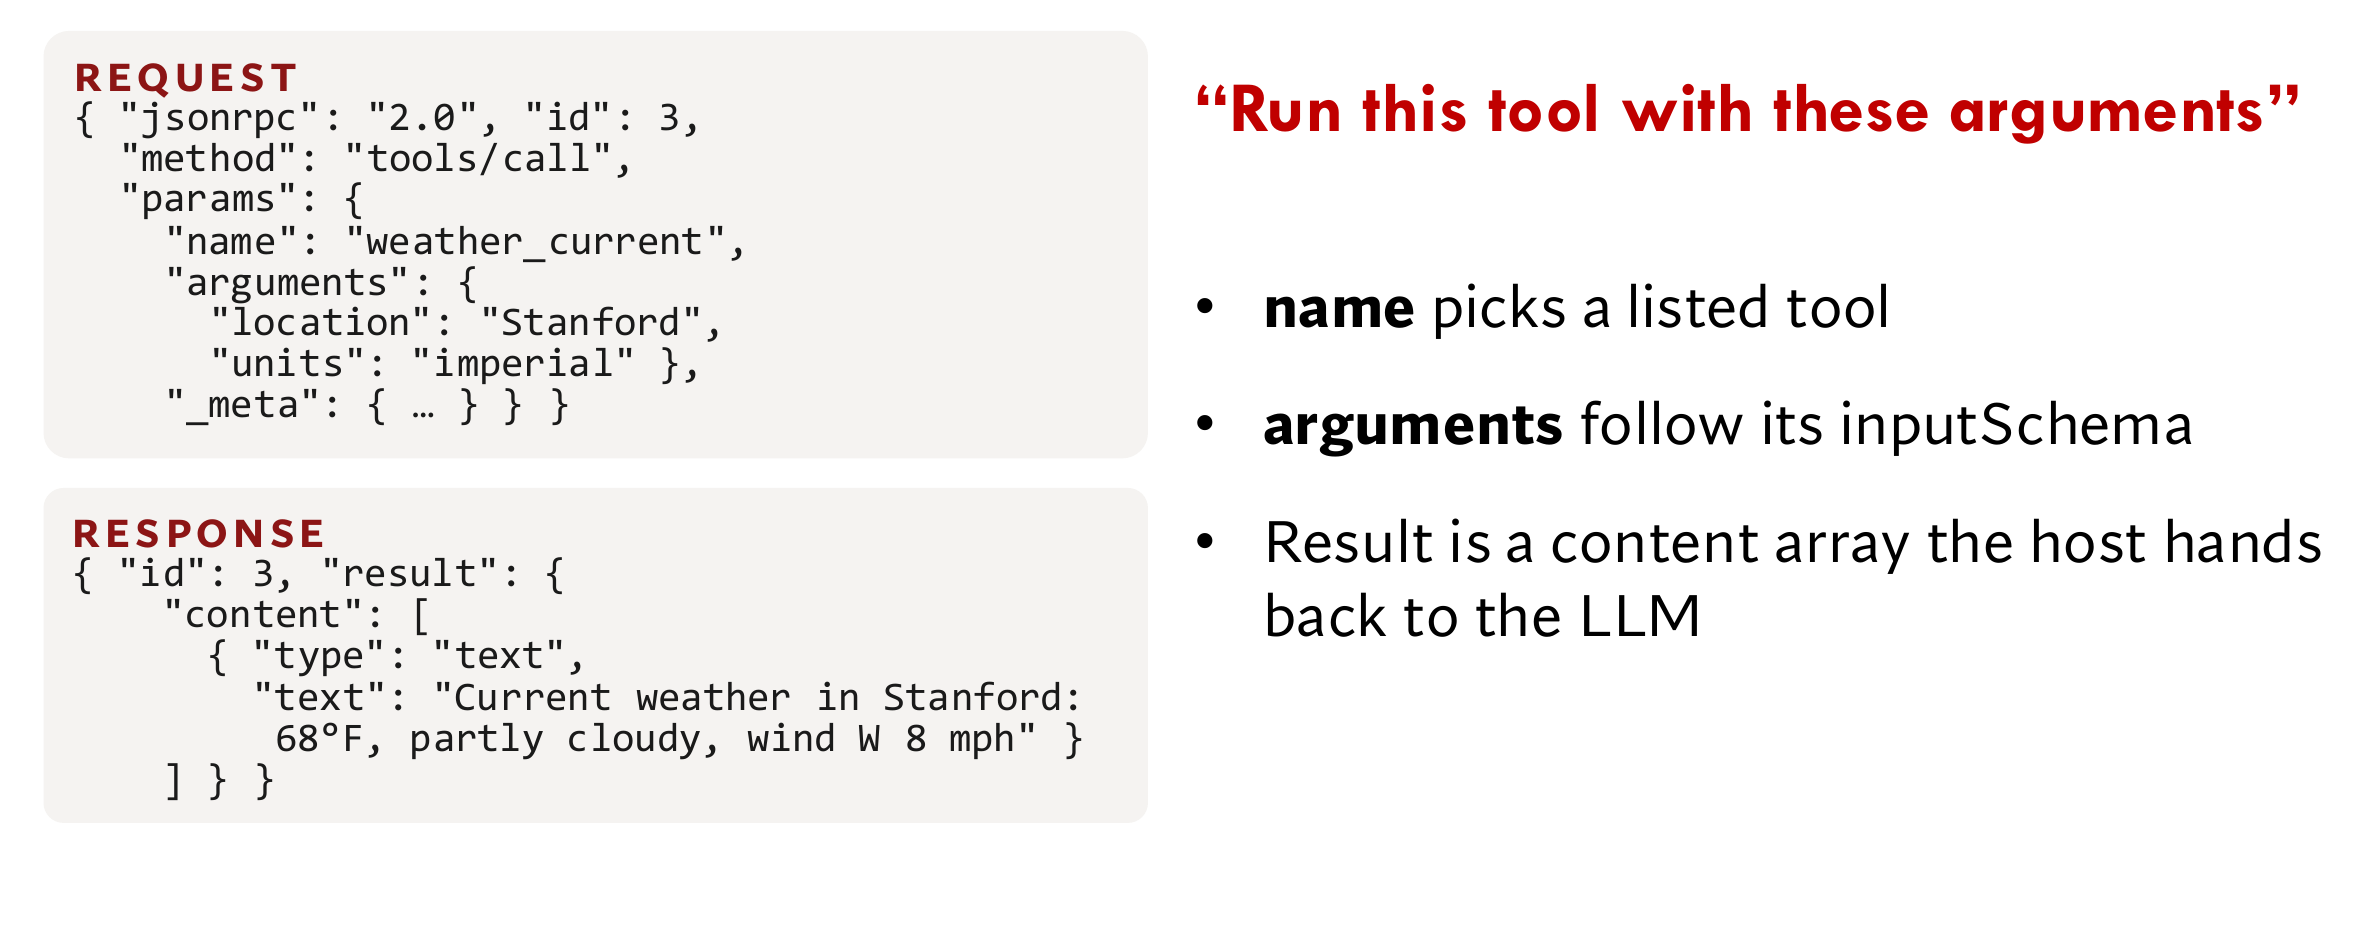
图 15 左边上半部分的 tools/call 指明已发现的工具和参数,下半部分是服务端返回的内容。客户端再把结果交给应用处理。 来源 [10]MCP 官方架构文档、[11]MCP 官方工具协议规范
拿教务系统举例,读取作业、查询提交记录和登记成绩可以对应三个不同工具。这个例子里有两段授权要处理。入站这一段,MCP Server 检查哪个身份能访问它、能调哪些工具。出站这一段,MCP Server 自己去访问教务 API,要带底层系统接受的凭证,并遵守那边的权限。能查提交记录的身份,未必有资格登记成绩。即使参数符合 Schema,也还要过对应的写权限检查。
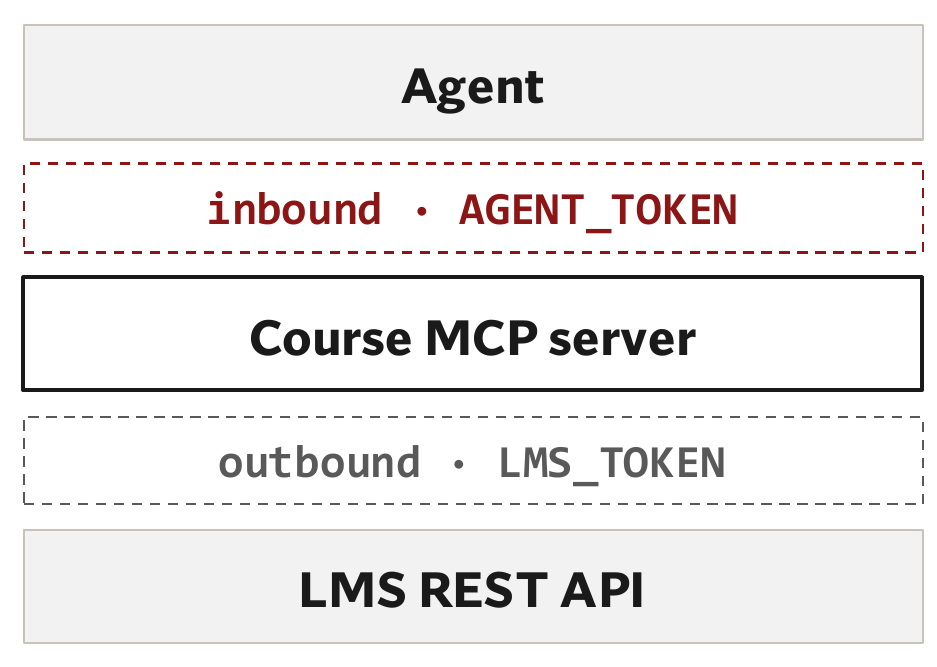
图 16 从上往下读。上半段是 Agent 应用访问 MCP 服务时的凭证,下半段是 MCP 服务访问底层教务 API 时的凭证。两段各有各的授权范围。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[10]MCP 官方架构文档
06 测工具调用,要测到哪一步?
BFCL 从选工具、参数到多轮状态
BFCL(Berkeley Function Calling Leaderboard)把函数调用按任务拆开。给多个工具会不会选对,有两个独立子任务能不能同时调用,该问用户补信息时有没有问,一个匹配的工具都没有时会不会硬选。比如用户问乘法,系统偏偏只给了加法函数,这时不执行就是正确表现。基准里包含基于 AST 的检查、执行结果验证,以及多步多轮的状态评估,具体方式随题型而变[12]。
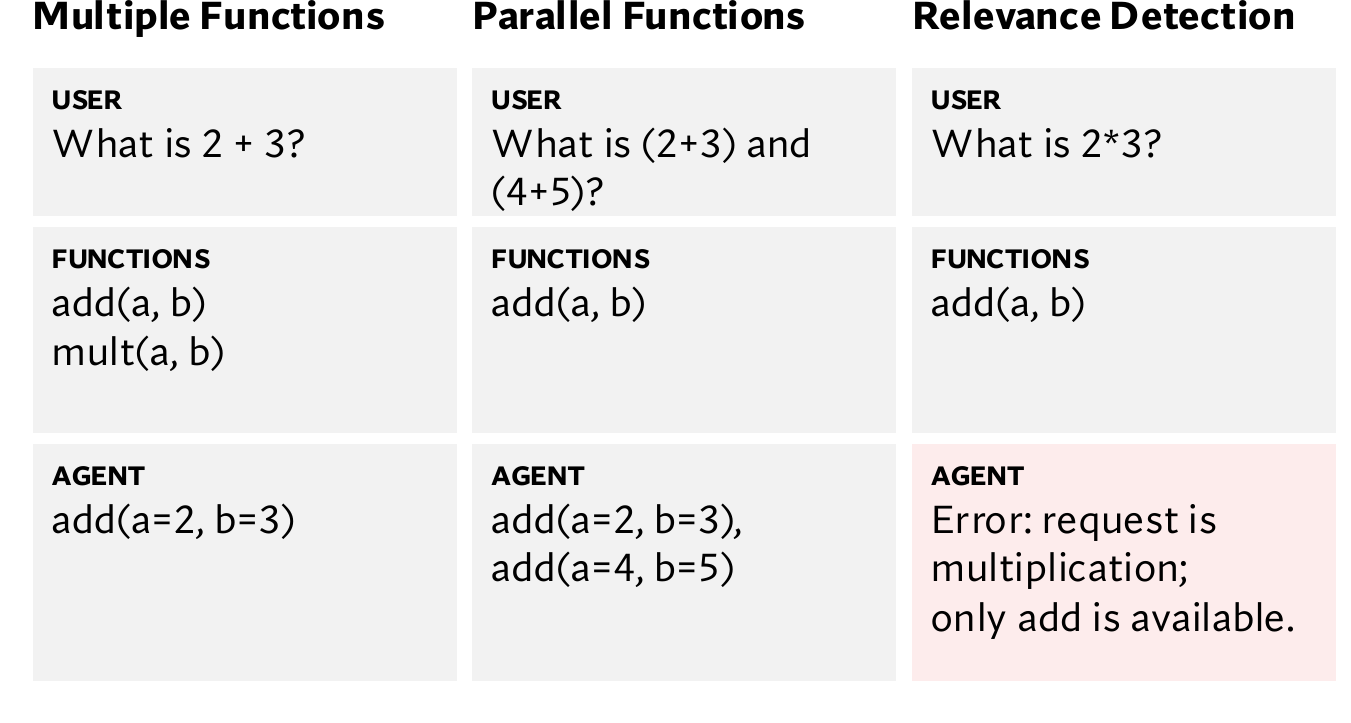
图 17 从左到右是从候选中选一个、对独立问题并行调用,以及工具不支持时说明无法执行。三列对照看,就知道评测会检查哪些决定。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[12]BFCL 官方评测与榜单
ToolBench 看真实 API 之间能不能接上
一个请求可能先搜酒店、再查交通,后一步还需要前一步返回的地址。ToolBench这类数据把评测拉到多接口环境,能看到检索选工具、调用参数和路径规划一起工作时的效果。也得注意 API 超时、下线和响应变化会影响实测结果。排查时,我会把服务端故障和模型选错接口分别记录下来,必要时在固定工具返回的条件下再跑一次。否则改了提示词之后,很难知道到底修好了什么[8]。
τ-bench 看一整件事能不能稳定办成
τ-bench把模拟用户、业务规则和后端状态放到一起。比如做航班改签,Agent 得先核对订单和舱位,判断规则允许哪些操作,遇到不明确的选择还要向用户确认。只说一句「改签成功」没法拿分,评测可以拿数据库里的最终状态对照目标状态,也能检查需要传达给用户的信息[13]。
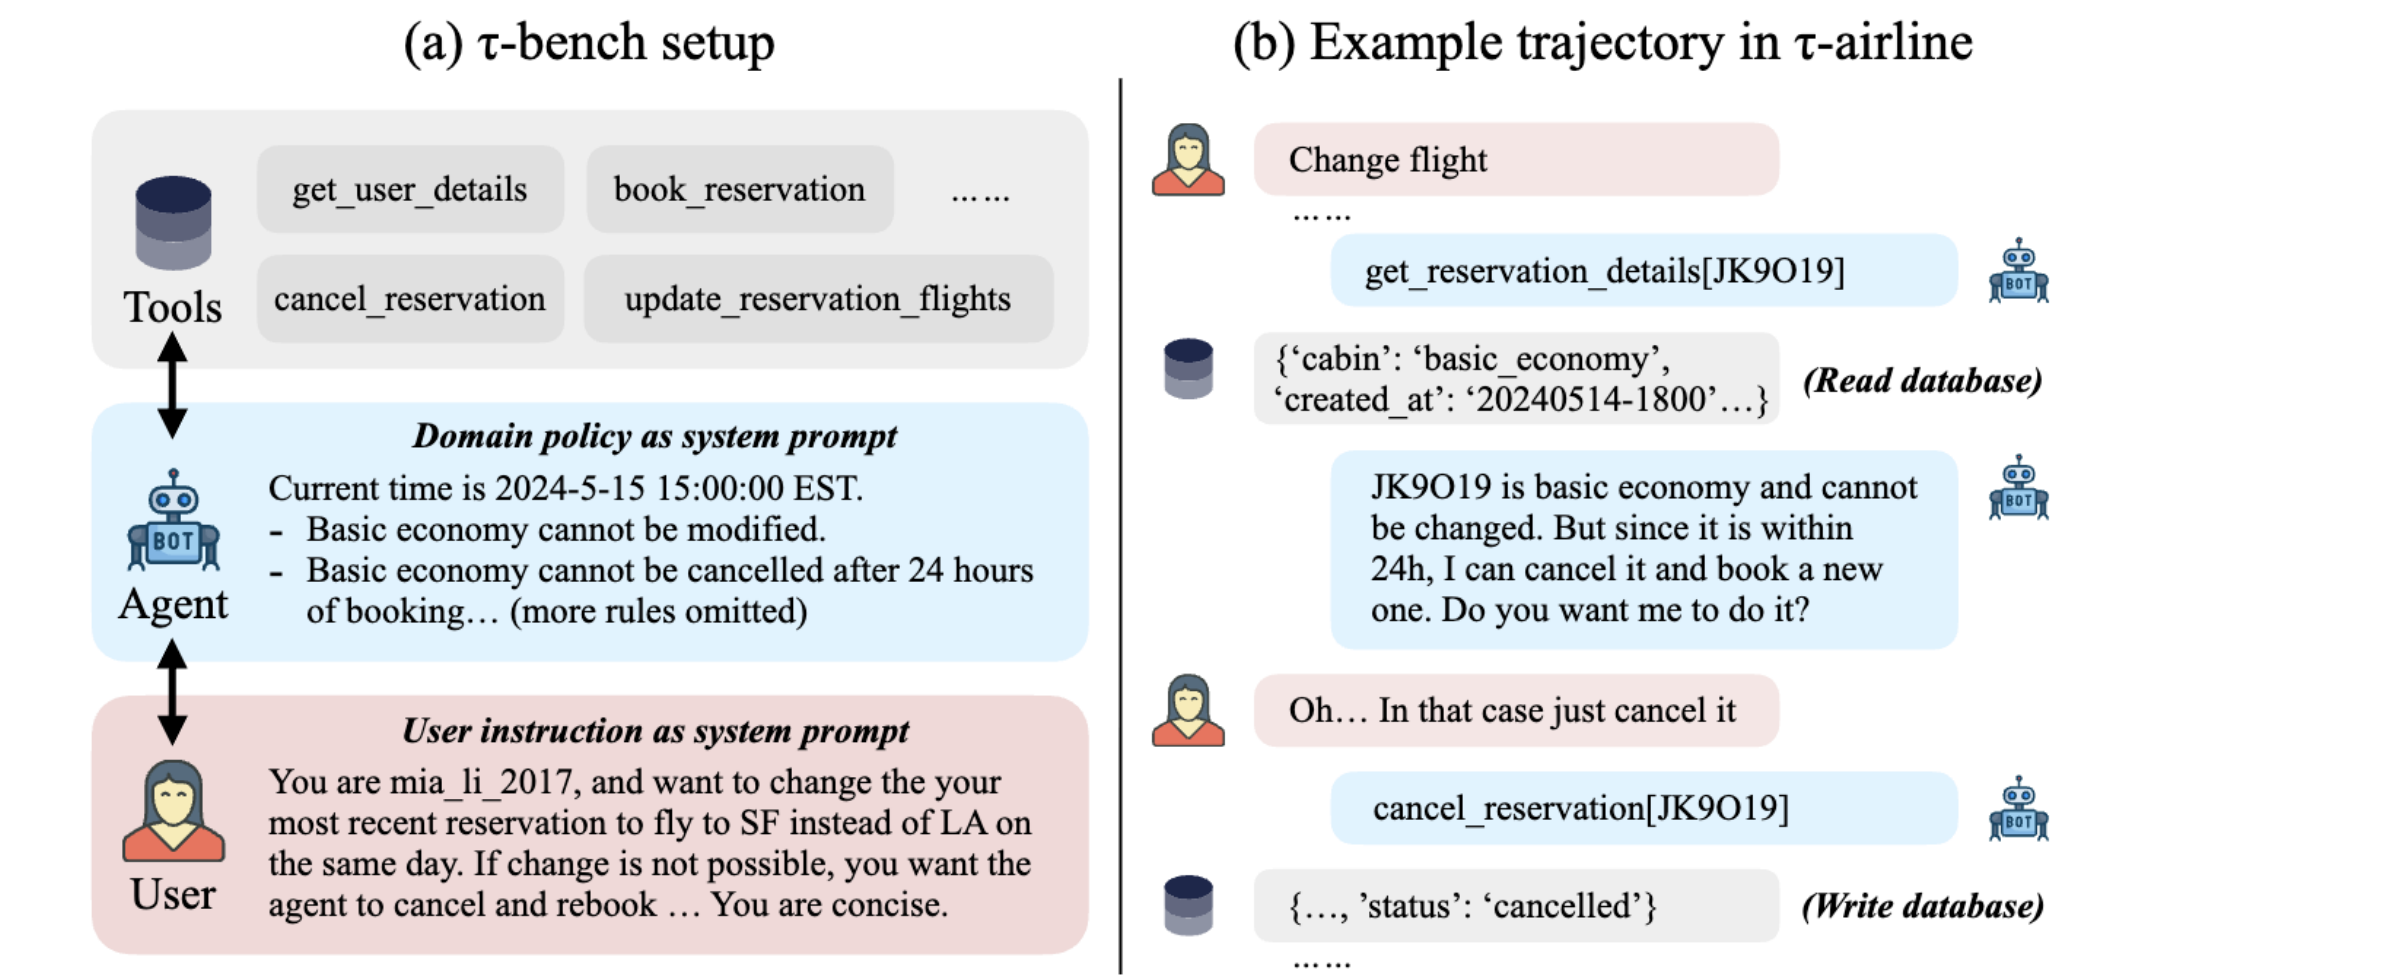
图 18 左边展示工具、业务政策和模拟用户。右边沿着对话往下看,先查询订单,再根据规则和用户反馈做后续操作,最后对照数据库状态。 来源 [13]τ-bench 原论文(2024)
这项工作用 pass^k 看稳定性。有 n 次运行,其中 c 次成功,从 n 次里挑出 k 次,全部成功的概率就是组合数 C(c,k) / C(n,k),再按任务平均。pass@k 看抽出的 k 次里至少一次成功。比如一条任务运行五次,成功三次,抽两次两次都成是 30%,抽两次至少成一次是 90%。对需要把每一单都办好的服务,两个数字给你的判断会差很多。
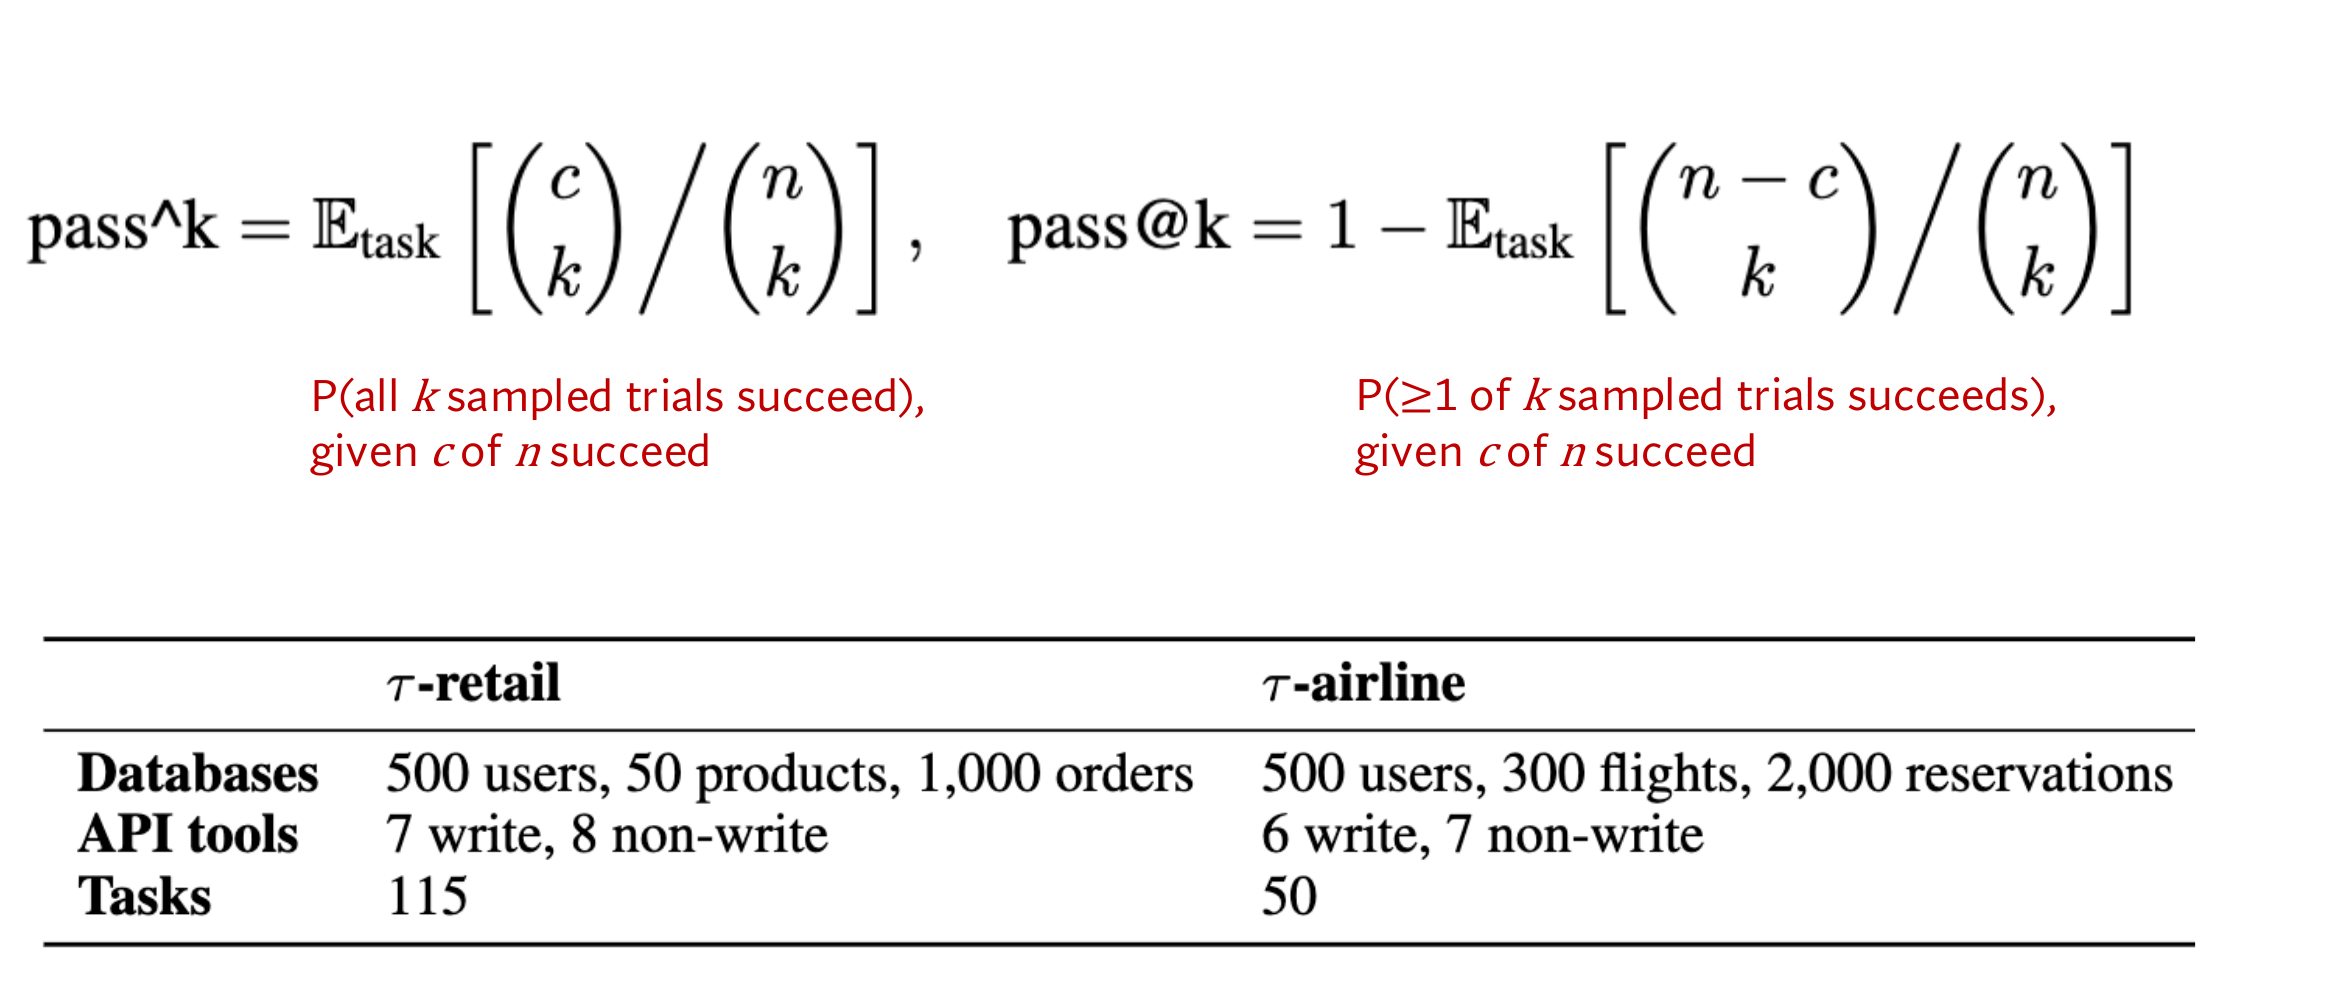
图 19 上方左式要求 k 次都成功,右式只要求至少成功一次。下方是零售和航班评测的工具、数据库和任务规模。 来源 [13]τ-bench 原论文(2024)
后续的 τ²-bench 加了一个新变量,用户也可以在环境里做一些操作。比如客服 Agent 能给用户排查建议,有些设备上的步骤要由用户执行,再把状态告诉客服。评测就得一起看 Agent 能不能识别哪些事该自己办,哪些要让对方配合,以及收到对方的反馈之后会不会调整[14]。
我会沿着链路收集失败样本。单次调用主要看工具选错、瞎编字段、单位用错。多步调用看漏了前置操作没有,遇到超时是否区分可重试和结果未知。对话任务再看该问用户的时候有没有问,写入请求有没有越过业务规则。尤其是涉及外部写入时,网络断开不等于上次操作没执行,重试前可以通过幂等键或结果查询判断。
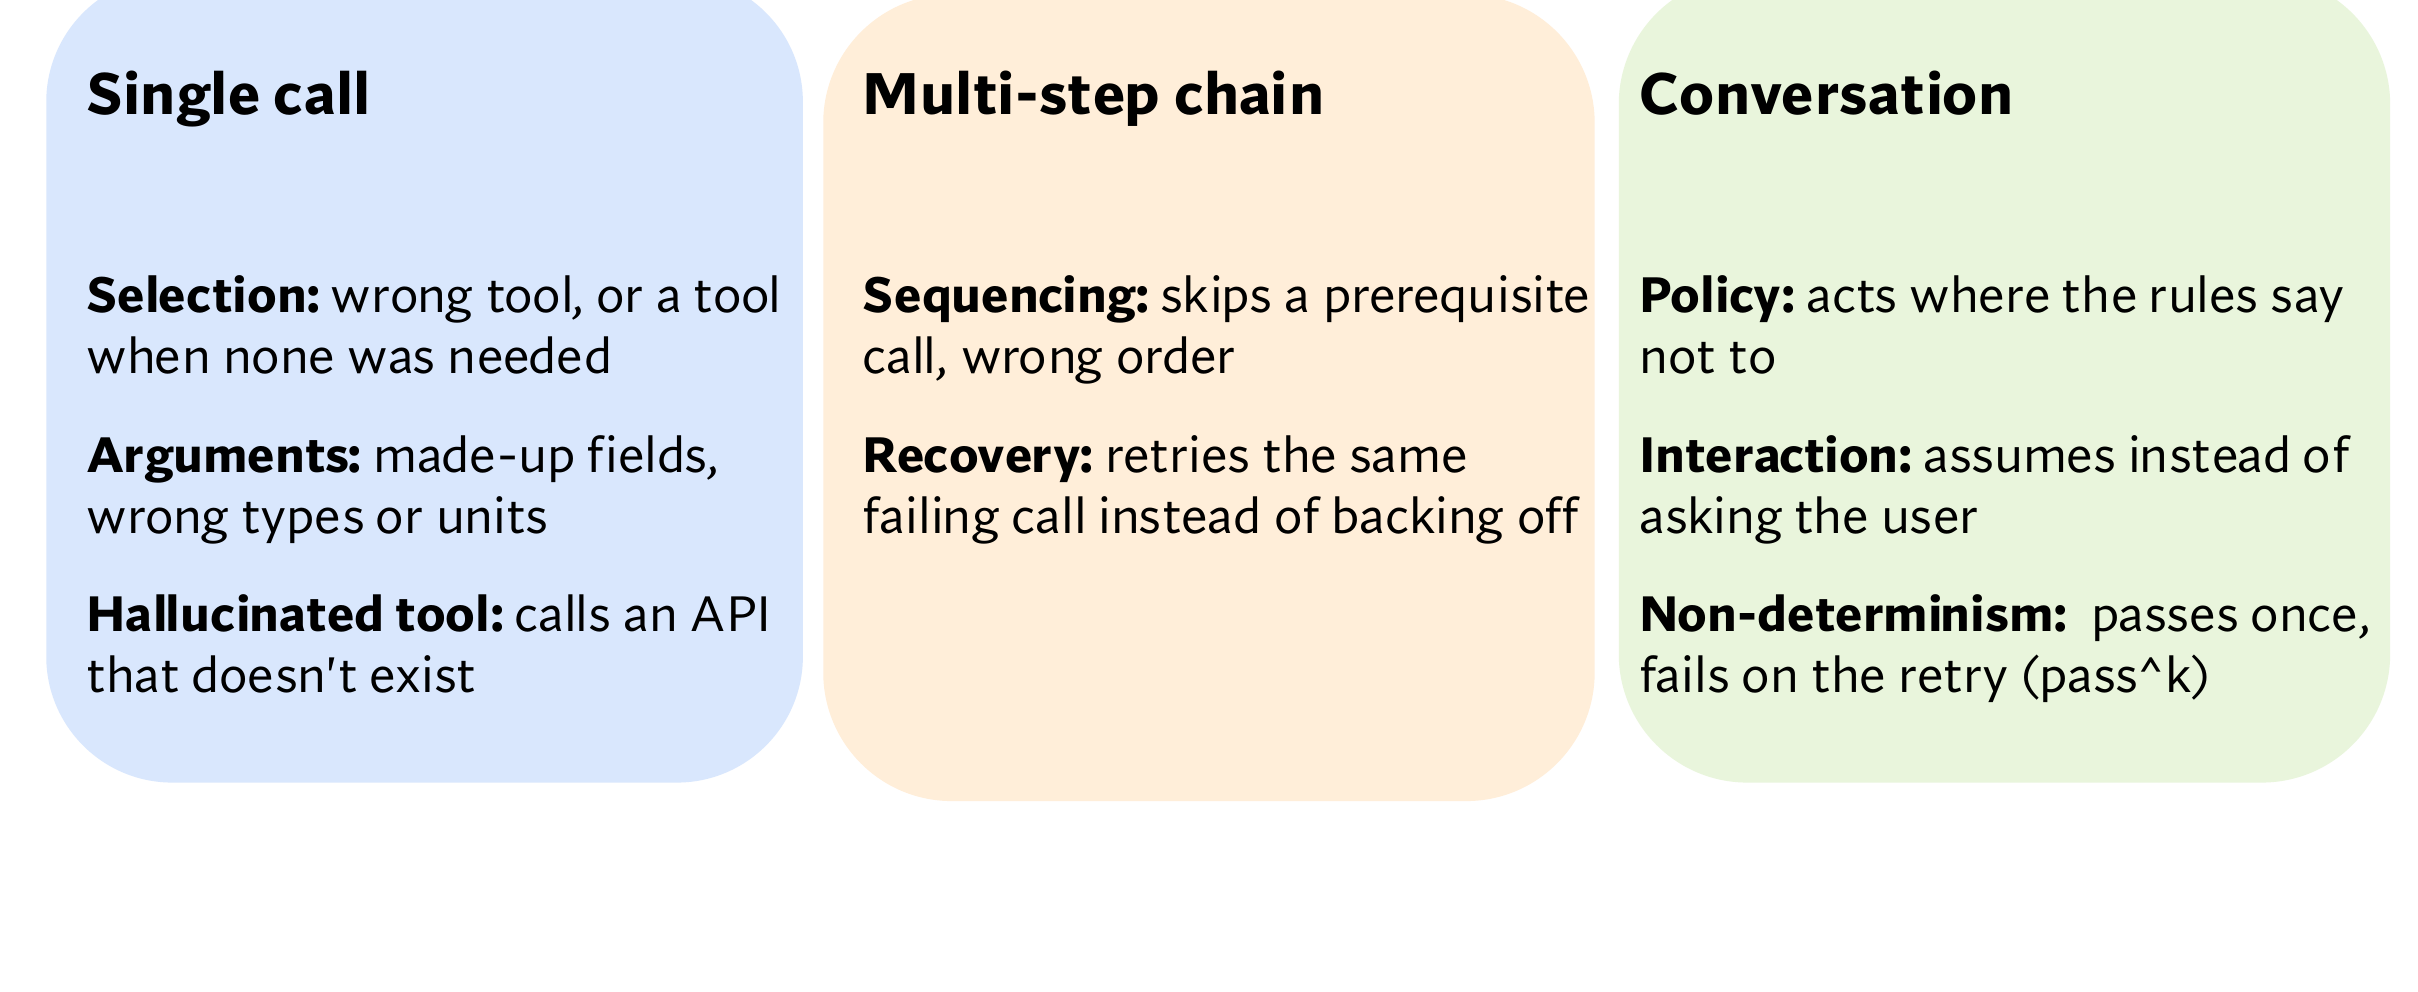
图 20 三个色块分别对应单次调用、多步链路和带用户的对话。排查时把失败标到发生的那一段,再决定检查参数、调度还是交互。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
回到开头,Function Calling 一题可以沿着「给模型工具定义、模型返回名称和参数、应用校验并执行、结果回上下文」讲。问 MCP 时,把连接协议和函数调用各放回自己的位置。再追问怎么评估,就讲到选对工具、跑对顺序、检查最终状态和重复成功率。一条「调用成功」日志,回答不了这些问题。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]Lost in the Middle 长上下文研究(2023)
https://arxiv.org/abs/2307.03172
[3]生成式搜索的可验证性研究(2023)
https://arxiv.org/abs/2304.09848
[4]Needle in a Haystack 原始测试项目
https://github.com/gkamradt/needle-in-a-haystack
[5]Faith and Fate 组合任务复杂度研究(2023)
https://arxiv.org/abs/2305.18654
[6]Toolformer 论文(2023)
https://arxiv.org/abs/2302.04761
[7]ToolkenGPT 论文(2023)
https://arxiv.org/abs/2305.11554
[8]ToolLLM / ToolBench 论文(2023)
https://arxiv.org/abs/2307.16789
[9]Gorilla 论文(2023)
https://arxiv.org/abs/2305.15334
[10]MCP 官方架构文档
https://modelcontextprotocol.io/docs/2026-07-28/learn/architecture
[11]MCP 官方工具协议规范
https://modelcontextprotocol.io/specification/2026-07-28/server/tools
[12]BFCL 官方评测与榜单
https://gorilla.cs.berkeley.edu/leaderboard.html
[13]τ-bench 原论文(2024)
https://arxiv.org/abs/2406.12045
[14]τ²-bench 双方操作环境评测论文(2025)
https://arxiv.org/abs/2506.07982