TechGuide「AI Agent 面试专题」第 3 篇 · RAG 与检索
正文约 4300 字 · 预计阅读 9 分钟
大家好,我是声哥。
上一篇讲到,模型能用哪些资料,得看系统把什么放进上下文。面试里要是追问「知识库明明有答案,为什么还是答错」,光背 RAG 的流程就接不住了。这篇拿一次检索请求走一遍,从切块、召回讲到重排和评测。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
01 为什么要先查资料?
有个例子挺直观。问模型「这周哪个答疑时段排队的人最少」,它可能猜周三下午人少,理由也说得过去。要是把过去三周的排队记录给它,它就能根据记录比较,周二下午平均有 14 人,周四上午平均只有 3 人。后者给出的依据可以回查。这个例子用来说明怎么利用历史数据,具体这周会排多久,仍然看实际情况。
这就是 RAG(检索增强生成)的出发点。先从外部资料里找和问题相关的内容,再把它交给模型生成答案。文档更新时可以改资料和索引。回答带上对应段落,读者也能自己检查模型有没有读错。
早期的开放域问答已经有类似分工。检索器(Retriever)在大资料库里缩小范围,阅读器(Reader)读候选段落,找出答案。比如从整套百科里先找到和华沙有关的文档,再在里面读出人口数字。DrQA 就是这个思路的典型例子[2]。
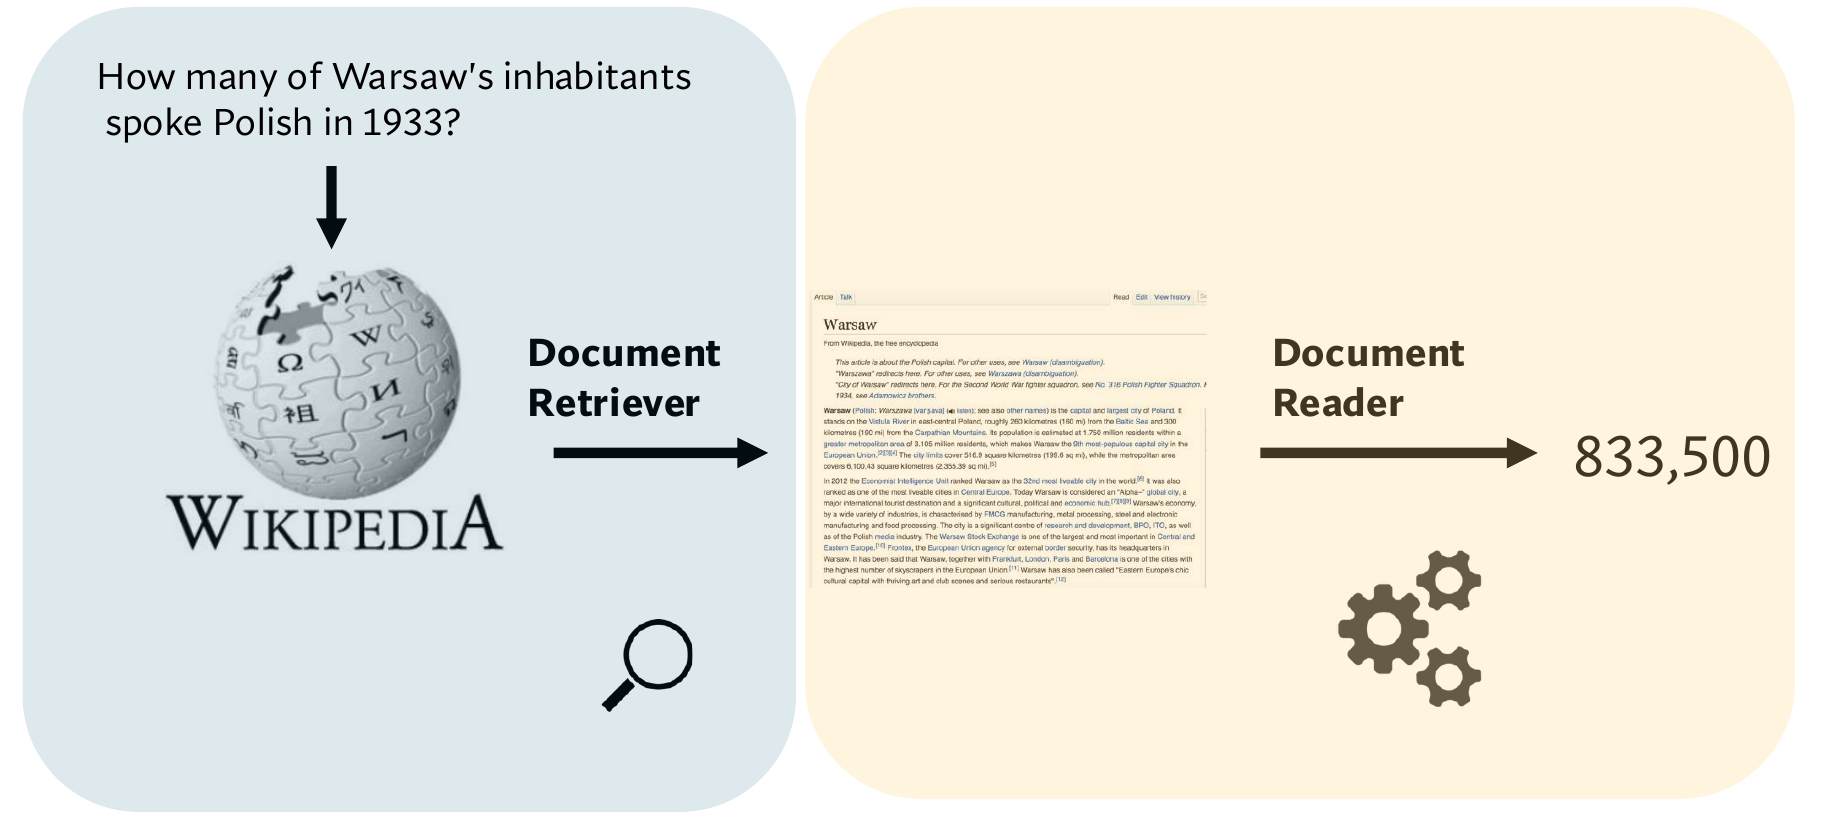
图 01 左边用问题检索百科,右边让阅读器从候选文档里找到答案。两段分开看,就能判断是查错了文档,还是读错了数字。 来源 [2]Reading Wikipedia to Answer Open-domain Questions(DrQA)
02 一次 RAG 请求是怎么走的?
工程里常见的链路前后分两段。离线把文档切成片段、建索引。在线拿用户的问题查索引,取回候选,把它们和问题放进上下文,再让模型作答。必要时在检索和生成中间加一层重排。
原始 RAG 论文给出的是一个可训练的做法。检索器根据问题给每段资料打分,生成器根据问题和资料生成答案。可以把多个候选段落的贡献看成按检索分数加权。RAG-Sequence在每个候选文档的条件下给整条回答算概率,再对候选加权。RAG-Token可以在每个输出位置对文档条件分布重新混合,前后不同的词可以依赖不同的资料。原论文用 DPR 做检索、BART 做生成,还可以联合优化检索器和生成器的相关参数[3]。
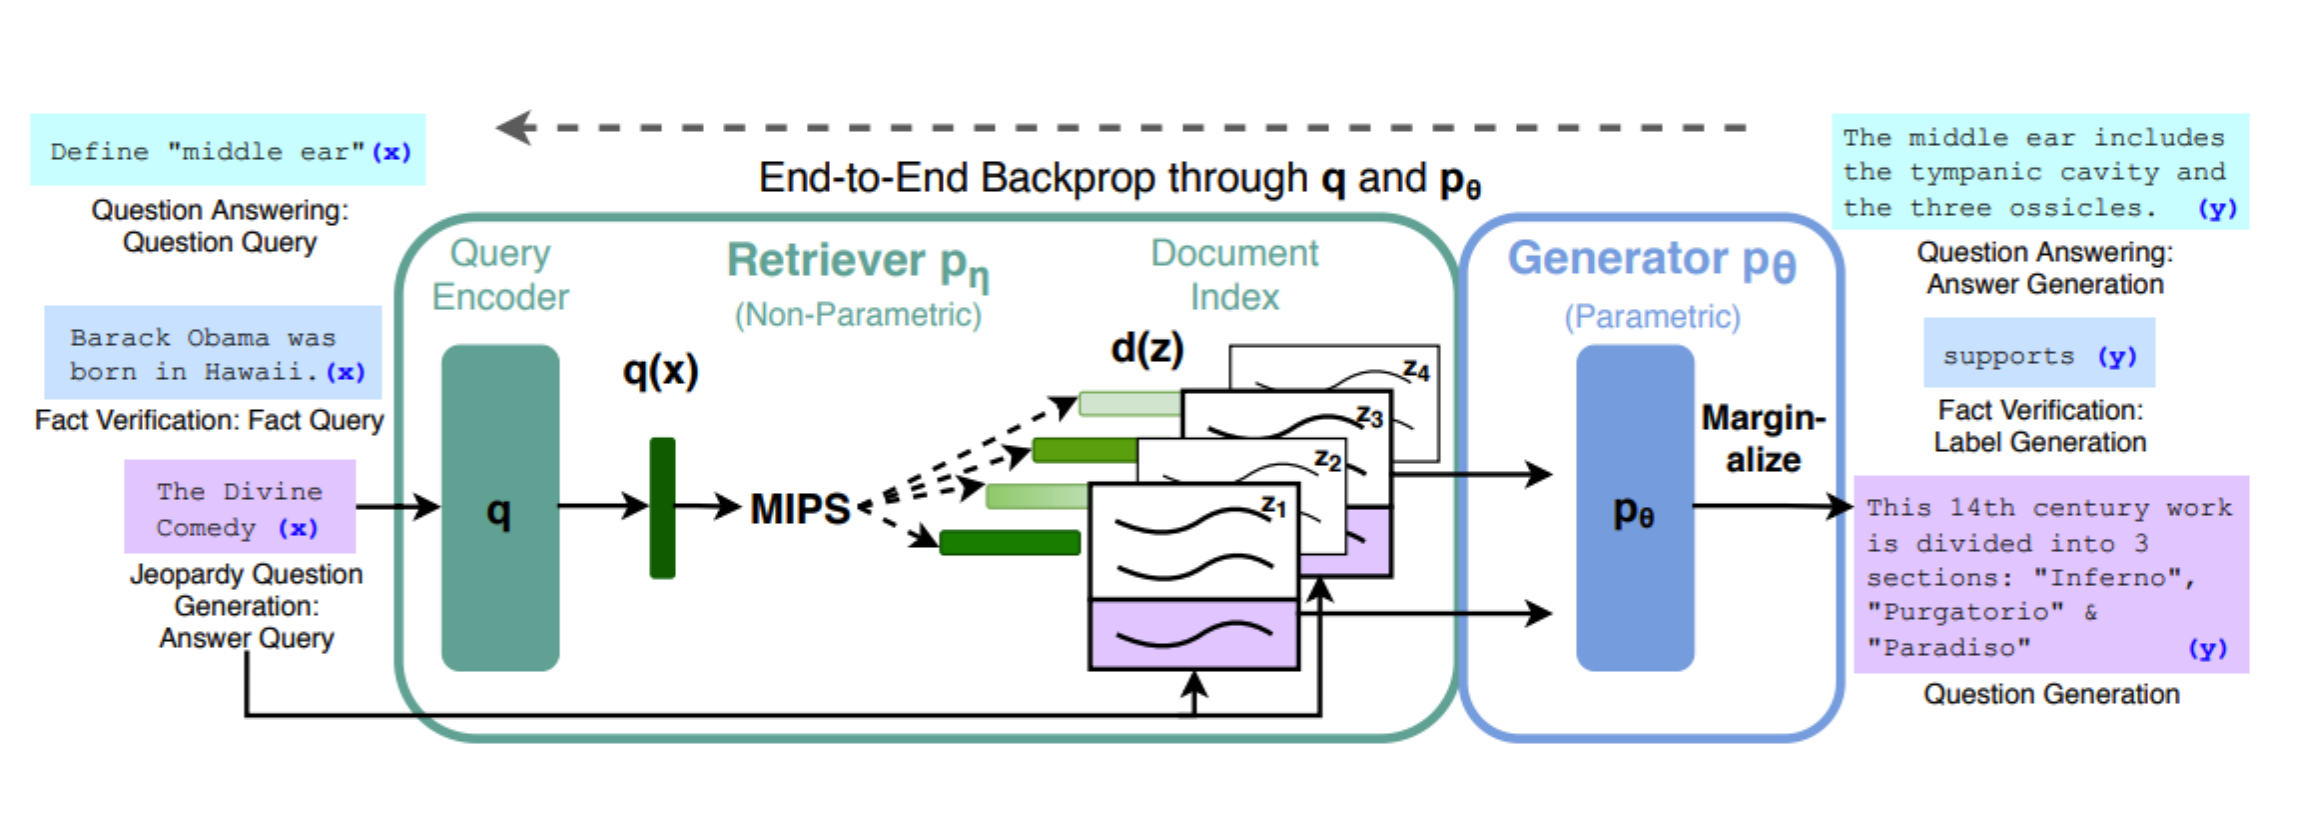
图 02 从中间往右读。问题先被编码,用向量索引找到候选段落,再由生成器结合问题和候选产生答案。图上的反向箭头表示训练时的反馈还可以传回检索侧。 来源 [3]Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
论文里的开放域问答测试显示,检索可以带来收益,但不同数据集的结果有差别。今天用通用大模型和搜索服务搭 RAG,通常可以先把它们作为独立组件接起来。线上查错时,先留住「到底检索到了哪些段落」这份记录,后面才分得清是哪一步出了问题。
在这条基本流程上,还能改造检索前、检索后两段。检索前可以改写查询、补搜索词或做路由,把问题送到对应的库。检索后可以重排或筛掉明显无关的段落。模块化 RAG 的想法是把这些环节拆开,根据任务挑选组合,某一段效果不够就单独换。
03 建索引之前,先想好什么叫一段资料
向量到底在表示什么?
向量检索把查询和材料转成数字向量,再用余弦相似度或点积比较。不同模型向量的粒度不一样。word2vec 这类静态词向量给同一个词共用一份表示。BERT 能让同一个词根据上下文变出不同表示。给 RAG 建索引时,常见做法是为每个文本块生成一个向量。图文混合的任务也有把文本和图片映射到同一空间的方法。
关键不只在于用了哪个 Embedding 模型。一个向量代表的是哪段文字?那段文字离开上下文后还读得懂吗? 这两个问题先要在切块时解决。
Chunking 怎么切才有用?
固定长度切块简单,太短容易把条件、例外、时间点切散,太长又容易把多个主题挤进同一个向量。可以给相邻块留一点重叠,也可以按标题、段落、句子等结构切。在格式复杂的文档里,还可以让模型帮忙找边界。块长和重叠度需要根据文档和查询类型验证,先从能复现实验的一套配置做起。
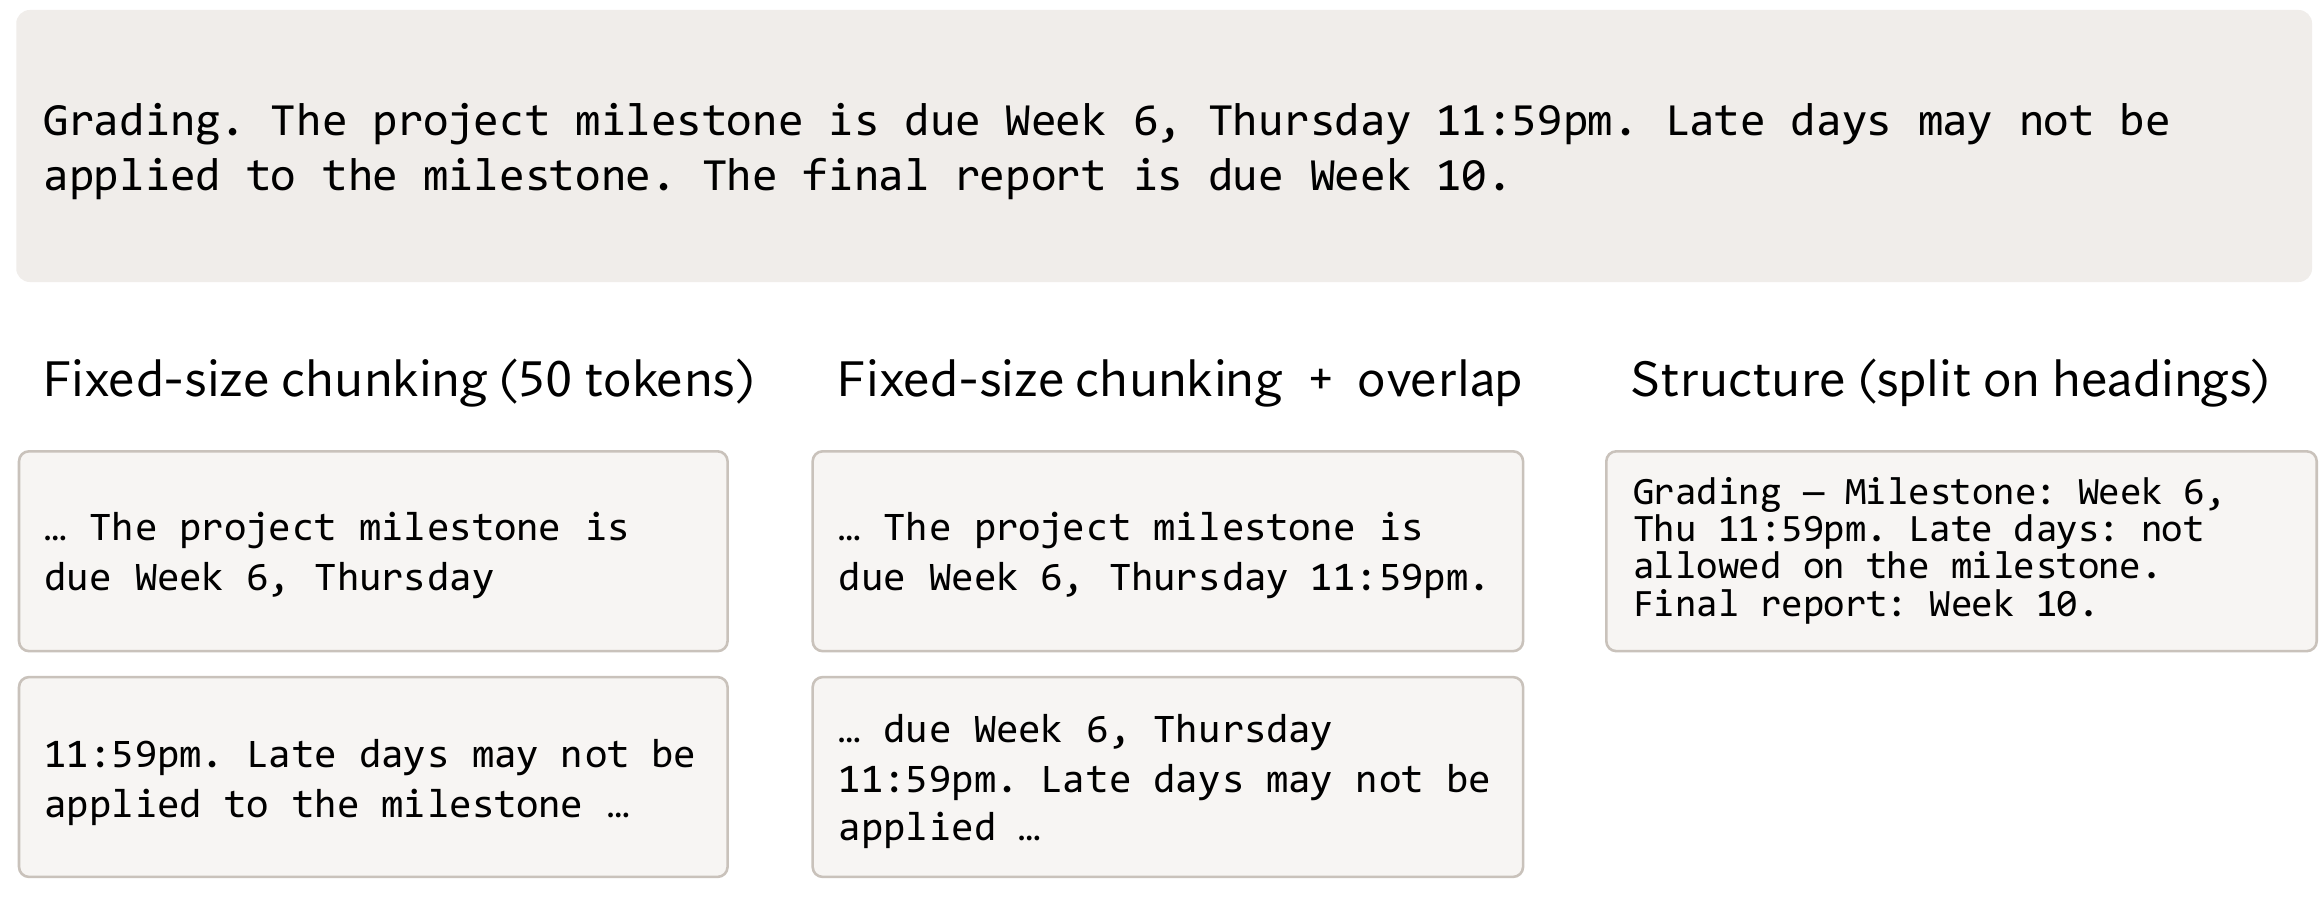
图 03 左边固定长度,把截止时间切到了下一块。中间保留重叠,尽量把和时间有关的信息留住。右边按结构切,尽可能让同一条规则完整出现在一块里。
一段话里的「这家公司」是谁?
比如财报里有一句「公司营收环比增长 3%」。单看这段,它没说是哪家公司、哪个季度。用户查 ACME 2023 年第二季度财报,这个段落就可能不好找。
上下文检索(Contextual Retrieval)会先用全文给每个块补一小段介绍,写清所在文档、章节或时间,再用补过的内容建立向量索引和关键词索引。Anthropic 的对照实验里,结合上下文向量和上下文 BM25 后,Top-20 的平均检索失败率从 5.7% 降到 2.9%。这是这组资料和实验配置下的结果[4]。
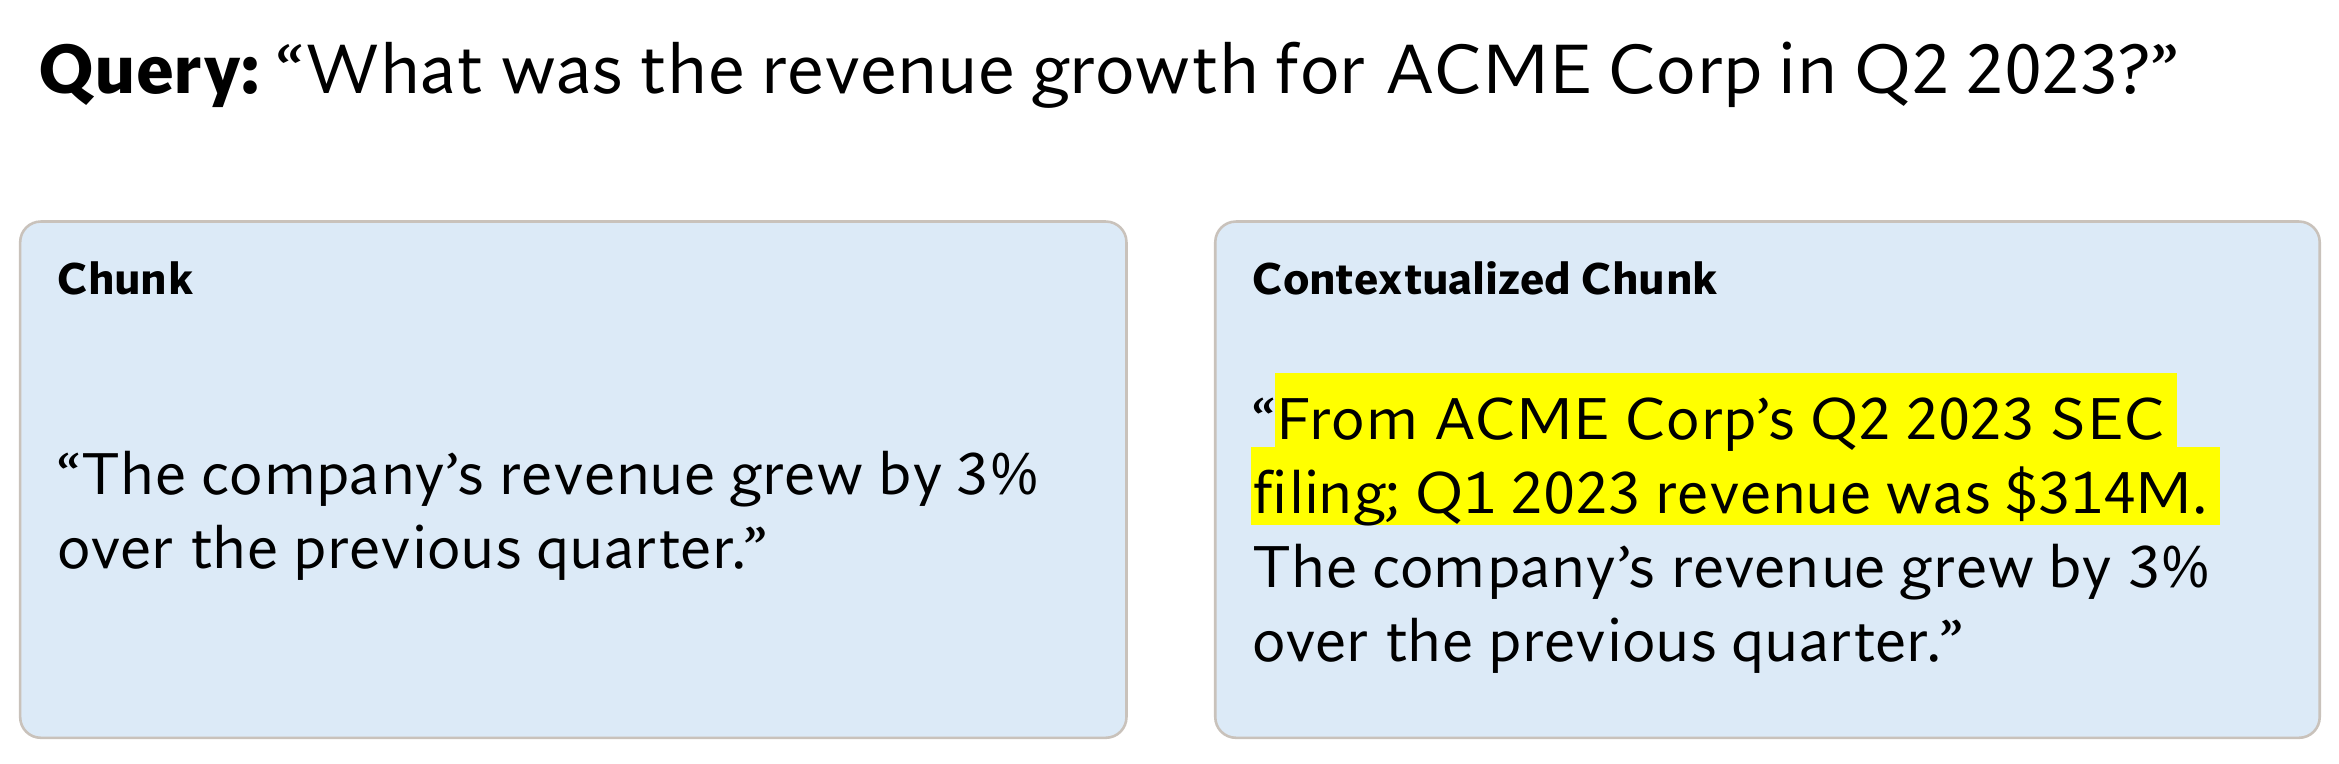
图 04 左框只有一条营收增长的信息,右框加上了公司名、财报季度和前一季度的数据。查找目标公司和季度时,检索器就有了更多线索。 来源 [4]Anthropic 的 Contextual Retrieval 实验
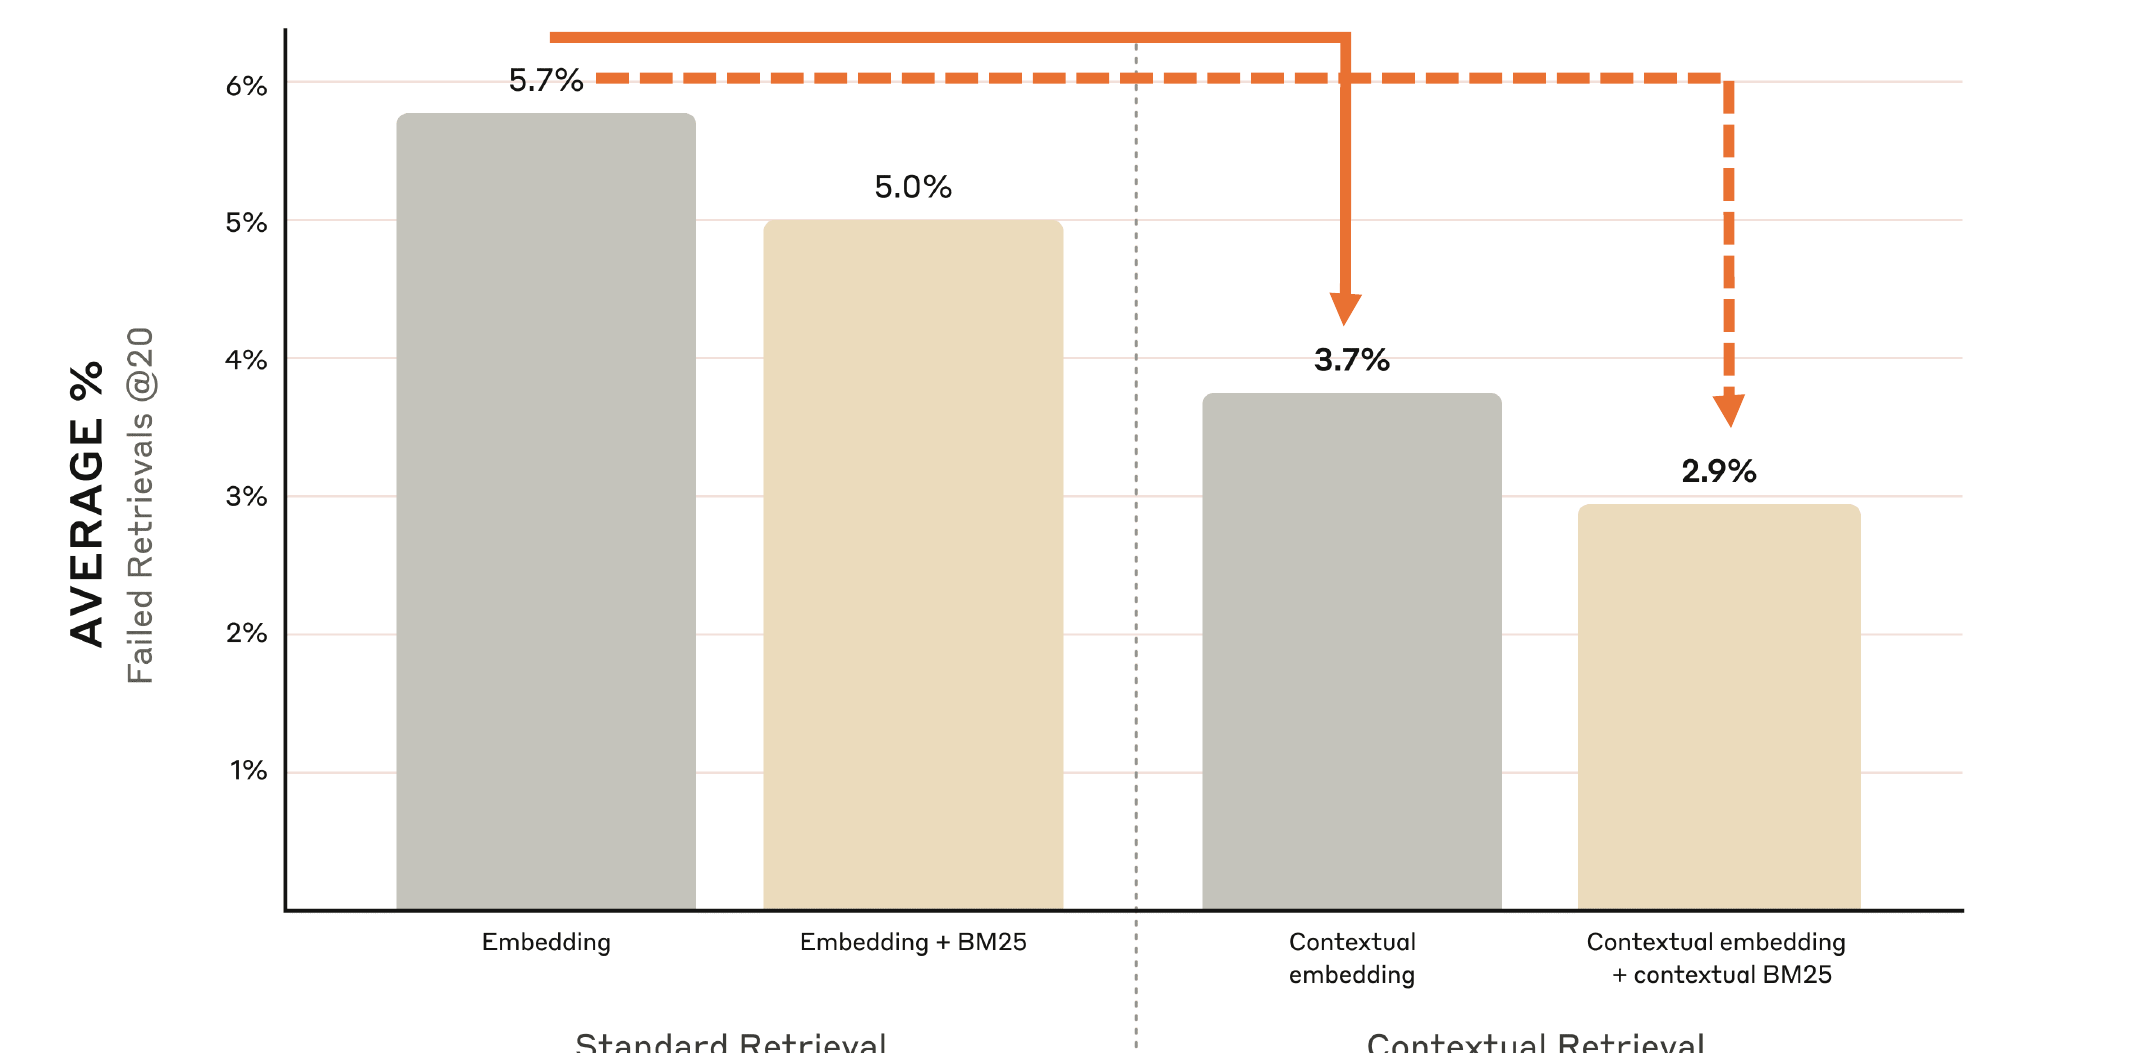
图 05 纵轴越低,表示越少出现「前 20 条里一条有用资料也没有」。从左到右依次增加了词法检索、上下文向量等做法。 来源 [4]Anthropic 的 Contextual Retrieval 实验
晚切块(Late Chunking)也想保留语境,顺序不同。先用支持长上下文的编码器读整篇文档,得到每个 token 的表示,再把某个切块范围内的 token 向量汇总成一个块向量。这样块本身不必附一段文字说明,向量已经参考过周围内容。代价是离线编码时需要处理更长的文本[5]。
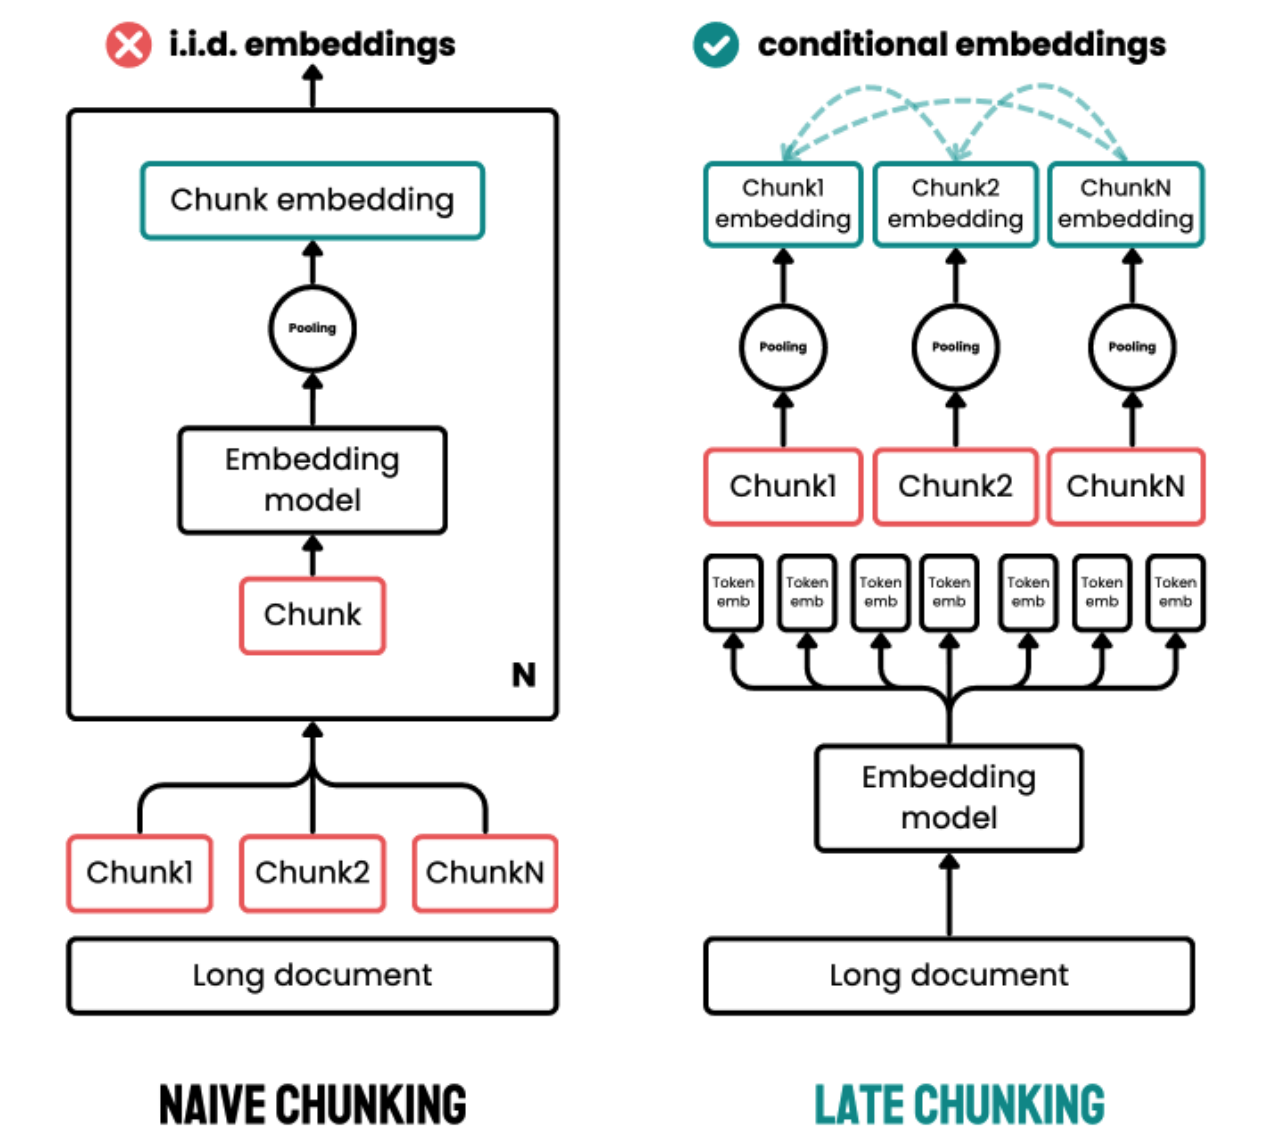
图 06 左边把各块独立交给模型,右边先让编码器看到长文,再按块把 token 向量汇总。 来源 [5]Late Chunking(长上下文分块向量)
全局问题和细节问题,可以查不同层
如果问「灰姑娘最后怎么获得幸福」,答案可能来自几段情节。如果问「这个故事的中心主题是什么」,只找到一段对话通常不够。RAPTOR把文本块向量聚类,把同组材料总结成一份摘要,再对摘要继续分组和总结,最后得到一棵树。叶子留着细节,上层放概括。检索时,两种资料都有机会被找到[6]。
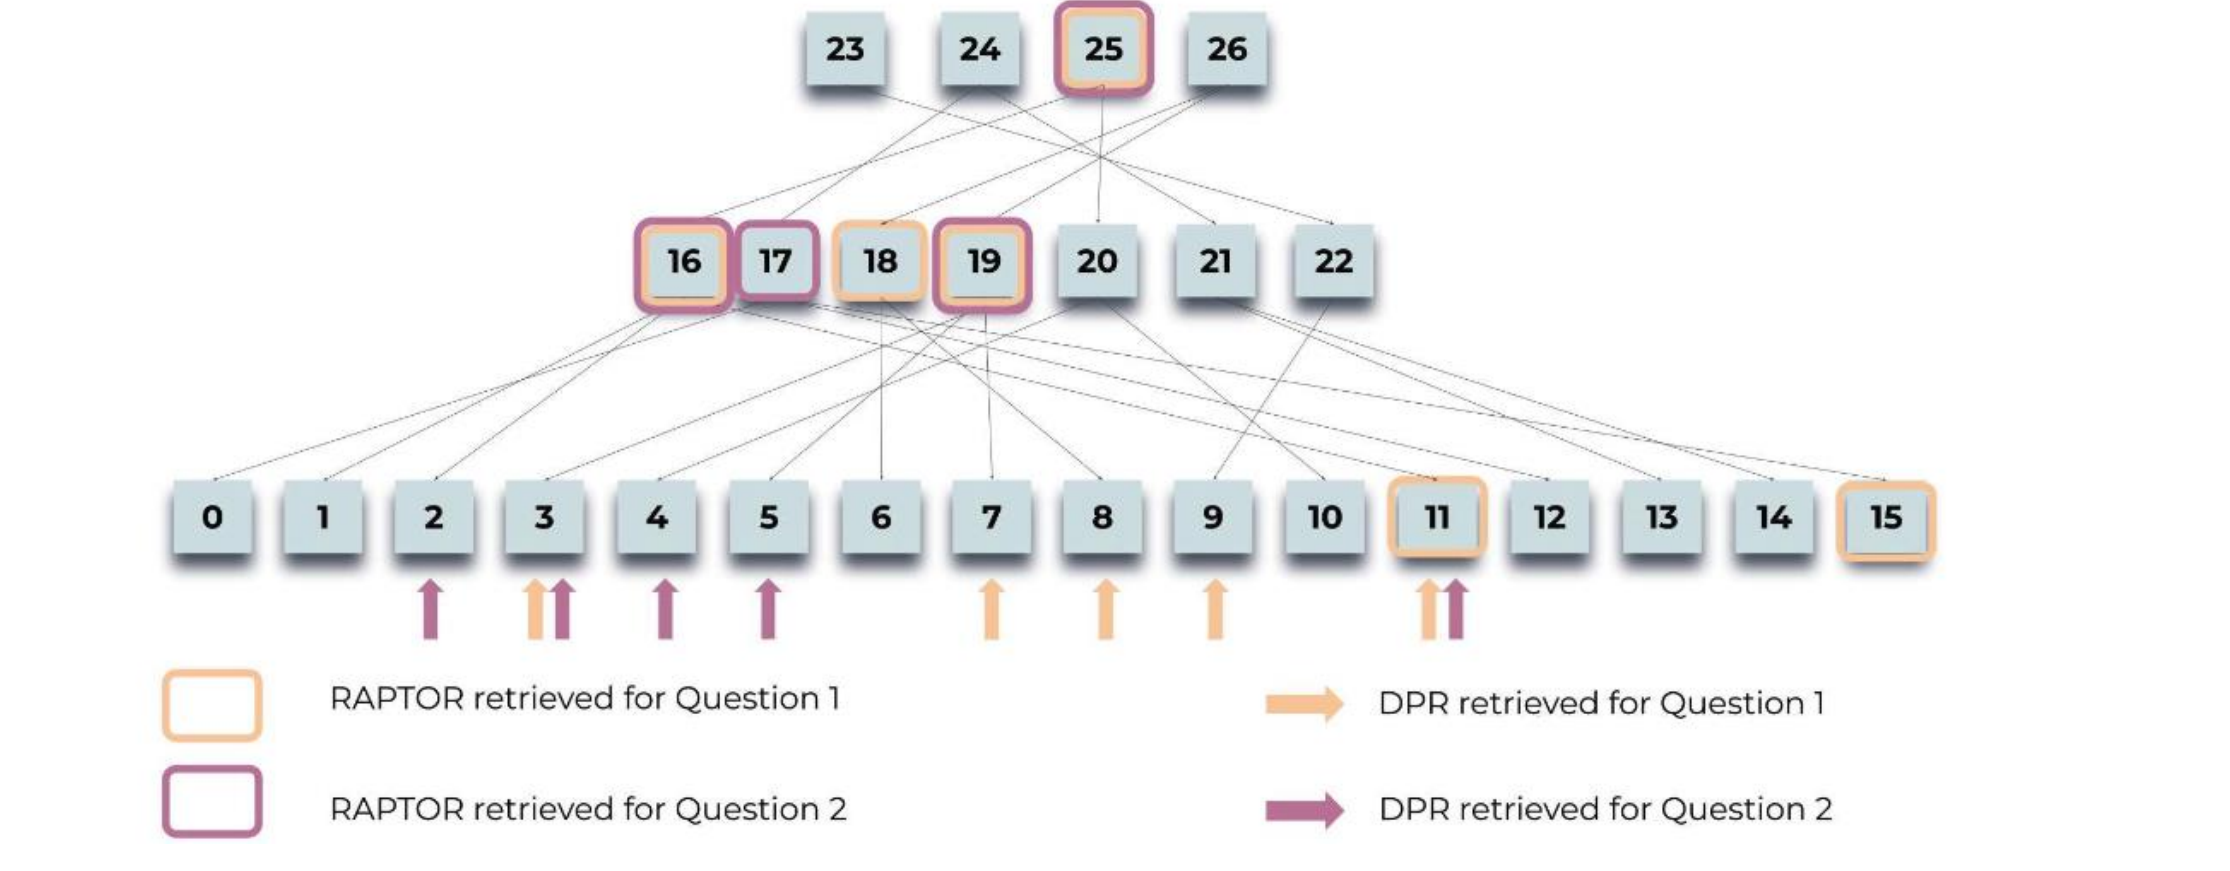
图 07 最底下一排是原始片段,上面是由几个片段整理出的摘要。图里用两种颜色标出灰姑娘的两个问题,问题不同,合适的层也会不同。 来源 [6]RAPTOR(树状索引)
GraphRAG则沿着另一条线组织资料。先从文档里提取实体和关系,建成图,再把联系紧密的部分分成群组并生成群组摘要。想综合大量文档理解全局主题时,可以用这些摘要汇总答案。想沿着某个实体追关系,也可以用图来组织证据。建图质量、索引成本和更新频率都要算进去[7]。按条款查某个明确数字时,简单检索往往已经够用。树或图更适合需要合并不同段落、甚至多篇文档才能回答的问题。
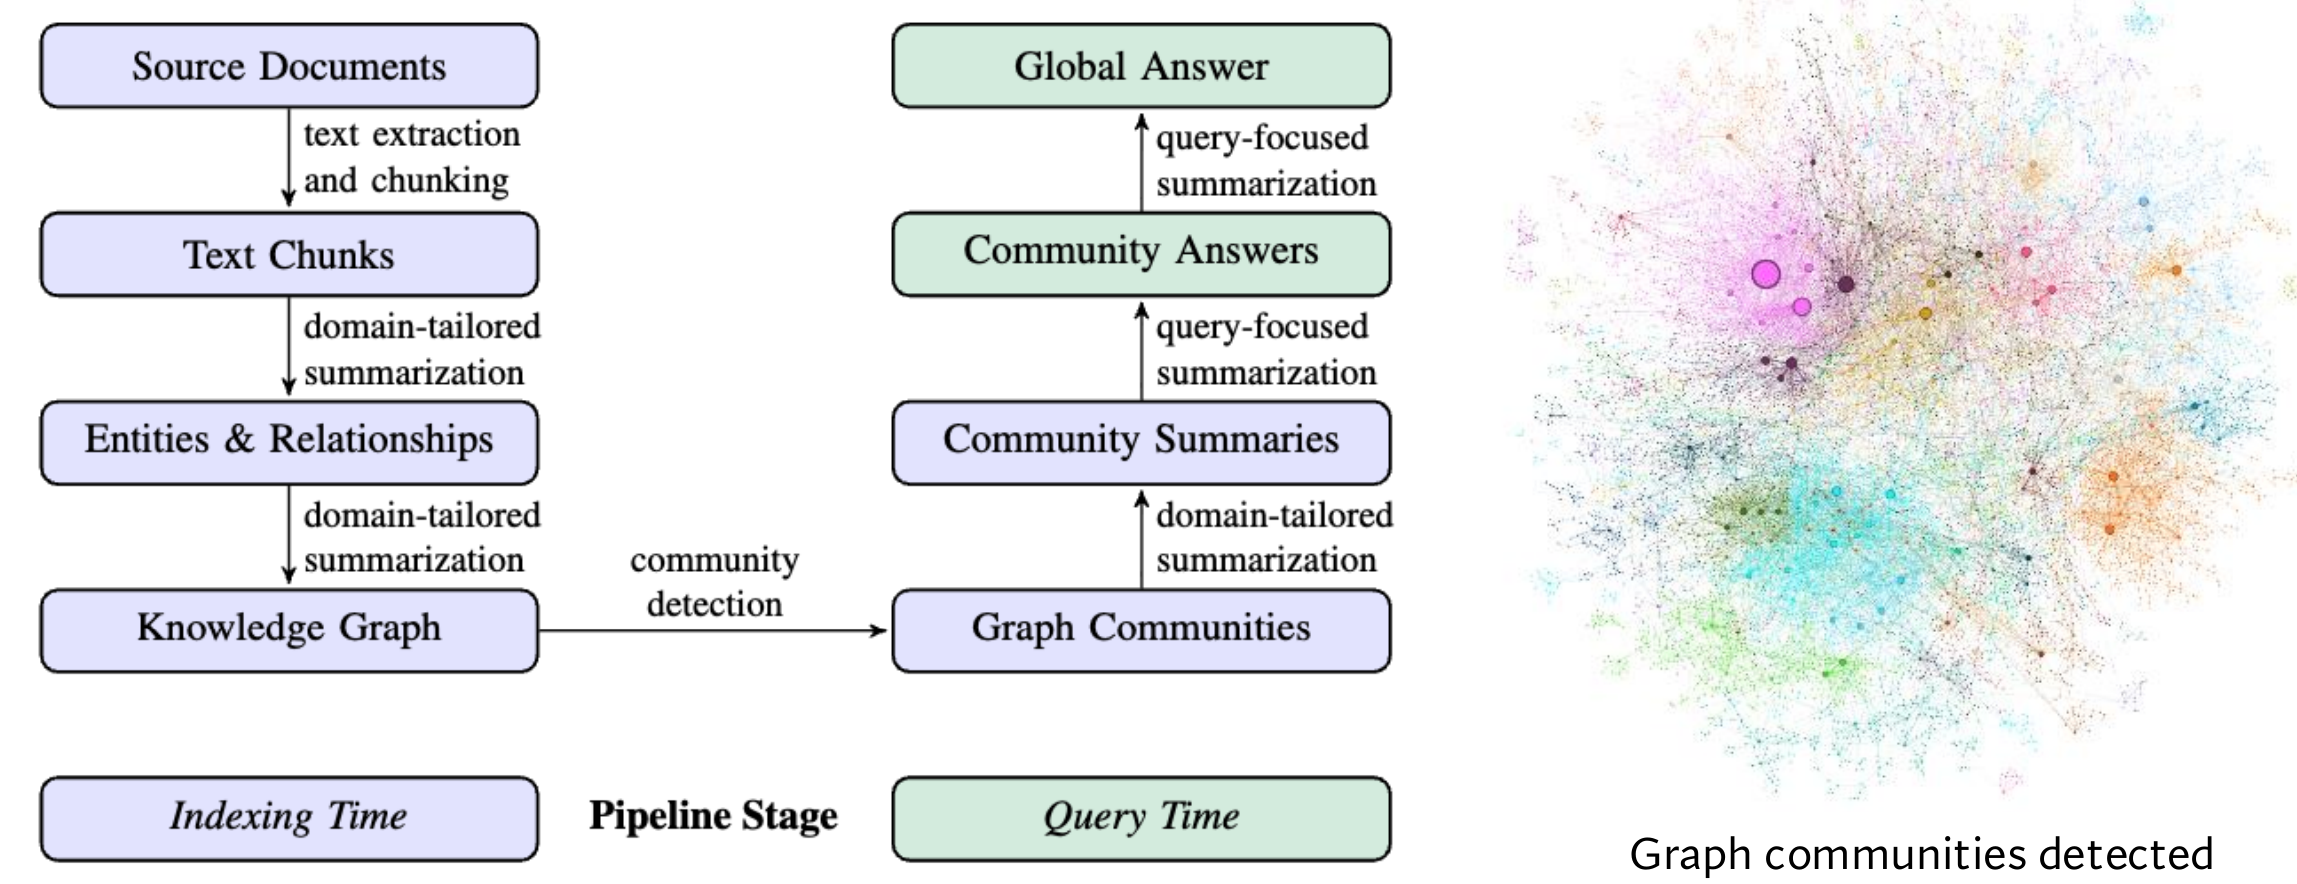
图 08 左侧从文档抽出实体与关系,右侧再把关联紧密的节点组织成社区,摘要可以用来回答跨文档的问题。 来源 [7]From Local to Global(GraphRAG)
04 向量多了,怎么查到前 k 个?
如果有 N 个文档向量、每个有 d 维,逐个跟查询比较,单次大约是 N × d 的工作量。数据量大时可以用近似最近邻(ANN),允许漏掉部分真实近邻,换更低的查询成本。
常见机制有几类。IVF 先把向量分组,查询时优先查跟自己最接近的几个组。PQ 把长向量压成更短的编码。HNSW把相近的向量连成多层图。底层点多,上层点少。搜索时从上层开始,先跳到大概相近的位置,再逐层下去细找。建图时还会保留一些跨簇的边,避免只在原来的小圈里打转[8]。
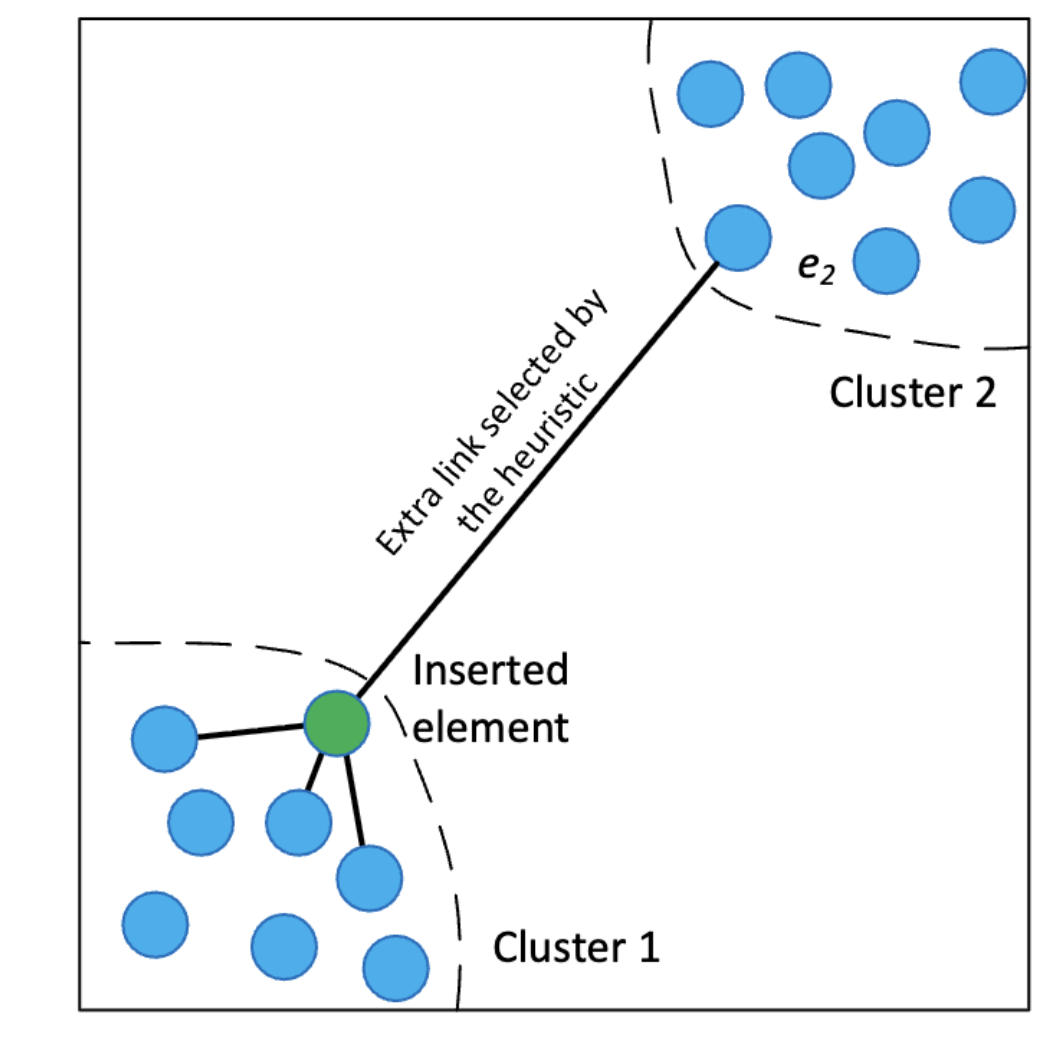
图 09 绿色点是正在插入的节点。除本簇里的邻居,图里还保留了一条连到另一簇的边,这样搜索不容易被困在某一片。 来源 [8]HNSW(分层近邻图)
05 BM25、DPR、混合检索,怎么选?
BM25主要看词能不能对上,适合产品型号、姓名、报错码这类精确字符串。它的分数可以先抓住三个因素:
- 词频。 关键词出现得多一些,相关性可能更高。重复很多遍时,加分会逐渐饱和。
- 逆文档频率(IDF)。 在全库少见的词,往往比到处都有的词更能区分文档。
- 文档长度。 一篇很长的文档本来就更有机会撞上关键词,所以要做长度归一化。
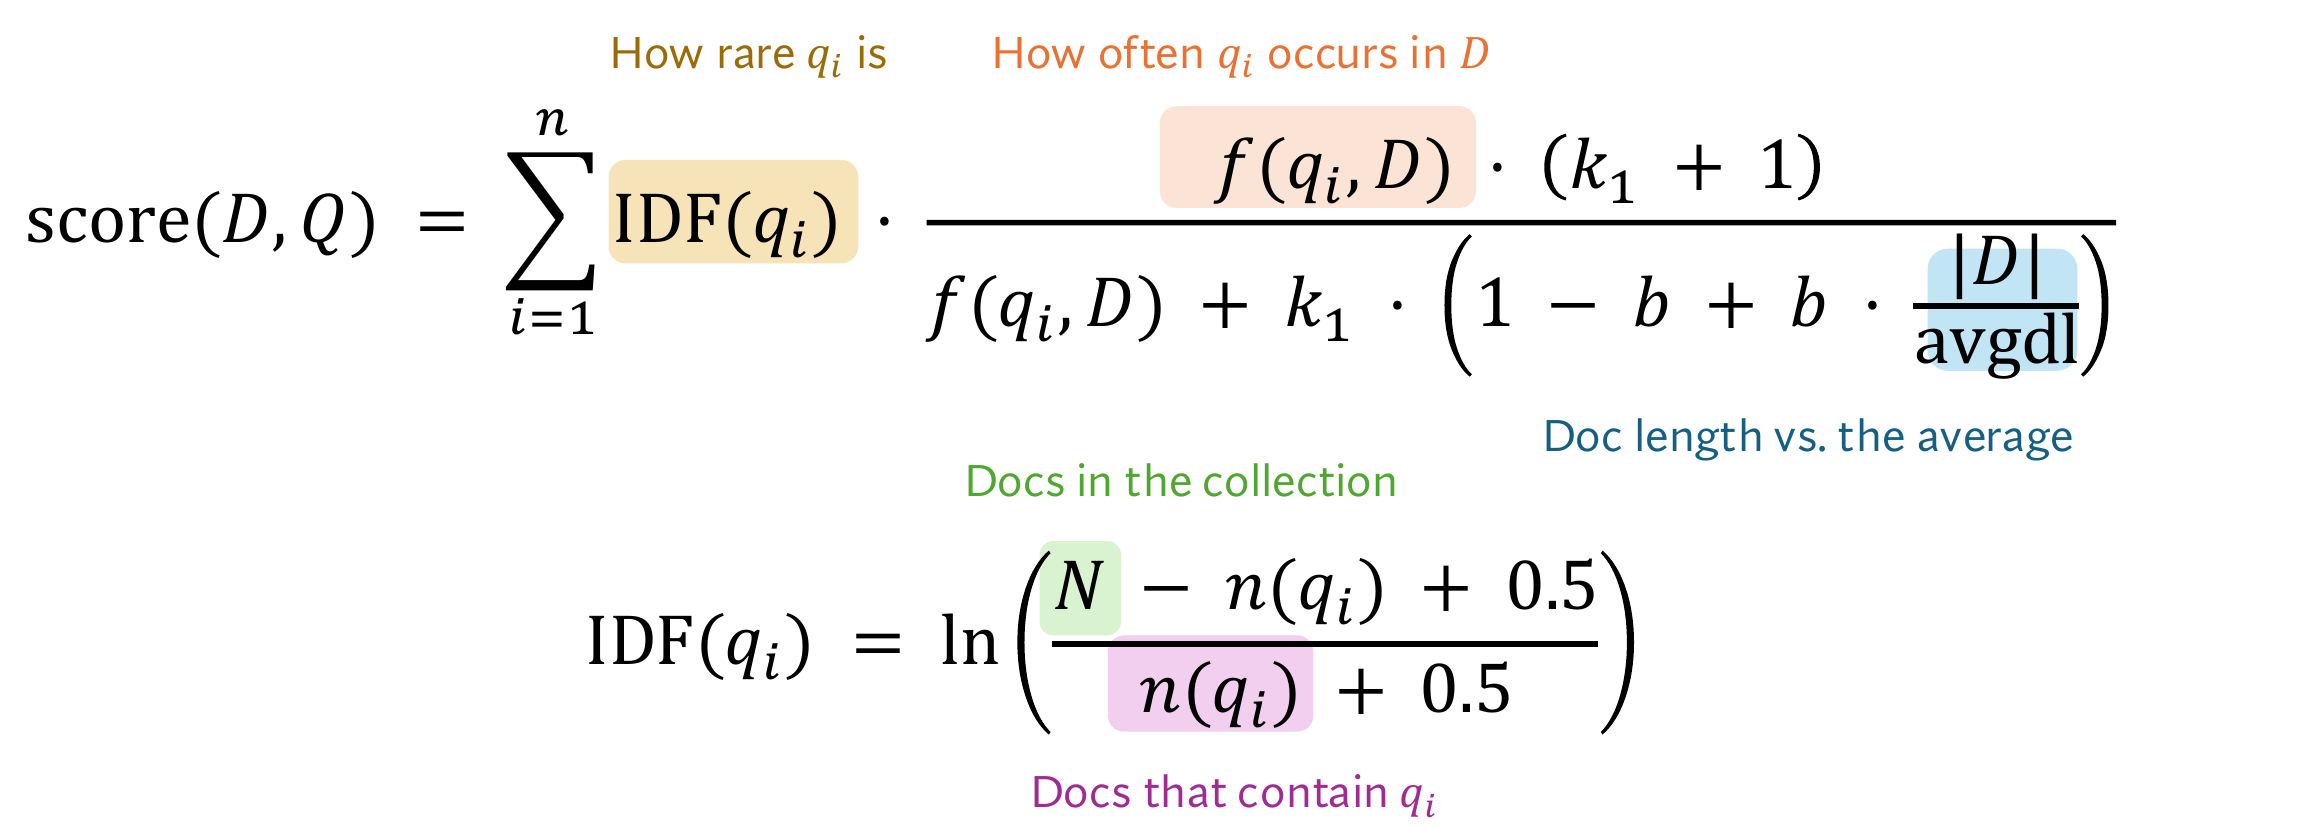
图 10 图上黄色是词在整个资料库里有多罕见,橙色是它在当前文档里出现多少次,蓝色是文档长度和平均长度的关系。
DPR(稠密段落检索)是双编码器的代表。文档和问题分别用模型编码,文档向量可以提前算好。查询时只算问题的向量,再拿它与索引里的段落向量打分。两个短句措辞不同,只要意思接近,也能被召回。训练时会让问题靠近正确段落、远离错误段落。BM25 找出来那些字面很像、内容却不对的段落,也能拿来当难负例[9]。
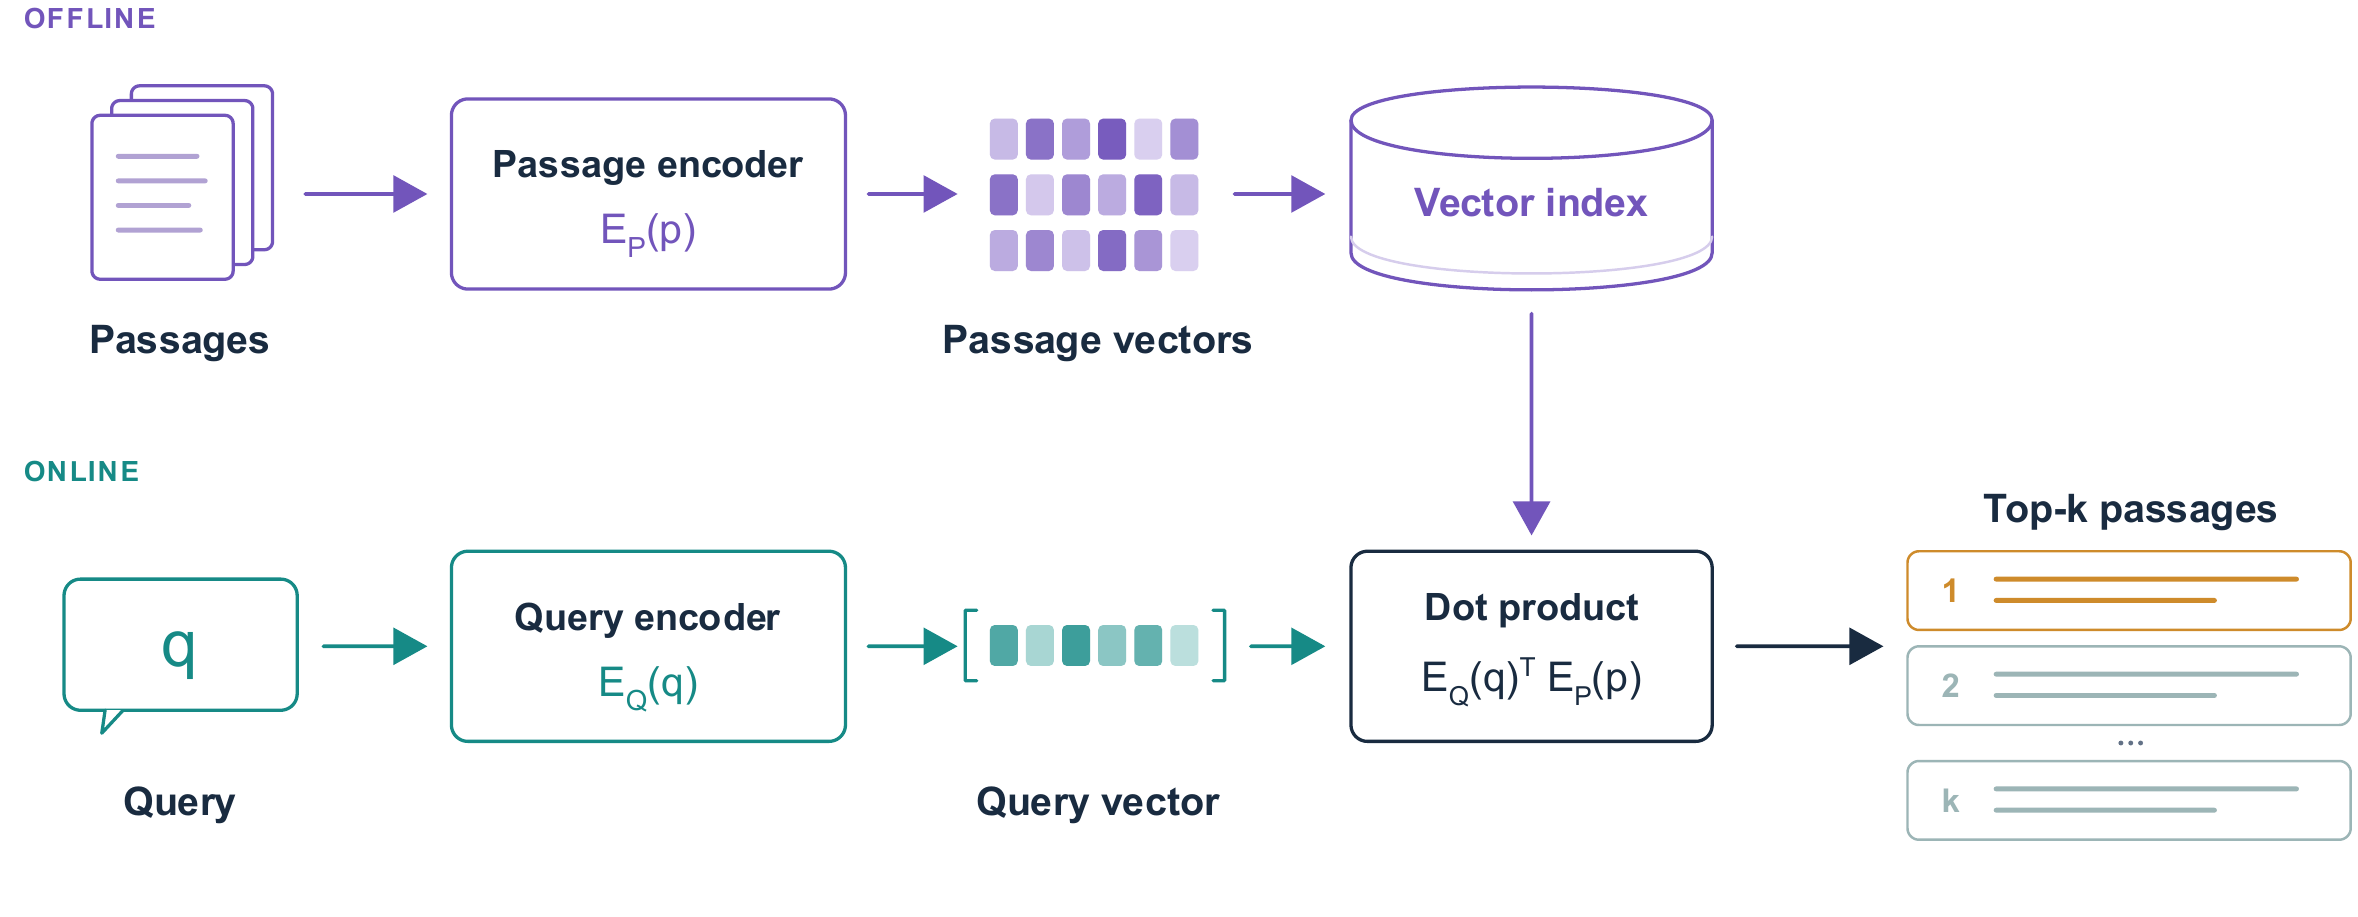
图 11 紫色的一行是提前给文档编码、建索引。绿色的一行是收到问题以后才走的路径,用查询向量给候选段落打分。 来源 [9]Dense Passage Retrieval for Open-Domain Question Answering
怎么评估召回结果?
假如每次返回前五段,Hit@5看是否至少找着一段相关资料。Recall@5关心所有相关资料里找回多少。若一共有四段证据,只找着第一段,命中已经为真了,召回率却只有四分之一。
MRR看第一段相关材料排多前面。它在第 1 名得 1,在第 2 名得 1/2。nDCG还可以给不同相关度的资料打不同分,更相关的内容排得越靠前,分越高。没找到任何相关片段的比例也可以单独统计。要是生成端的结果变差,先看证据有没有进候选、重排后有没有排到足够靠前,再回头看模型有没有正确使用它。
用混合检索把两路结果合起来
DPR 在原论文的多组开放域问答测试里表现不错,具体取决于数据集和训练样本。遇到很少见的错误码、产品 ID,它还是可能漏掉很多词法检索能抓到的资料。于是有了混合检索,两路分别召回,再合并排序。
一个常见的合并办法是倒数排名融合(RRF)。拿一篇候选文档,按它在每个结果列表里的名次给分。排得越靠前,分越高。如果两路都把它排得不错,就加两次。这样可以绕开词法分数和向量相似度的量纲差异。
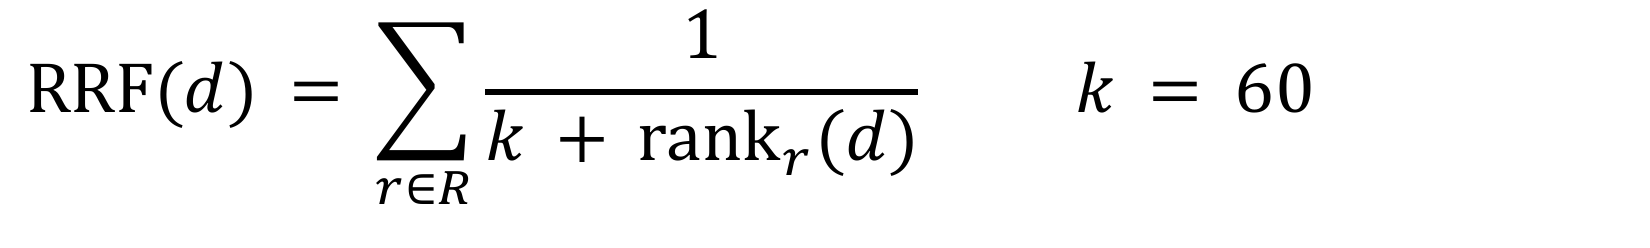
图 12 公式只用候选在各路结果里的名次。一路没召回它,那一路就不加分。图里的 k 是用来控制靠前名次影响的常数。
06 召回之后,为什么还要重排?
检索器要在很多段落里快速挑一批候选。到了少量候选,可以让模型把每个「问题、段落」一起读一遍,用交叉编码器(Cross-encoder)算更细的相关性。它可以直接比较两边的词、语义和限定条件。缺点是每对都要重新算,逐篇扫全库一般太贵。
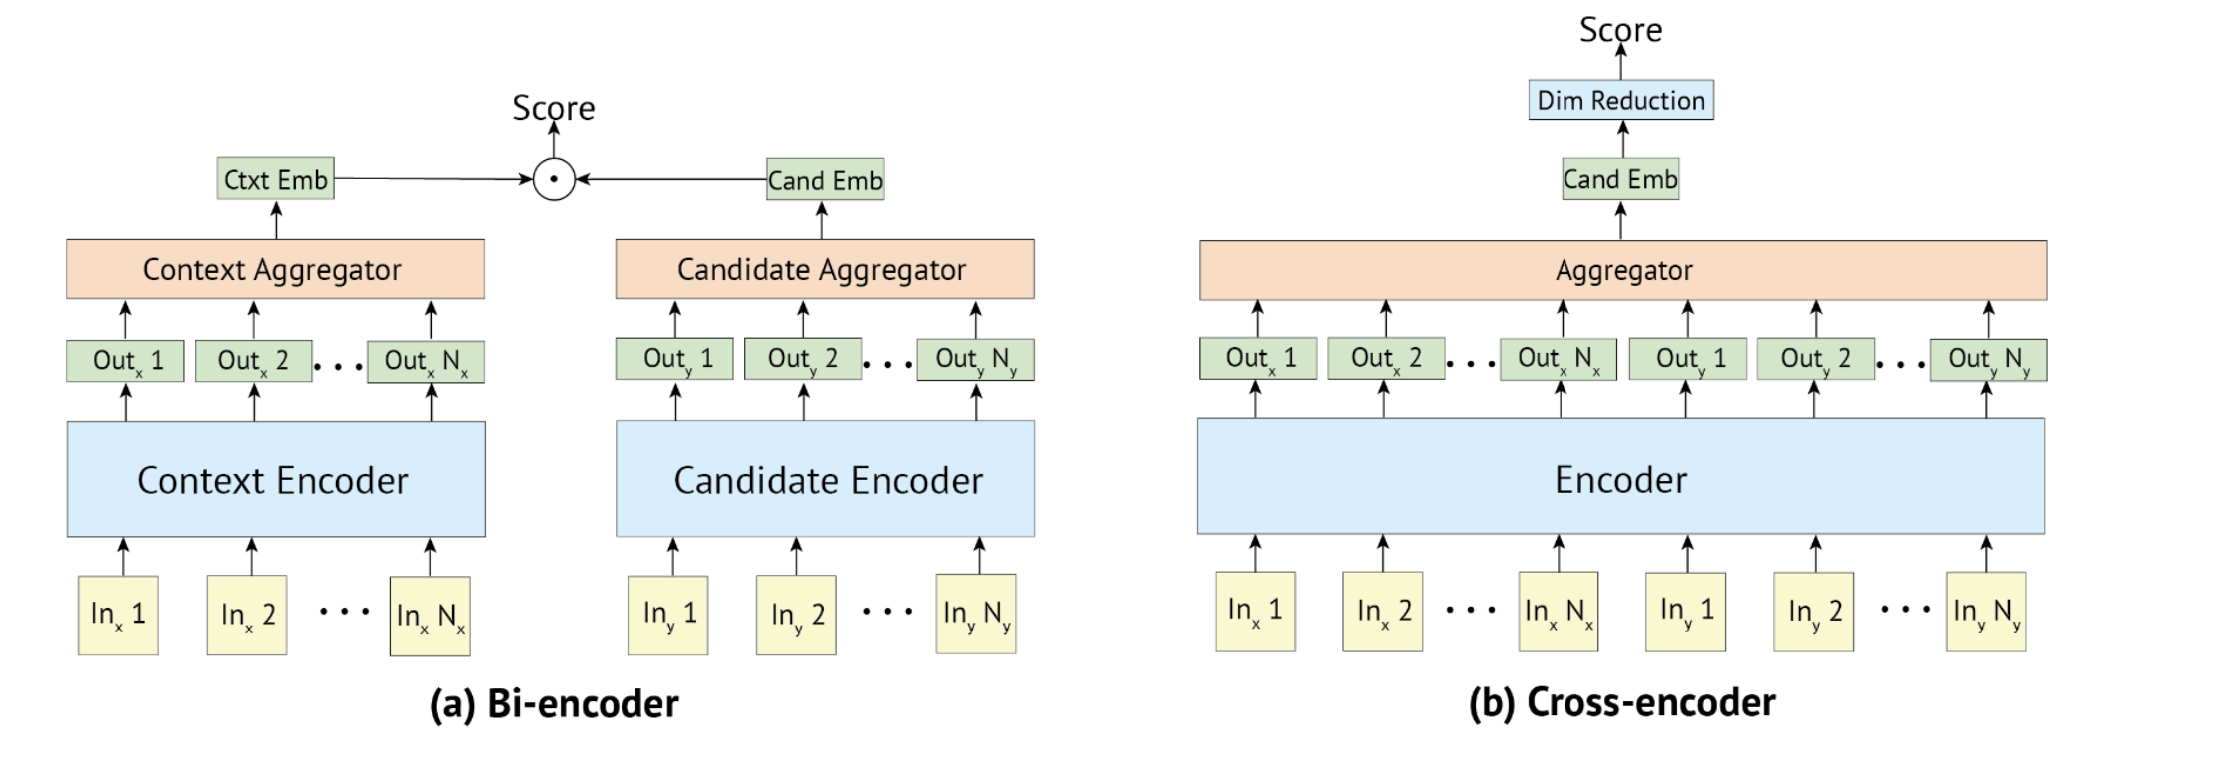
图 13 左边分开编码问题和文档,可以提前算文档的一侧。右边把两段文字一起送进模型,多花一些计算换更细的相关性判断。
ColBERT走的是中间路线。问题和段落分别编码,段落侧还能离线建索引。不同之处是它给每个 token 留一个向量。打分时,对每个查询 token 找到文档里最像的那个 token,然后把这些最大相似度加起来。这叫 MaxSim,能保留词级证据,索引也会比「一段一个向量」更大[10]。
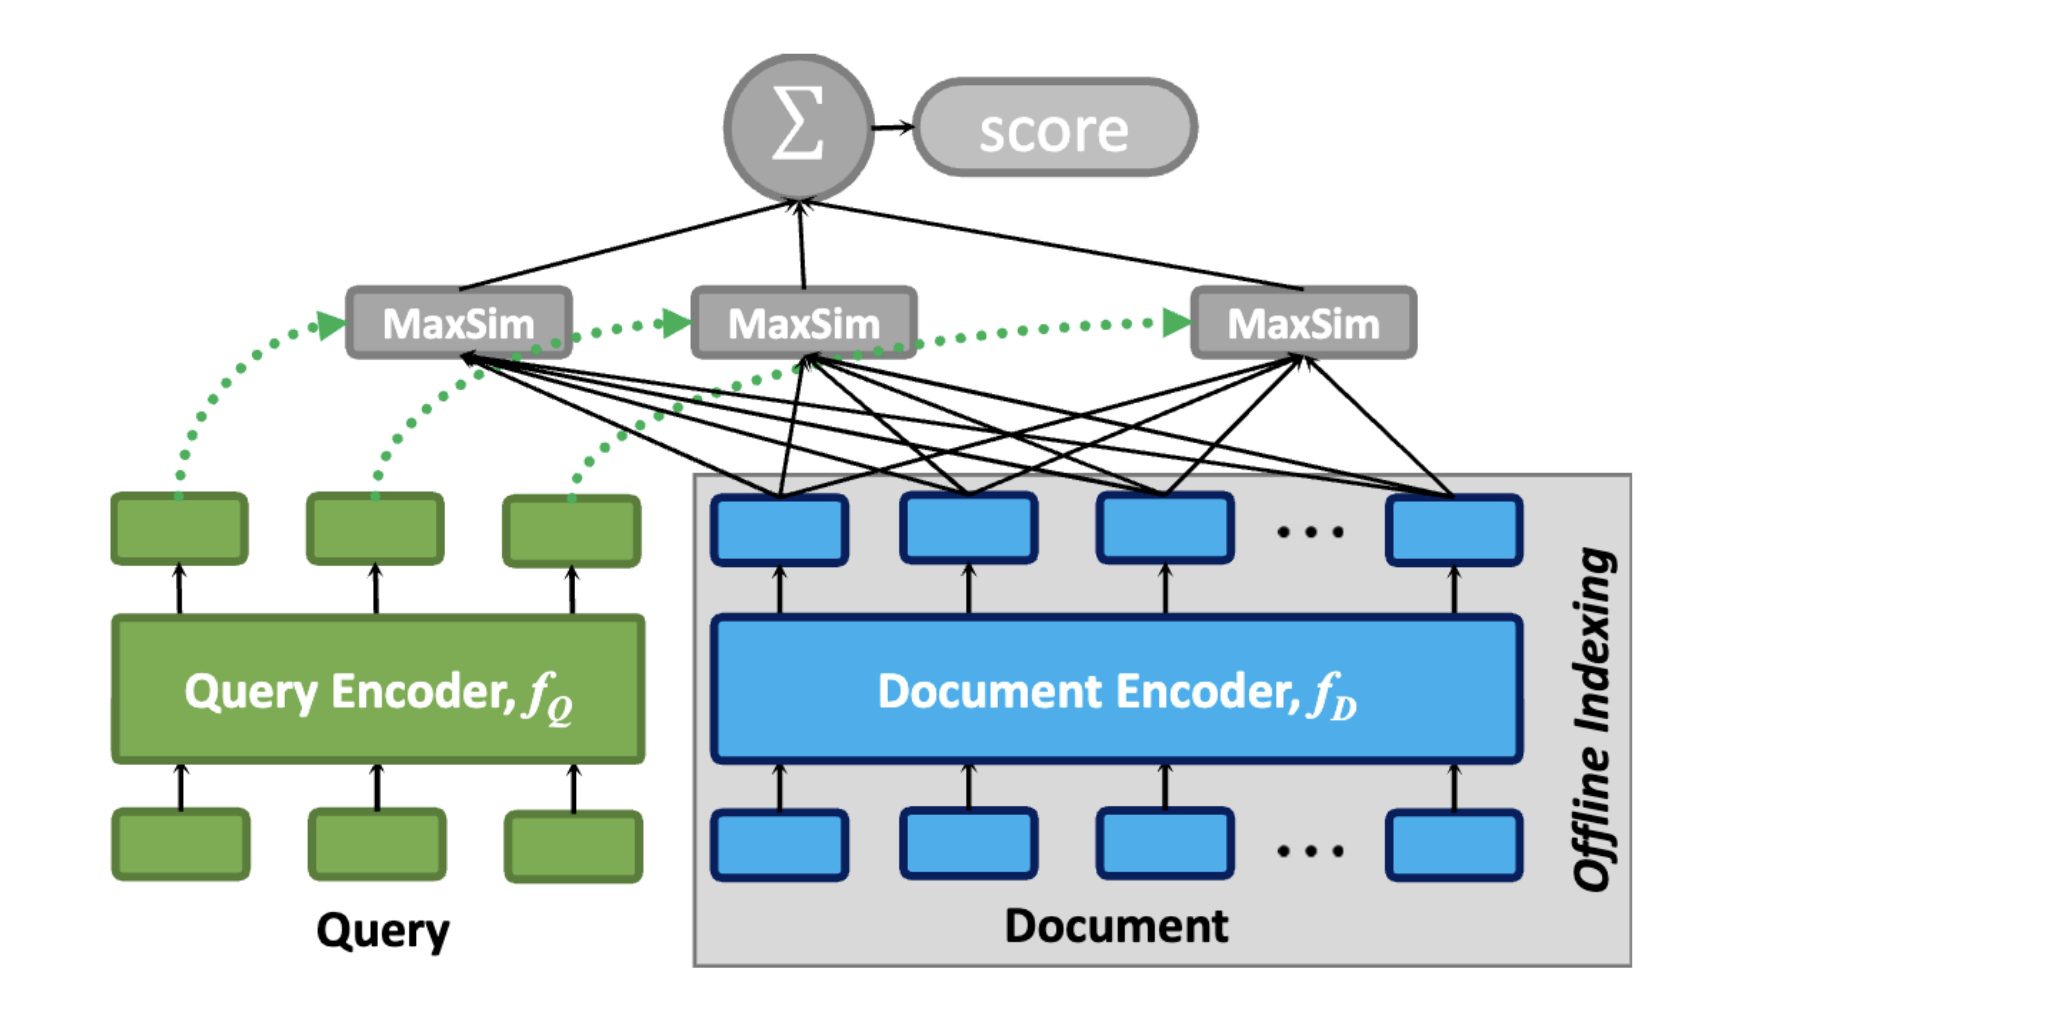
图 14 绿色是问题的 token,蓝色是文档的 token。每组 MaxSim 为一个查询 token 找最佳匹配,最上面的求和得到总分。 来源 [10]ColBERT(后交互与 MaxSim)
07 把检索放进 Agent 的循环
普通的固定链路经常是有问题就查一次,然后生成。到了 Agentic RAG,检索变成 Agent 可以选择的一个动作。它要判断这一步查不查、用什么词查、这些证据是否已经够了。如果一次搜索只解决了前半个问题,可以根据新结果再查下一步。
Self-RAG在训练中加入特殊的反思标记,让模型学会何时检索、判断材料是否相关,以及生成的内容有没有得到资料支持。模型能在生成的不同阶段反复做这些判断[11]。
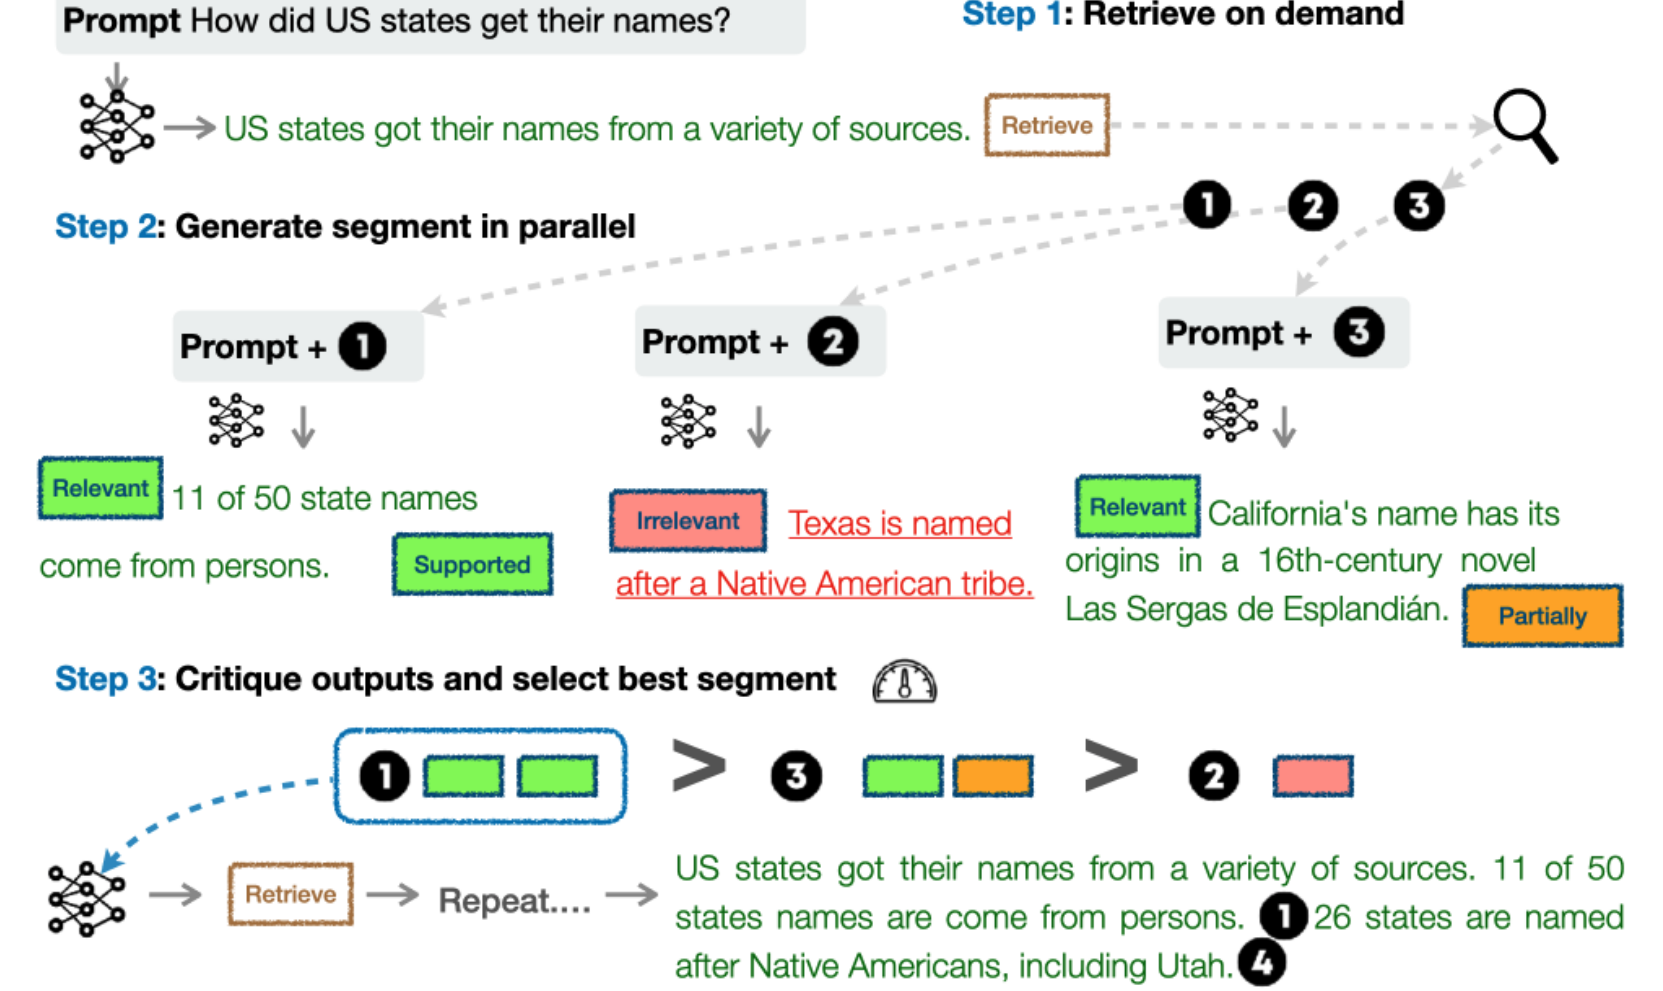
图 15 先按需检索,基于候选资料生成几条结果,再判断资料是否相关、结论是否得到支撑,留下更合适的一条。 来源 [11]Self-RAG 原论文
CRAG(纠正型检索增强生成)在检索和生成之间放了一个评估器,对取回的资料判定置信度。资料靠谱时保留并提炼,资料不相关时考虑补查外部来源,拿不准时可以组合处理。它专门面对「检索已经跑完,结果却很差」这一类问题[12]。
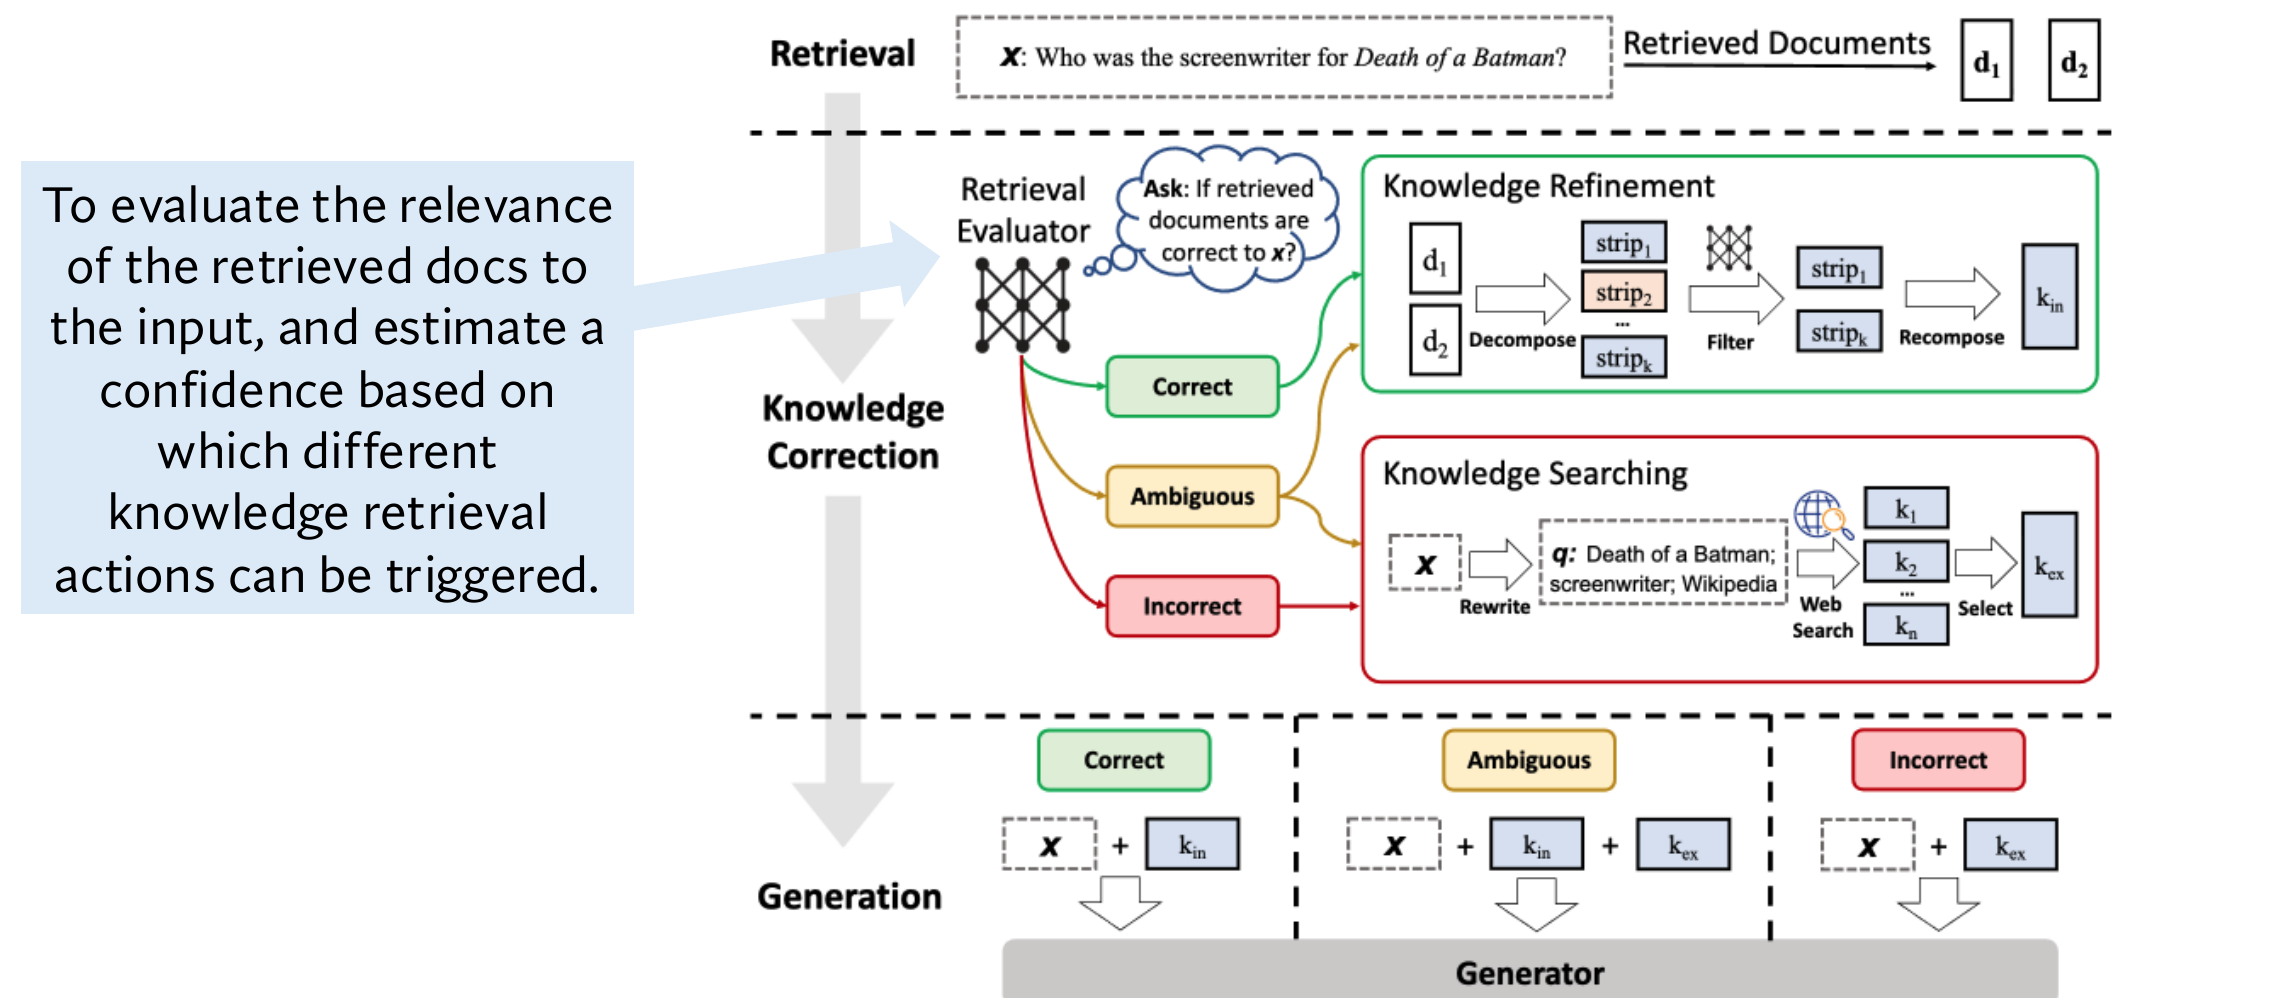
图 16 中间的评估器按相关性给检索结果分流,后面再做知识提炼、补查或组合。生成器吃到的是处理后的材料。 来源 [12]Corrective Retrieval Augmented Generation(CRAG)
Search-R1用带搜索反馈的强化学习训练模型。模型在解题过程中可以多次发起查询,把返回内容作为新的观察,再决定搜索还是回答。训练用任务奖励让模型学到什么时候值得查、查什么更管用。它给出的思路是,搜索策略也可以从完整的解题轨迹里学出来。原论文的训练示例用最终答案是否正确提供奖励,并把外部搜索返回的内容当成观察输入[13]。
08 RAG 答错了,我会从哪三处查?
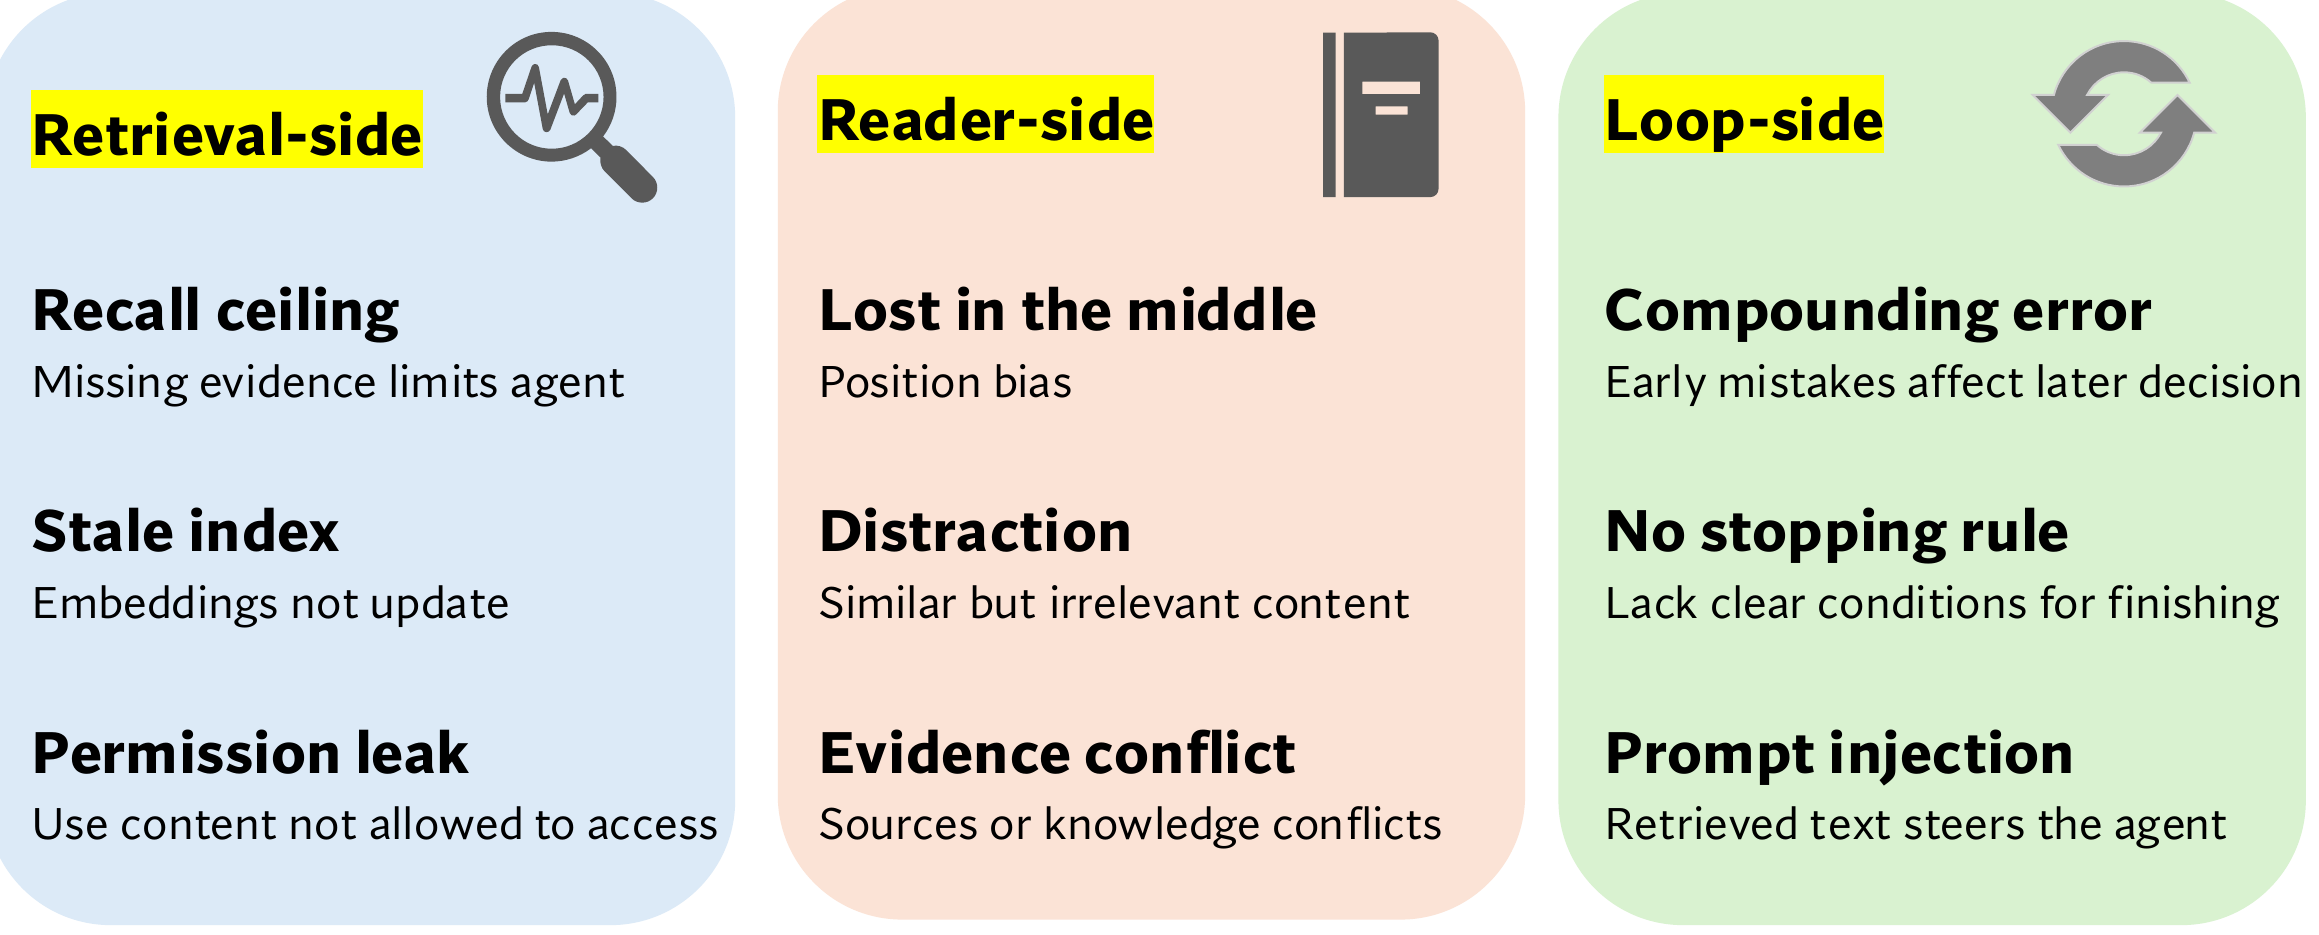
图 17 左列是检索侧的问题,中间是阅读和生成侧的问题,右列是 Agent 多轮检索循环里的问题。先确定错误出现在哪一段,再改对应组件。
先查检索侧。 正确资料是否已经入库?切块有没有把条件切断?索引是旧的吗?当前用户是否有权限读这一条?如果正确证据根本没被找回来,后面的生成器能用的信息就少了一块。
再查阅读和生成侧。 资料明明在上下文里,模型也可能漏看夹在中间的重点,被相似但无关的段落干扰,或者在两个矛盾来源中选错了。检查看到的证据、排序、出处和更新时间,可以帮助定位问题。
最后查循环侧。 第一次搜错,后面可能沿着错的线索越走越远。没有停止条件也容易反复查同一个问题。外部网页和文档还可能混入看似给 Agent 的指令,这就是提示注入的一类风险。系统应当把这些文字当成待核验的资料,并保留原有的权限和操作边界。
总结
面试里问「你们 RAG 准确率不高,怎么改」,我会先选几道有确定证据的问题。看原始文档、切块、候选、重排和最终回答,一路追到证据丢掉或者被读错的位置。检索漏了就修索引或召回,候选顺序有问题就测重排,多轮搜索反复跑偏就回头看查询策略和停止条件。分清这些环节,才知道换模型、换 Embedding,还是改流程更有效。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]Reading Wikipedia to Answer Open-domain Questions(DrQA)
https://aclanthology.org/P17-1171/
[3]Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
https://arxiv.org/abs/2005.11401
[4]Anthropic 的 Contextual Retrieval 实验
https://www.anthropic.com/research/contextual-retrieval
[5]Late Chunking(长上下文分块向量)
https://arxiv.org/abs/2409.04701
[6]RAPTOR(树状索引)
https://arxiv.org/abs/2401.18059
[7]From Local to Global(GraphRAG)
https://arxiv.org/abs/2404.16130
[8]HNSW(分层近邻图)
https://arxiv.org/abs/1603.09320
[9]Dense Passage Retrieval for Open-Domain Question Answering
https://arxiv.org/abs/2004.04906
[10]ColBERT(后交互与 MaxSim)
https://arxiv.org/abs/2004.12832
[11]Self-RAG 原论文
https://arxiv.org/abs/2310.11511
[12]Corrective Retrieval Augmented Generation(CRAG)
https://arxiv.org/abs/2401.15884
[13]Search-R1 原论文
https://arxiv.org/abs/2503.09516