TechGuide「AI Agent 面试专题」第 6 篇 · Agent 设计模式
正文约 5200 字 · 预计阅读 11 分钟
大家好,我是声哥。
上一篇用录日历讲了框架。同样是管日程,收到一封时间明确的邮件,和收到一句「帮我和同事约半小时」,做法就不一样。这篇聊聊什么时候把步骤提前写好,什么时候让模型看结果再决定下一步。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
01 工作流和 Agent,区别在谁决定下一步
还是拿日历举例。「把这封邮件里的会议加进日历」,步骤通常预先就知道。先提取字段,再检查日期和时间,最后决定是否写入。模型负责把自然语言读成字段,程序决定哪些节点会跑。这是典型的工作流(Workflow)。
把要求换成「看看我下周怎么挤出半小时,帮我和同事对个时间,原来的会能挪就挪」。得查到日历才知道冲不冲突,发现时间不够还要问用户能不能移动别的会。如果下一步经常由当前情况决定,可以把工具交给模型,让它读着结果往下走。这是典型的 Agent 控制流。外层程序仍然可以约束能用的工具、让用户批准写入、设置预算和终止条件。
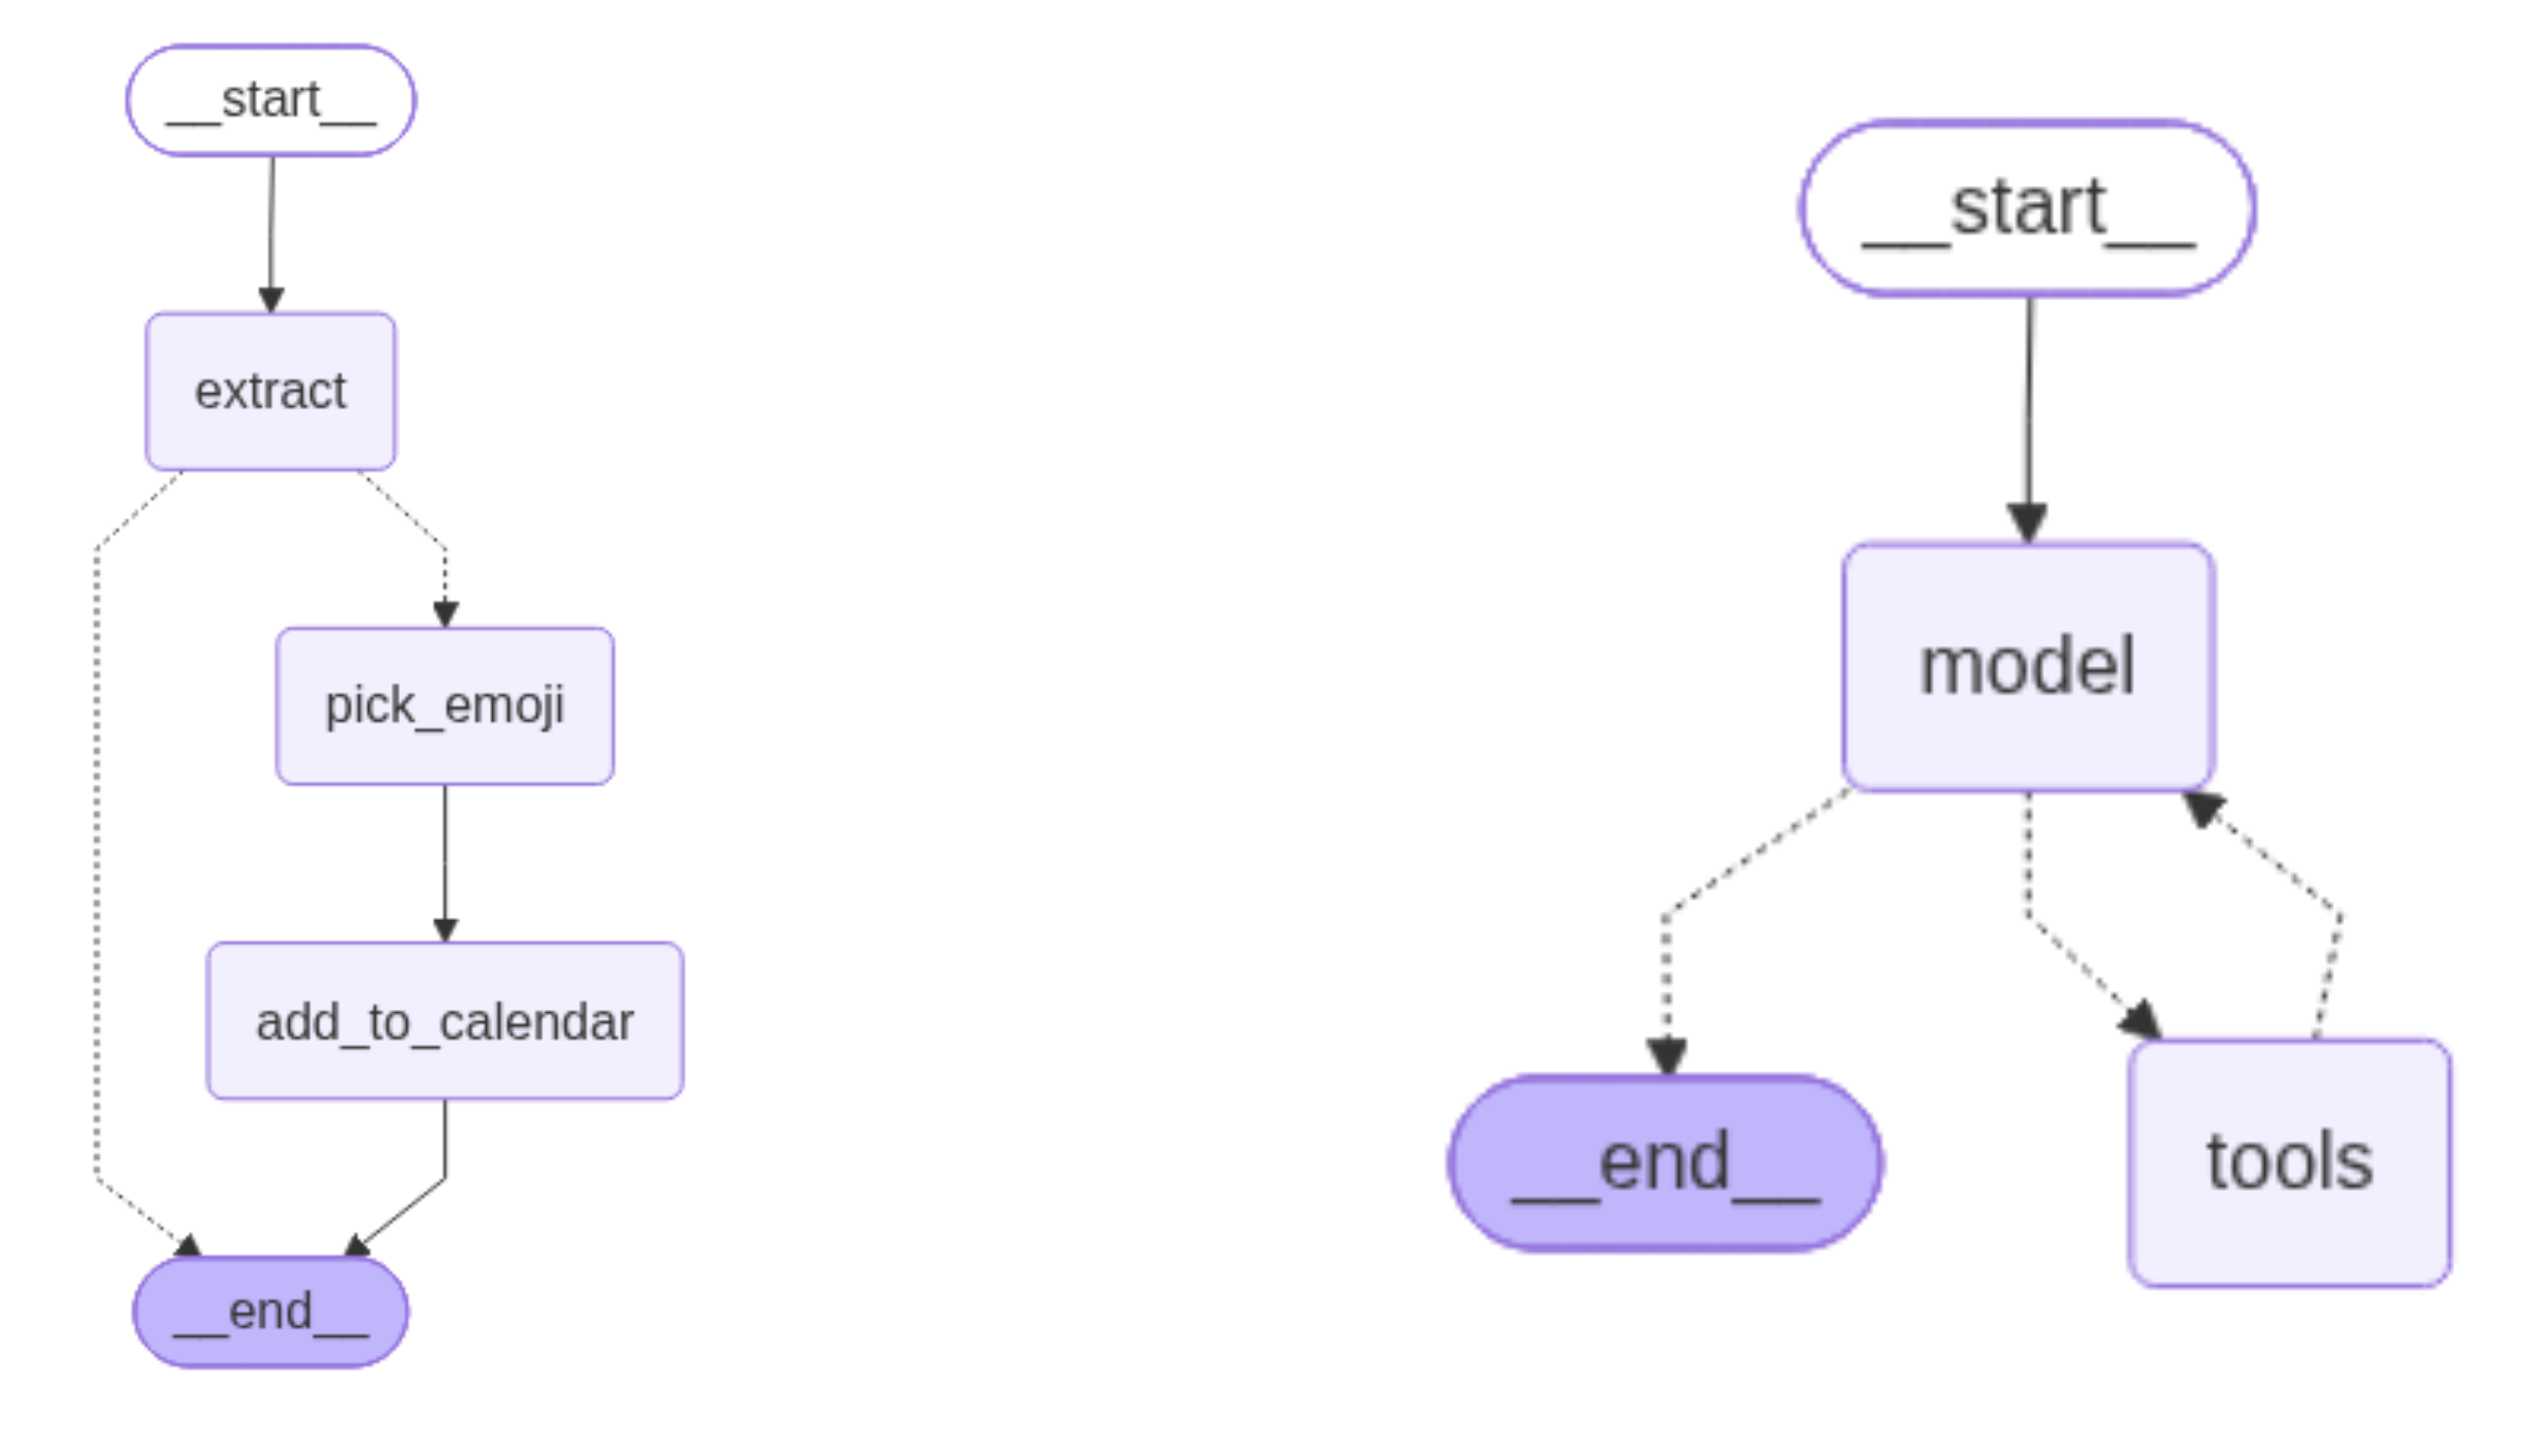
图 01 左边先提取再走预定分支,字段完整才写日历。右边从模型节点出发,根据本轮结果决定调工具继续,还是结束。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
我会先看流程里最难预测的是哪一段。邮件分类能列出常见类别,分支很好写。要是用户的目标、环境状态、遇到的异常每次都变,强行把每种路径提前写好会很费劲。工程里完全可以让一部分固定下来,只有需要适应变化的那一段交给 Agent。
02 五种工作流,先按任务长什么样来选
下面五种模式可以在 Anthropic 的《Building Effective Agents》里找到。把几个图挨着看,差别主要是步骤之间有没有依赖、分支由谁来选,以及需要哪些反馈[2]。
1. 提示词链(Prompt Chaining)
一步要用到上一步的结果,就按顺序接。比如先把长稿拆成要点,程序检查有没有漏掉必填项,再用下一次调用写成成稿。中间可以插一个校验门,失败就结束或进入修复分支。每次调用的问题更小,也更容易定位质量掉在哪一段,代价是串行步骤增加了等待时间。
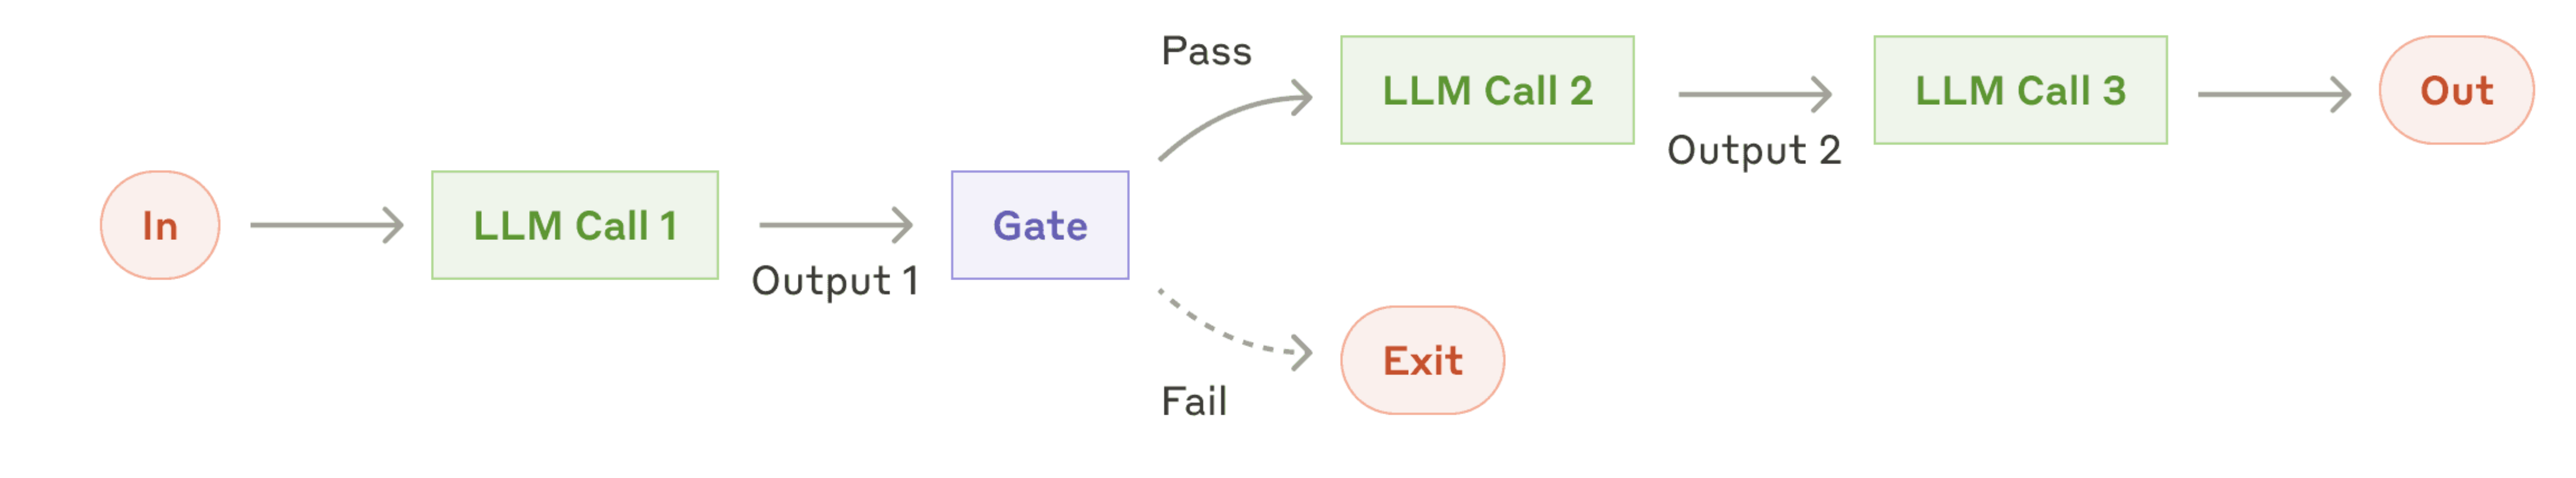
图 02 第一个模型的输出先过检查门 Gate。通过才依次执行后面的调用,没过就退出。 来源 [2]Anthropic · Building Effective Agents
2. 路由(Routing)
输入能分成比较稳定的几类,就先分流。比如售后问答先判断是物流、售后政策还是账户问题,再找对应的流程、模型或提示词。简单请求可以走便宜的模型,复杂的单独处理。前面这个分类一旦走错,后面写得再漂亮也可能答了另一件事,评测要把路由单独拎出来。
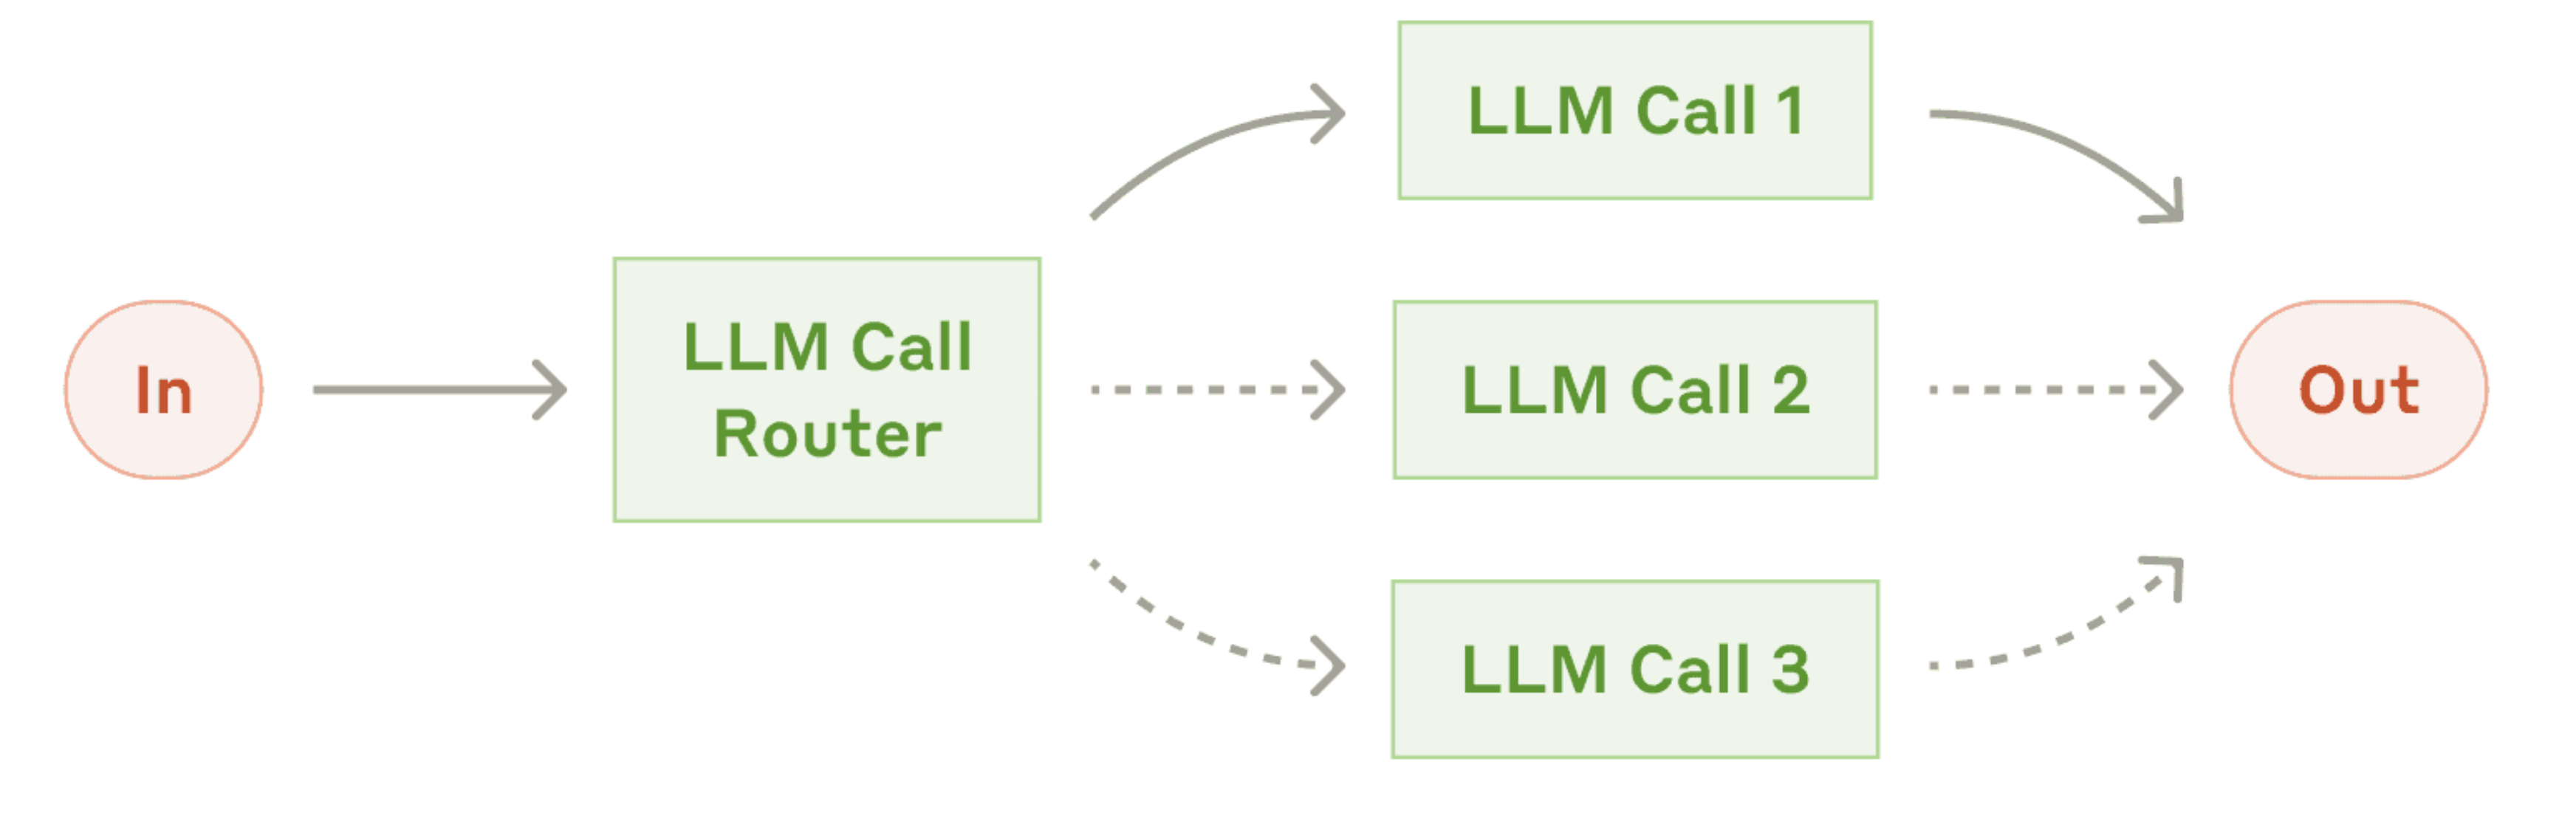
图 03 先过 Router,再从三条路径里选择适合当前请求的那一条。实线展示图中选中的路径,其余分支用虚线画出来。 来源 [2]Anthropic · Building Effective Agents
3. 并行化(Parallelization)
并行有两种常见用法。任务分片(Sectioning)把可以独立做的活同时做,比如同一段材料分别检查事实和格式,也可以把十条记录分开处理。投票(Voting)是让几次调用都处理同一个问题,然后按投票或别的合并规则选答案。前一种让各分支把注意力放在自己的任务上,后一种增加了尝试次数。几路都会犯同一种错误时,多数票一样会错。
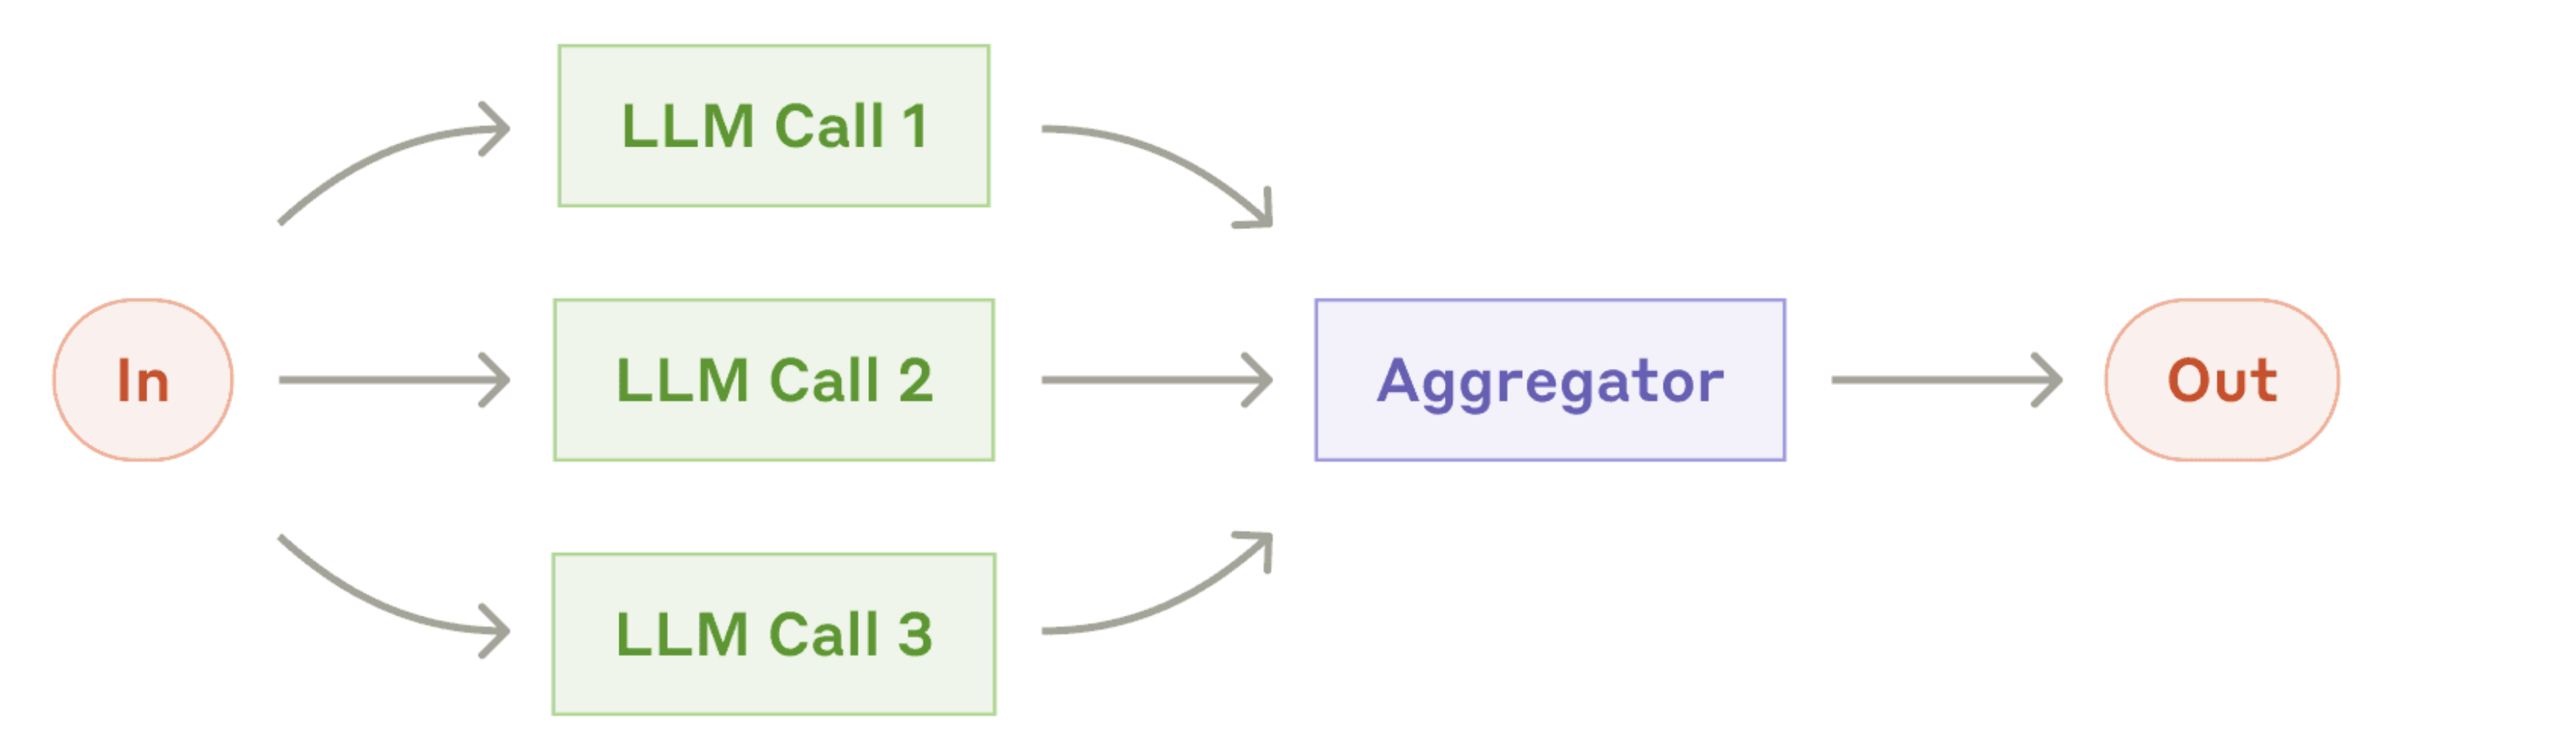
图 04 从同一个输入扇出多次调用,再由 Aggregator 汇总。每个分支可以负责一件独立的事,也可以拿到同一个问题各答一遍。 来源 [2]Anthropic · Building Effective Agents
4. 编排者与执行者(Orchestrator–Workers)
有些任务能预先写清「要拆」,但要看完输入才知道拆几件事。比如用户要对一个新项目做调研,编排者读完需求才知道该查公开资料、核对历史版本,还是需要把不同提供方的说明交叉比对。它先生成子任务,再把工作交给各个 Worker,最后汇总。和固定分片相比,这里多了一个决定做哪些子任务的模型调用,可能漏拆,也可能拆得太碎。
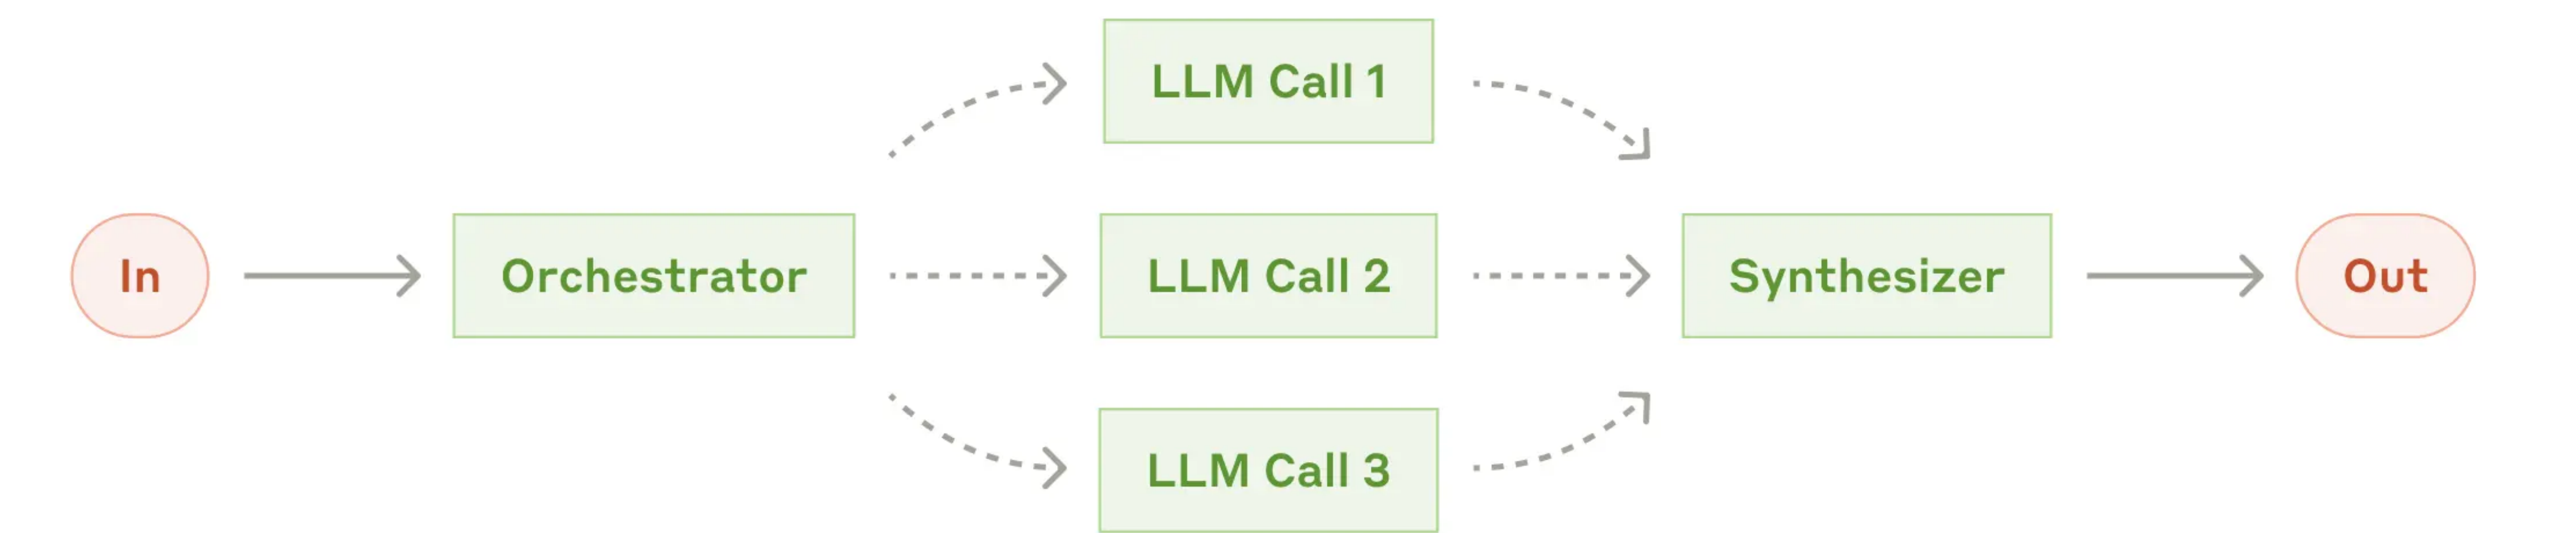
图 05 Orchestrator 根据本轮输入创建子任务,派给中间的 Worker,右边的 Synthesizer 汇总结果。子任务的数量和内容可以随需求变。 来源 [2]Anthropic · Building Effective Agents
5. 评估者与优化者(Evaluator–Optimizer)
先出一版,再按规则检查。通过就交付,没通过就带着具体意见再改一轮。比如检查摘要里每个结论有没有对应依据,评估者可以指出「第三条的数字在原文里没有」。生成者才知道怎么改。要跑得起来,首先得说得清楚什么是好答案,其次评估者要有能力给出有用反馈,最后修订者还得能根据反馈变好。评估标准如果只是「更专业一些」,多迭代几轮未必有帮助。
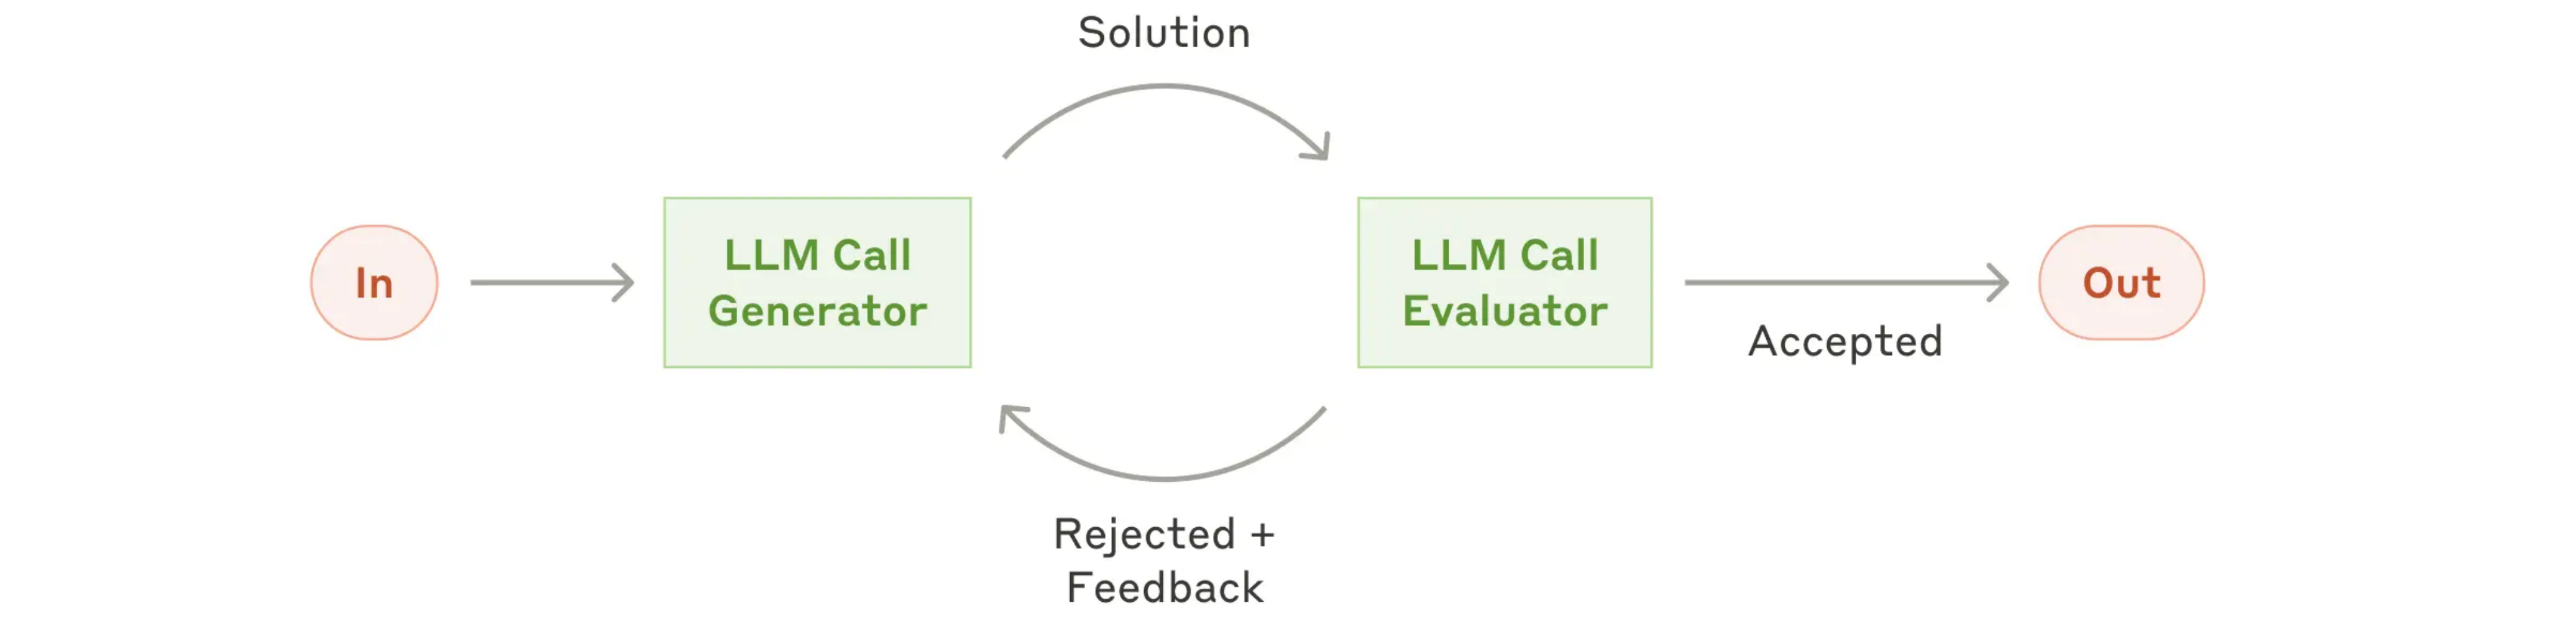
图 06 生成的结果先交给 Evaluator。它接受就输出,拒绝就把反馈送回 Generator 再改。实际应用可以加上最大轮数和停止条件。 来源 [2]Anthropic · Building Effective Agents
03 两个例子,看看模式组合起来是什么样
STORM要把一个主题写成带引用的百科式长文。比如输入「2024 年花莲地震」。直接让模型写,很容易沿着它最熟悉的几个点展开,读到第三段才发现重要的问题没查。STORM 把大纲单独做。它会找相近主题,推测读者和写作者可能关心的不同角度,再从不同角度发问、检索、补问题。比如关心地震成因的人和关心交通、救援的人,问的问题就不一样。多轮问答收集到的资料和直接生成的初始大纲,再合在一起修订;之后按章节找证据、写正文[3]。
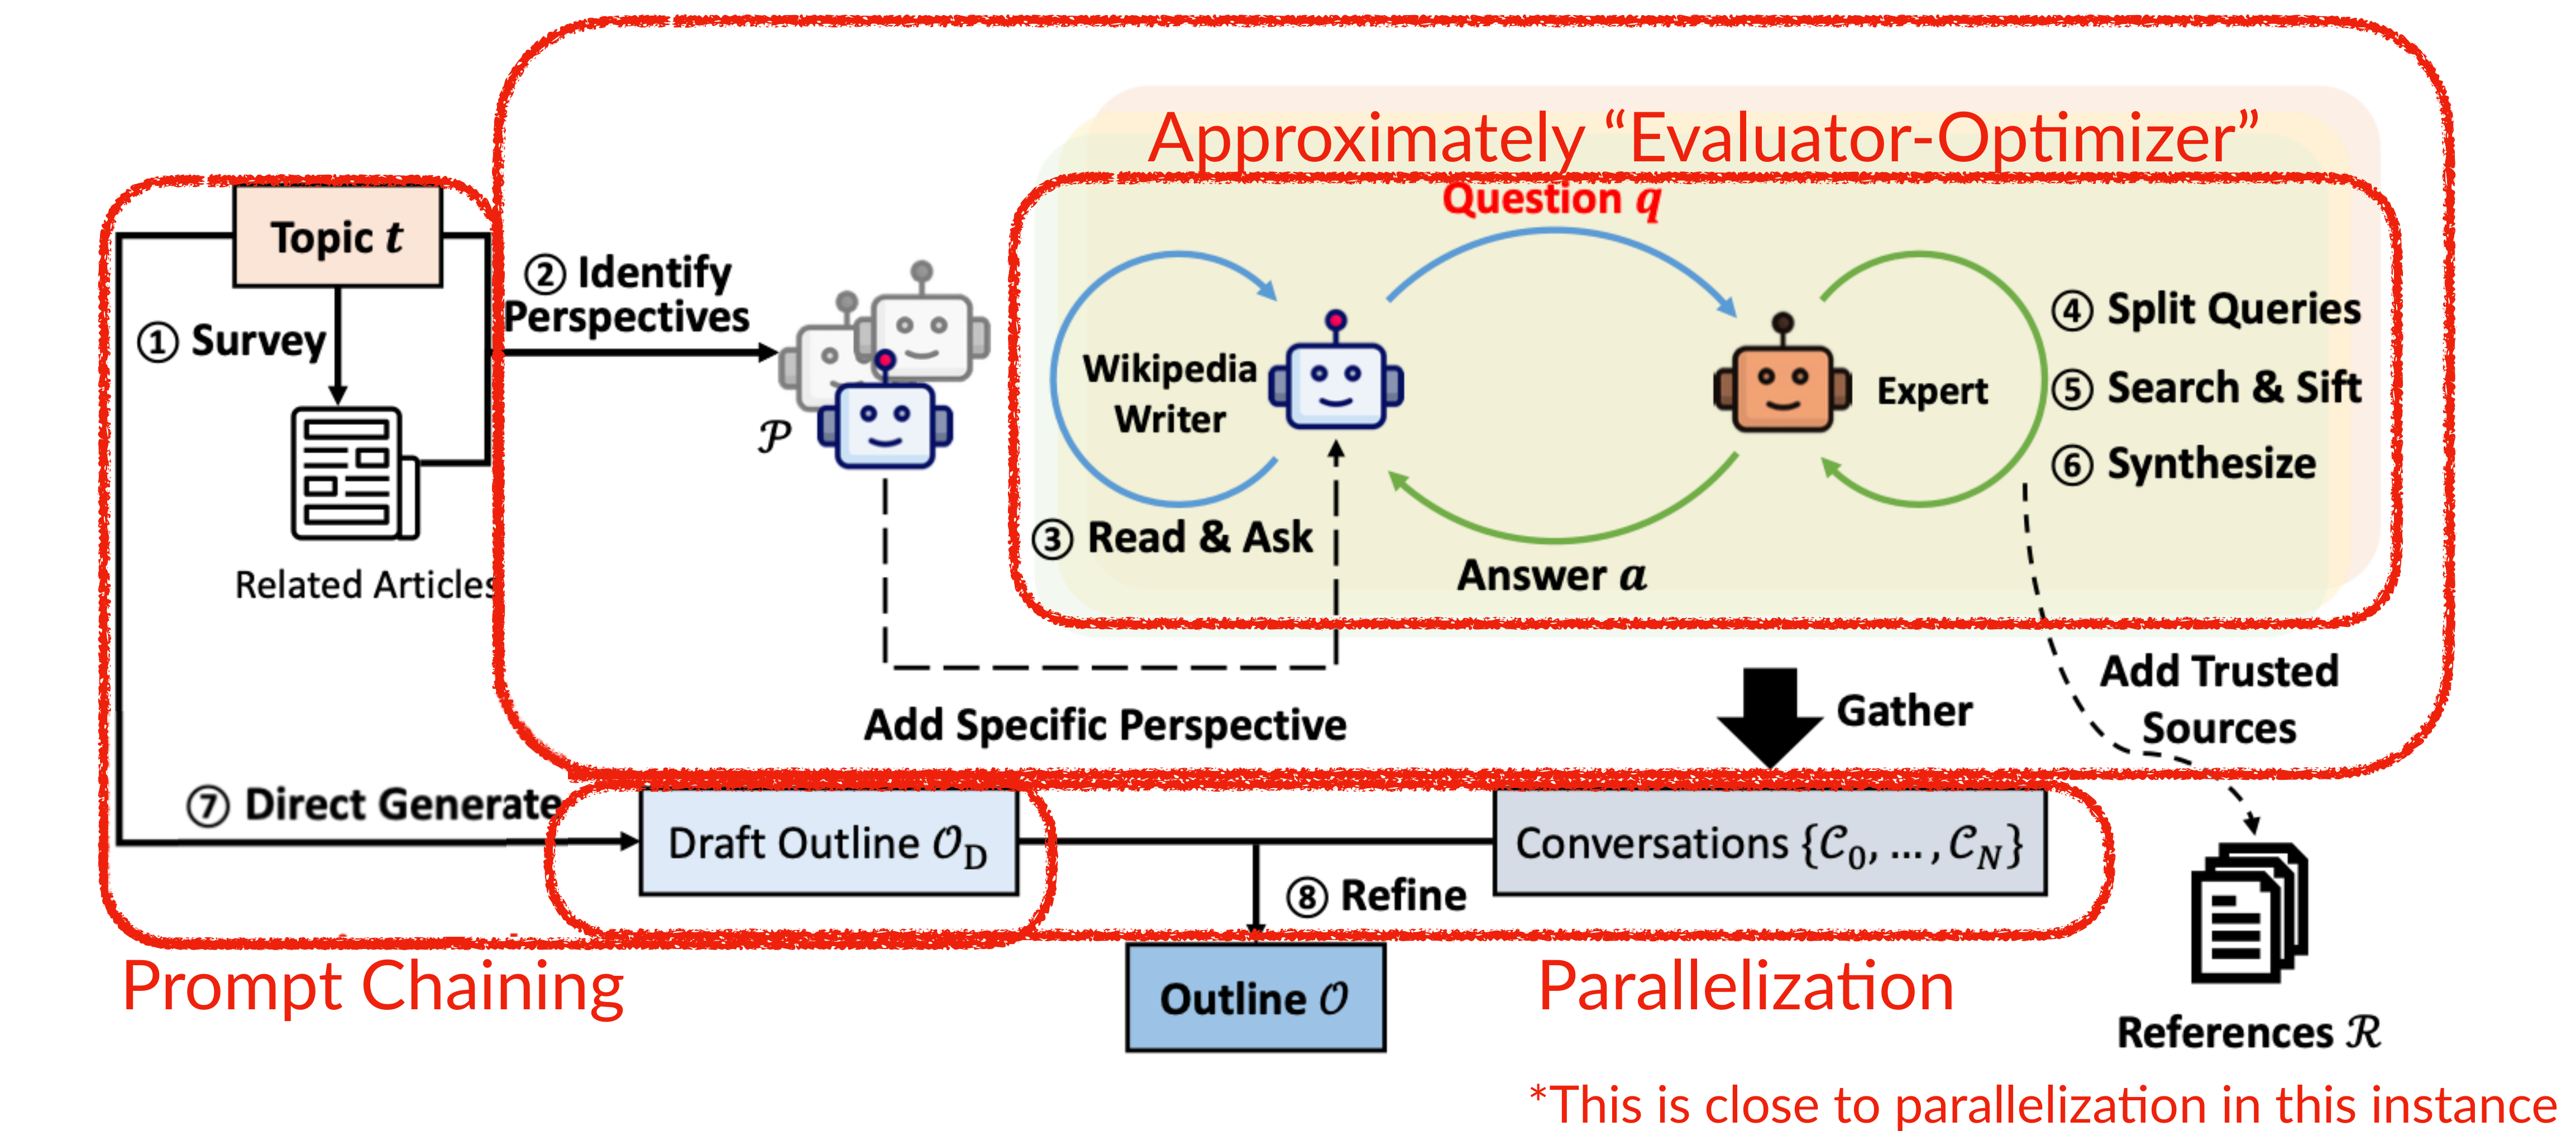
图 07 先找两条支线。直出大纲和多角度查资料可以并行。查资料那边按主题分派不同角度,多轮问答后再汇入大纲修订,类似把并行、编排和反馈装在一起。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[3]STORM 原论文(2024)
论文拿生成稿和人工撰写的文章比对,检查词语重合度、实体召回率等,也用评分模型按一套有百科编辑参与制定的标准打分。对比过直接写、带检索生成、去掉单独大纲阶段等做法之后,带大纲的 STORM 在覆盖度等指标上得分更高。这里的启发很具体,先把「该查哪些问题」拆成一个可以检查的中间结果,后面的写作才有机会把漏掉的角度补上。
Archon关心的则是怎么找出工作流的组合。给它目标基准、可用模型和推理预算,再让搜索算法试不同的候选结构。结构可以包含并行生成、给候选排序、结合多个候选、让批评者给反馈等。每个组合在样本上跑一轮,分数反馈给搜索过程。论文给出的曲线是在指定任务和预算下比较这些设计,想把方法搬到自己的业务里,仍然要先准备好能代表业务的评测[4]。
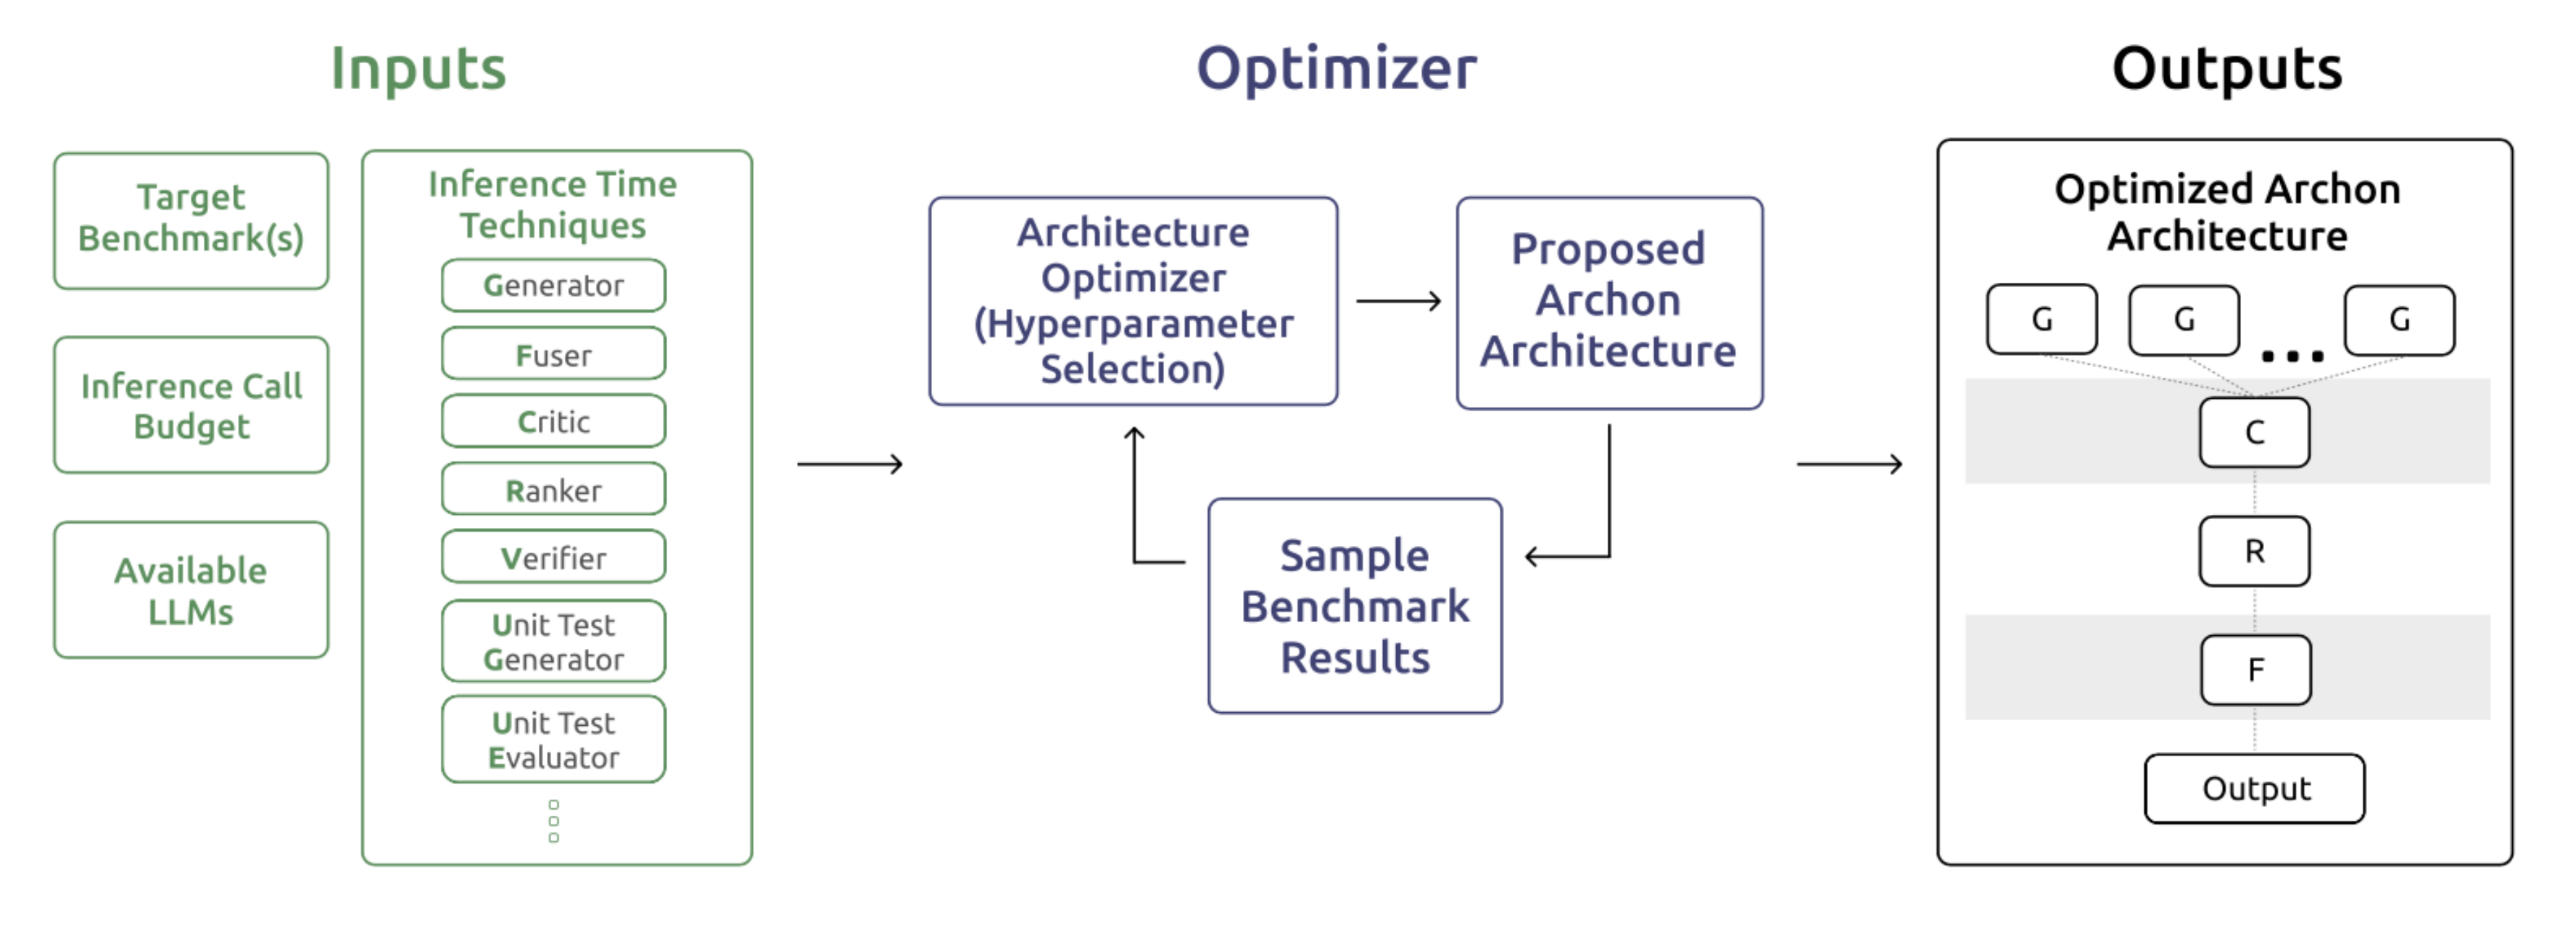
图 08 左边输入目标基准、预算和可用组件。中间提出组合、采样评测、用结果调整搜索。右边得到当前任务下选出的推理架构。 来源 [4]Archon 推理架构搜索论文(2024)
04 Agent 自己选下一步,有哪几种写法?
ReAct 边做边看
ReAct是 Reason + Act。每步先根据现有信息判断要做什么,执行一个动作,观察结果,再决定下一步。拿第一篇那道 Apple Remote 的题来说,Agent 先查遥控器最初针对什么软件,得到 Front Row,再去查这个软件还支持什么控制方法。搜到名字相近的词条后,它调整搜索,最后找到键盘功能键。它每轮都能根据刚取到的证据调整,而把多步推理一次写完,就没法在中途用新资料纠正起点[5]。
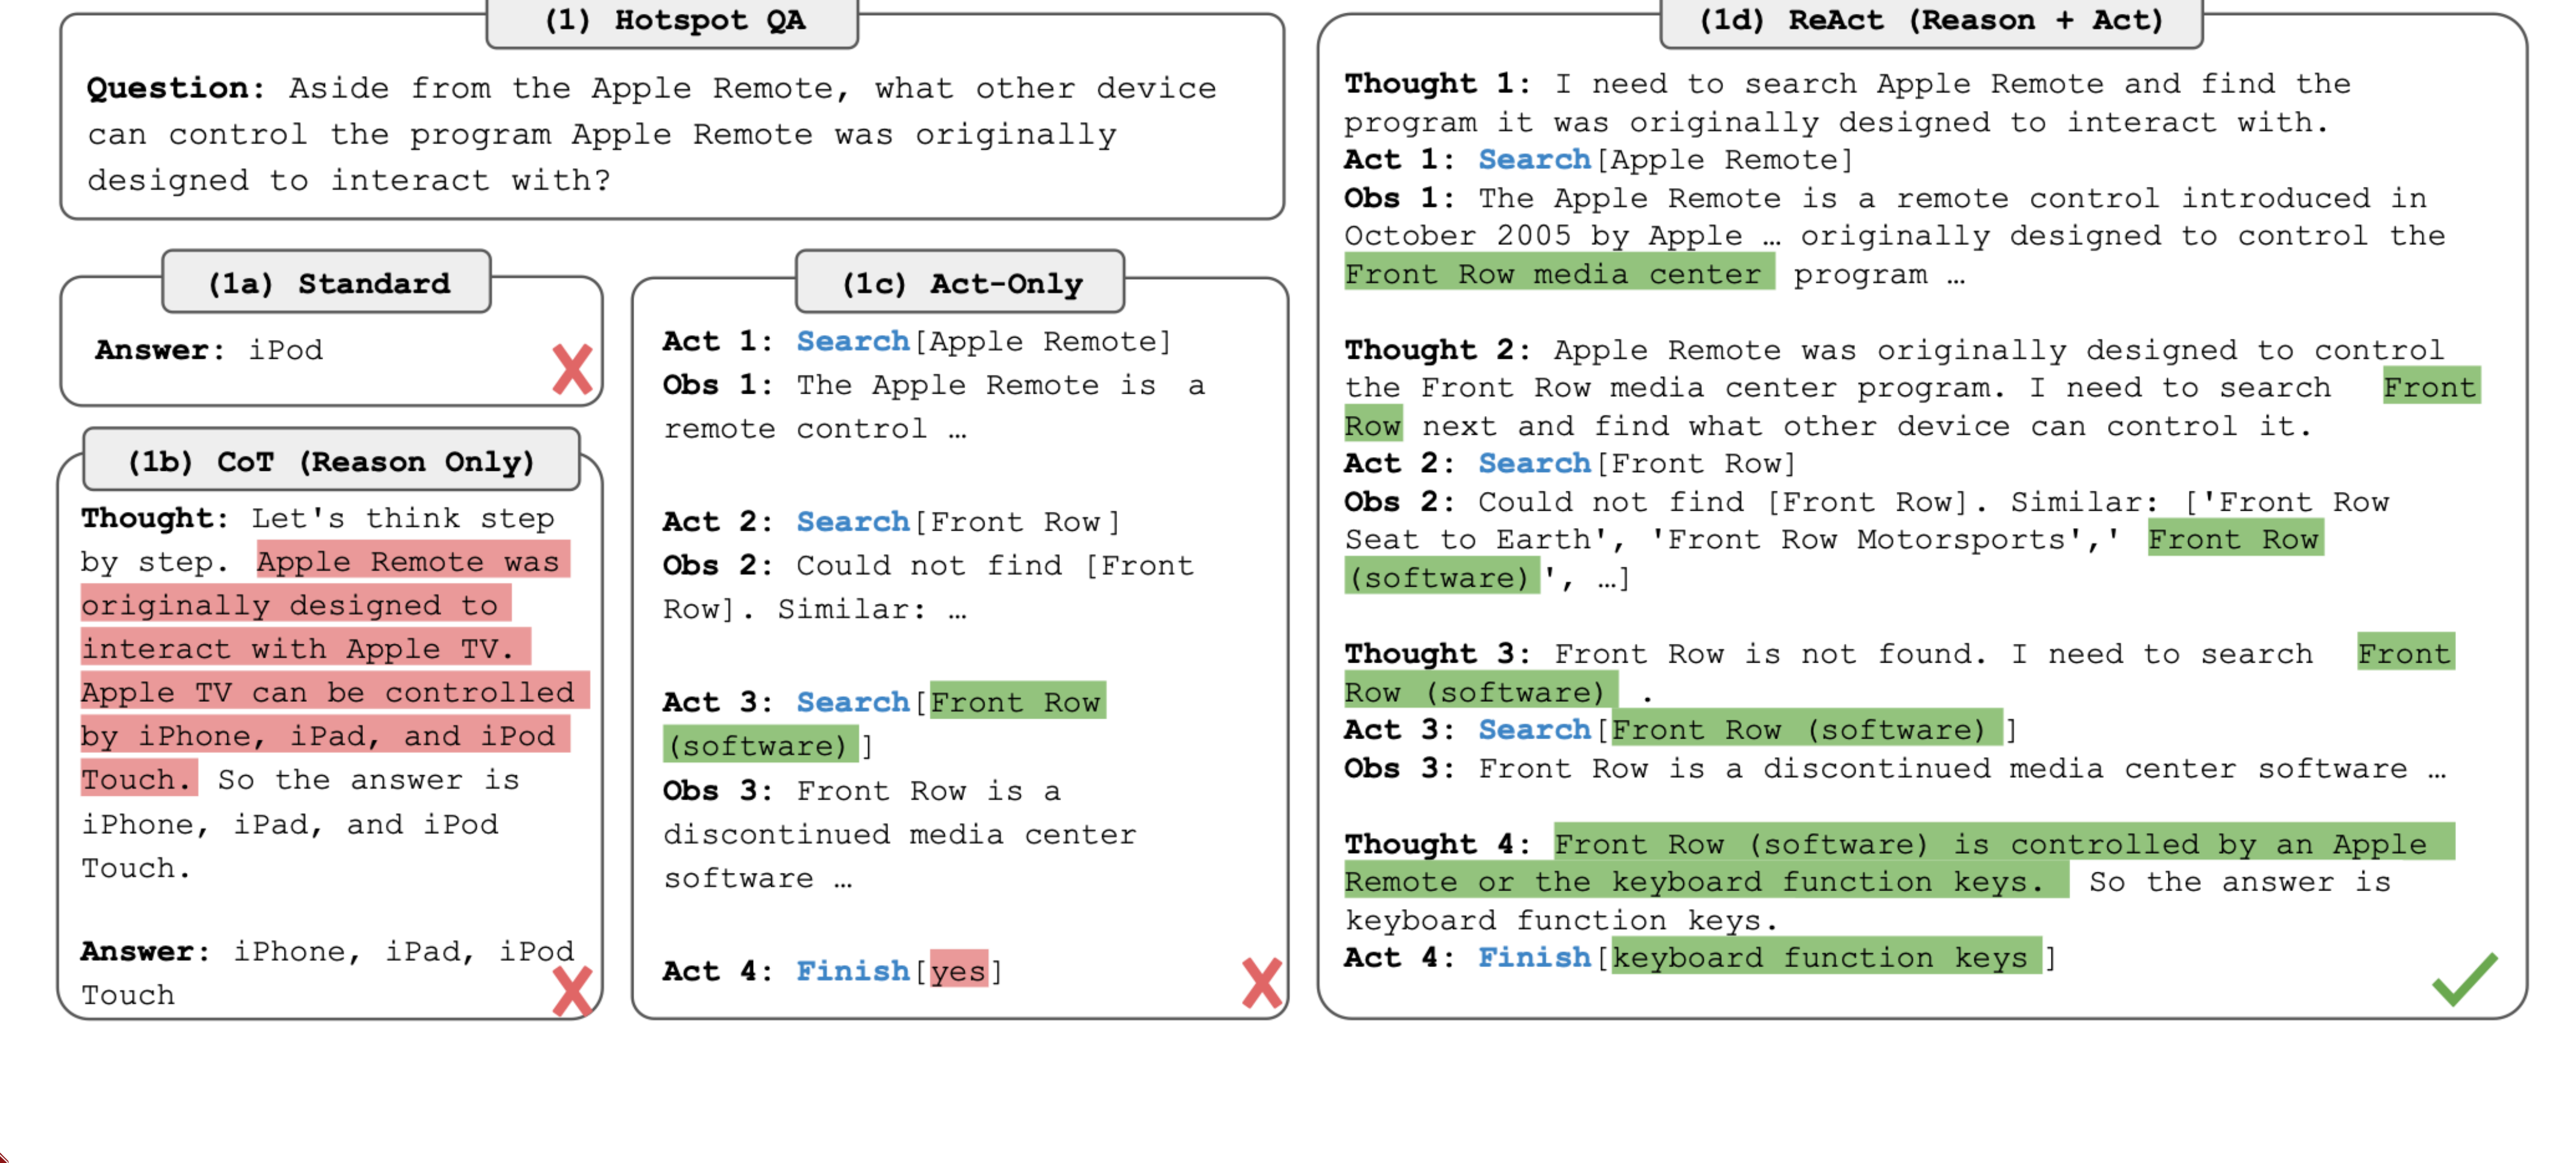
图 09 左侧是同一题的几种回答方式,右侧是 ReAct。每次 Action 后面都有 Observation,第三轮换成更具体的搜索词,最后答出键盘功能键。 来源 [5]ReAct 原论文(2022)
这里的「推理」是系统根据当前状态选行动,原论文用文本展示了这个过程。实际应用可记录简明的行动理由、调用和证据,方便排查。循环还需要清楚的出口,比如证据足够、必须向用户确认、或者已经到达步数上限。
Reflexion 让上一轮失败变成下一轮经验
Reflexion把反馈从一步拉长到一次任务。先让负责行动的模型做一次,评估者或外部环境反馈结果,再把有用的经验写成几句反思,留给下一次尝试。比如测试告诉 Agent 改动只覆盖普通用例,边界条件还过不了。下次先读这个反馈,直接去找漏掉的路径,比重新猜一次更有针对性。论文里的实验用这种文本记忆提高了若干任务的多次尝试表现[6]。
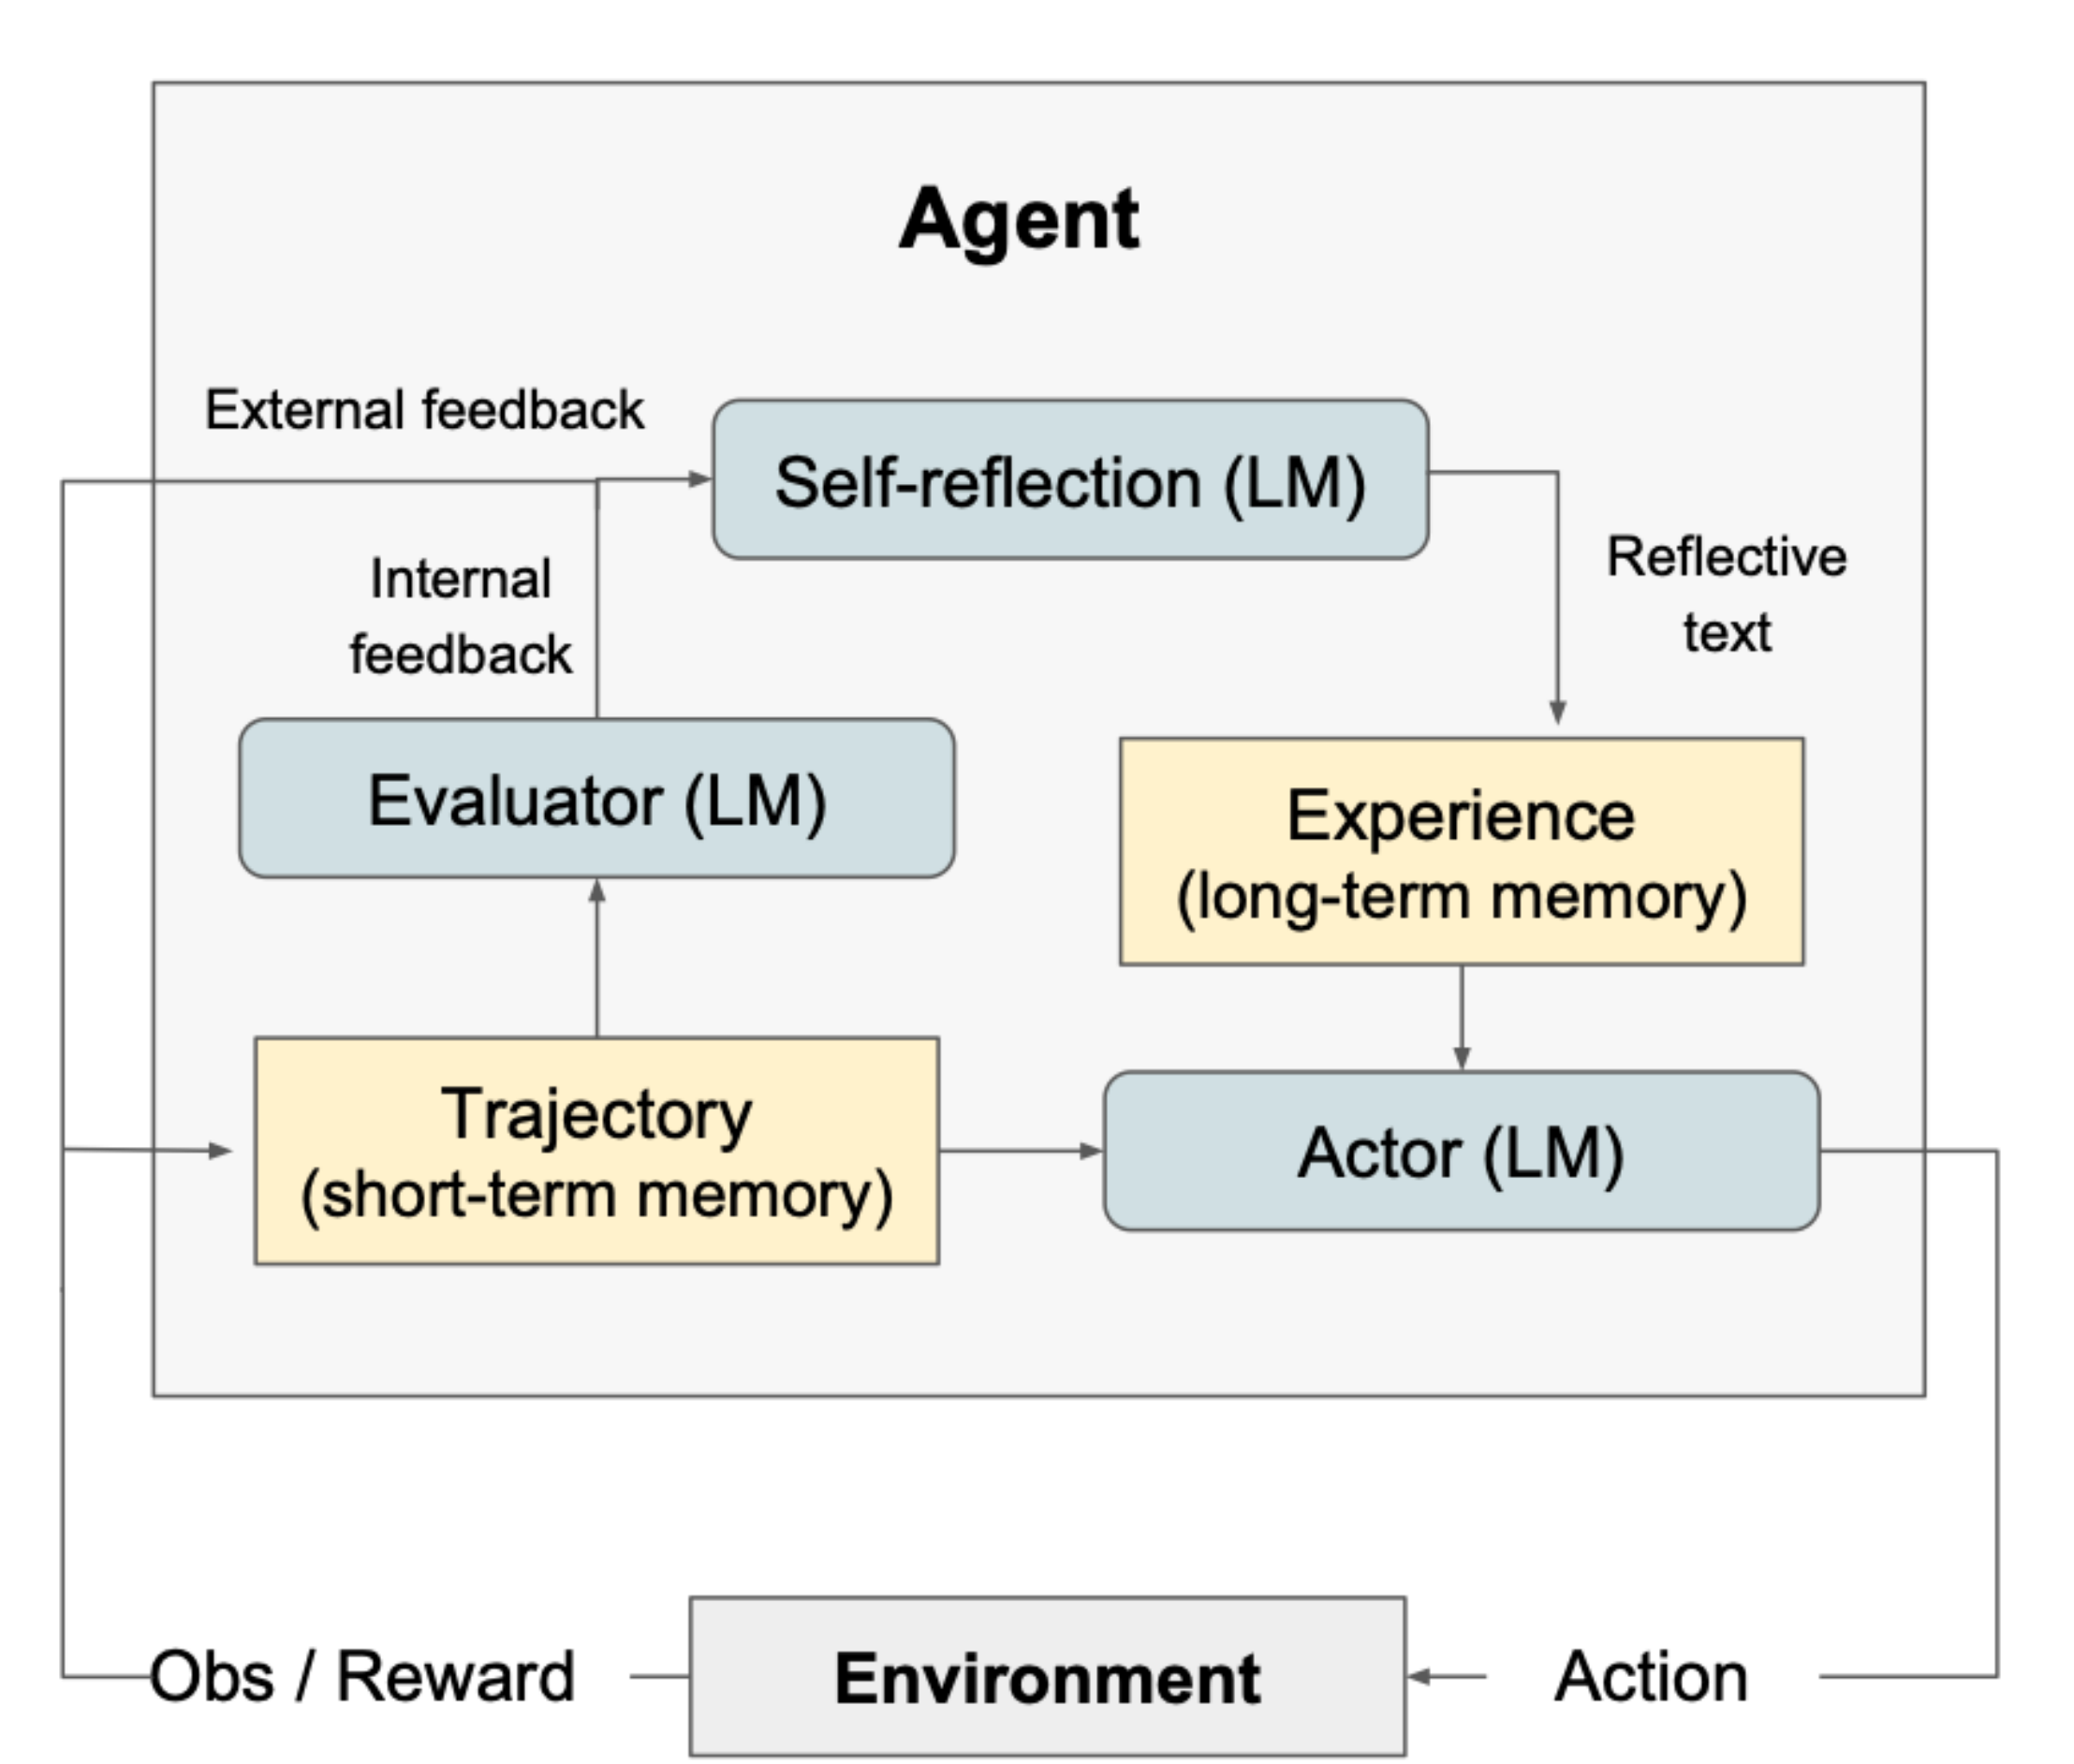
图 10 下面是 Agent 与环境交互。评估和环境反馈进入自我反思,再写进右边的经验记忆。新的尝试可以读取它。 来源 [6]Reflexion 原论文(2023)
评估者光说一句「我认为应该重答」就让模型改,有时会把对的改错。关于自我纠错的研究发现,缺少可靠外部反馈时,在它所测试的一些推理任务上,模型反思后的结果反而变差。CRITIC把搜索、程序执行等工具引入验证过程。举例说,先写出答案,再用计算器核对数字,用资料核对事实,拿能验证的结果修正文案。模型有内置推理能力,任务能不能办好仍然可以拿外部状态核验[7][8]。
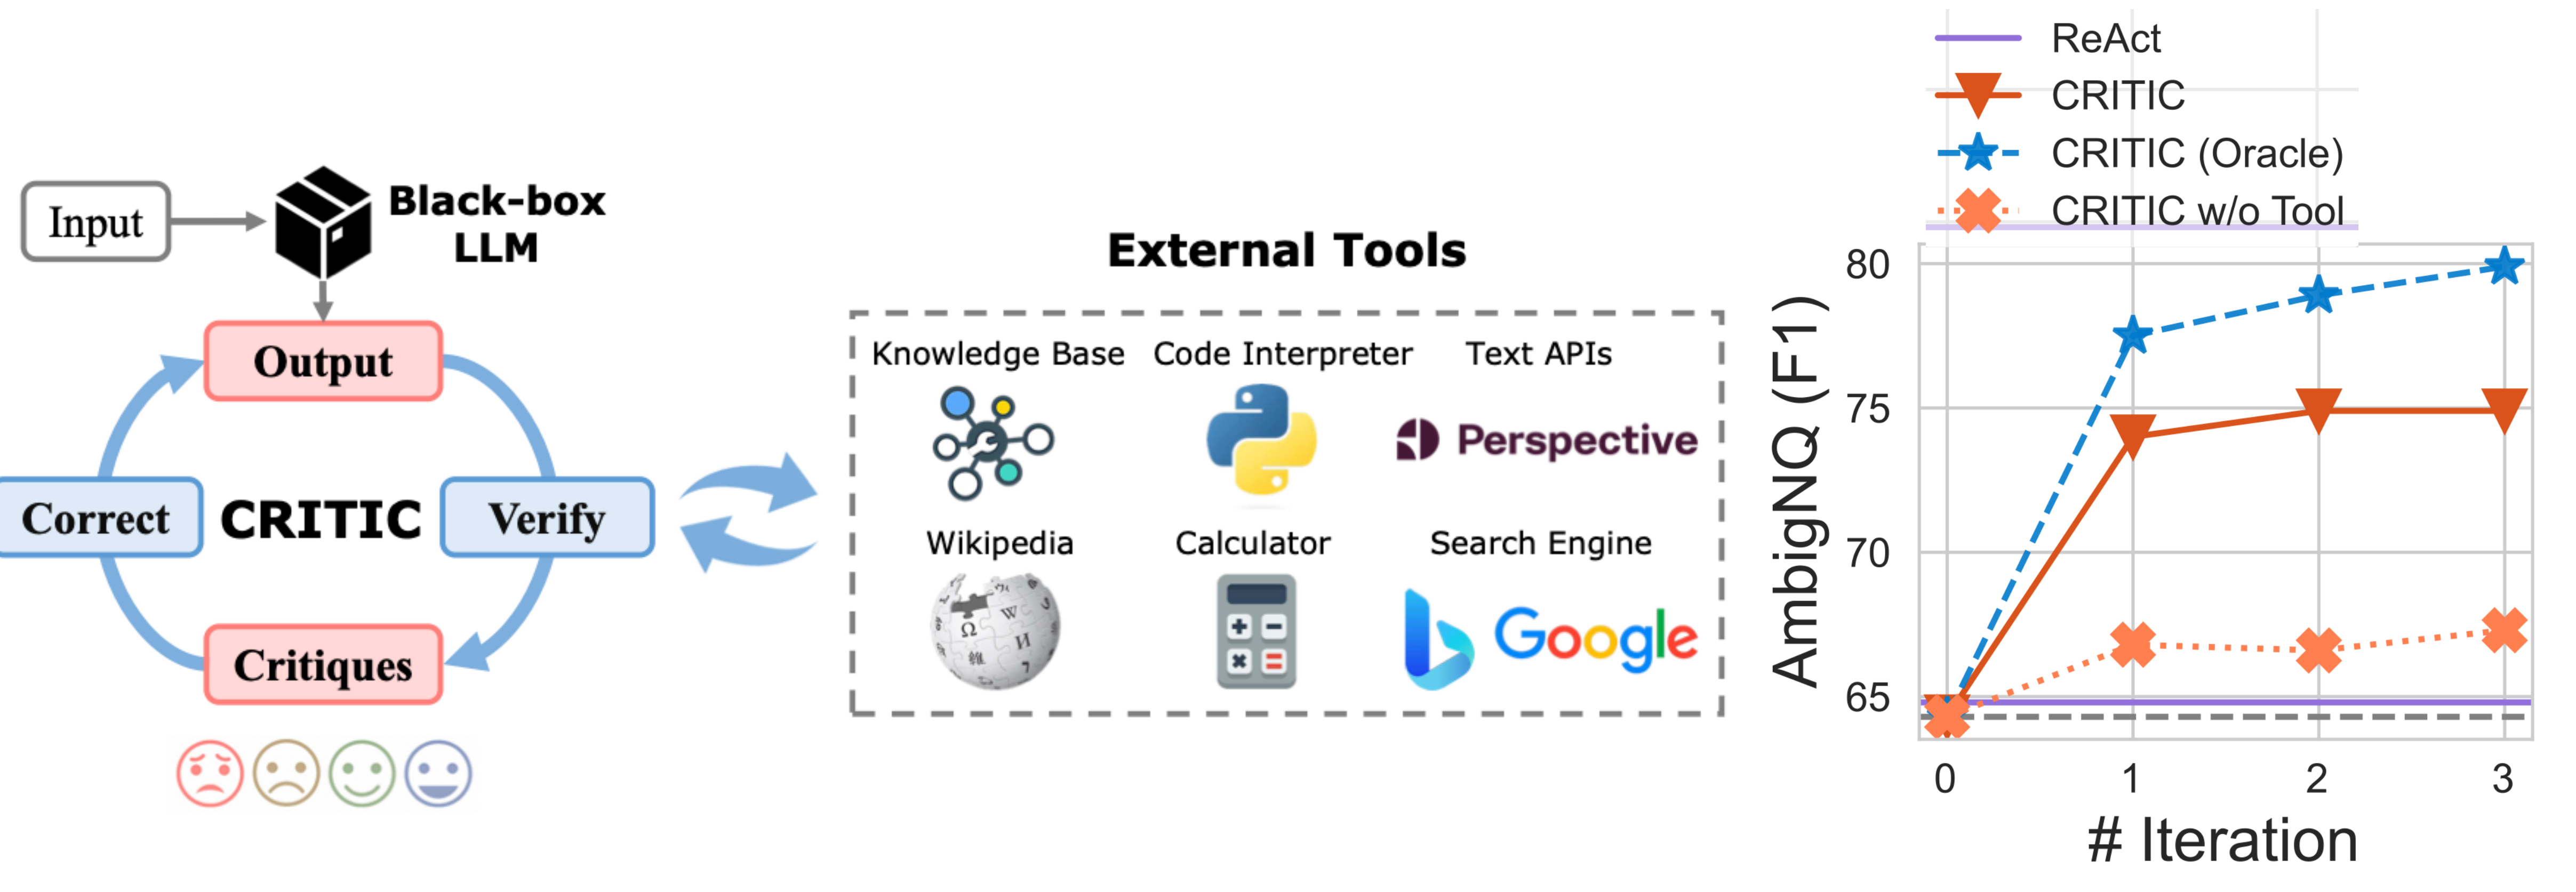
图 11 图左先生成答案,图中用搜索或计算等工具验证,拿结果返回修订。右边对比在同一个评测任务里,不同验证条件下的表现。 来源 [8]CRITIC 工具辅助纠错论文(2023)
CodeAct 把一段行动写成可运行的代码
用 JSON 调一个工具很明白,函数名是什么,参数是什么。但遇到很多相似调用时,每次都先让模型读一遍结果,会用掉很多轮。CodeAct让模型把行动写成代码,交给执行环境。代码能用循环、变量、条件,也可以在一轮里组合现成函数[9]。
原论文有个比价例子。对四个国家查手机价格、换算汇率、算上成本,再找最便宜的。每一步都用单个 JSON 调用,中间结果反复回到模型。代码可以遍历几个地区,直接在执行环境里比较,最后回一份最小值和对应国家。论文在其任务设置下看到更高的成功率和更少的交互回合。真正接到应用时,代码能读哪些文件、调用哪些接口以及资源上限,都属于执行环境该管的事。
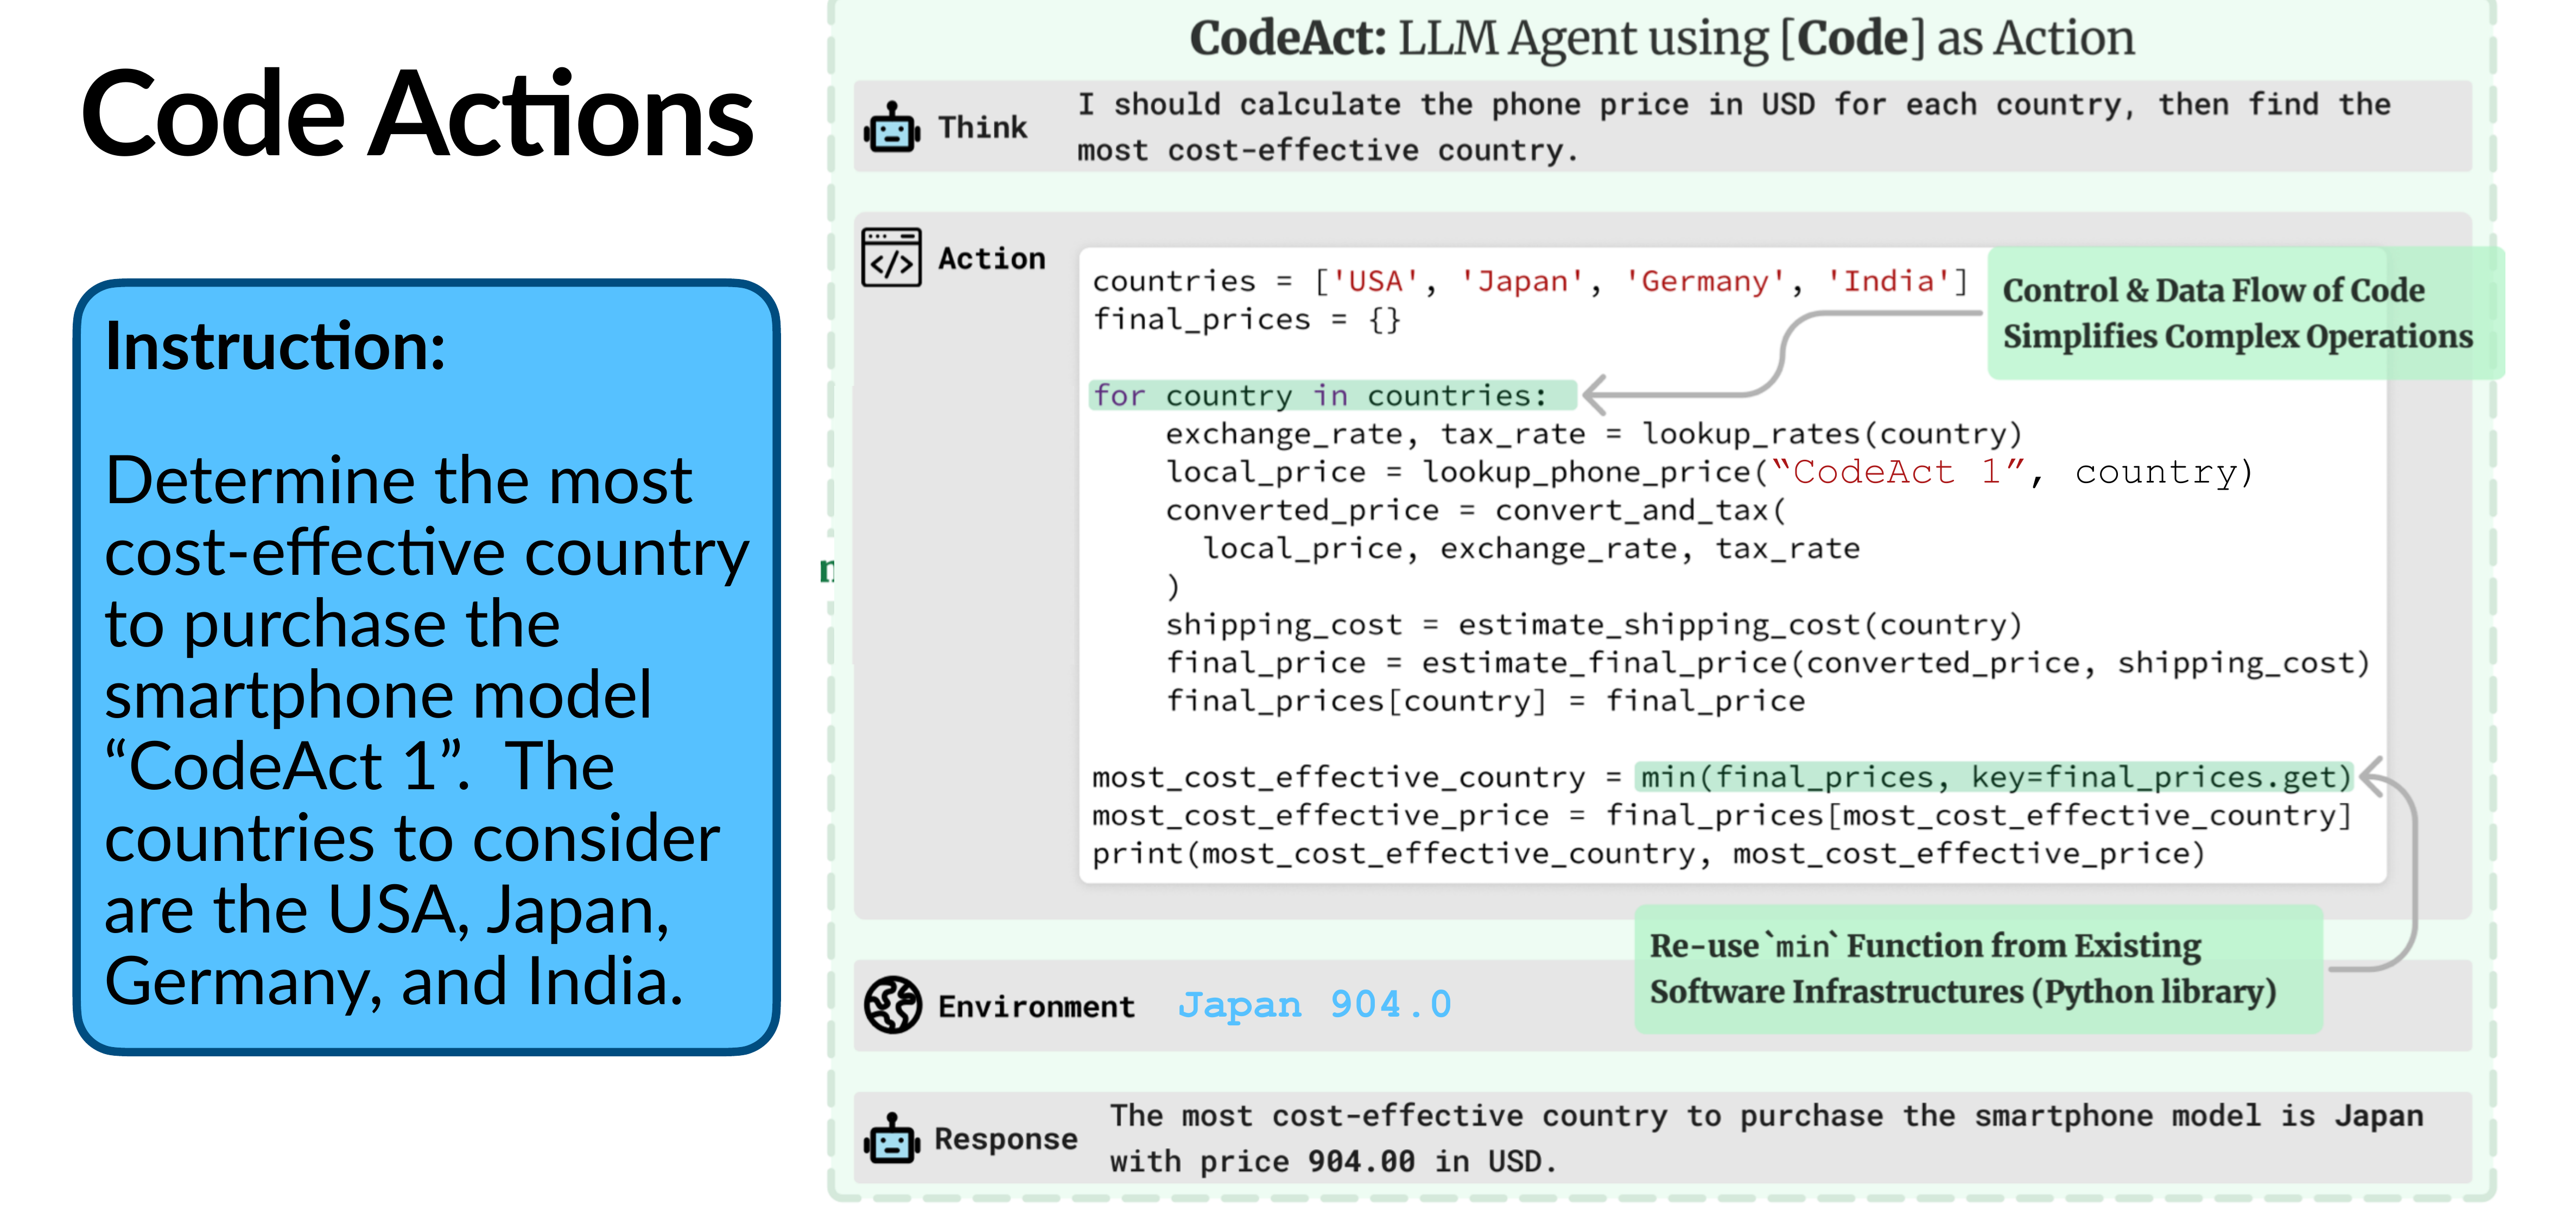
图 12 左侧是要比较四个国家的购买成本。右边的代码循环读取价格和汇率,算完再比较,把结果交回模型。 来源 [9]CodeAct 原论文(2024)
ReWOO 和 LLMCompiler 把能提前排的活排好
如果查资料的顺序一开始就能想出来,可以先计划。ReWOO把任务拆成 Planner、Worker 和 Solver。Planner 一次写出计划,后面的步骤可以用变量引用前面将来返回的证据;Worker 依次解析引用执行;Solver 最后汇总。这样每拿到一个结果,模型不用带上所有已走步骤再规划一遍。要是早先计划没考虑到数据缺失,执行时也要有失败出口[10]。
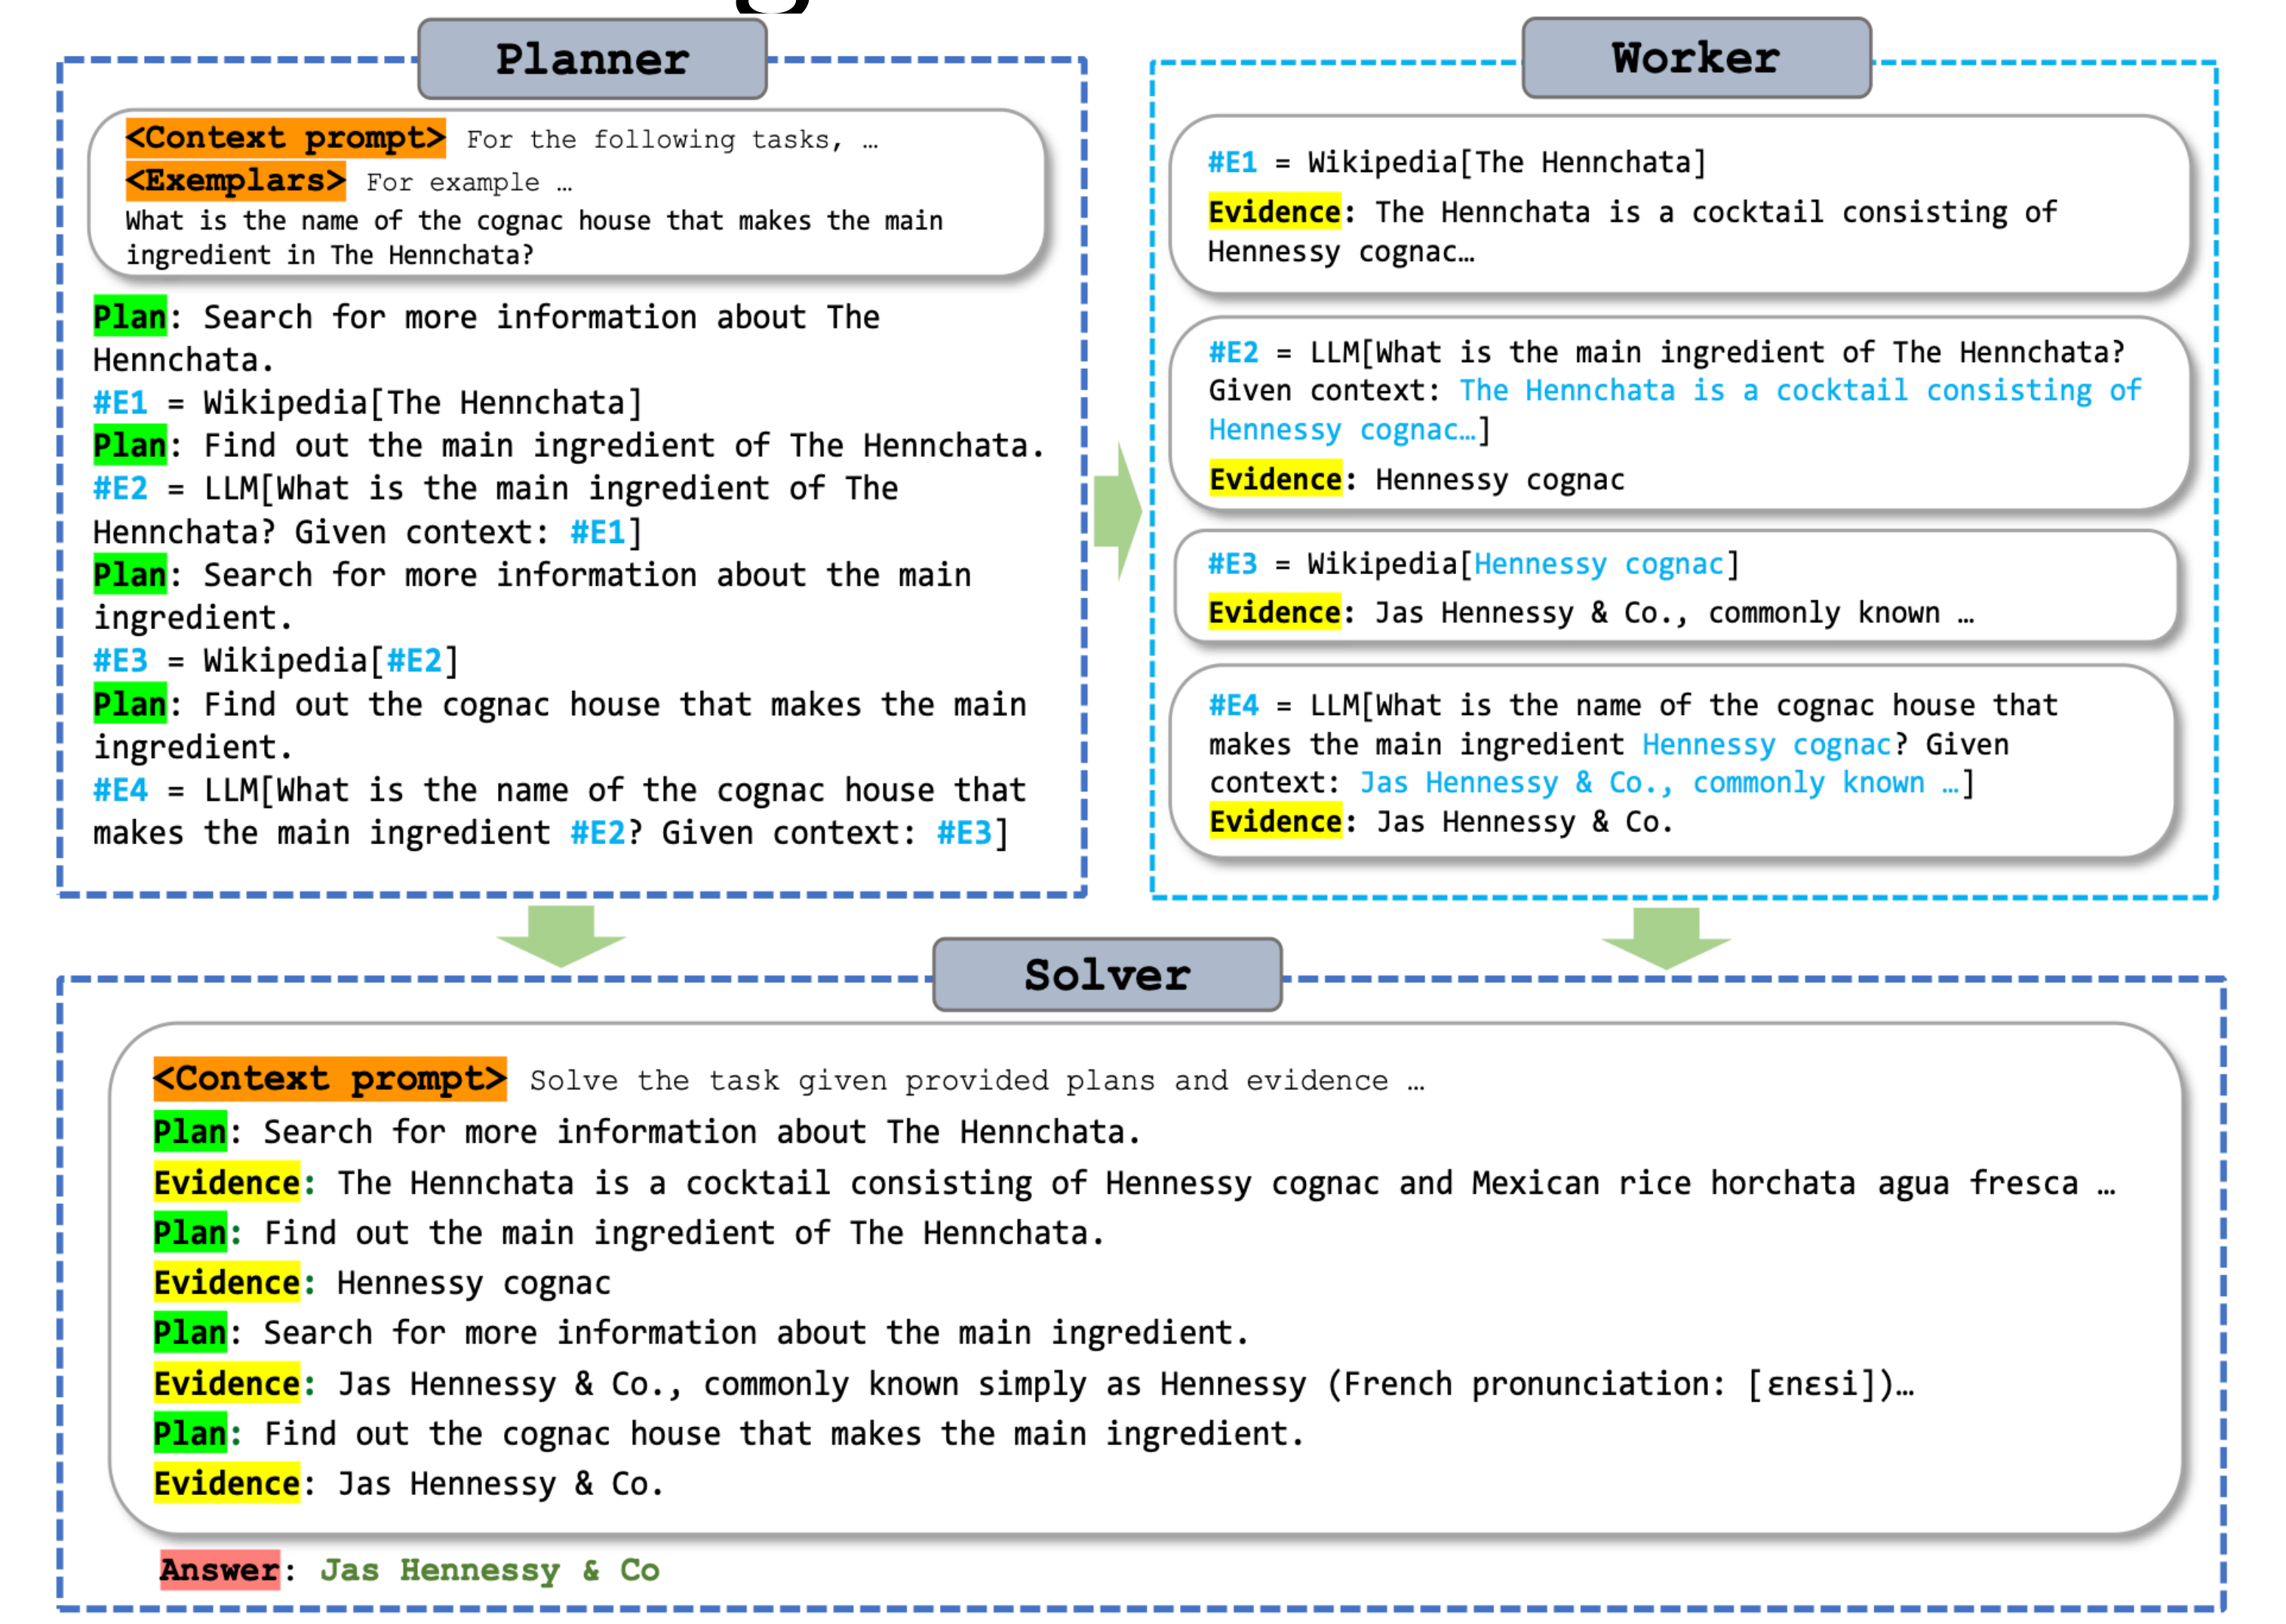
图 13 Planner 写下步骤和待填的证据编号,Worker 调工具补上证据,Solver 结合计划和结果作答。 来源 [10]ReWOO 原论文(2023)
LLMCompiler进一步把任务组织成有向无环图(DAG),让互不依赖的调用并行,后一项要用前一项结果时再等待。比如分别搜索两个人的国籍,两个搜索可以同时跑,比较要等都回来。它还可以根据已有结果决定直接作答或重新规划。这里的并发收益取决于任务有多少能同时做的步骤,也取决于多一次规划的开销[11]。
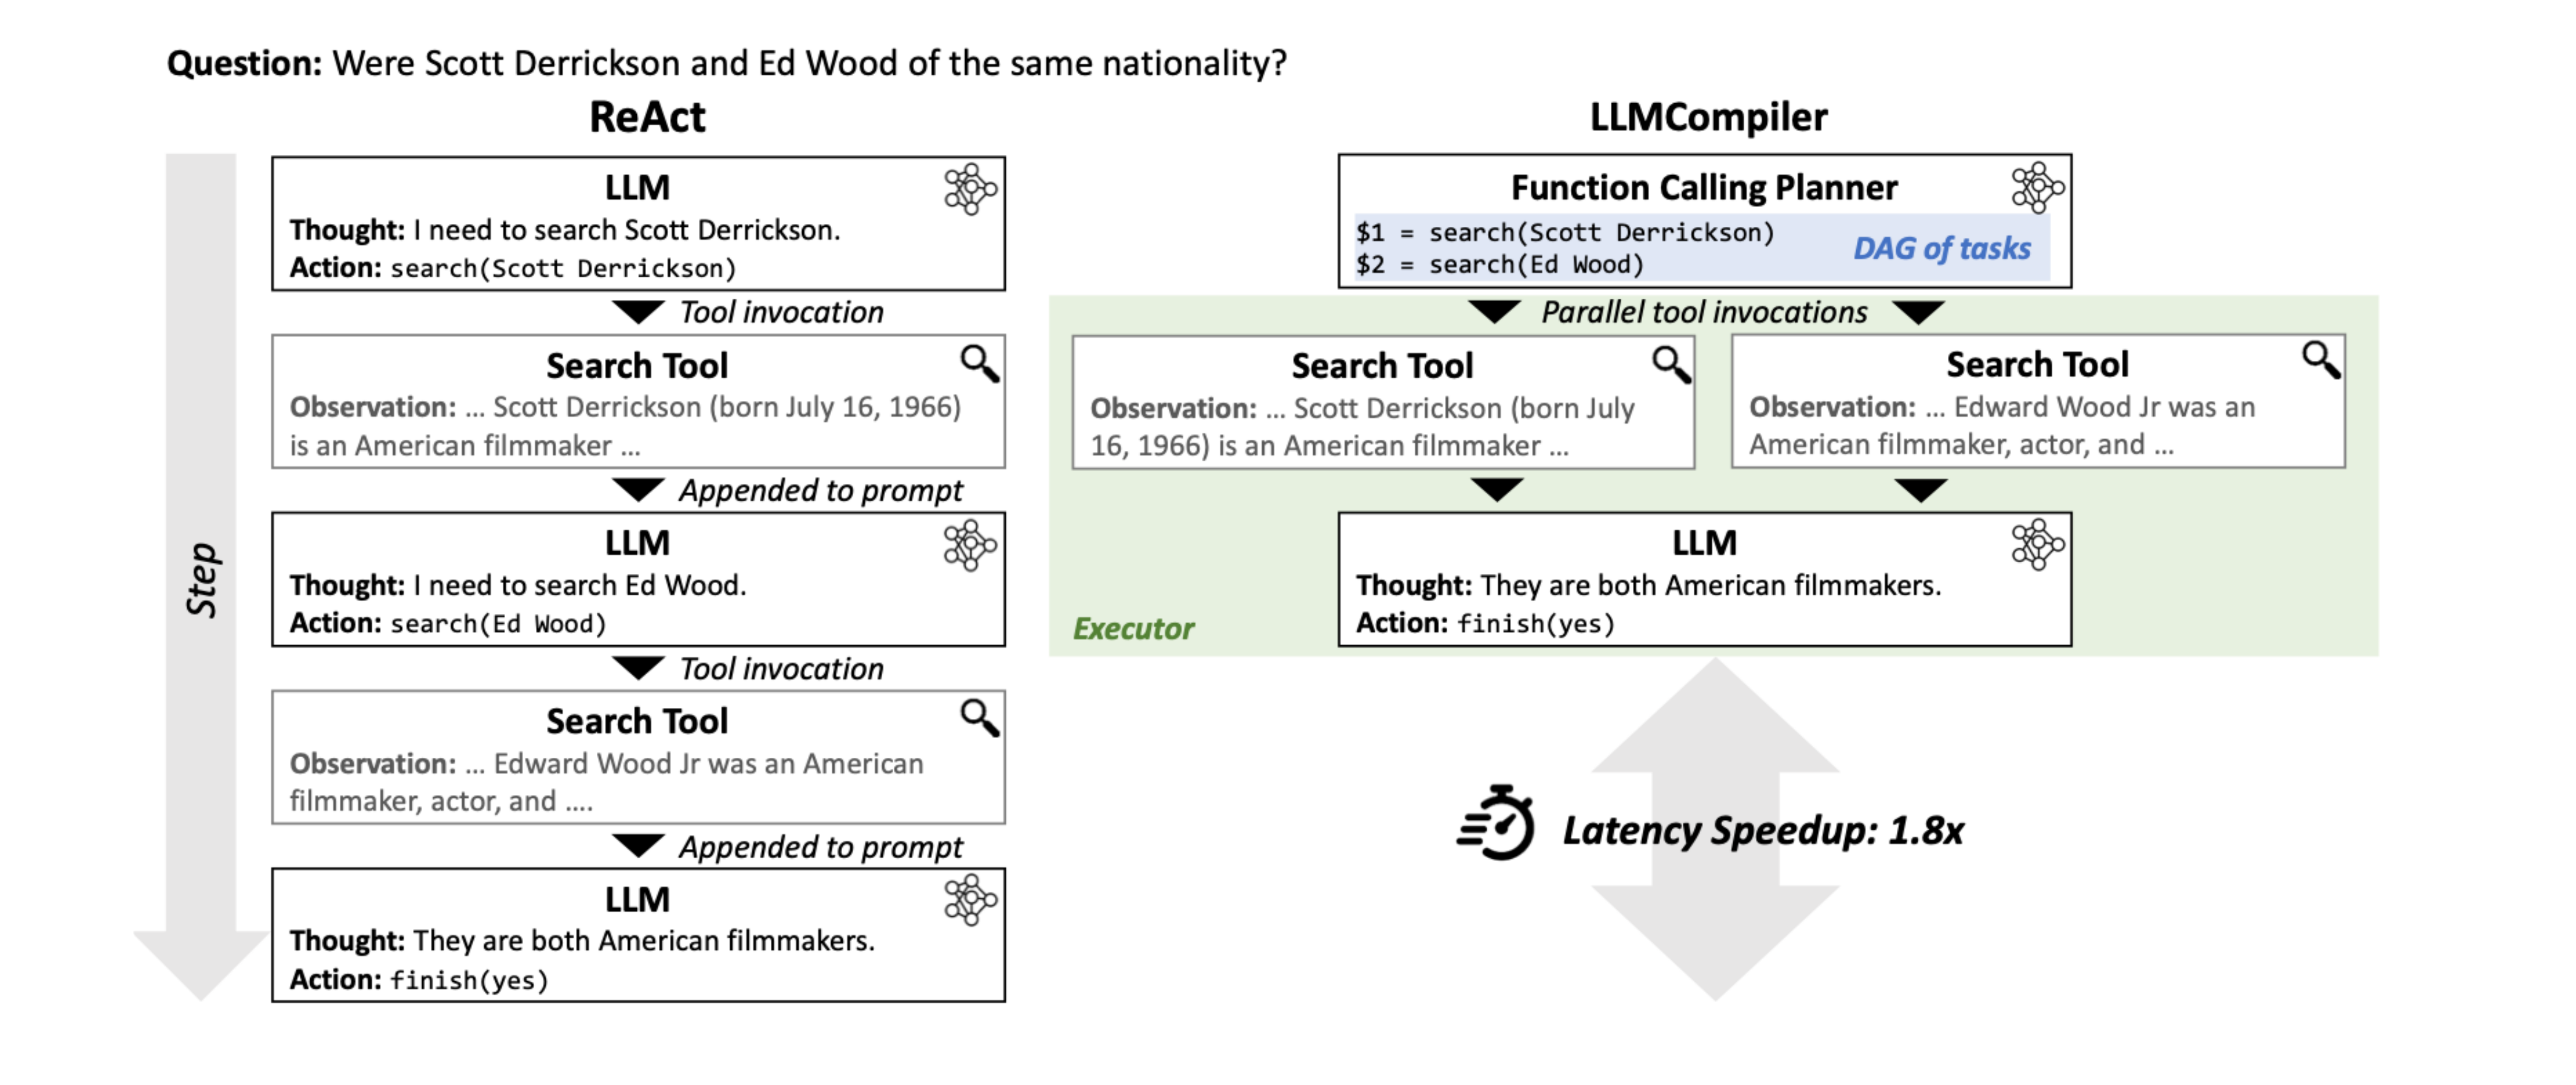
图 14 左边的 ReAct 先查一个人再查另一个,右边先由 Planner 生成两个搜索,两个结果回来才汇总。图中的加速倍数只对应这次示例。 来源 [11]LLMCompiler 原论文(2023)
几种办法可以放在同一个 Agent 里。先计划可以同时做的查询,遇到一条信息和预期不符时,再走一轮「观察、决定、行动」。我会看每一步到底要不要等上一步。依赖画出来,就知道哪些能并行、哪里要保留调整空间。
05 任务跑久了,模型这一轮应该看到什么?
工具每次返回点东西,消息历史很快就会变长。上下文窗口有上限,推理成本会长,材料变多之后关键信息也可能淹没在里面。反过来,如果只留最近几句,Agent 可能忘了用户说过「只能读,别改」,也可能忘了自己已经跑过哪些检查。上下文管理要同时保住两件事,当前这一步好找关键信息,任务接着跑还有前情[12]。
还有个容易忽略的成本。部分模型服务可以复用请求开头重复的 token,对应的键值缓存通常依赖相同的前缀。把固定指令放在前面、每轮新证据接在后面,有机会少算一段。如果不断改动历史靠前的位置,能复用的部分就会缩短。压缩能降低后续输入量,但压缩后的第一轮仍可能需要重新处理一部分内容。
持久化事件日志,原记录和输入分开
OpenHands可以把用户消息、动作和工具观察记成一条条事件。磁盘上的完整记录保留下来。每次给模型发请求时,从事件里选当前需要的部分,分组、转成消息,形成这一轮的输入。比如排查一次错误时,可以找回某条命令的完整输出;模型处理别的文件时,不用轮轮重读那一大段日志。外部观测工具也可以订阅事件来追踪进度[13]。
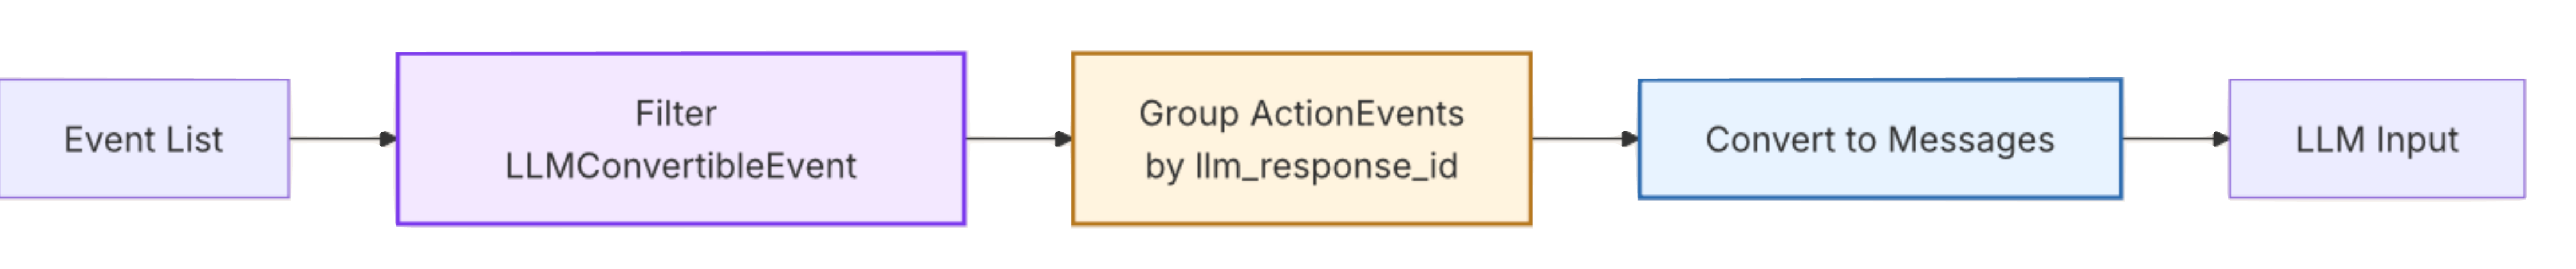
图 15 从左往右读。原事件经过筛选和分组,再转换成模型能读的消息。右边的输入只是根据左边的记录生成的一份视图。 来源 [13]OpenHands SDK 事件架构文档
外置记忆,必要时再取
MemGPT借用了像内存分层一样的思路。把眼下需要用的状态留在工作上下文里,把低频信息存到外部存储,需要时再检索进来。原图里,Agent 和用户聊起生日,当时可以留下有用的事实。下一次再聊到相关经历,就按关键词回查。具体存哪些、怎样找旧信息,会影响它能不能在后续找回正确一段[14]。
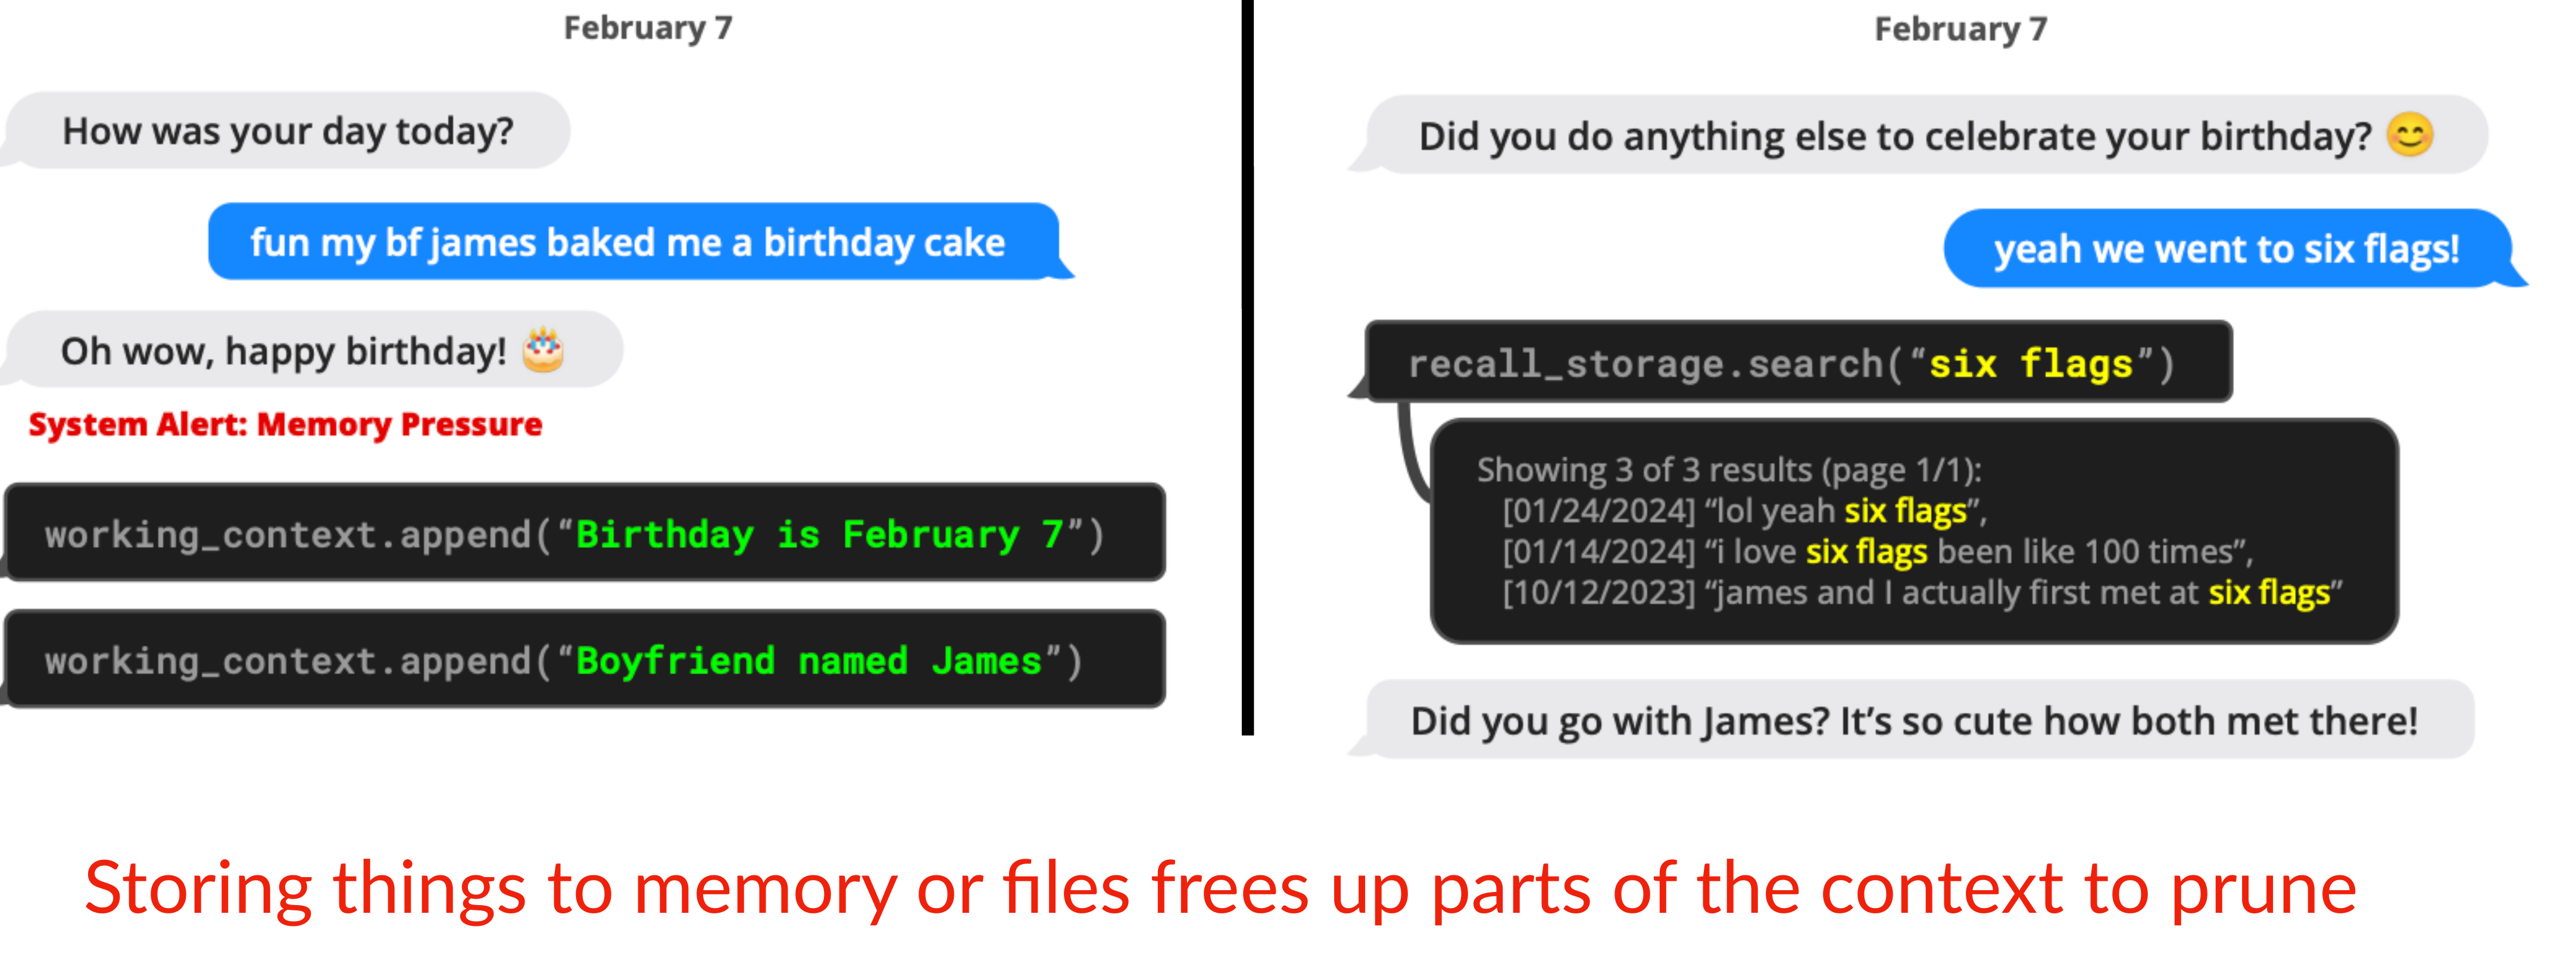
图 16 左边对话里有值得保留的事实。右边隔了一段时间,从外部记忆查回相关信息,再接着答。两次对话不需要全部常驻在模型输入里。 来源 [14]MemGPT 原论文(2023)
上下文压缩和观察遮蔽,动的是不同地方
Compaction(上下文压缩)通常用模型把较早的对话、行动、观察压成一段摘要,再和最近几轮放在一起。好的摘要要把已经做过的决定、需要继续做的事和用户限制写清楚。它能留住线索,但也可能遗漏关键细节。保留原始事件,就有机会在需要时回查。
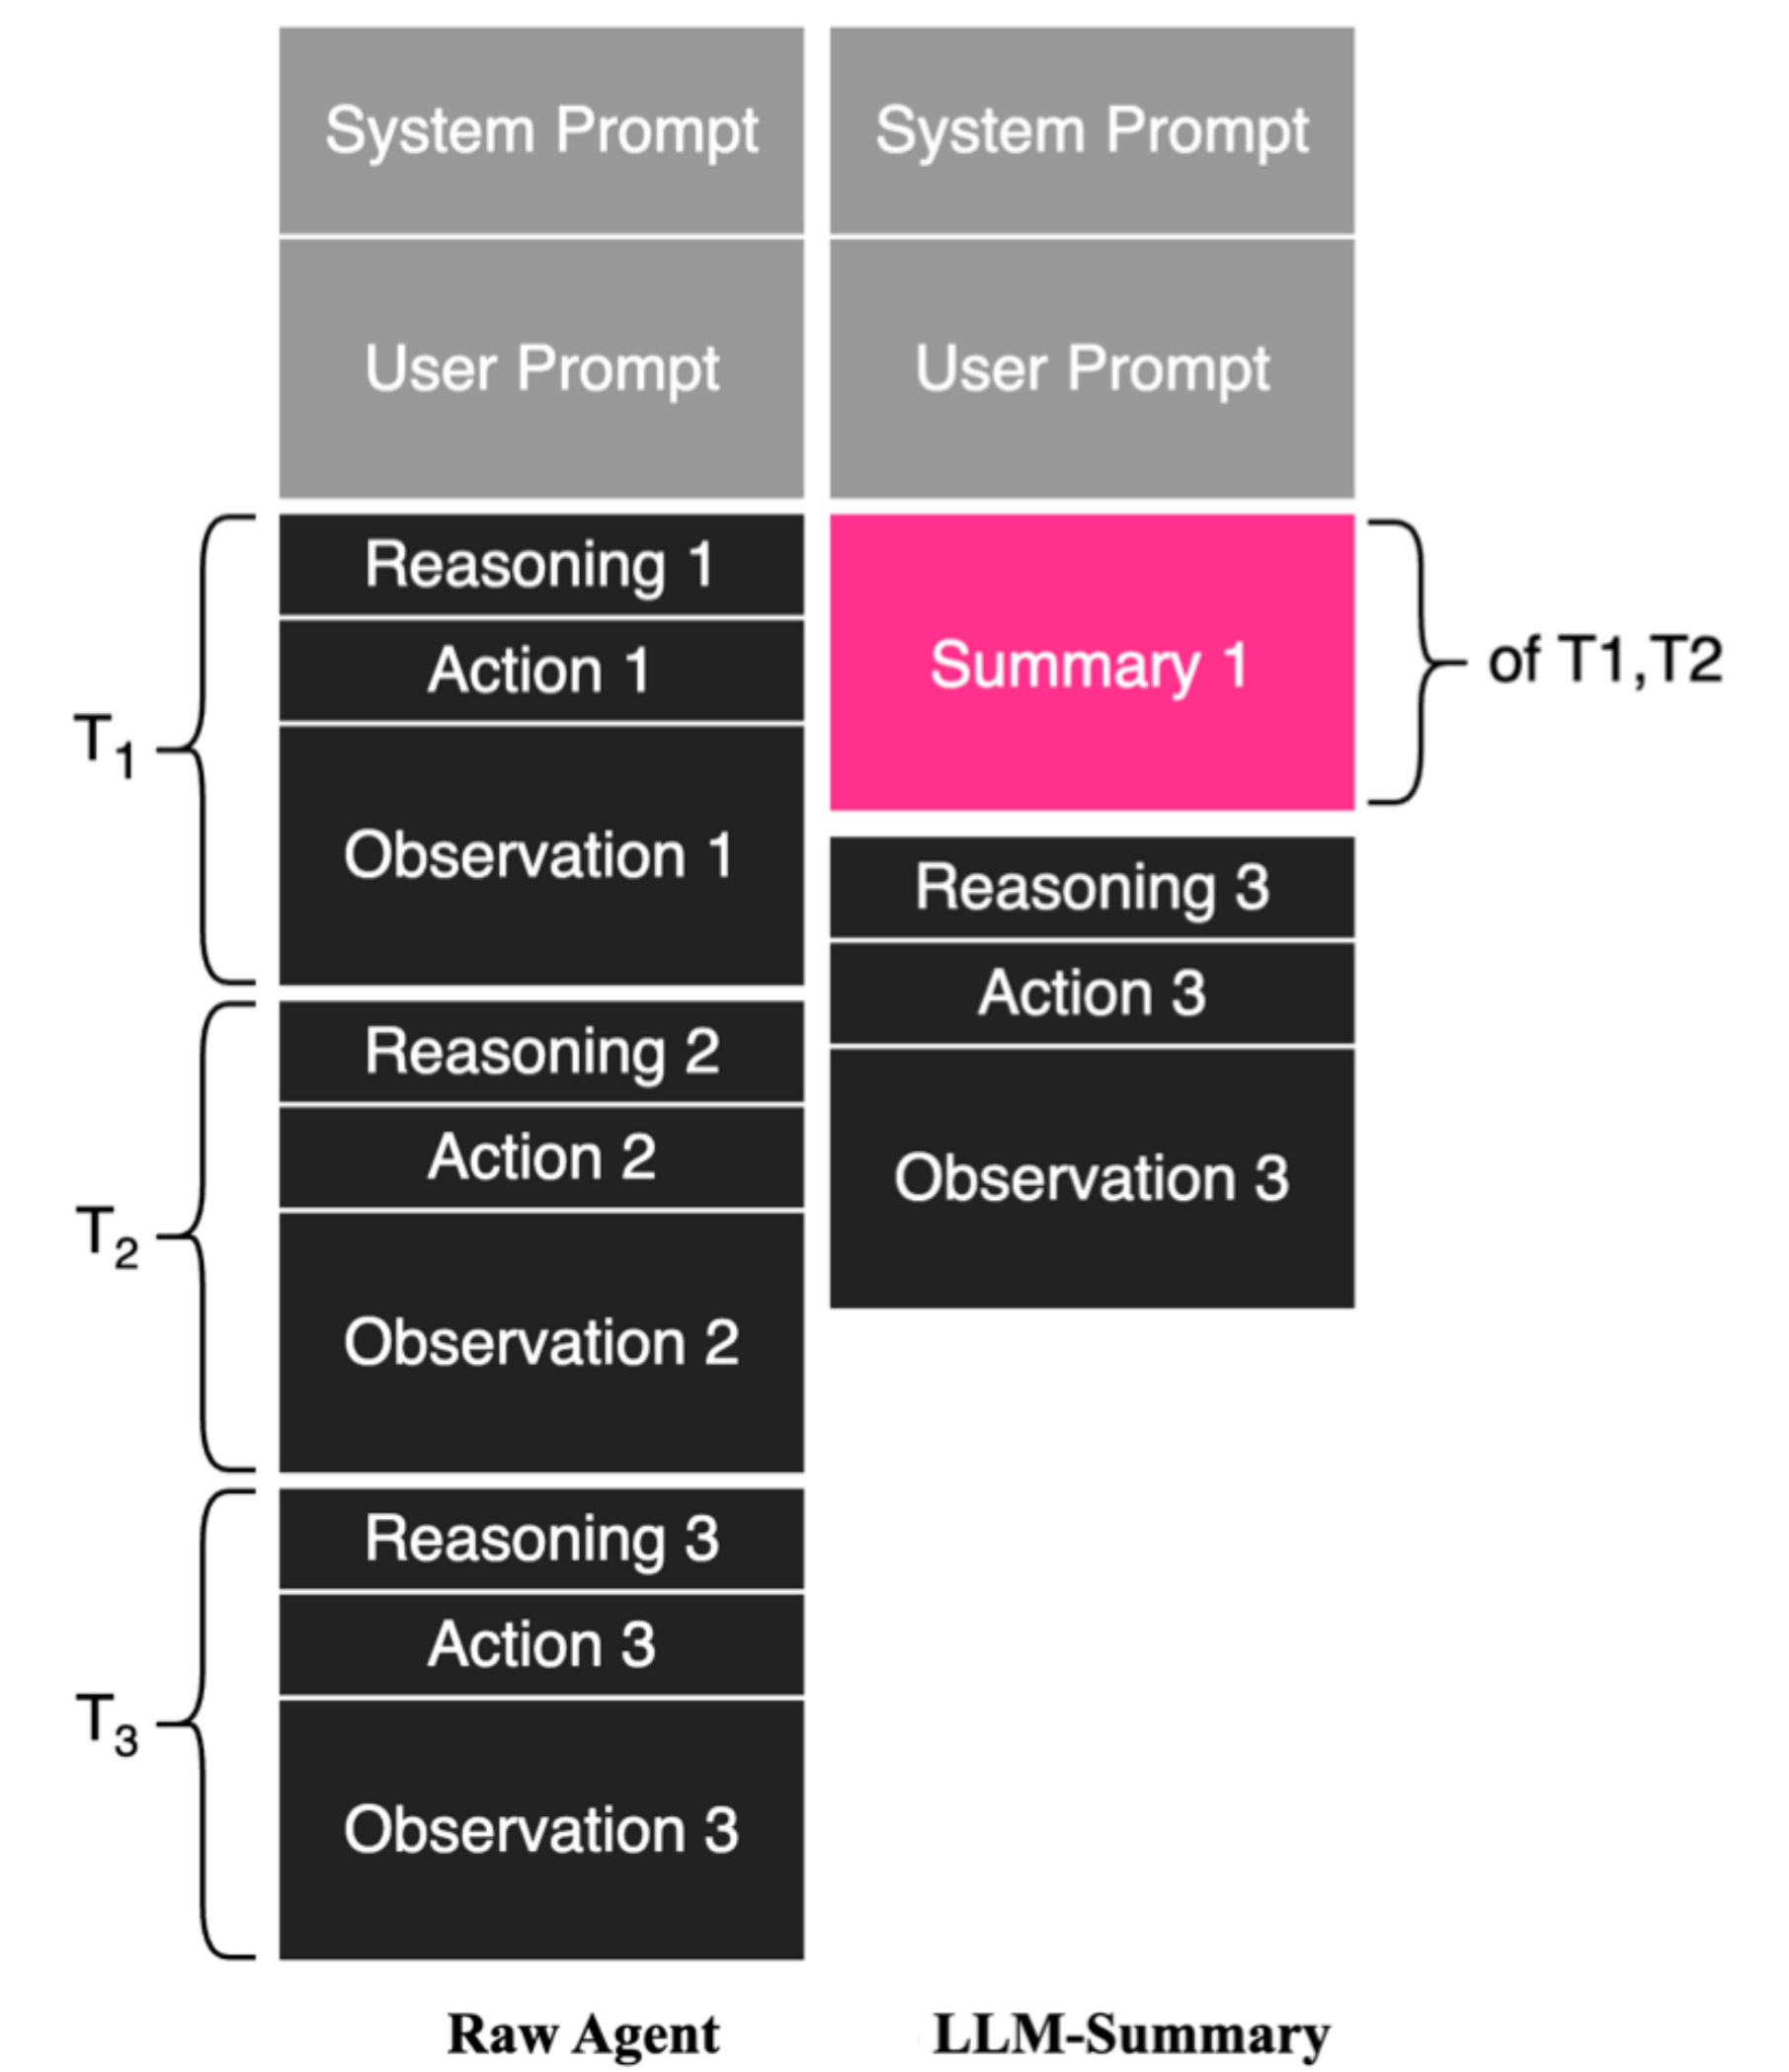
图 17 左边是三轮推理、行动和观察。右边用粉色的 Summary 1 替换较早的两轮,保留第三轮原文。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[12]Anthropic · Agent 上下文工程
Observation Masking(观察遮蔽)可以先只处理长工具输出。比如保留「执行过测试」和后续对结果的判断,把很早的一整屏测试输出换成占位提示,近期输出继续保留。对照论文的样本,编程 Agent 上下文里工具观察占了很大比例。在一些模型和任务的设定下,这种程序化做法用较少上下文内容,达到了和模型摘要接近的效果。要保留哪些输出,仍取决于接下来的任务是否需要回去核对细节[15]。
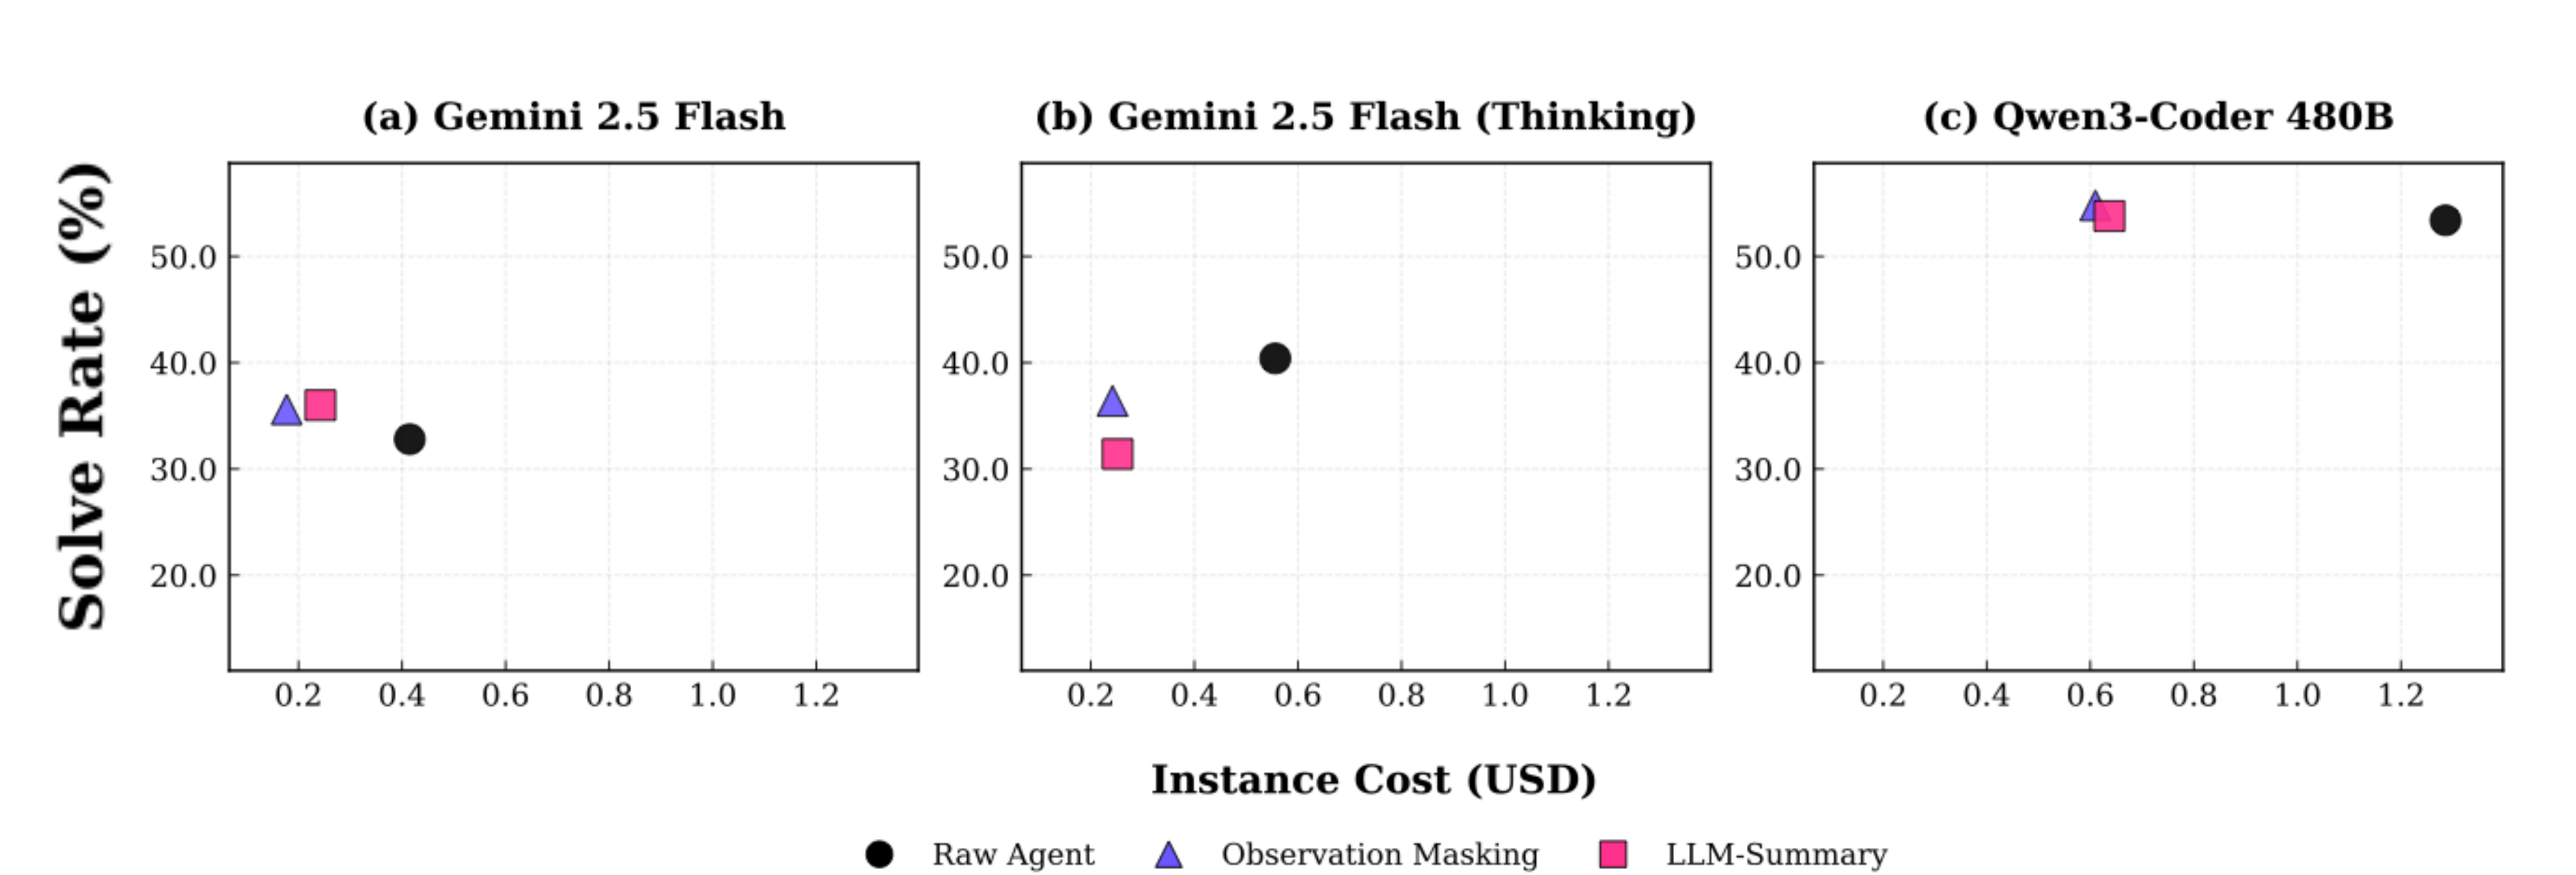
图 18 横轴是每个任务的运行成本,纵轴是解决率。每张小图是一个模型,三种标记分别表示原始上下文、遮蔽旧观察和模型摘要,在同一张图里比较。 来源 [15]The Complexity Trap 观察遮蔽研究(2025)
隔离上下文,把材料按需交给需要的人
如果一个子任务会读很多资料,可以交给上下文独立的子 Agent。主 Agent 发目标和范围,子 Agent 做完返回结论、证据和重要错误,主线程继续。还可以用渐进披露(Progressive Disclosure),开头只放工具或技能的简述,真正碰到 PDF、表格等任务再读对应说明和资源。正文可以晚点给,系统层的必要规则仍然应当一直可用[12][16]。
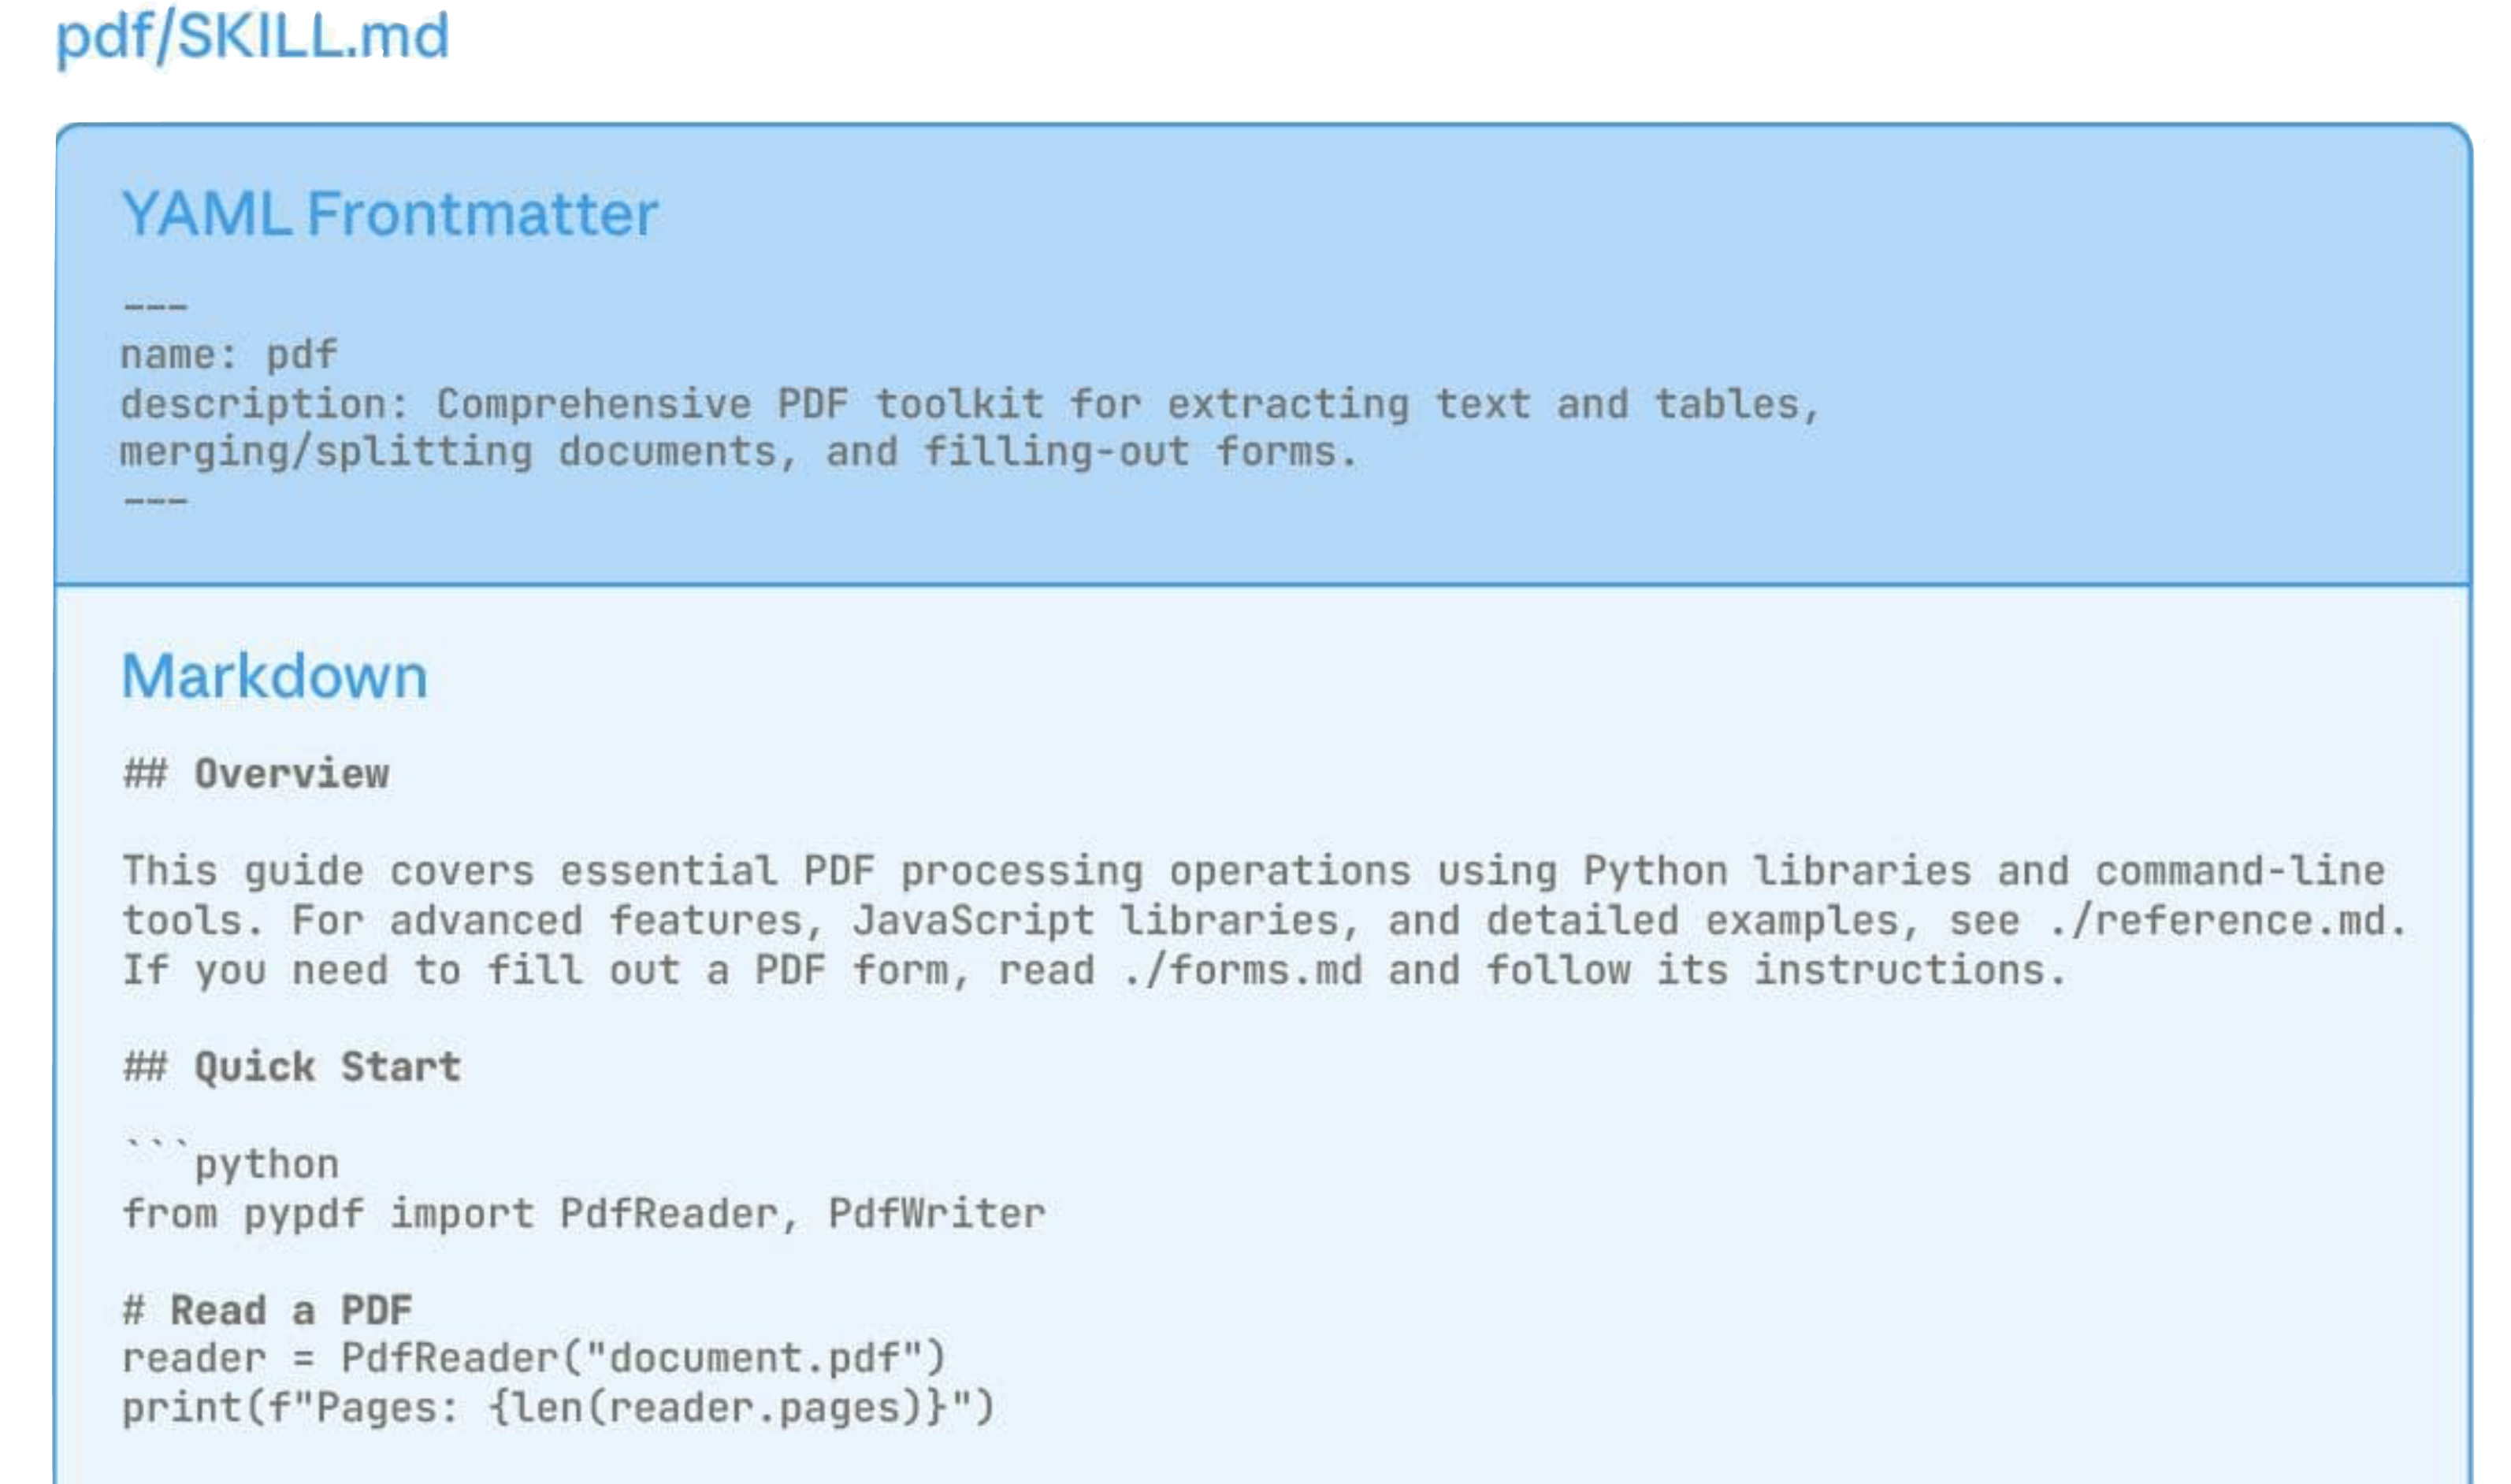
图 19 图左上方是技能名和简述,下面是详细说明。Agent 可以先用简述判断要不要读,碰到对应任务再取正文。 来源 [16]Anthropic · Agent Skills 与渐进披露
几种做法可以配合。先写事件日志,构造请求时排除不相关事件。较长的旧工具输出可以遮蔽,再把前半程浓缩成摘要。跨会话可能要用的事实存出去,新任务开工时查回来。用「写入、选择、压缩、隔离」这四个动作整理,可以看出自己缺的是哪一环[17]。
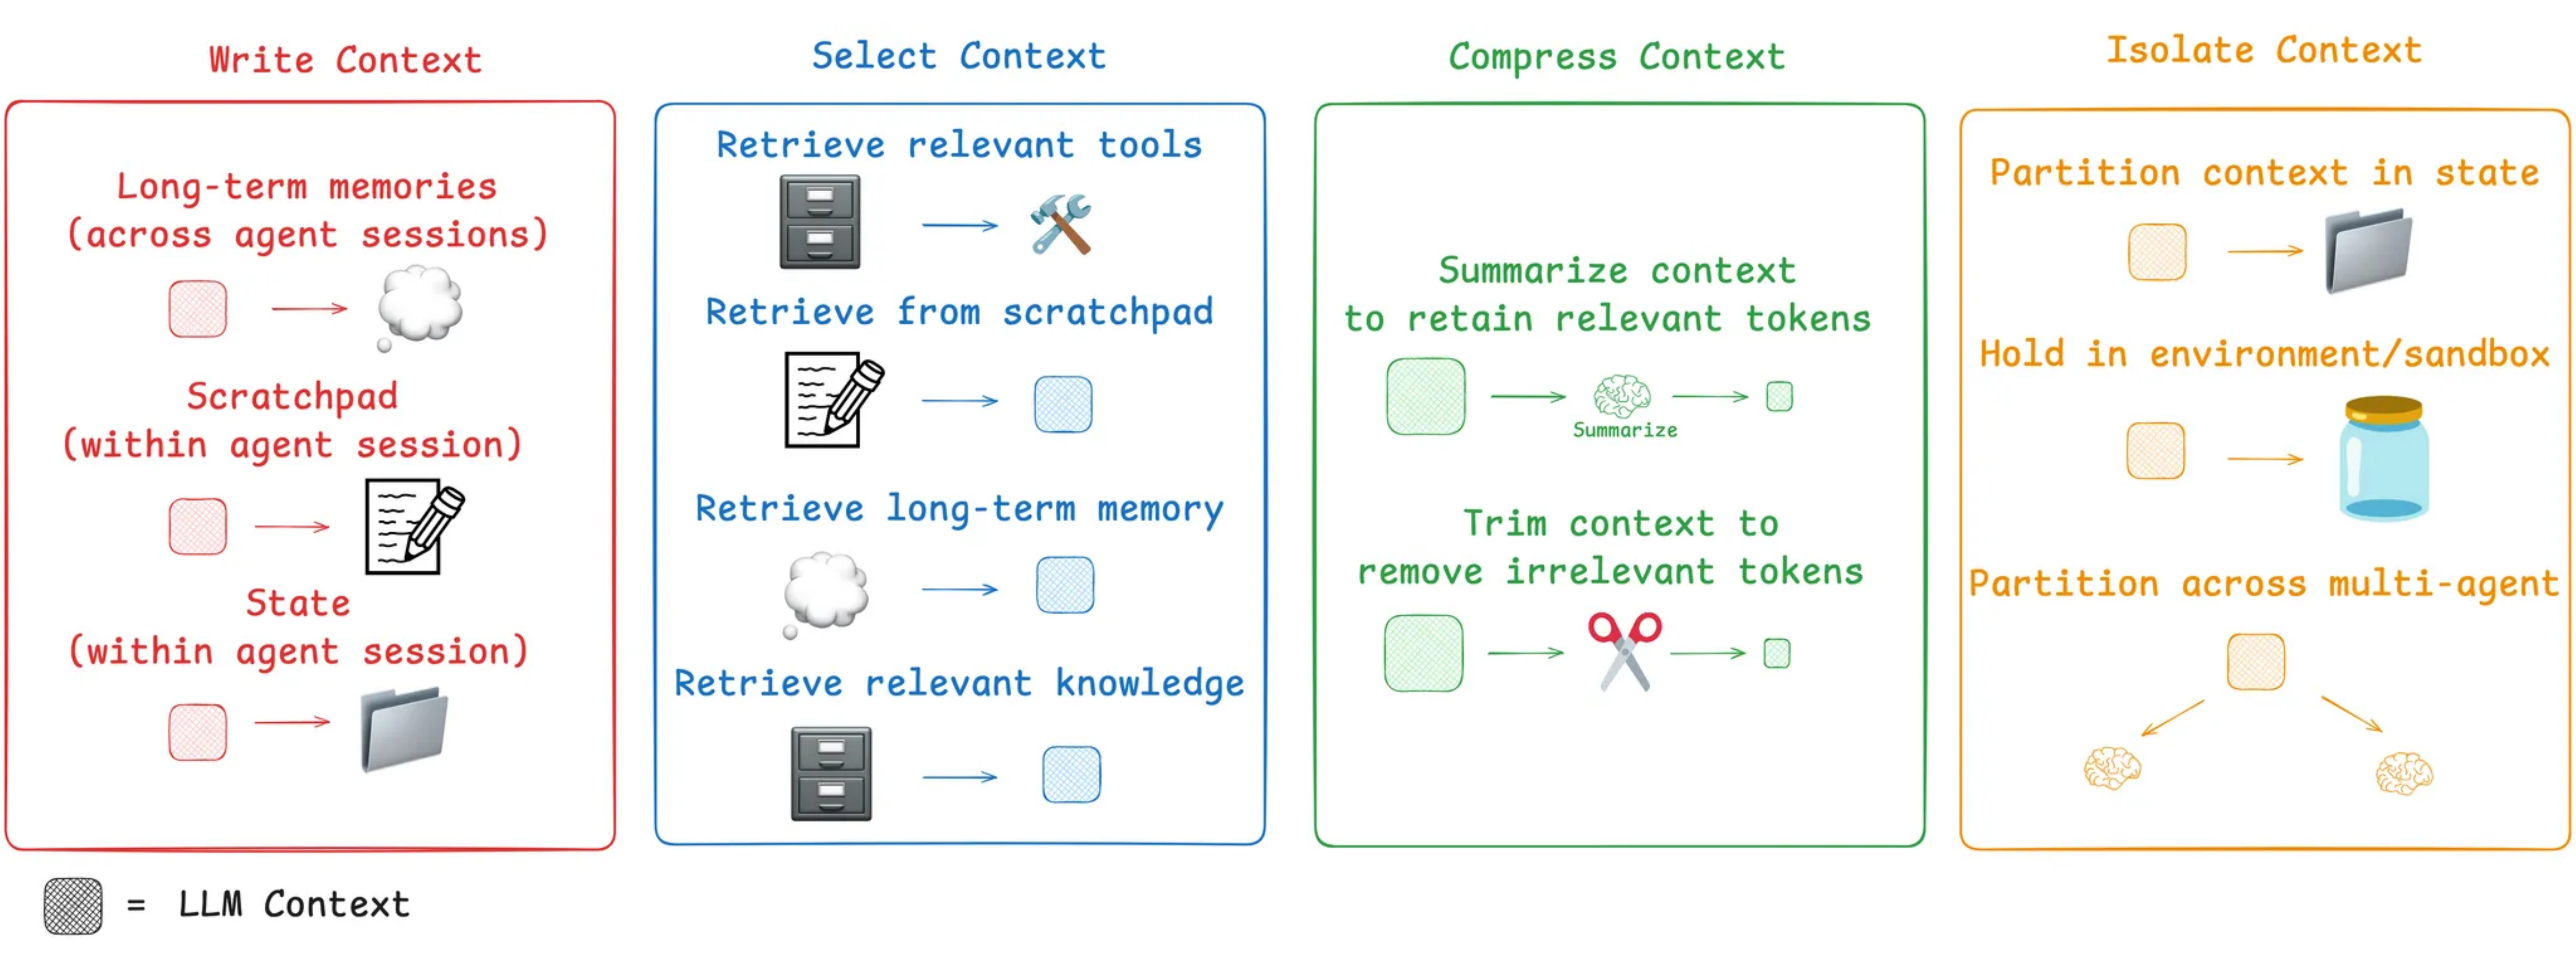
图 20 从左到右是写入信息、选择要读的材料、压缩或者截短、把上下文隔开。灰底表示会在某一步进入模型输入的部分。 来源 [17]LangChain · Agent 上下文工程分类
06 把这些概念放回 Pi 看一遍
上一讲提过 Pi。拿它做例子,能看到一个简洁的 Harness 里到底还剩什么。默认可以读、写、编辑文件和执行 Shell 命令,工具使用是 ReAct 式循环,模型发结构化请求,执行结果再回来。其他能力可以用扩展加。默认的运行权限跟着启动 Pi 的进程走,如果任务不该碰到某些文件或服务,需要在外层限制访问[18]。
会话历史可以组织成树。比如我先尝试一个实现方案,后来发现方向不对,可以回到那次决策前另开一条分支。运行新分支时,模型读到的是选中支线的上下文。原分支事件仍可供回看,已经在外部做过的写文件动作还要靠工作区状态或版本控制处理。
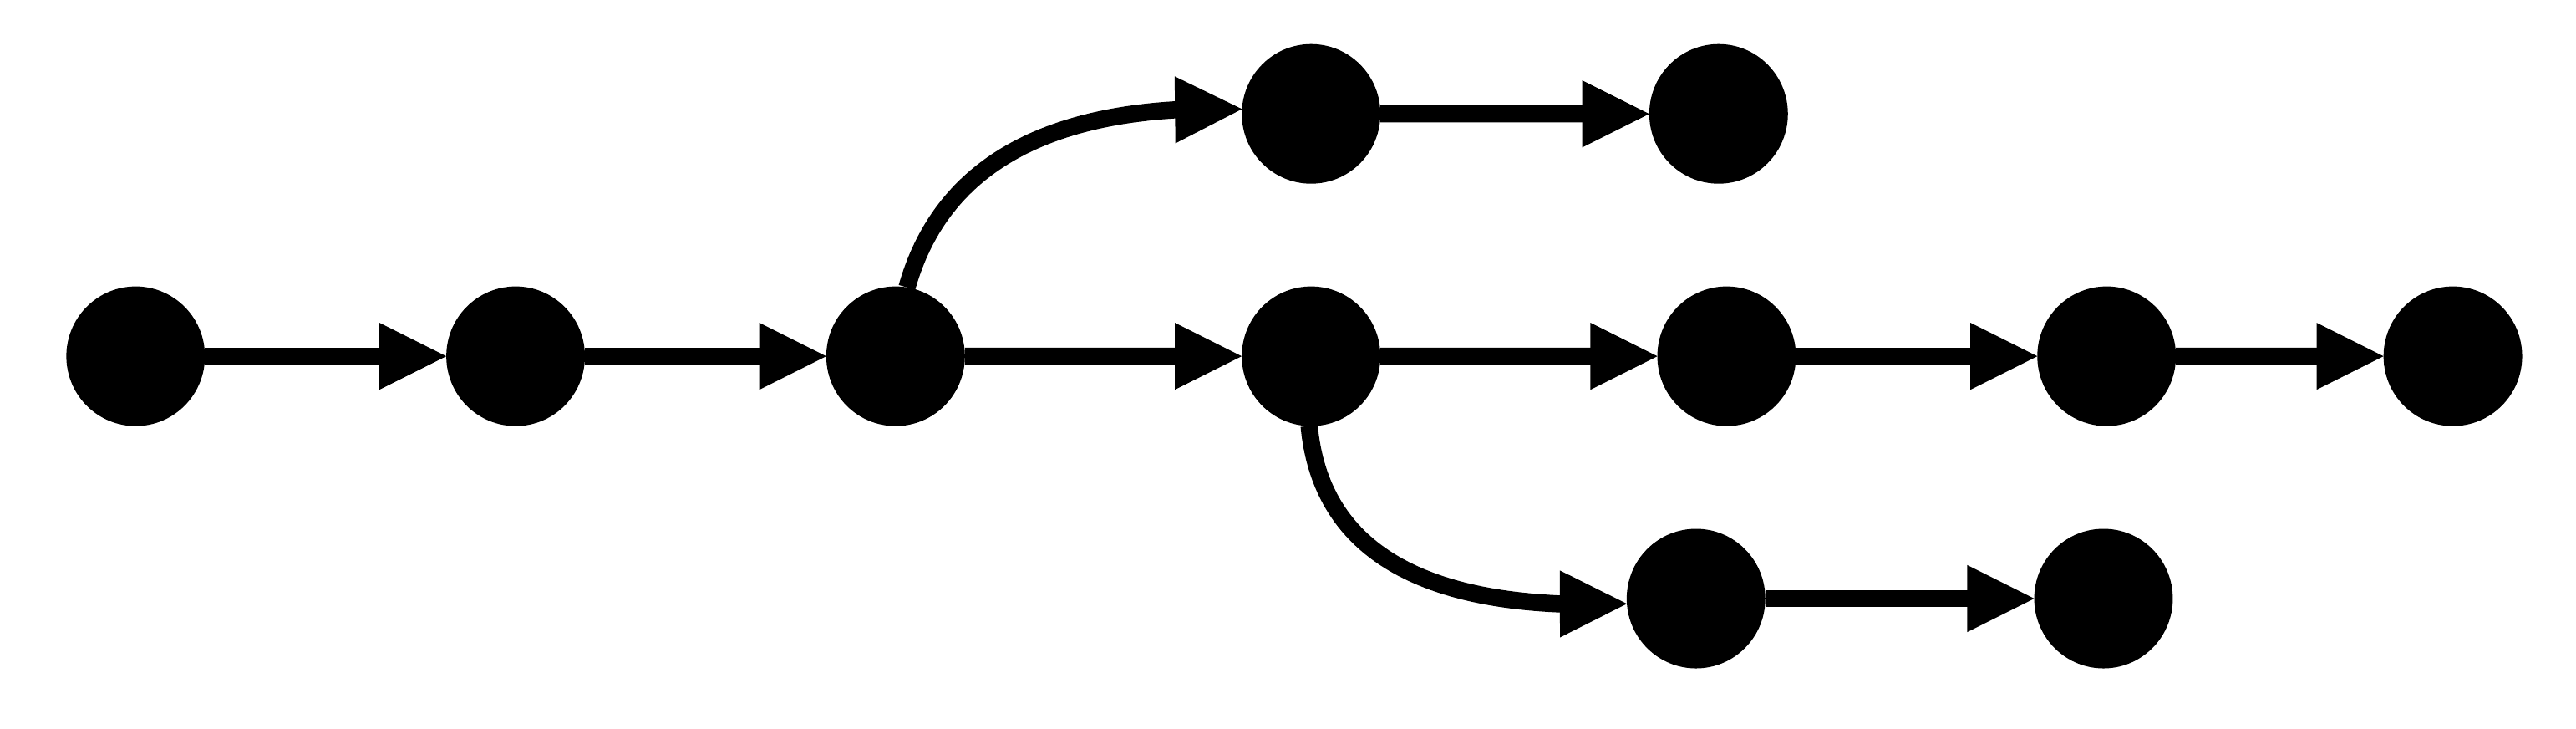
图 21 每个点代表历史里的一个位置。沿某条分支继续时,以这条路径构造上下文,可以回到早期节点走另一条支线。 来源 [18]Pi CLI 官方文档
历史长了就做压缩,把过去过程转成摘要,后面一段原样保留,再和系统提示拼起来。开始时也可以只加载技能简述,需要时再读正文。把这套机制和前面几节对上,Pi 仍然需要决定下一步、限制能做的动作、管理当前读到的消息。工具少,只是让这些决策更容易逐个看清楚[19]。
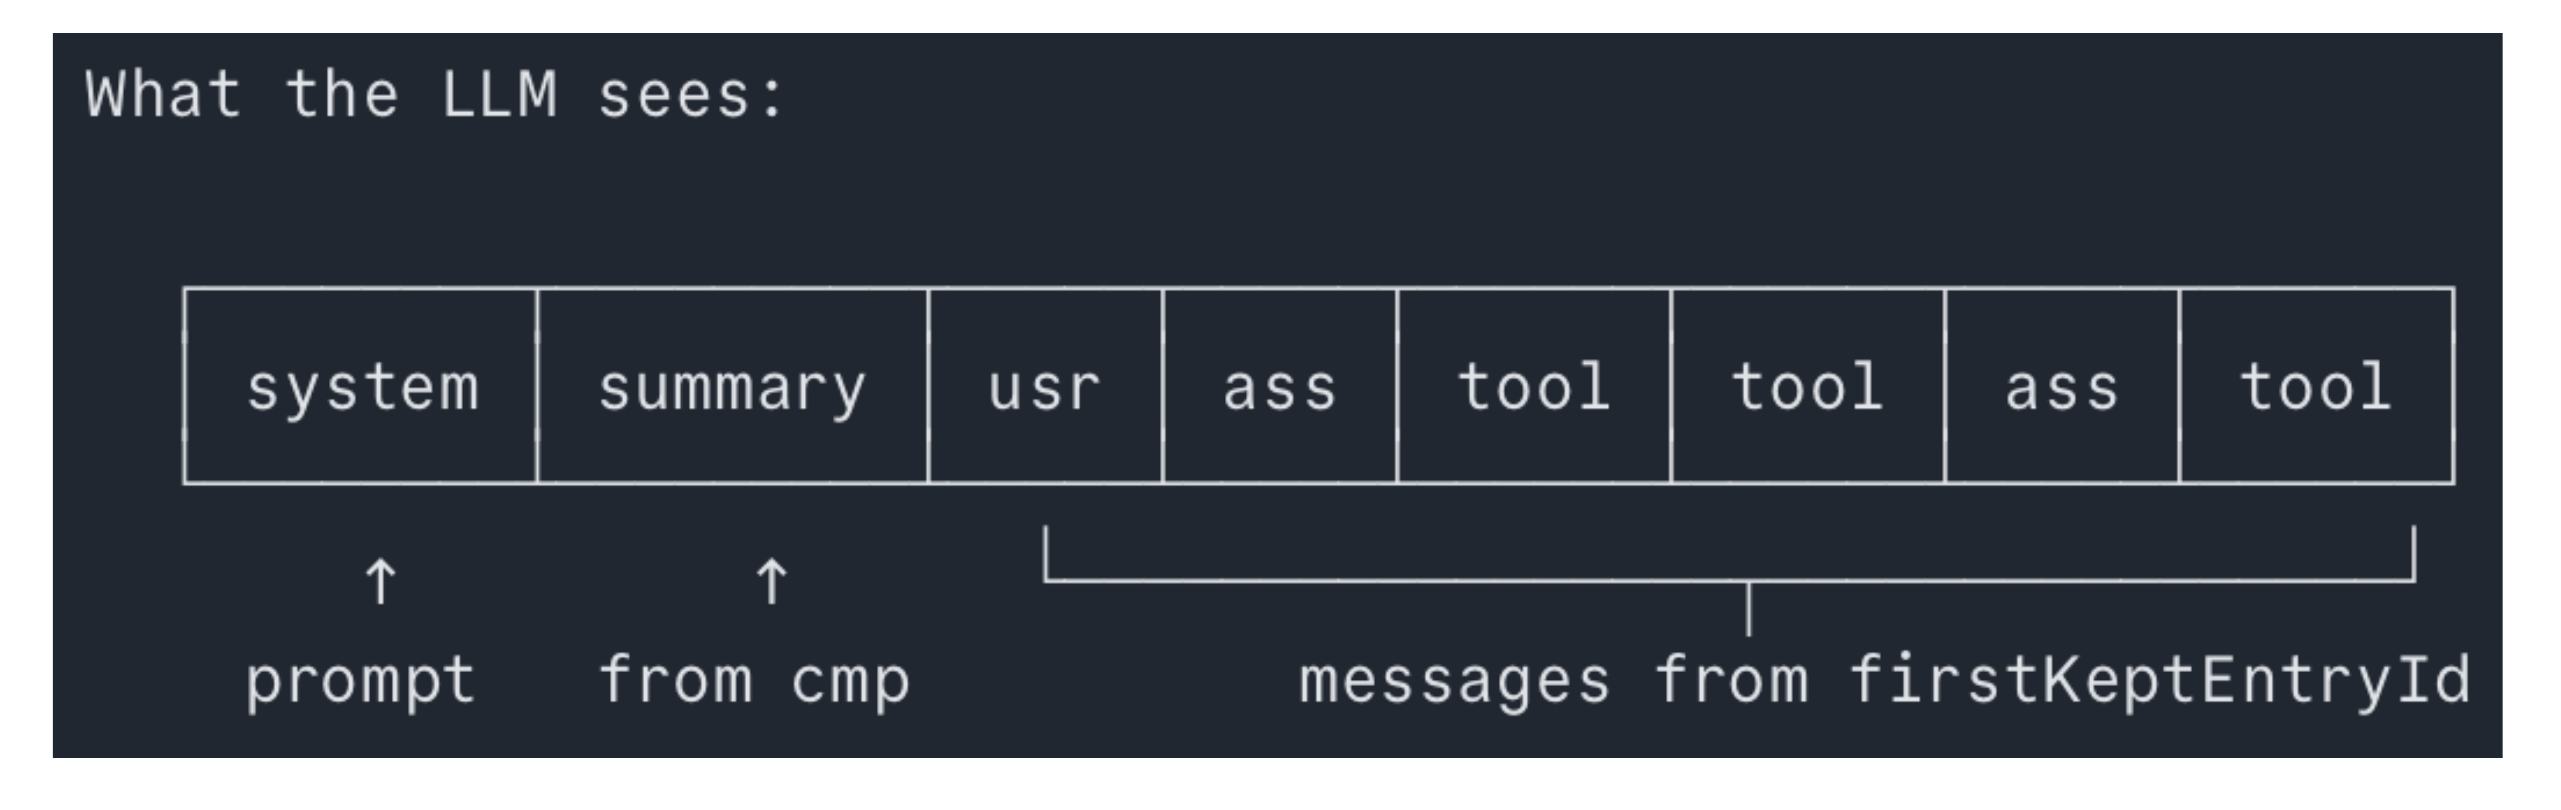
图 22 图下半部分,从左到右是系统提示、较早历史的摘要和保留原文的近期消息。分界点之后的用户、模型和工具记录照常出现。 来源 [19]Pi 上下文压缩文档
所以,要回答「Agent 和固定工作流怎么选」,我会从一个具体任务讲。能提前确定步骤,就写清步骤和校验。碰到靠结果决定下一步的活,再给模型工具和活动范围。任务会跑很久,就提前想好哪些事件要留、哪些内容下一轮还用得上。要是连「哪一步需要模型判断」都说不出来,可以先从把流程画出来开始。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]Anthropic · Building Effective Agents
https://www.anthropic.com/research/building-effective-agents
[3]STORM 原论文(2024)
https://arxiv.org/abs/2402.14207
[4]Archon 推理架构搜索论文(2024)
https://arxiv.org/abs/2409.15254
[5]ReAct 原论文(2022)
https://arxiv.org/abs/2210.03629
[6]Reflexion 原论文(2023)
https://arxiv.org/abs/2303.11366
[7]无外部反馈的推理自纠研究(2023)
https://arxiv.org/abs/2310.01798
[8]CRITIC 工具辅助纠错论文(2023)
https://arxiv.org/abs/2305.11738
[9]CodeAct 原论文(2024)
https://arxiv.org/abs/2402.01030
[10]ReWOO 原论文(2023)
https://arxiv.org/abs/2305.18323
[11]LLMCompiler 原论文(2023)
https://arxiv.org/abs/2312.04511
[12]Anthropic · Agent 上下文工程
https://www.anthropic.com/research/effective-context-engineering-for-ai-agents
[13]OpenHands SDK 事件架构文档
https://docs.openhands.dev/sdk/arch/events
[14]MemGPT 原论文(2023)
https://arxiv.org/abs/2310.08560
[15]The Complexity Trap 观察遮蔽研究(2025)
https://arxiv.org/abs/2508.21433
[16]Anthropic · Agent Skills 与渐进披露
https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
[17]LangChain · Agent 上下文工程分类
https://www.langchain.com/blog/context-engineering-for-agents
[18]Pi CLI 官方文档
https://docs.pi.dev/latest/cli
[19]Pi 上下文压缩文档
https://docs.pi.dev/latest/compaction