TechGuide「AI Agent 面试专题」第 7 篇 · Agent 记忆架构
正文约 5300 字 · 预计阅读 11 分钟
大家好,我是声哥。
上一篇讲了任务跑久了,怎么给模型留住关键上下文。这篇再往前想一步,如果用户隔几天又来,Agent 该记住什么?偏好变了,旧的那条又该怎么处理?这篇把记忆怎么存、什么时候读、做完怎么测讲清楚。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
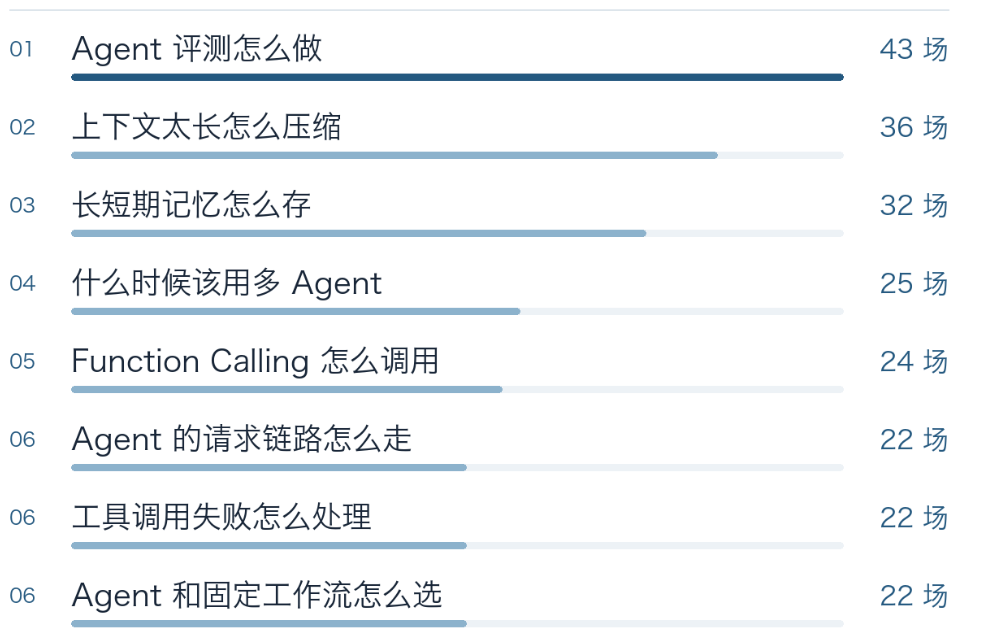
Agent 岗位面试高频题(138 场面试,同一轮同一题只计一次)
01 Agent 到底要记住什么?
假设你让 Agent 帮忙订机票,已经交代过目的地、时间,下一次打开对话,只说「把上次没订完的那张继续办了」。Agent 要是只看到这句话,最稳妥的做法就是从头问。它缺的是上次的进度和约束。有了历史记录,也得找回真正有用的几句,区分「已经查过某个航班」和「用户已经同意下单」。
还有两类东西容易丢。第一类是事实和偏好。比如用户之前爱吃某类食物,后来发现有食物过敏。两条记录都在,系统还要知道哪条现在适用。第二类是做事的方法。Agent 上次摸清了一个网站怎么查地点,下次要查同一地点的邮编,可以复用前半段操作,省得再探索一遍[2][3]。
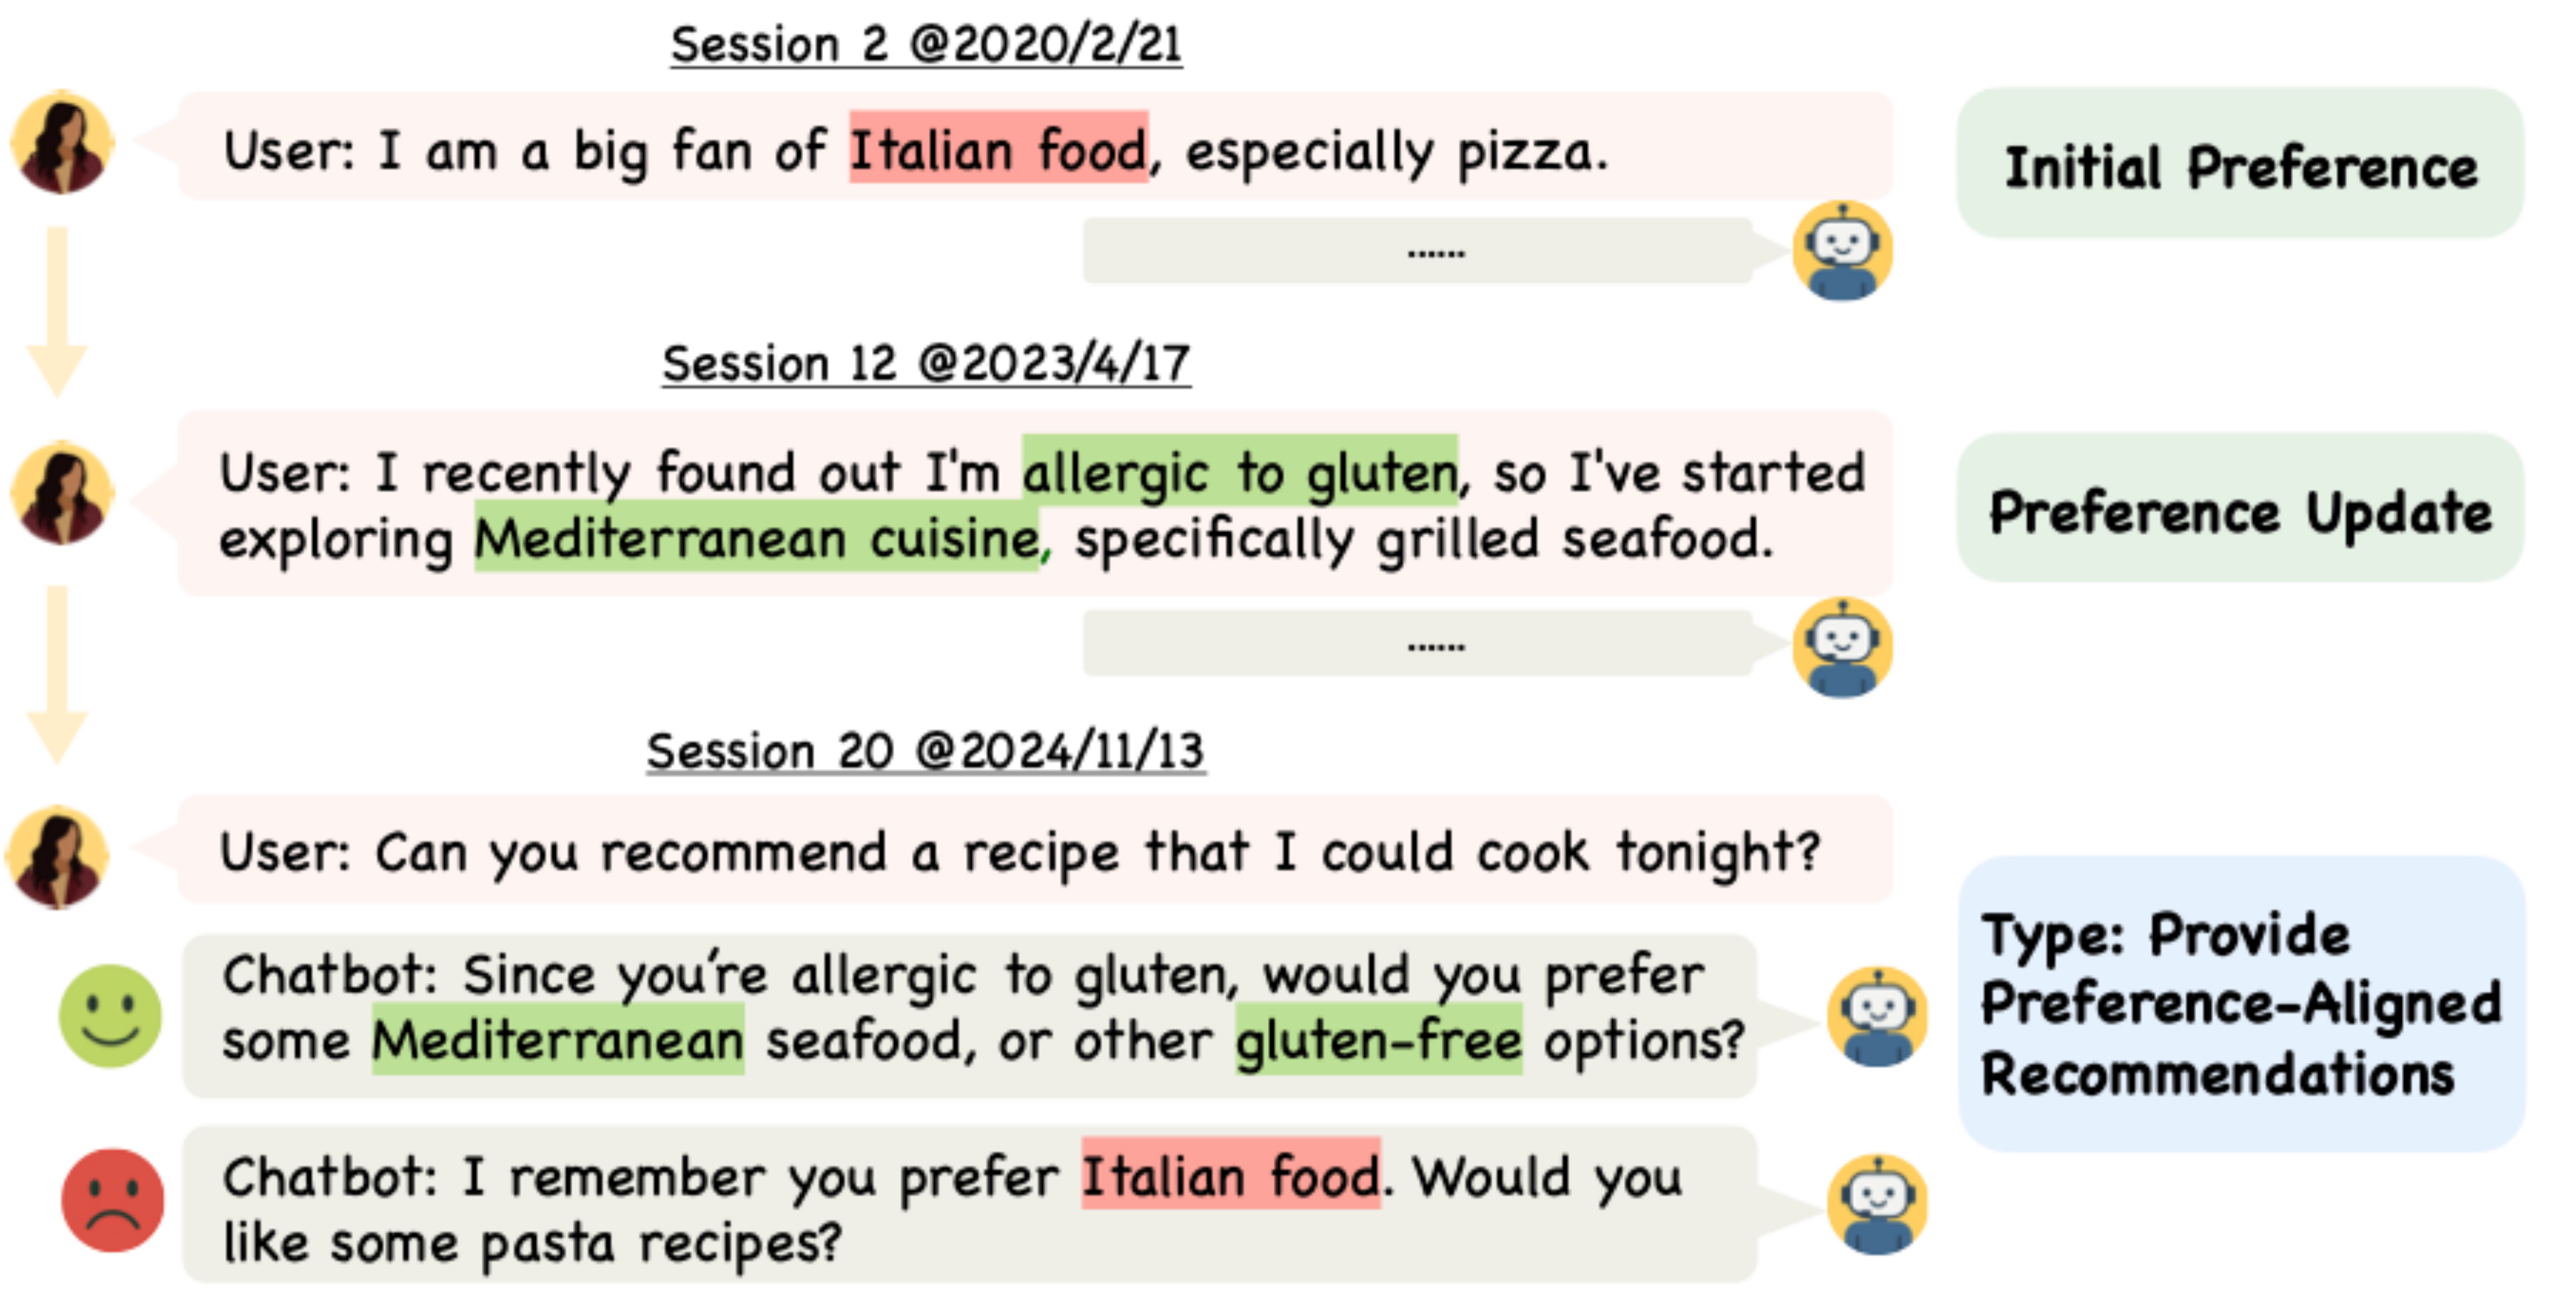
图 01 从上往下是三次对话。最早说喜欢意大利菜,后来补充了麸质过敏。最后问晚饭推荐时,新信息会改变哪些建议还能给。 来源 [2]PersonaMem 动态用户偏好评测(2025)
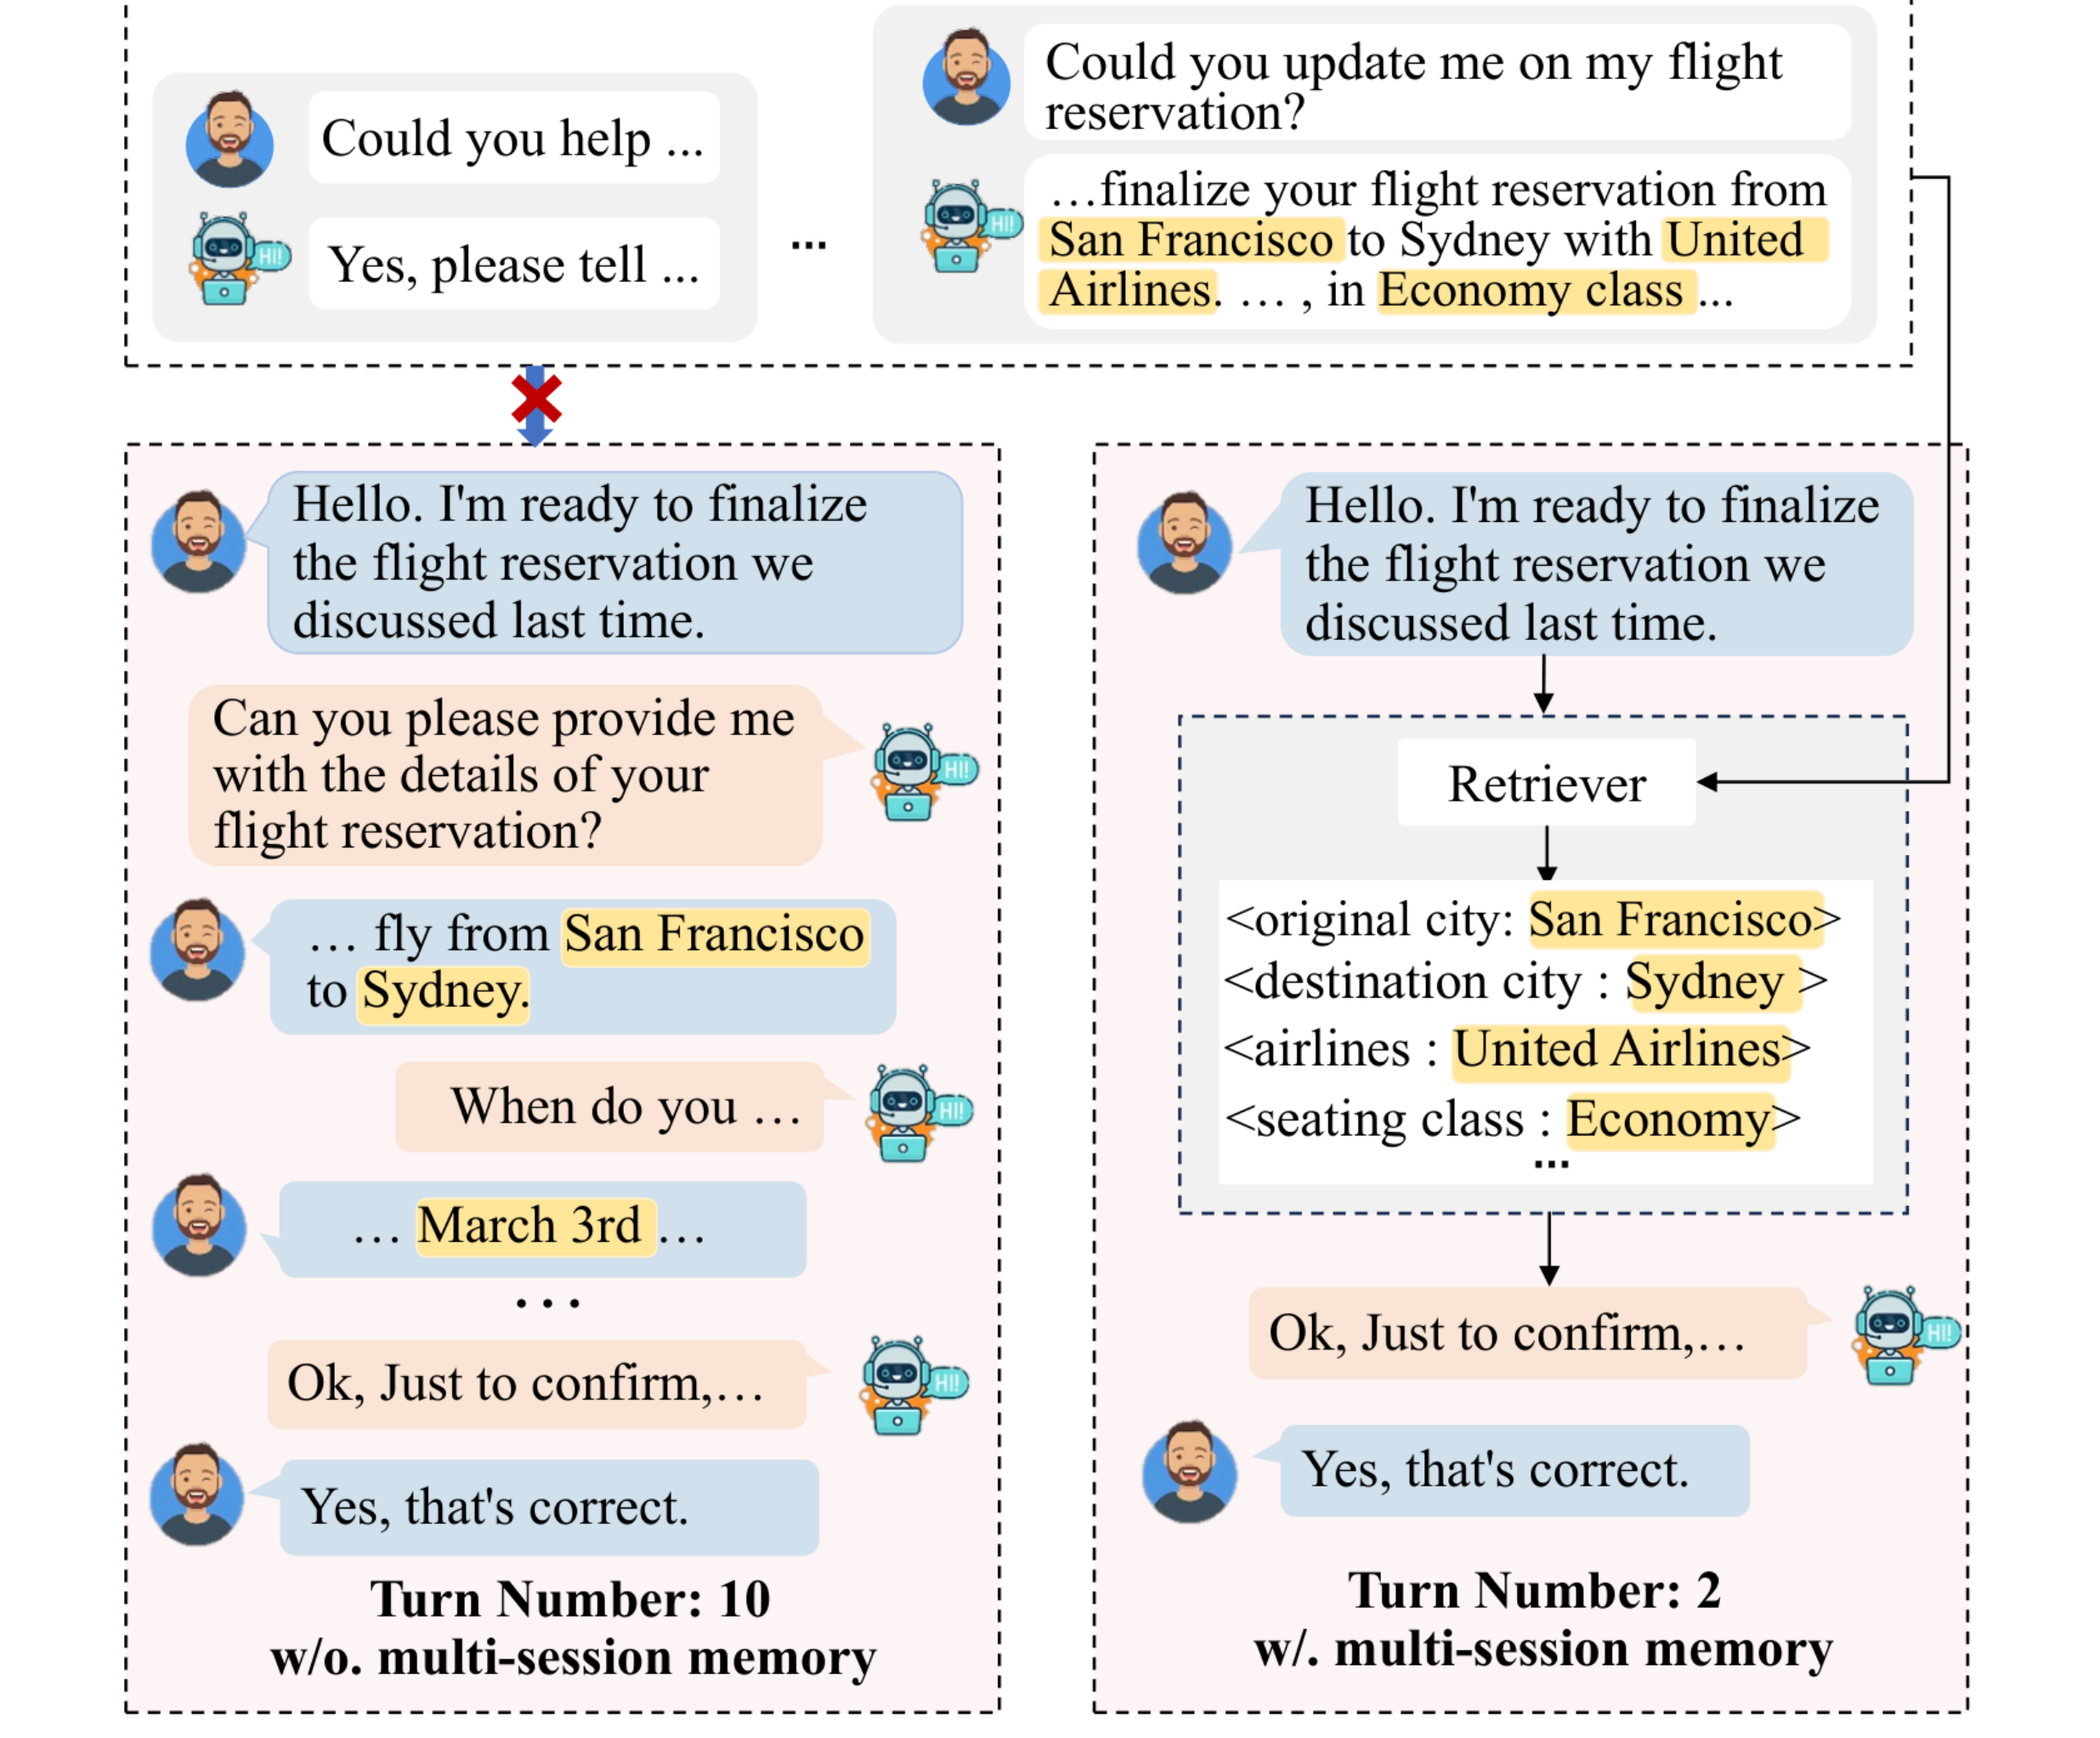
图 02 图左是重新追问预订条件的过程,右边把前几轮留下的目的地、时间和舱位找了回来。对话轮数少了,最后的预订确认仍然要走。 来源 [4]MemGuide 跨会话记忆选择研究(2025)
把这几个例子放在一起,做记忆系统要问三个问题。存什么,什么时机读写,用什么方式存和查。 用户换了一句话,规则触发也许就不同。把「只给建议,等我同意再动手」保存下来是一件事,真正执行操作前检查许可是另一件事。记忆可以提供依据,执行权限还得由应用来处理。
02 长短期记忆,先分清四种内容
CoALA 是一个描述语言 Agent 组成的框架。它把眼下要用的信息和可以长期保留的信息分开。后者又按内容分成情景、语义和程序性记忆。先认清这四种内容,后面看框架怎么存就容易了[5]。
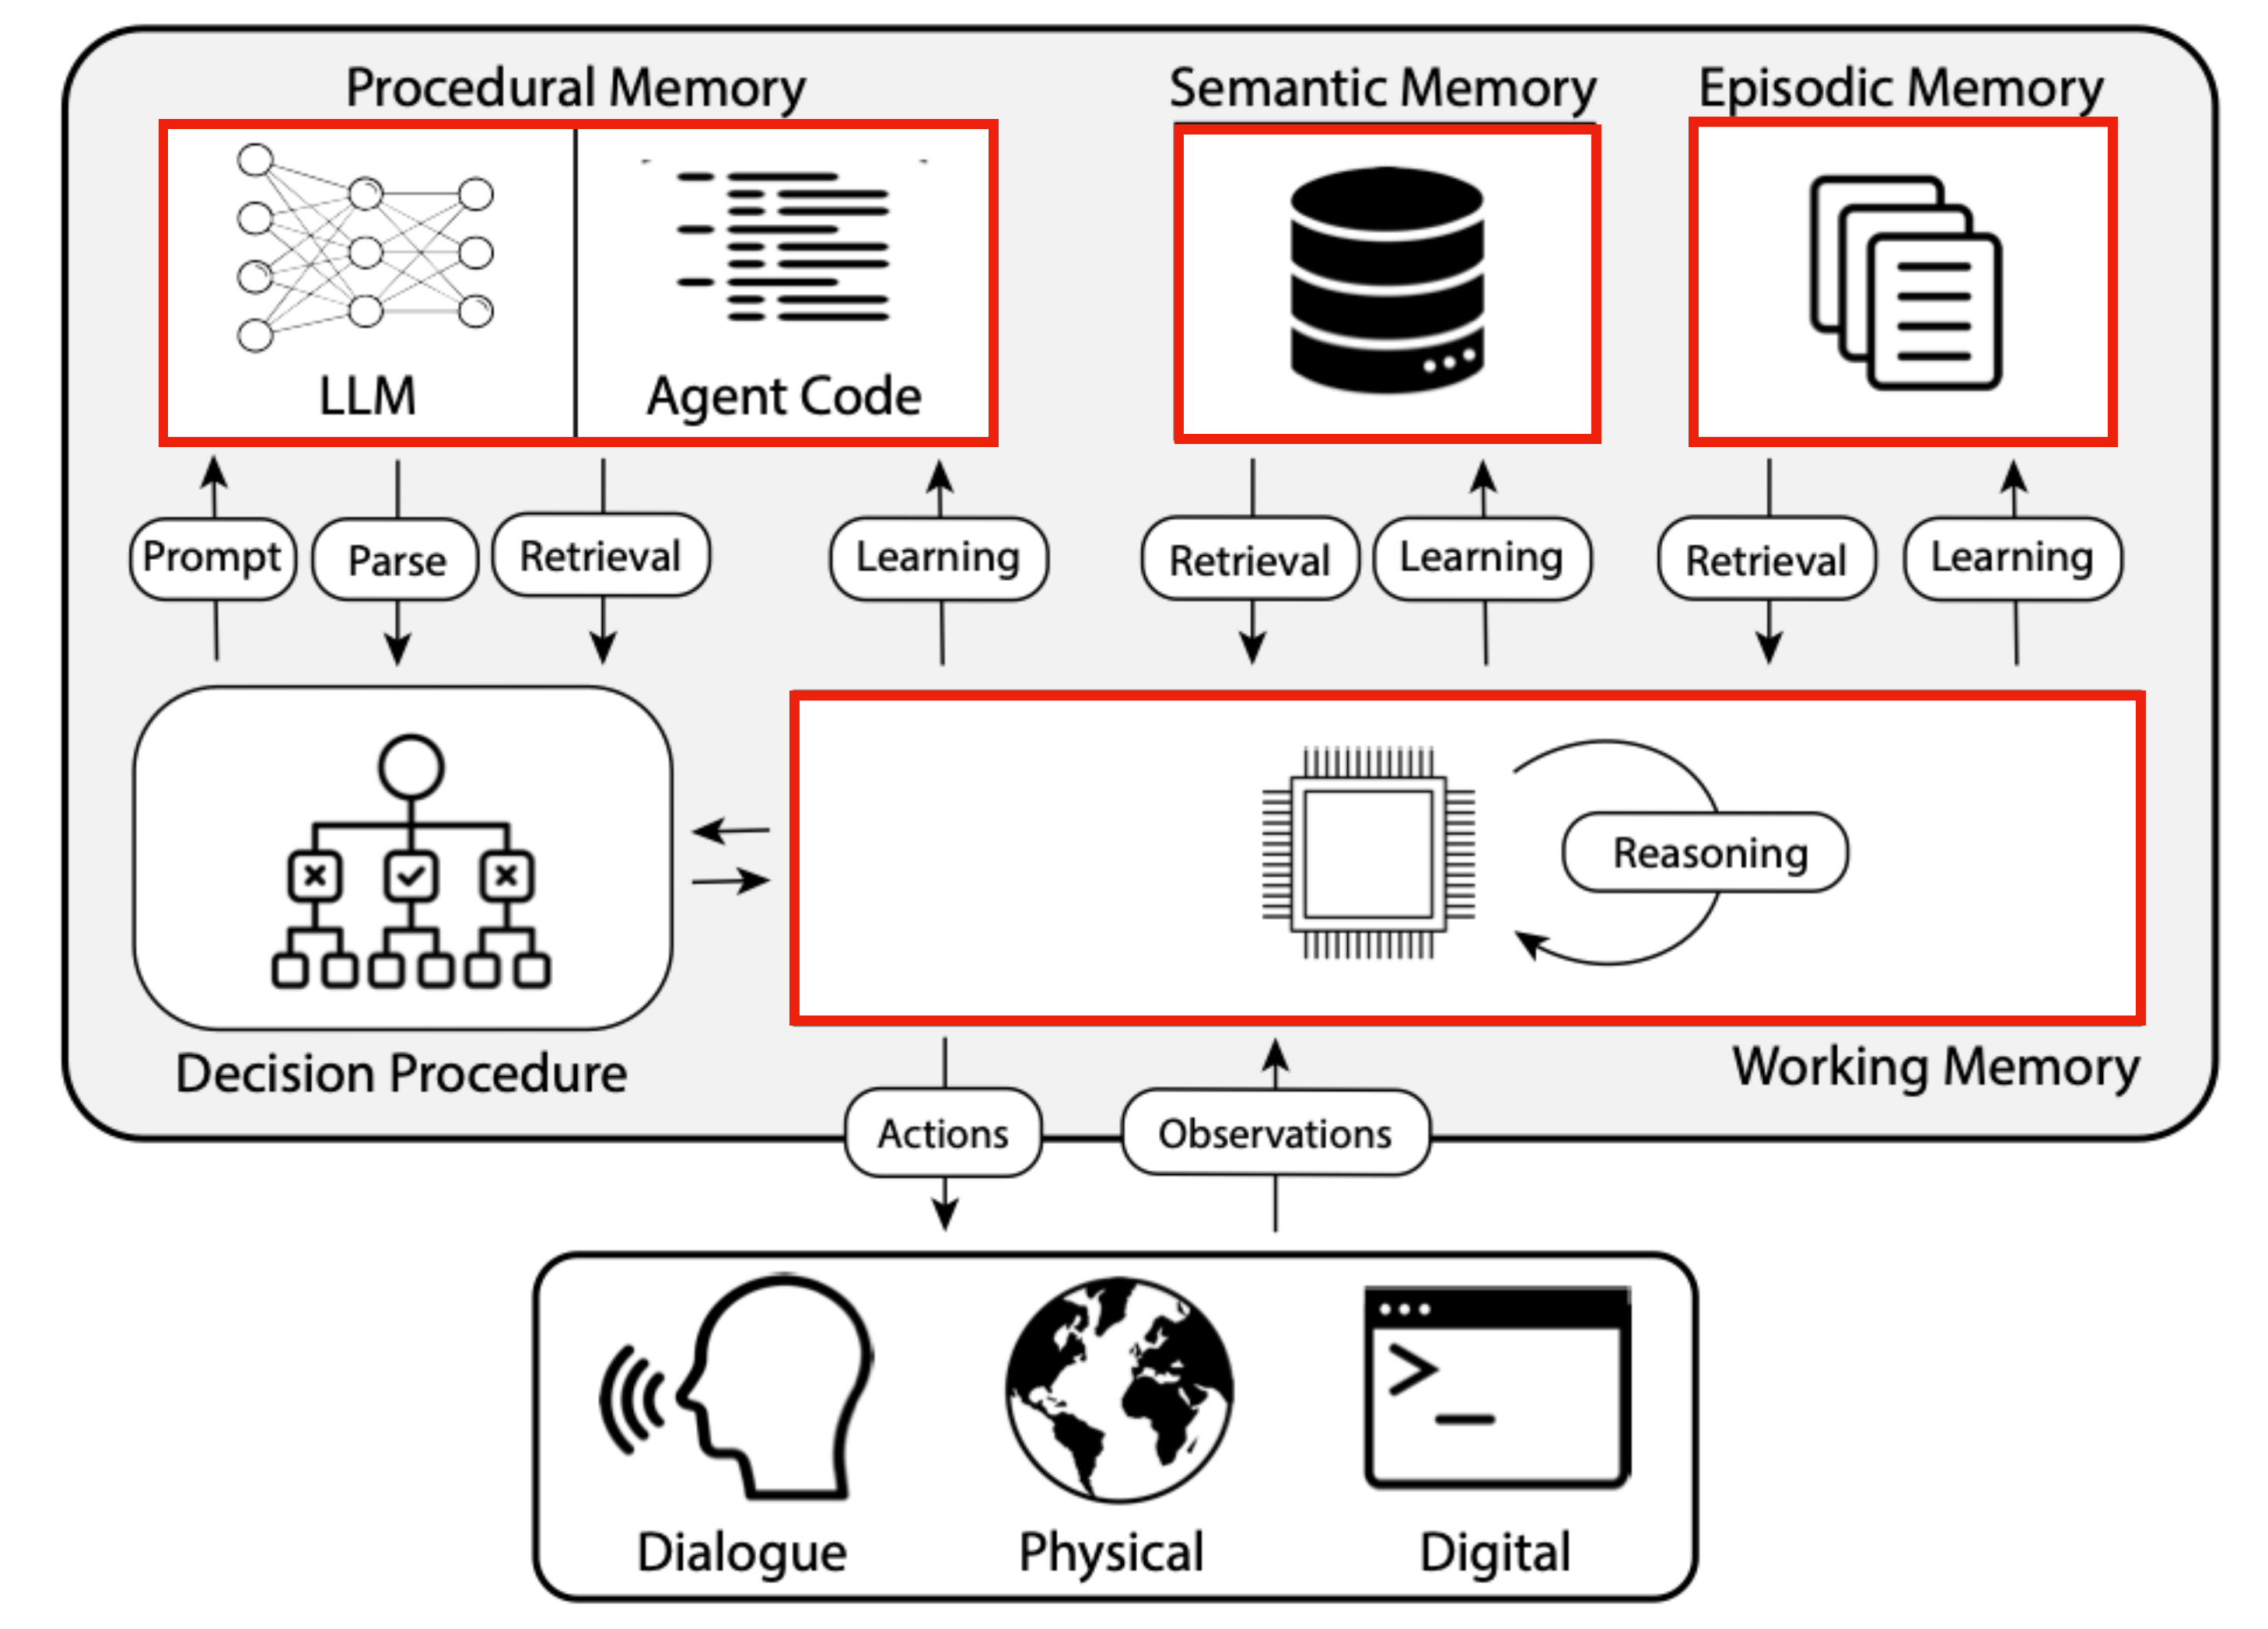
图 03 上面三块是程序性、语义和情景记忆。中间红框是工作记忆,它与决策、行动和环境观察一起构成当前运行过程。 来源 [5]CoALA 语言 Agent 认知架构(2023)
- 工作记忆(Working Memory)是 Agent 这一刻拿来判断的信息。用户刚说的话、这一步的目标、刚返回的工具结果往往会进入当前上下文。一次请求能看到多少,由上下文管理决定。
- 情景记忆(Episodic Memory)记发生过什么。比如旧对话、调用顺序和当时的返回结果。今天追问「上次是哪一步失败」,可以回头查日志。
- 语义记忆(Semantic Memory)记抽取出来的事实、规则和偏好。比如「用户平日出差习惯选上午的航班」。它可能来自多次对话,可以带上来源和时间。
- 程序性记忆(Procedural Memory)记怎么做事。比如整理会议纪要时先找决定项、再列负责人和截止时间。这种方法可以反复用,也可以写成技能或可执行的程序。
四种信息在一项任务里经常同时出现。你正在处理哪封邮件,是工作记忆里的任务状态。昨天的完整来信是情景记忆。从来信中提取出的团队约定属于语义记忆。处理这类邮件通常要走哪几步,则是程序性记忆。要回看当时原话,可以查情景记忆。只要知道现在的约定,可以读语义记忆。两者最好能顺着来源对上。
还可以按记忆放在哪里区分。参数记忆是训练后留在模型权重里的知识和能力,微调可以改变它。通过上下文提供的记忆是在使用时把资料取出来、装进请求。刚学到的新偏好、原始聊天记录或某一次任务的处理步骤,都可以保存在外部,下一次按需送进去。一条旧记录找回来以后,才进入这轮工作记忆。发现记错了,可以改外部记录和检索规则。
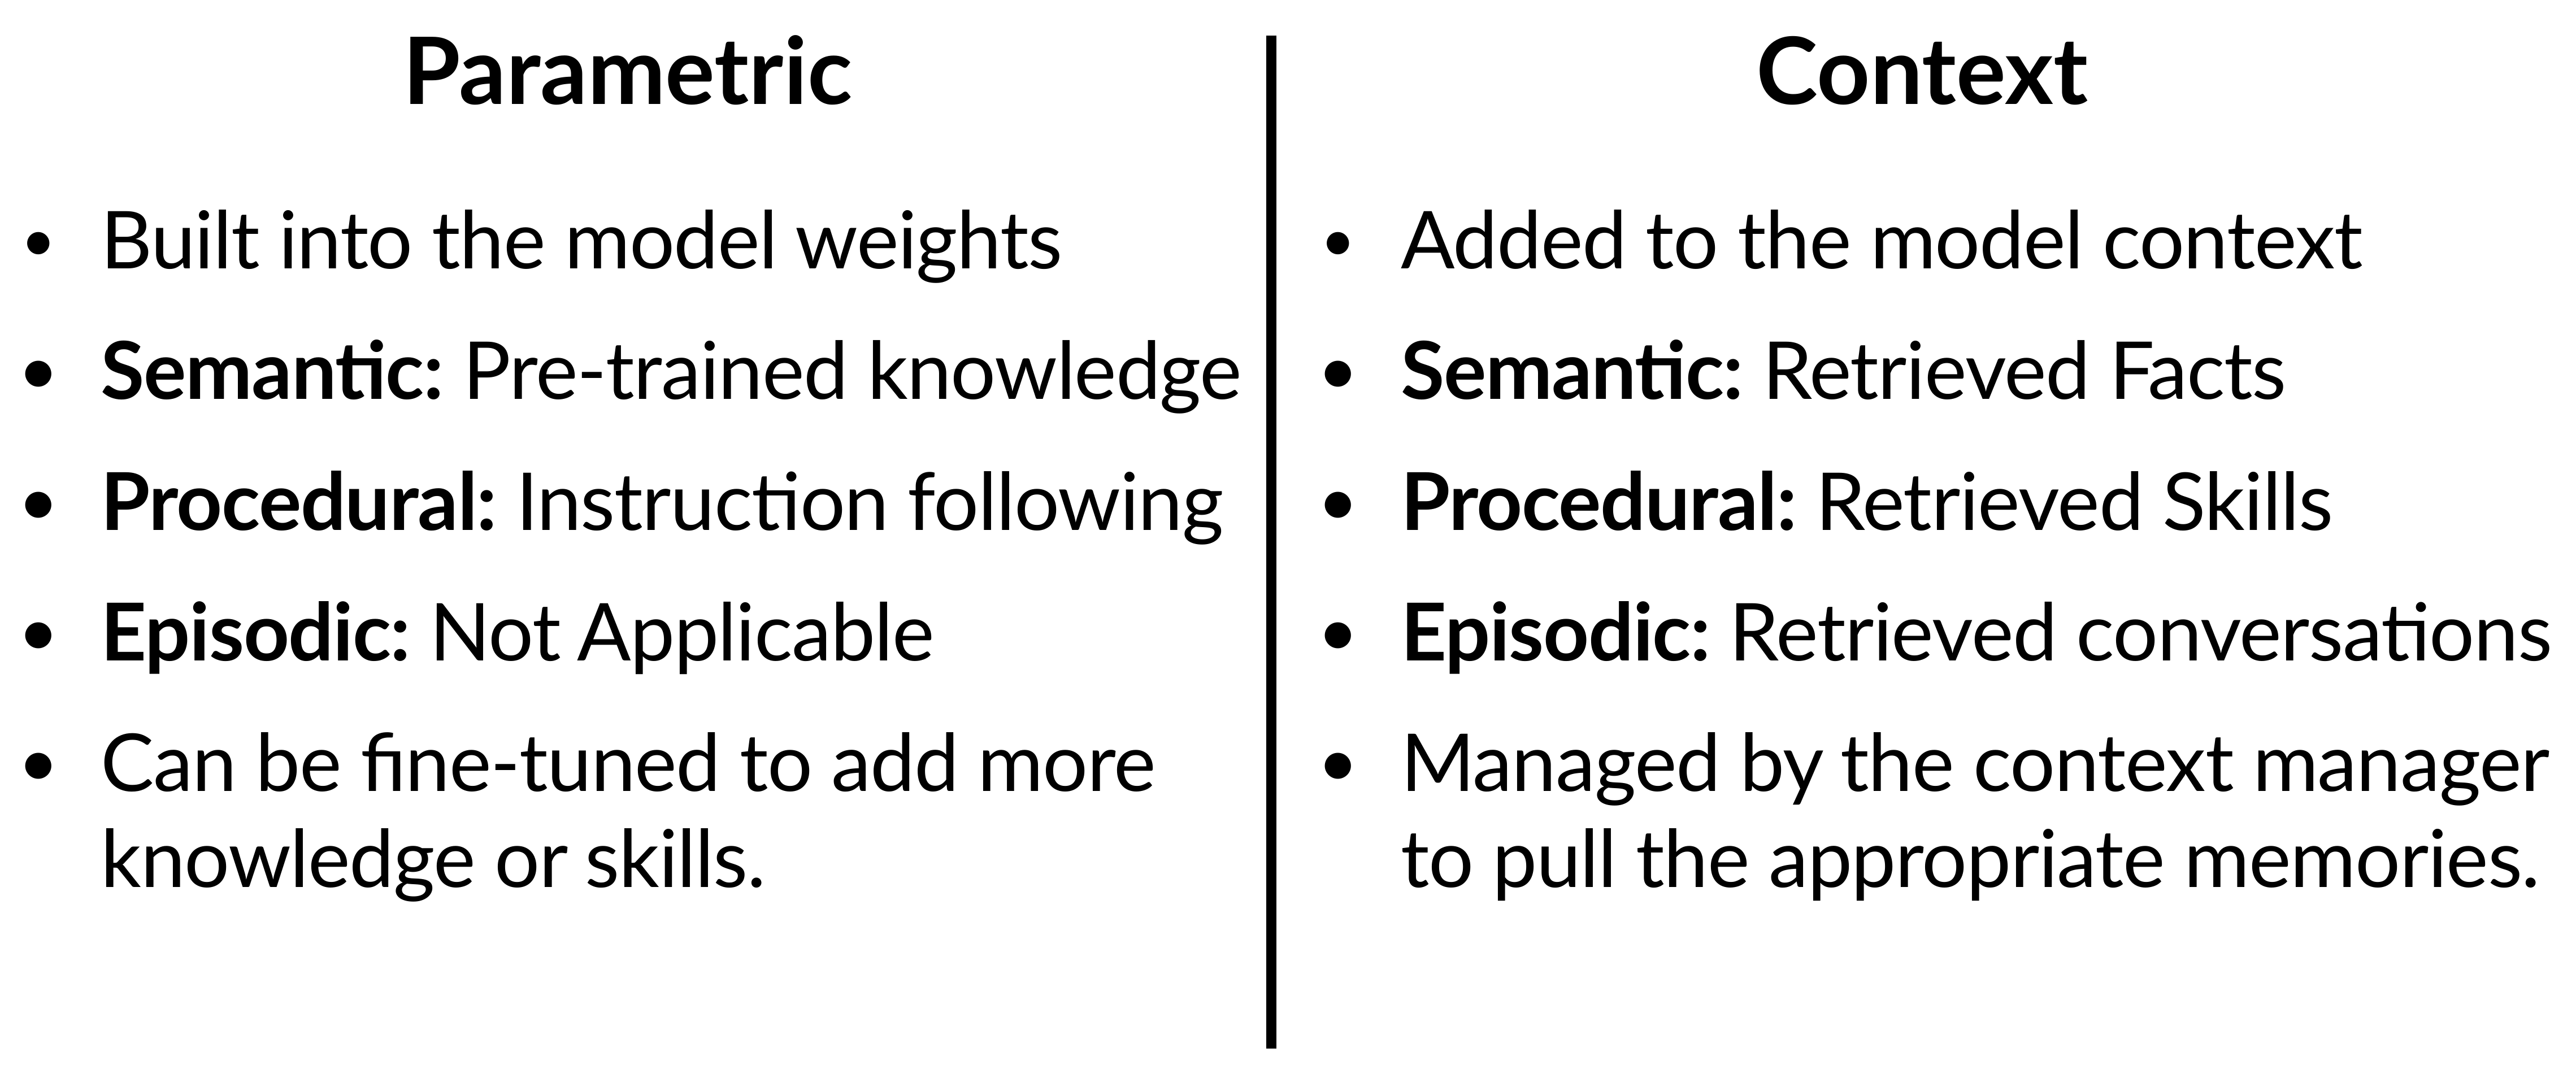
图 04 左侧是训练后留在模型参数里的知识和能力,右侧是运行时按需取回的事实、技能和历史。右侧三类都可以由上下文管理器挑选。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[5]CoALA 语言 Agent 认知架构(2023)
03 文件、数据库、知识图谱分别怎么存?
知道要存什么之后,我会再看什么时候写。用户明确说「记住这个」可以在当前任务里写。会话结束时可以由后台归纳。日程真正确认后,也可以用业务事件更新状态。读也类似,某个步骤明知道要核对偏好,可以由程序先查。开放任务可以把查询做成工具,交给 Agent 按需调用。触发时机和底层存储是两件事。
最直接的一种是文件系统。把技能写进 Markdown,原始轨迹按日期落盘,偏好和知识放在不同目录。人可以打开文件核对,Agent 可以按路径或关键字找。目录层级本身也能表达范围,例如个人、项目和历史任务分开。条目多了要考虑检索和并发写入。一个旧文件留在原处,也可能重复进入某一次新的请求。
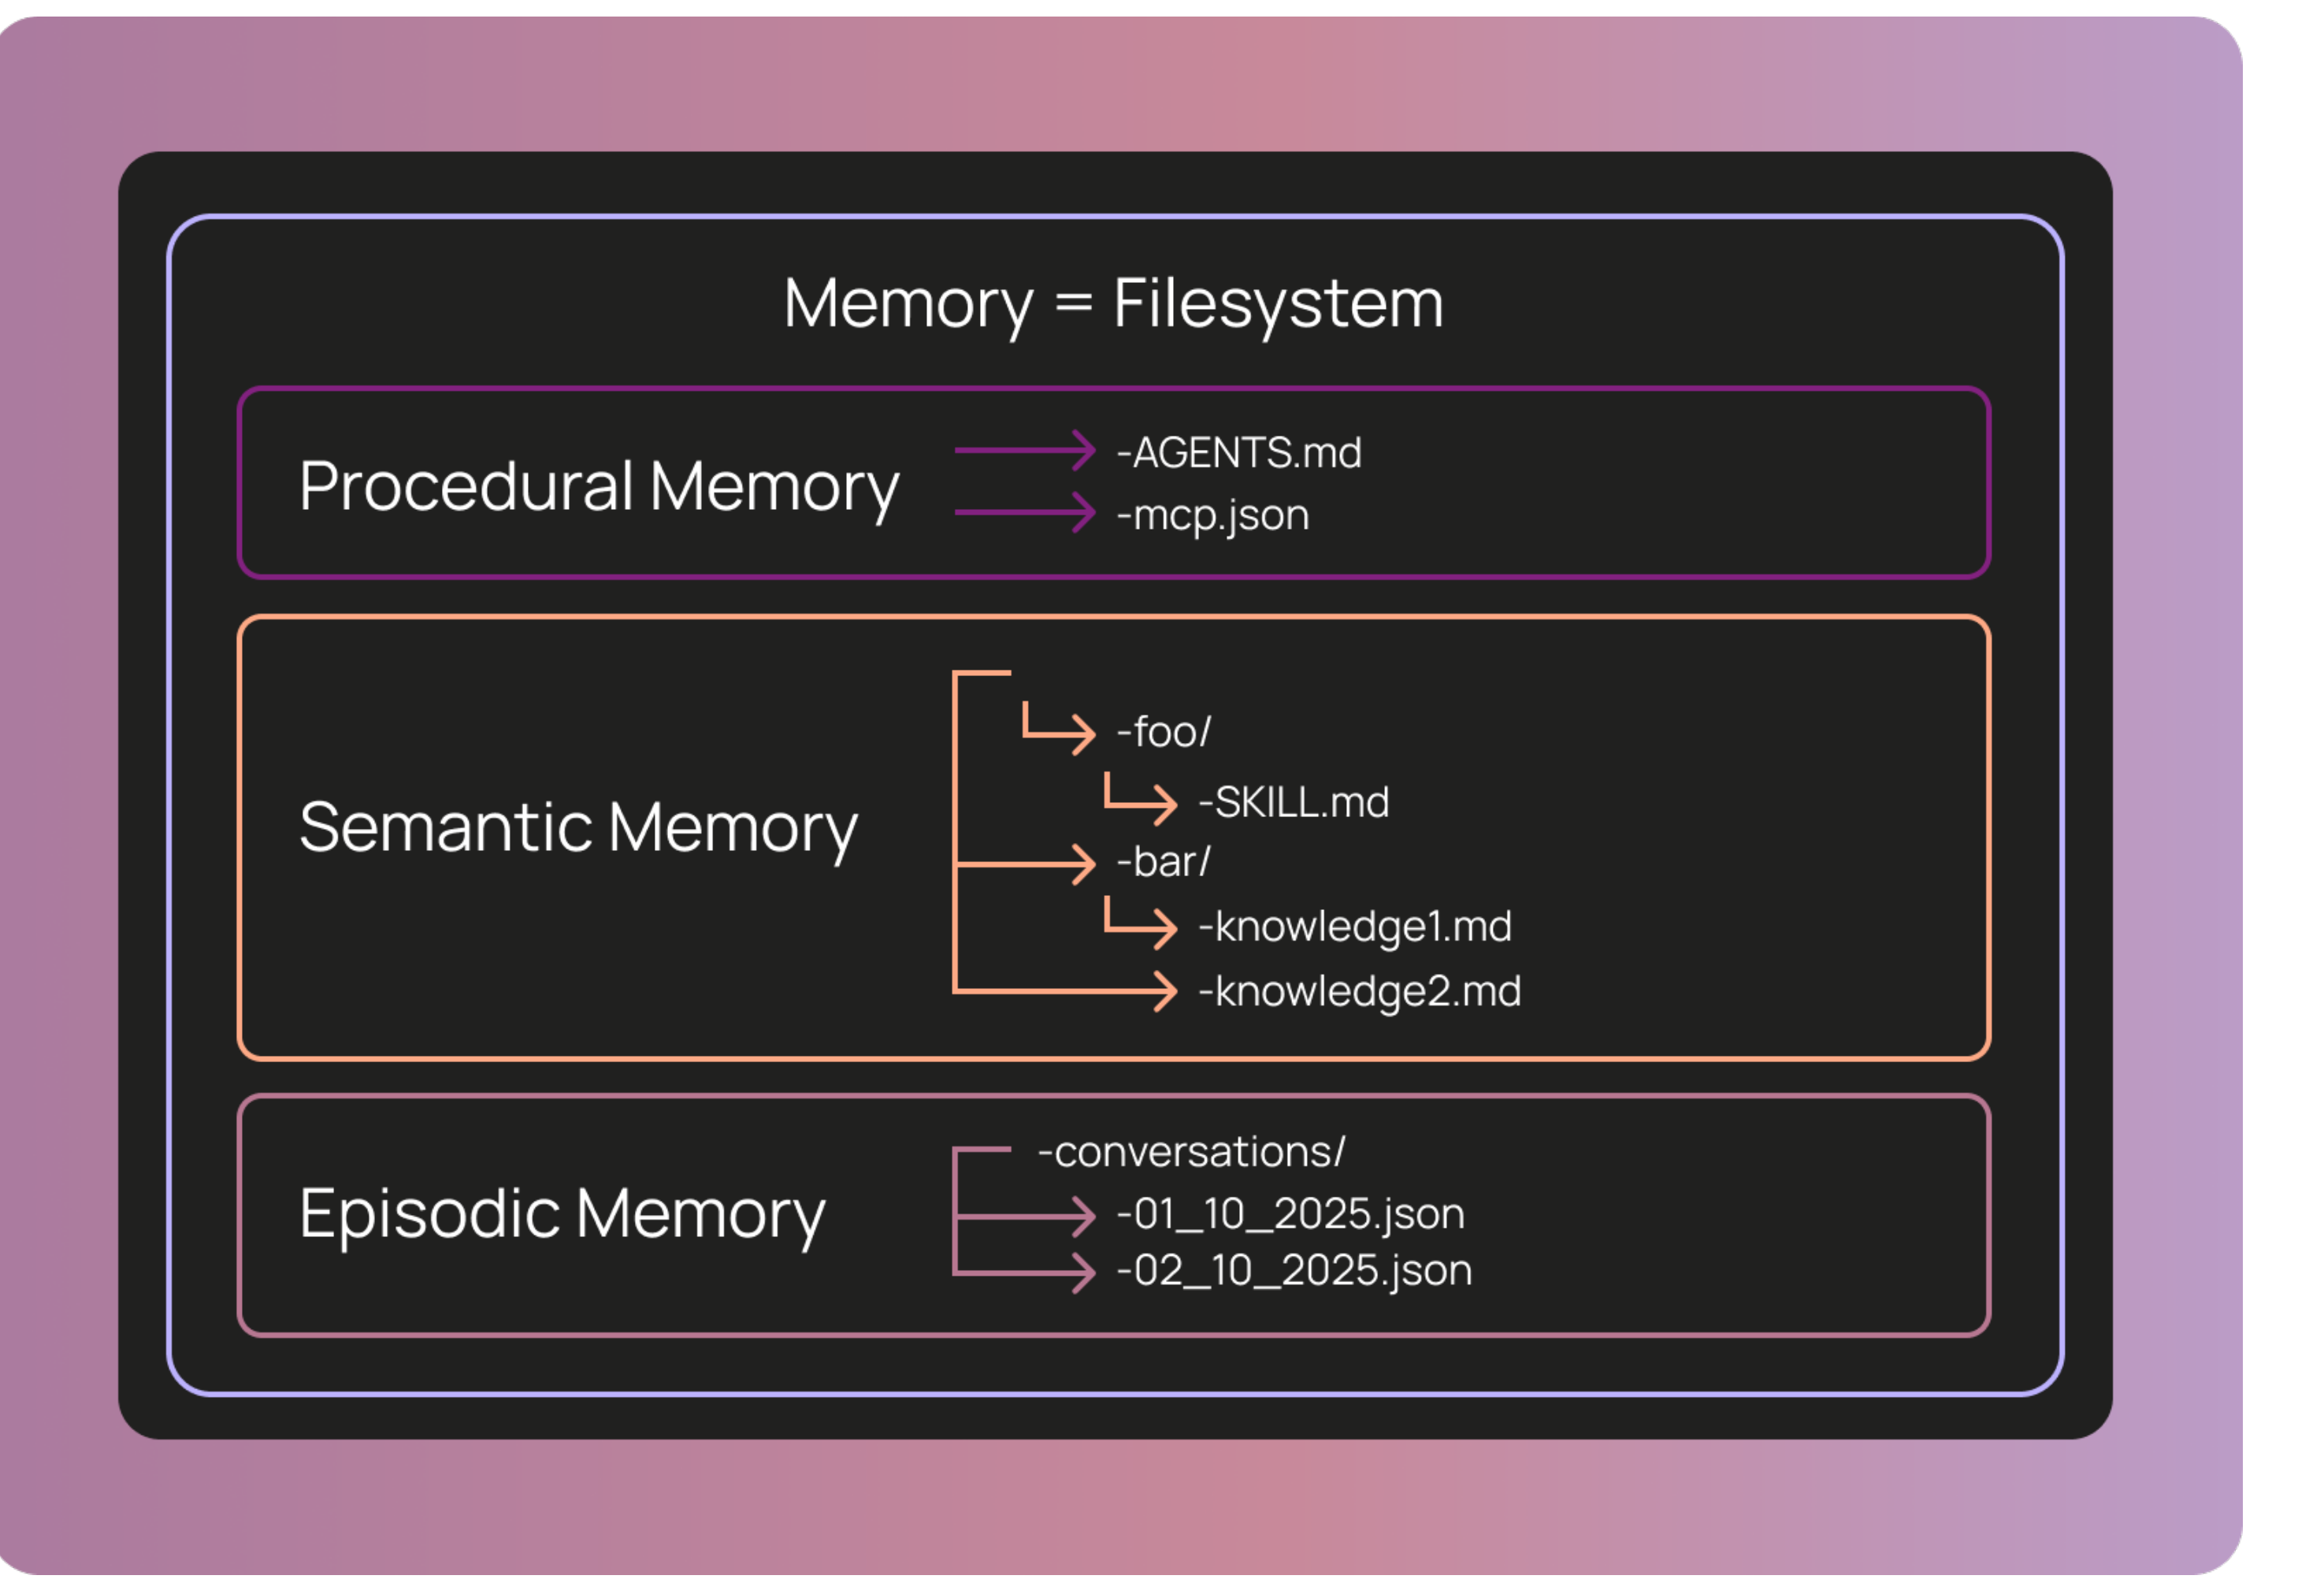
图 05 文件树按内容分开。上面是程序性说明,中间是知识文件,下面是对话记录。不同类型的记忆能沿不同的路径查找。 来源 [21]LangChain 文件式记忆设计说明
第二种是数据库。如果知道用户、任务、时间,先用元数据过滤,SQLite 这类数据库就能做。查某个产品名、订单号,可以用精确匹配或关键词检索。用户换一种说法,向量检索更有机会从语义上找回旧信息。很多系统可以先按权限和时间缩小范围,再组合关键词和向量结果。第三篇讲过的召回和重排,也适用于找记忆。
第三种是知识图谱。例如要记「某人现在属于哪个团队」,可以把人、团队和所属关系分开存,再在关系上标它什么时候开始、什么时候失效。Zep 用带时间信息的图,把对话里的关系和已有数据接起来,便于查当前状态和变化过程。图能把关系说清楚,也要为实体归并、冲突处理和更新付出成本[6]。
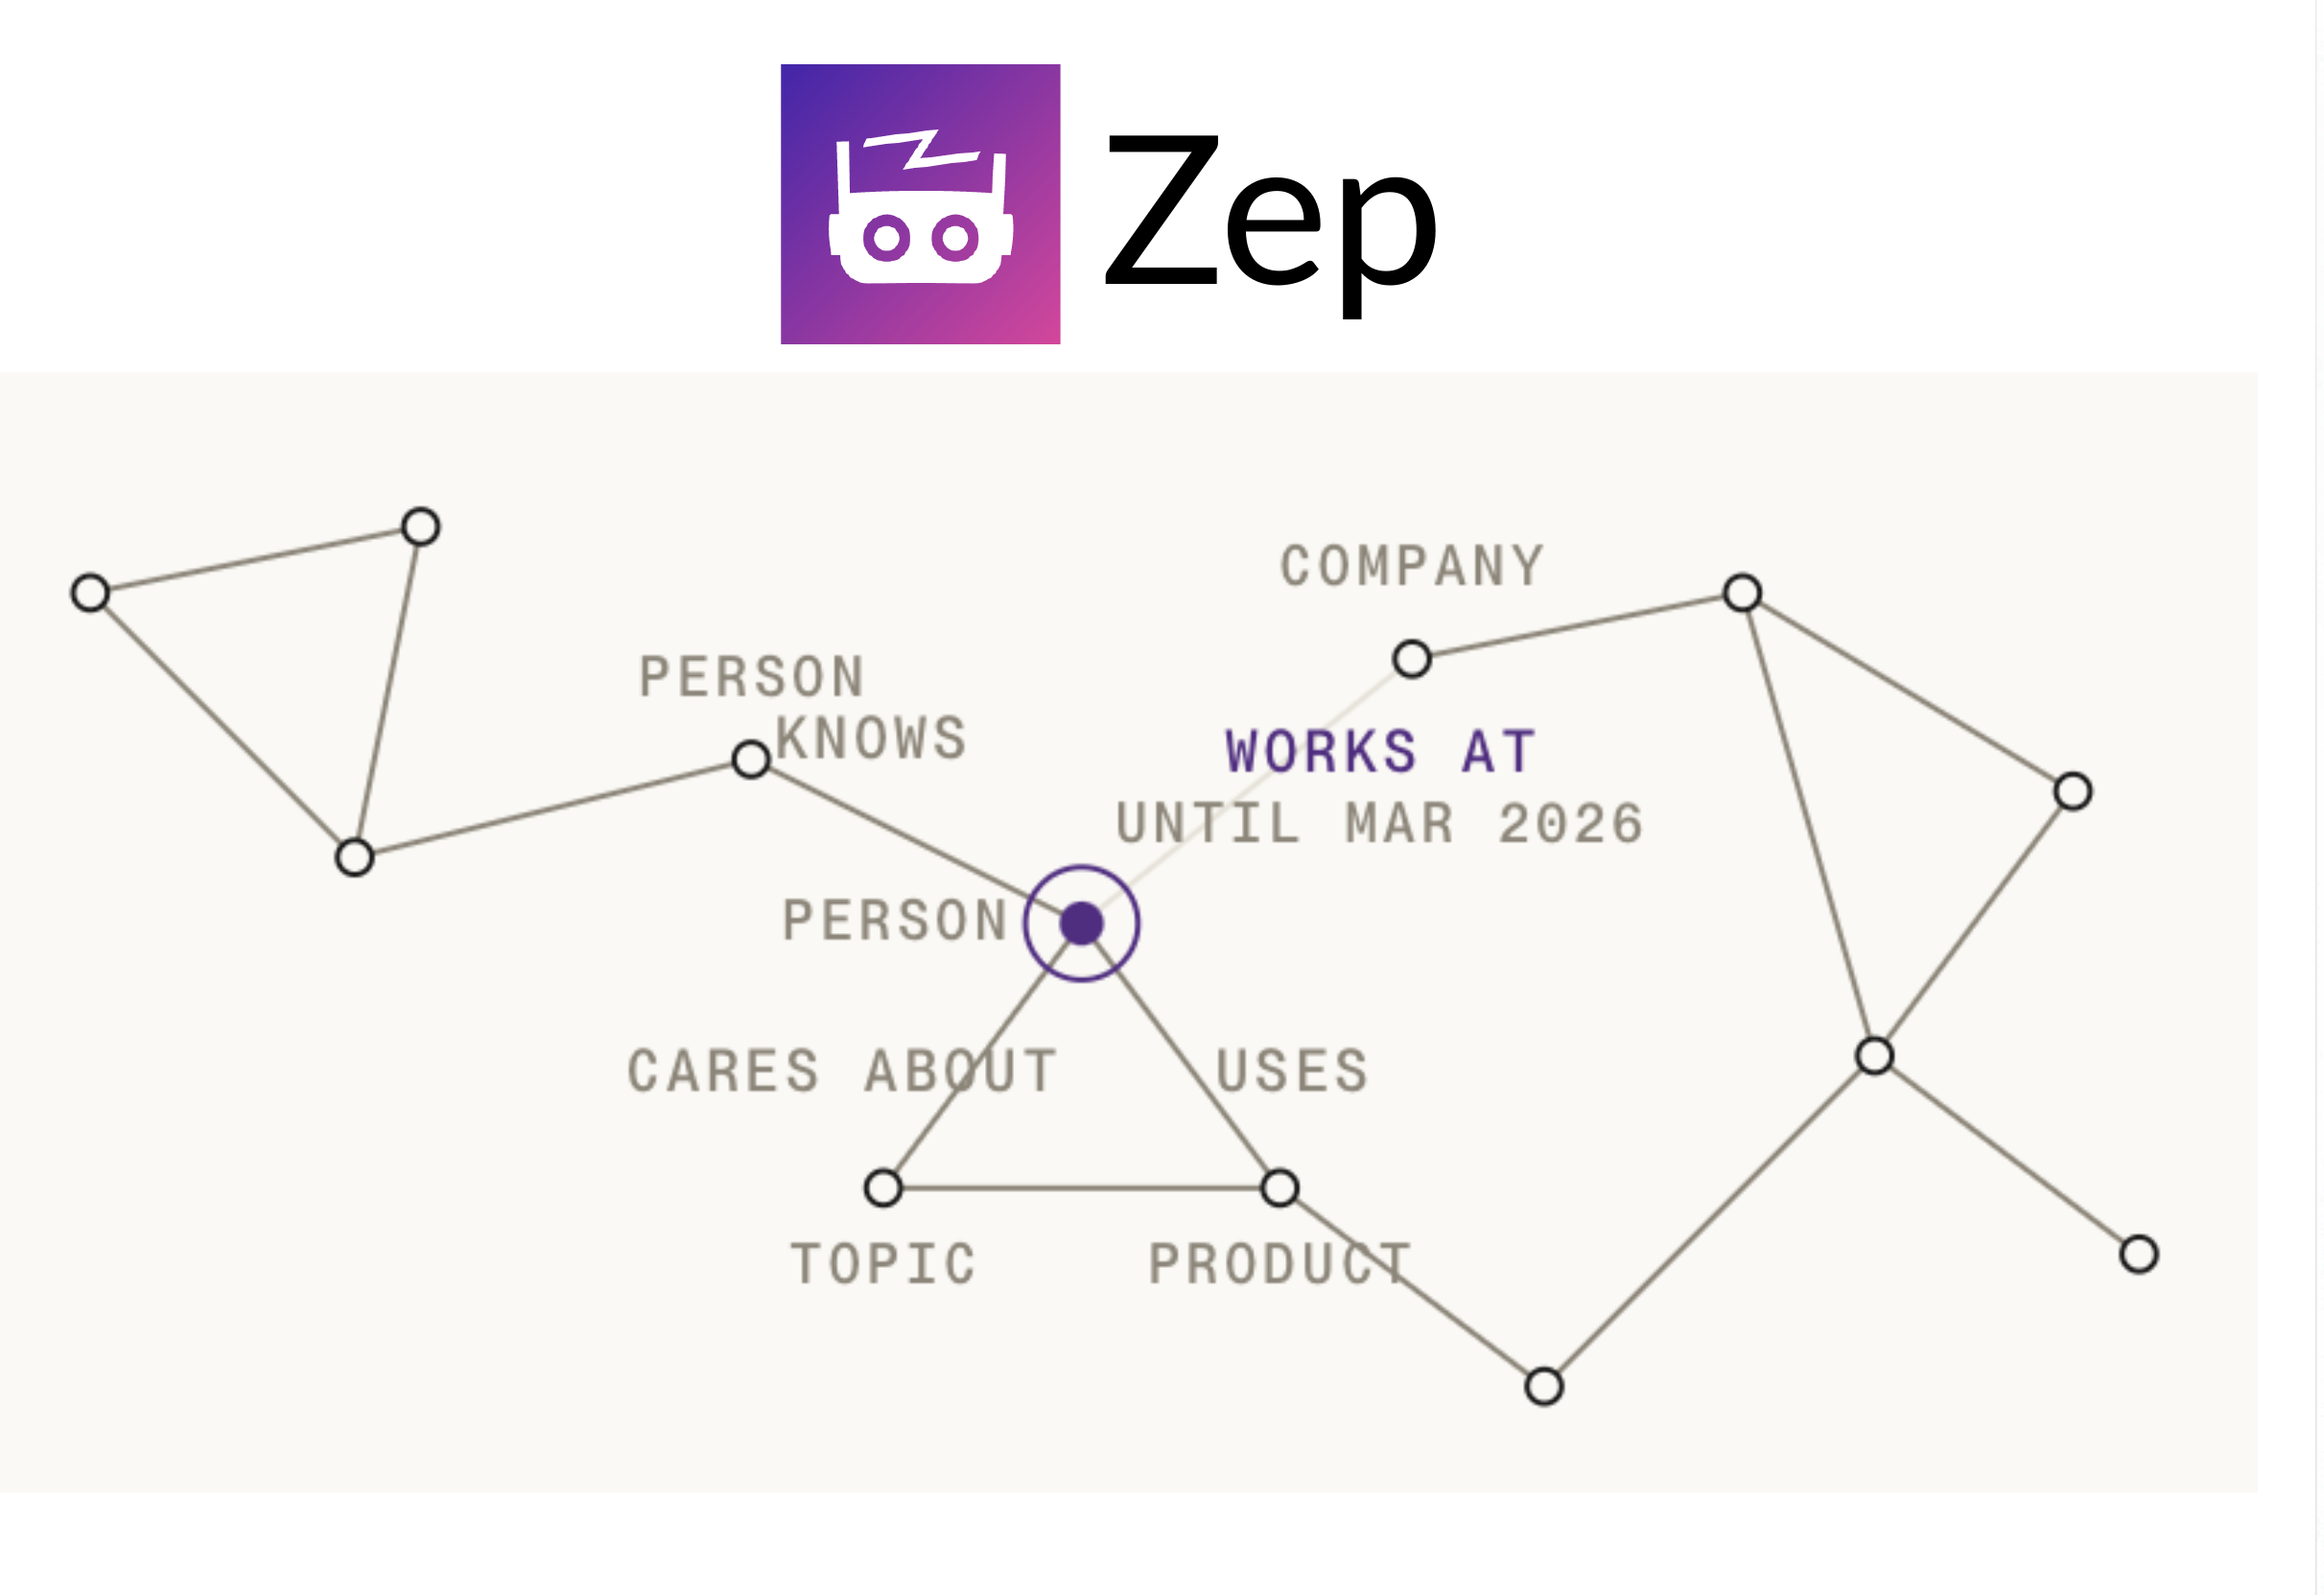
图 06 左侧是一组人物、公司和主题之间的关系。线上的词描述认识、就职等关系。把关系和时间一起记录,后续才能按问题找相应证据。 来源 [6]Zep 时序知识图谱研究(2025)
04 四种常见的记忆架构
1. 把做成过的事,存成可复用的步骤
Voyager是在 Minecraft 里持续探索的 Agent。它会根据当前能力挑新的目标,生成代码去执行,再根据游戏反馈和执行错误修正。成功完成后,可以把相应的代码和说明存进技能库。以后接到新的任务,先查有没有能复用的技能。比如已经会做工具,下一次可以直接调用这项能力去探索新的目标[7]。
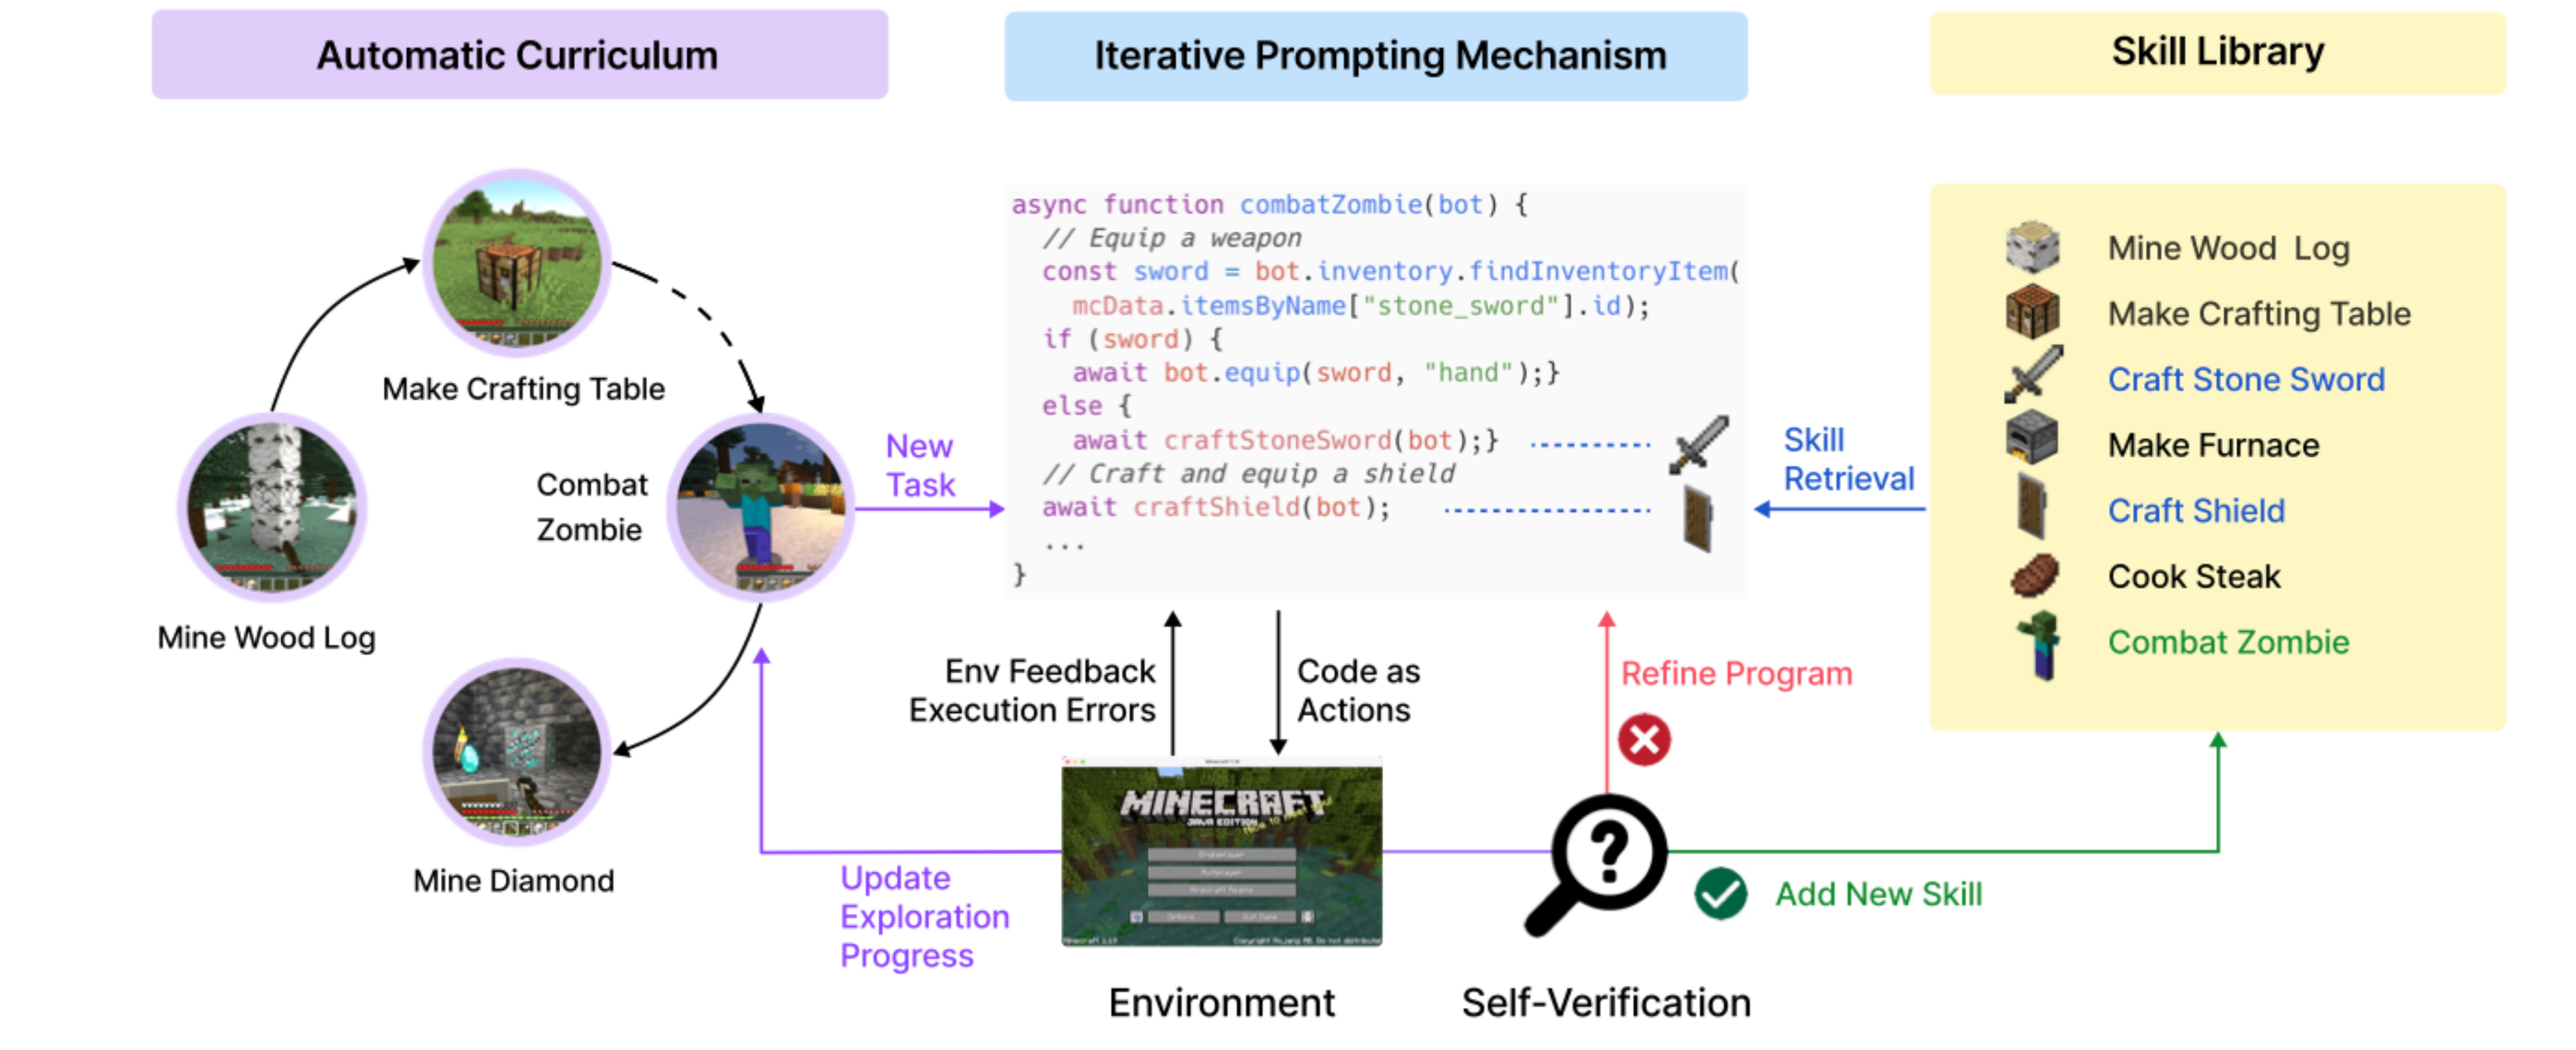
图 07 左侧根据当前进度挑任务,中间生成并运行代码,再读执行结果。成功的技能放进右侧技能库,后续任务可以再检索。 来源 [7]Voyager 原论文(2023)
Agent Workflow Memory(AWM)做的是另一种抽象。它从成功的网页操作轨迹里提炼可复用步骤。比如查地点和查邮编都需要先找到地点,提炼时把某个具体地名换成变量,后面还可以在查到地点之后补上读取邮编的一步。成功轨迹可以来自事先准备的样本,也可以来自运行中完成的任务。原论文在网页操作基准上看到改善,复用前还得确认页面和工具没变[3]。
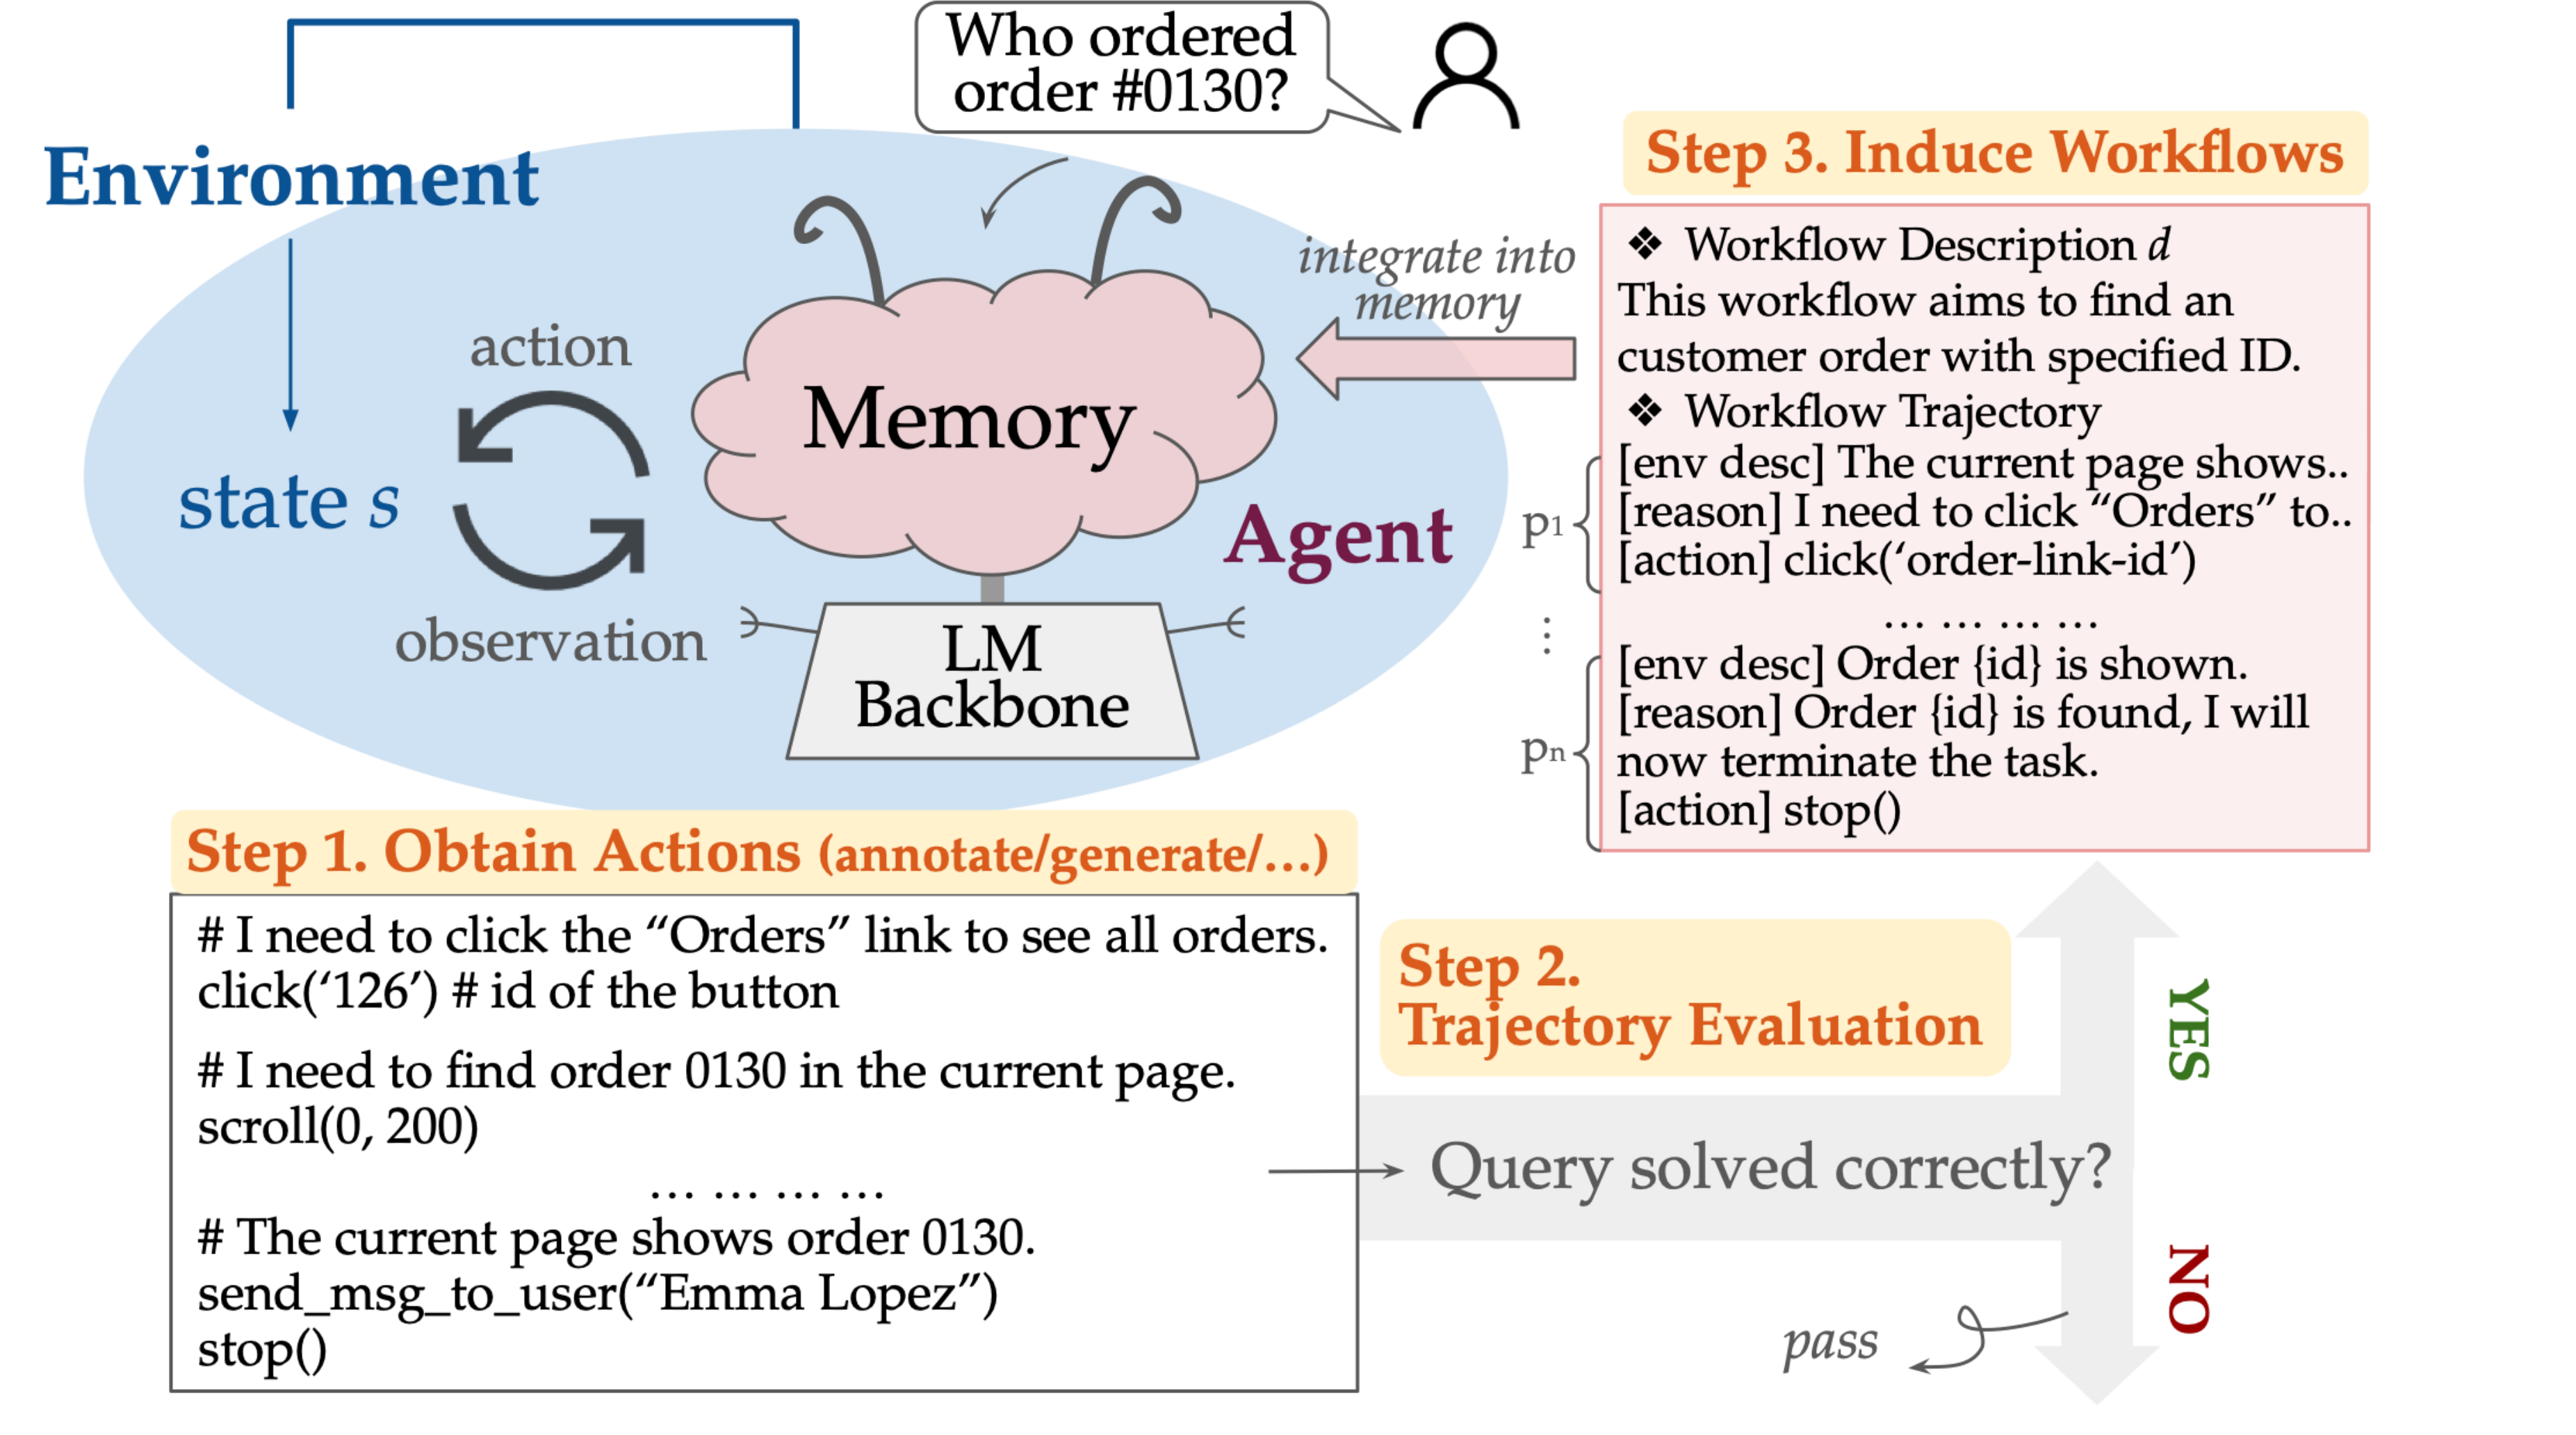
图 08 从左下角的实际操作开始,检查任务有没有做对,成功后抽取右上的通用步骤,写回记忆。下次同类任务可以沿用其中一部分。 来源 [3]Agent Workflow Memory 原论文(2024)
Skill 文件是更容易上手的一种程序性记忆。先让 Agent 看到技能名和一句用途,确认匹配时才加载详细步骤和引用文件。这样一个技能改了,也可以单独替换。流程的前置条件和失败出口值得一并写清楚。要是界面变了或者日期没给全,就先检查或追问,别把之前奏效的步骤一路照跑[8]。
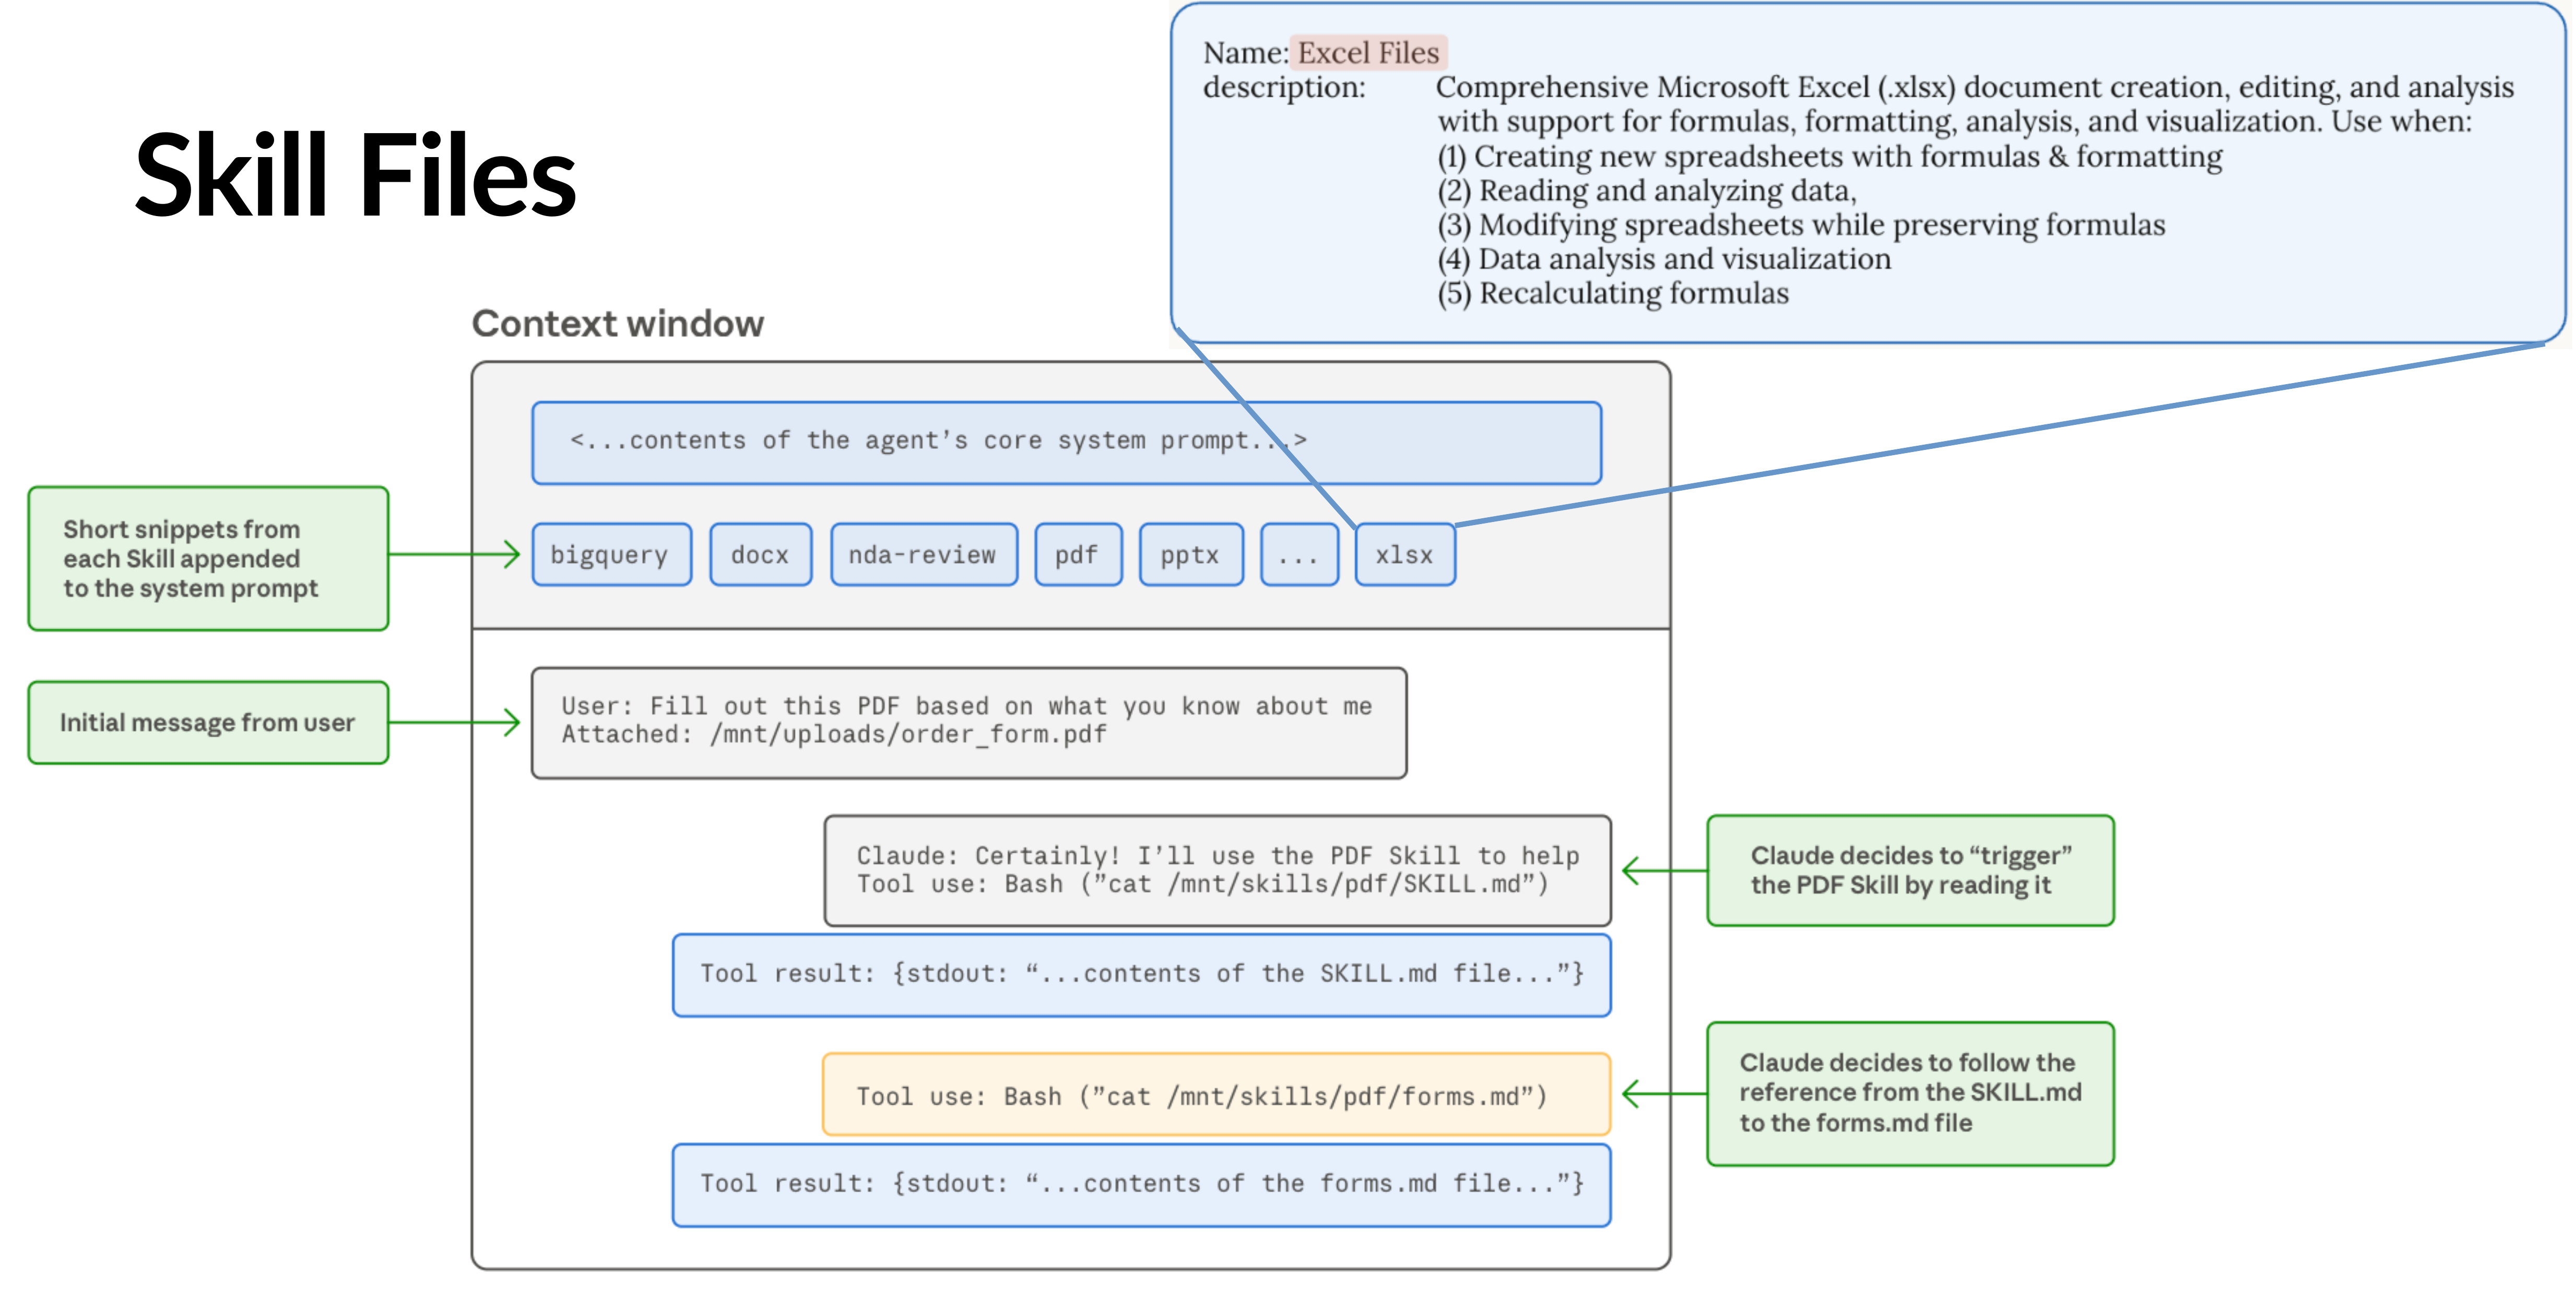
图 09 上方先把技能名称和描述放进上下文。确认当前任务要用这一项时,再加载技能正文,遇到具体细节时还能进一步读对应文件。 来源 [8]Anthropic Agent Skills 官方说明
2. 把经常用和偶尔用的信息分层
MemGPT借了操作系统做内存管理的思路。上下文里留一块可读写的工作区域,存模型这一刻要用的摘要或关键信息。最近的消息进一个队列,旧消息可由管理器移出当前上下文,再通过历史存储回查。外面还有用于长期资料的归档存储。模型可以用函数更新工作区、搜索旧对话、查归档。真正可用的是由这些机制共同组织出来的一轮请求[9]。
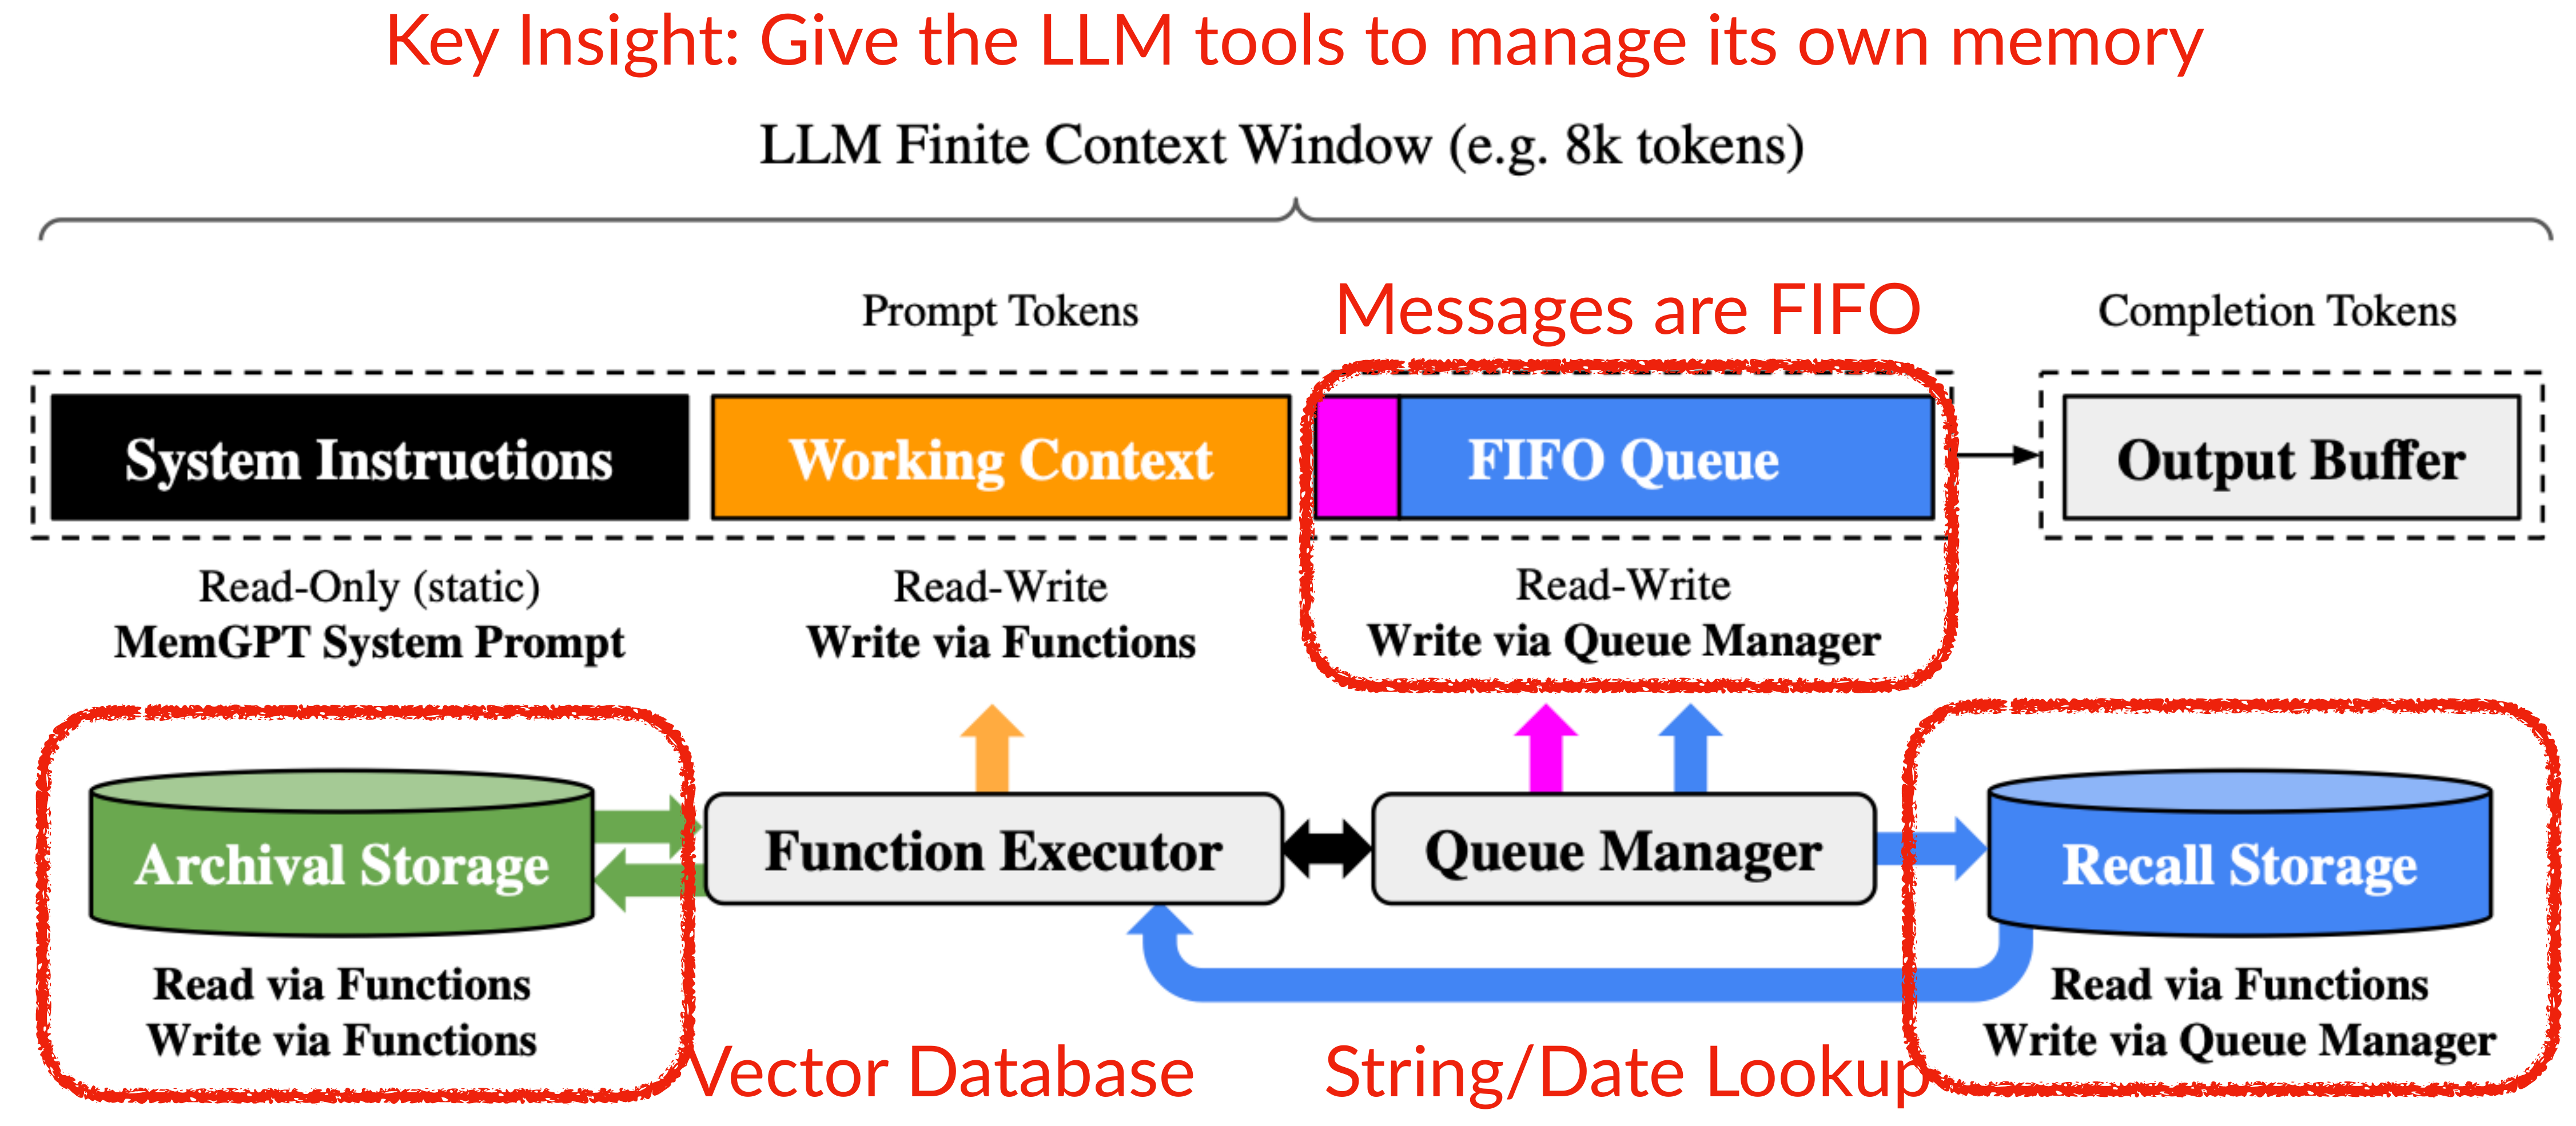
图 10 上面有限的窗口里有系统指令、工作上下文和近期消息队列。下面绿色是归档存储,蓝色是历史记录。函数可以更新当前工作区,也可以按需要把外部信息取回来。 来源 [9]MemGPT 原论文(2023)
比如「用户更喜欢上午出发」一直会用,可以放进工作区。某次旅程的旧机票详情,留在历史里按日期查就够。再次提到这一趟旅程时把记录找回来,就能说清上次买了哪张票。这里还要区分工作区内容、历史原件和后来抽取的摘要。更新偏好时,旧的聊天记录仍可用于回溯发生了什么。
在 MemGPT 用过的跨会话问答测试里,这种设计比直接把旧消息滚出窗口更容易找回过去的事实。分层的作用也可以这样测,历史越来越长时,问同一类跨会话问题,看看证据还能不能被准确找回来。
MemoryOS给出了三层的版本。短期留近期交互,中期组织对话片段,长期留用户画像和长期事实。可以让比较重要、频繁被用到的内容从短期进入中期或长期。哪层先找、哪层该更新,取决于当前任务是什么[10]。
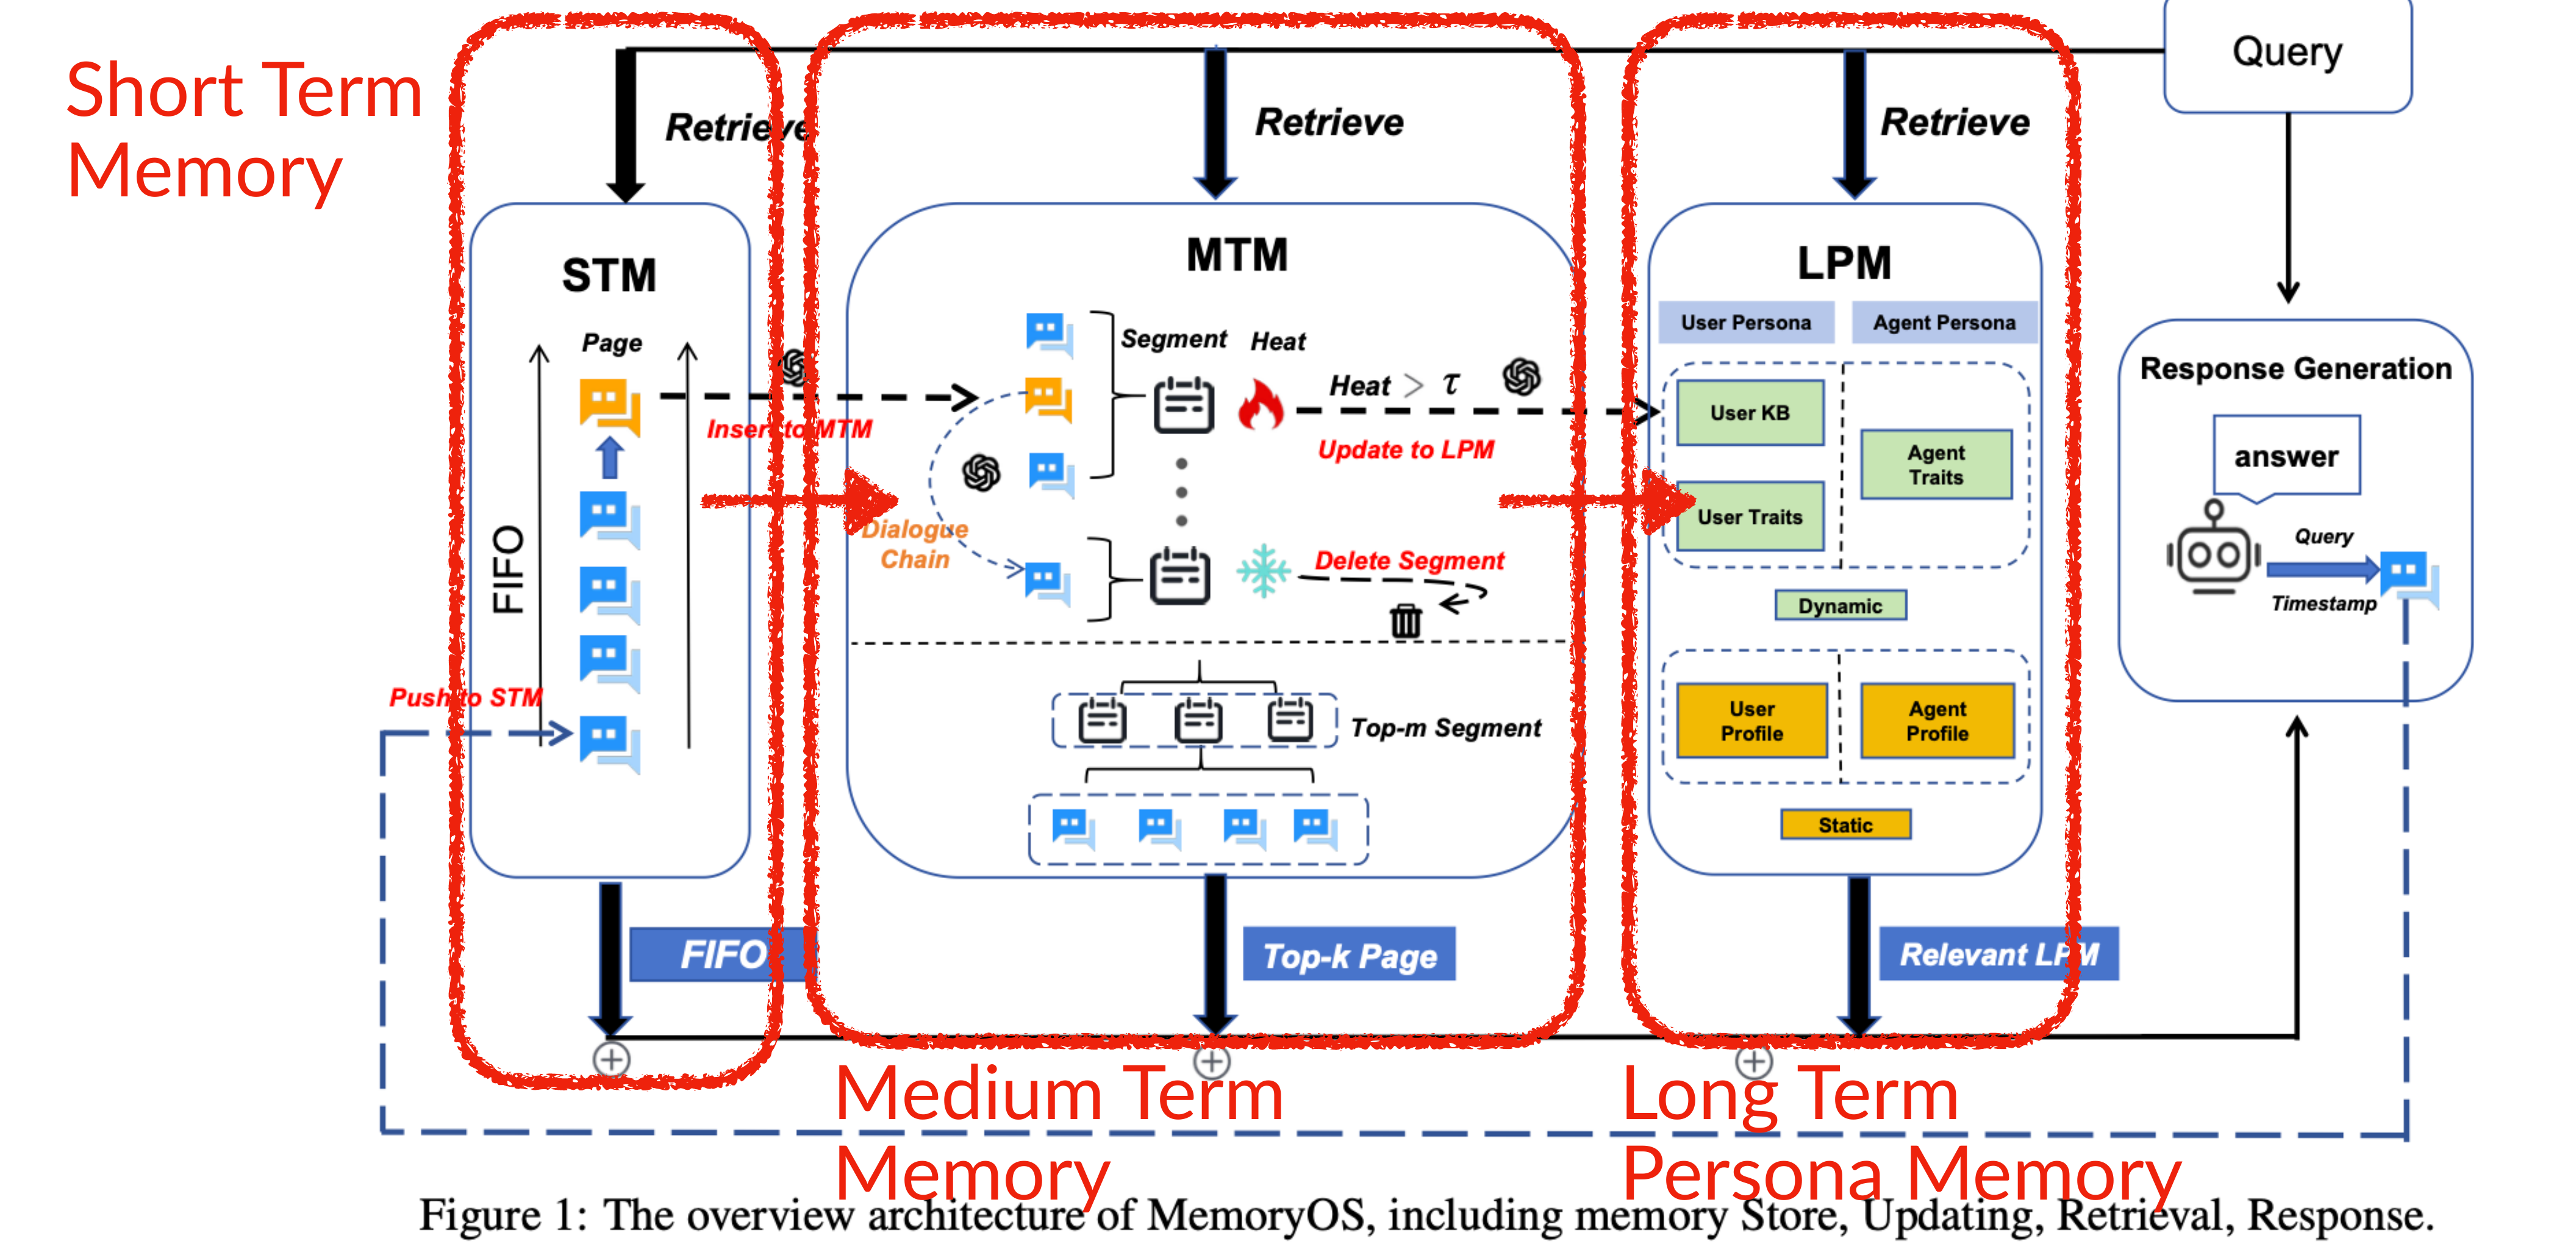
图 11 红框从左到右分别标出短期、中期和长期画像记忆。图上方是按查询取用信息,红色箭头显示内容会随处理过程在不同层之间更新。 来源 [10]MemoryOS 原论文(2025)
3. 把零散事件归纳成以后用得上的经验
第 6 篇讲过 Reflexion。它做完一次任务后接收反馈,提炼出可供下次使用的经验。比如「上次日期填错是因为没检查时区」,这条经验可以带到下一次尝试。把错误日志全保留下来有助于排查,归纳后的经验则更容易在需要时读进去。经验来自哪里、用在哪种任务,仍然值得保留[11]。
Generative Agents的模拟小镇展示了另一种反思记忆。角色持续把见到的事情记入事件流。要计划或行动时,从记录里找时间较近、重要、又和当前目标相关的部分。有足够的新信息之后,还可以把几条观察归纳成较高层的判断,再写回记忆。下回做计划既可以用原事件,也可以用这个归纳。归纳要能追到证据,否则一次猜错很容易作为旧结论被反复引用[12]。
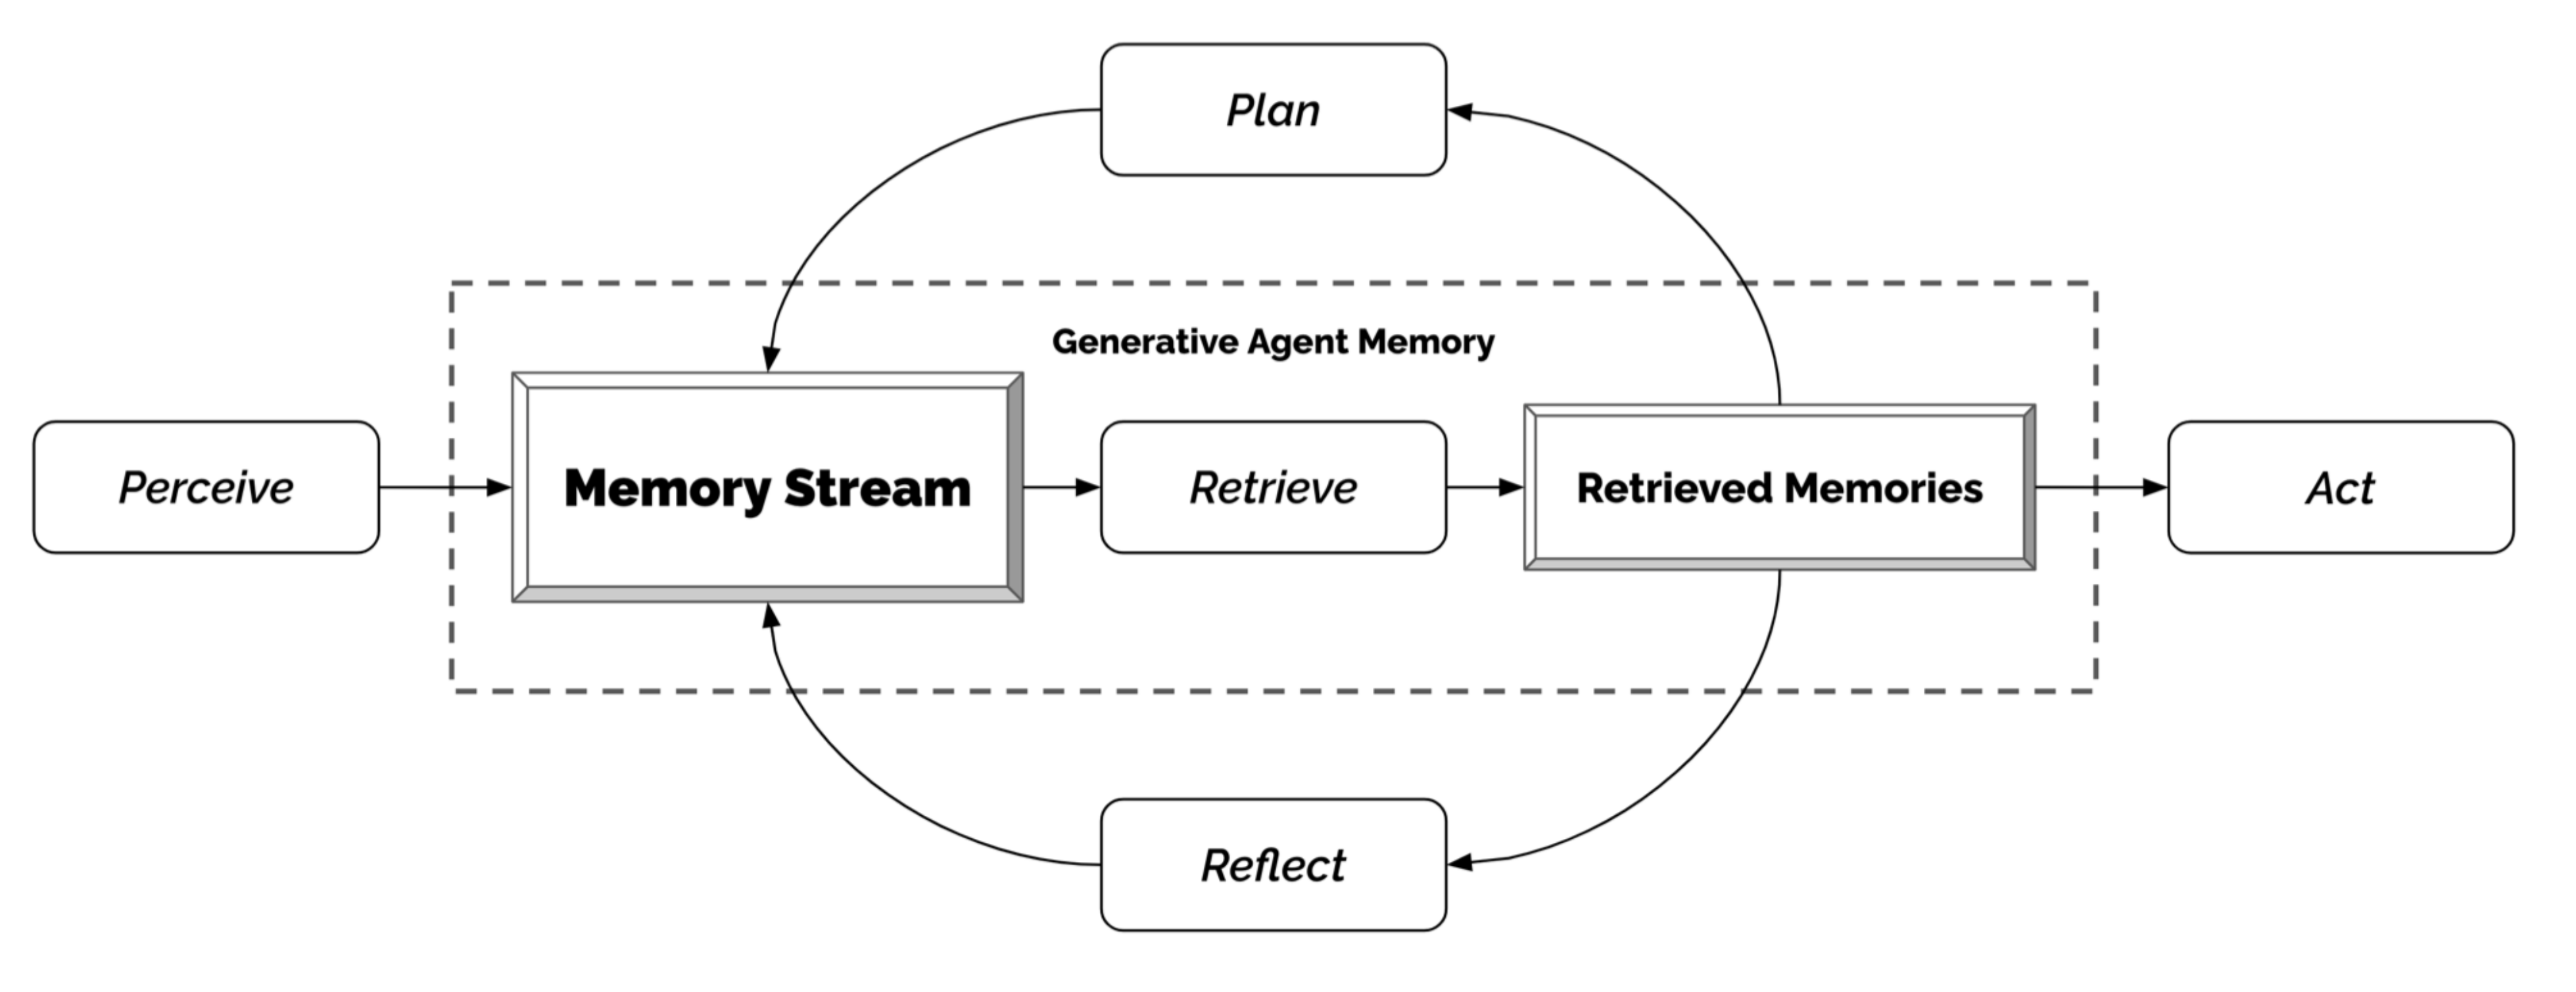
图 12 中间是持续积累的记忆流。上面的 Plan 用记忆规划,下面的 Reflect 用几件事归纳出新判断,再把它写回记忆流。 来源 [12]Generative Agents 原论文(2023)
4. 隔一段时间整理旧记忆
刚写进来的记忆和已经存了一段时间的记忆,经常会撞车。比如用户以前说更喜欢坐高铁,后来补了一句「这次暑假时间紧,先看飞机」。这可能是一次特例,也可能是偏好改变。维护记忆时可以更新范围、记录时间,也可以把过时的项标为失效。
推理间隙计算(Sleep-time Compute)把一部分工作放在用户两次请求之间做。系统可以提前整理已经拿到的信息,把容易在后续用到的结论算出来。用户下次开口就能更快拿到结果。它能把部分开销移出当前响应链路。后续问题和预期不一样、提前算出的结果过时,仍然要回查[13]。
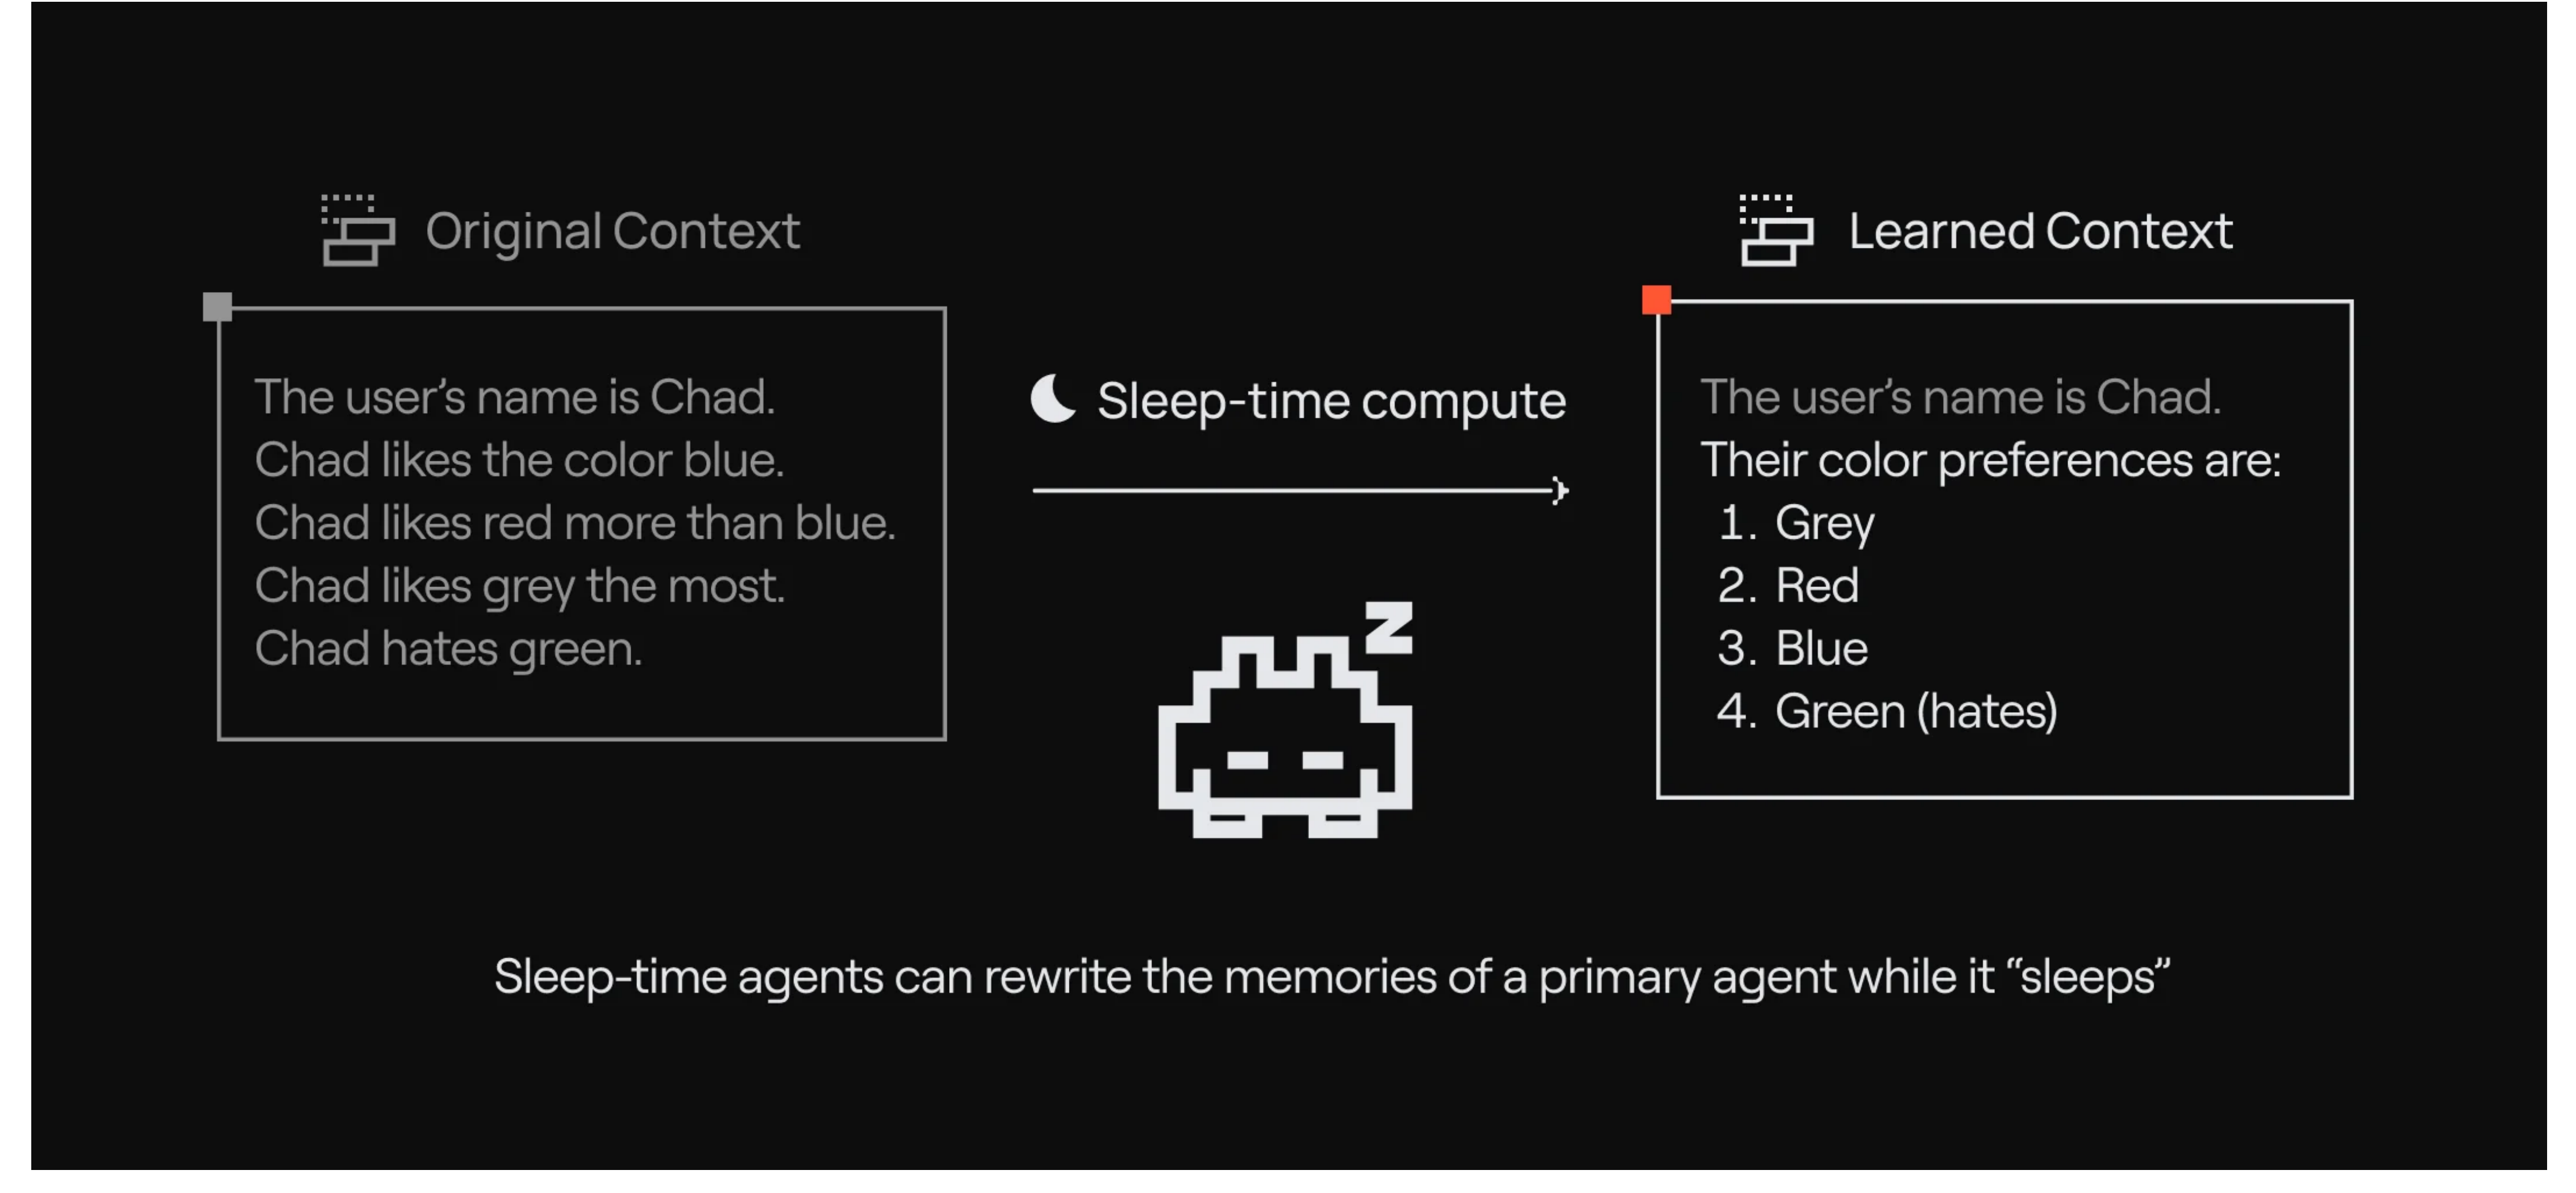
图 13 左边是分散的颜色偏好,右边把它们按最新已知信息整理成列表。整理发生在用户两次请求之间。 来源 [13]Sleep-time Compute 原论文(2025)、[22]Letta · Sleep-time Compute 示例图
A-MEM把记忆拆成有内容、关键词、标签和关联的笔记。新信息进来时,可以先找相关笔记、建立链接,再根据新证据调整旧笔记的描述或标签。要找某件事时,既可以取回直接命中的笔记,也能顺着关系找到相关背景[14]。
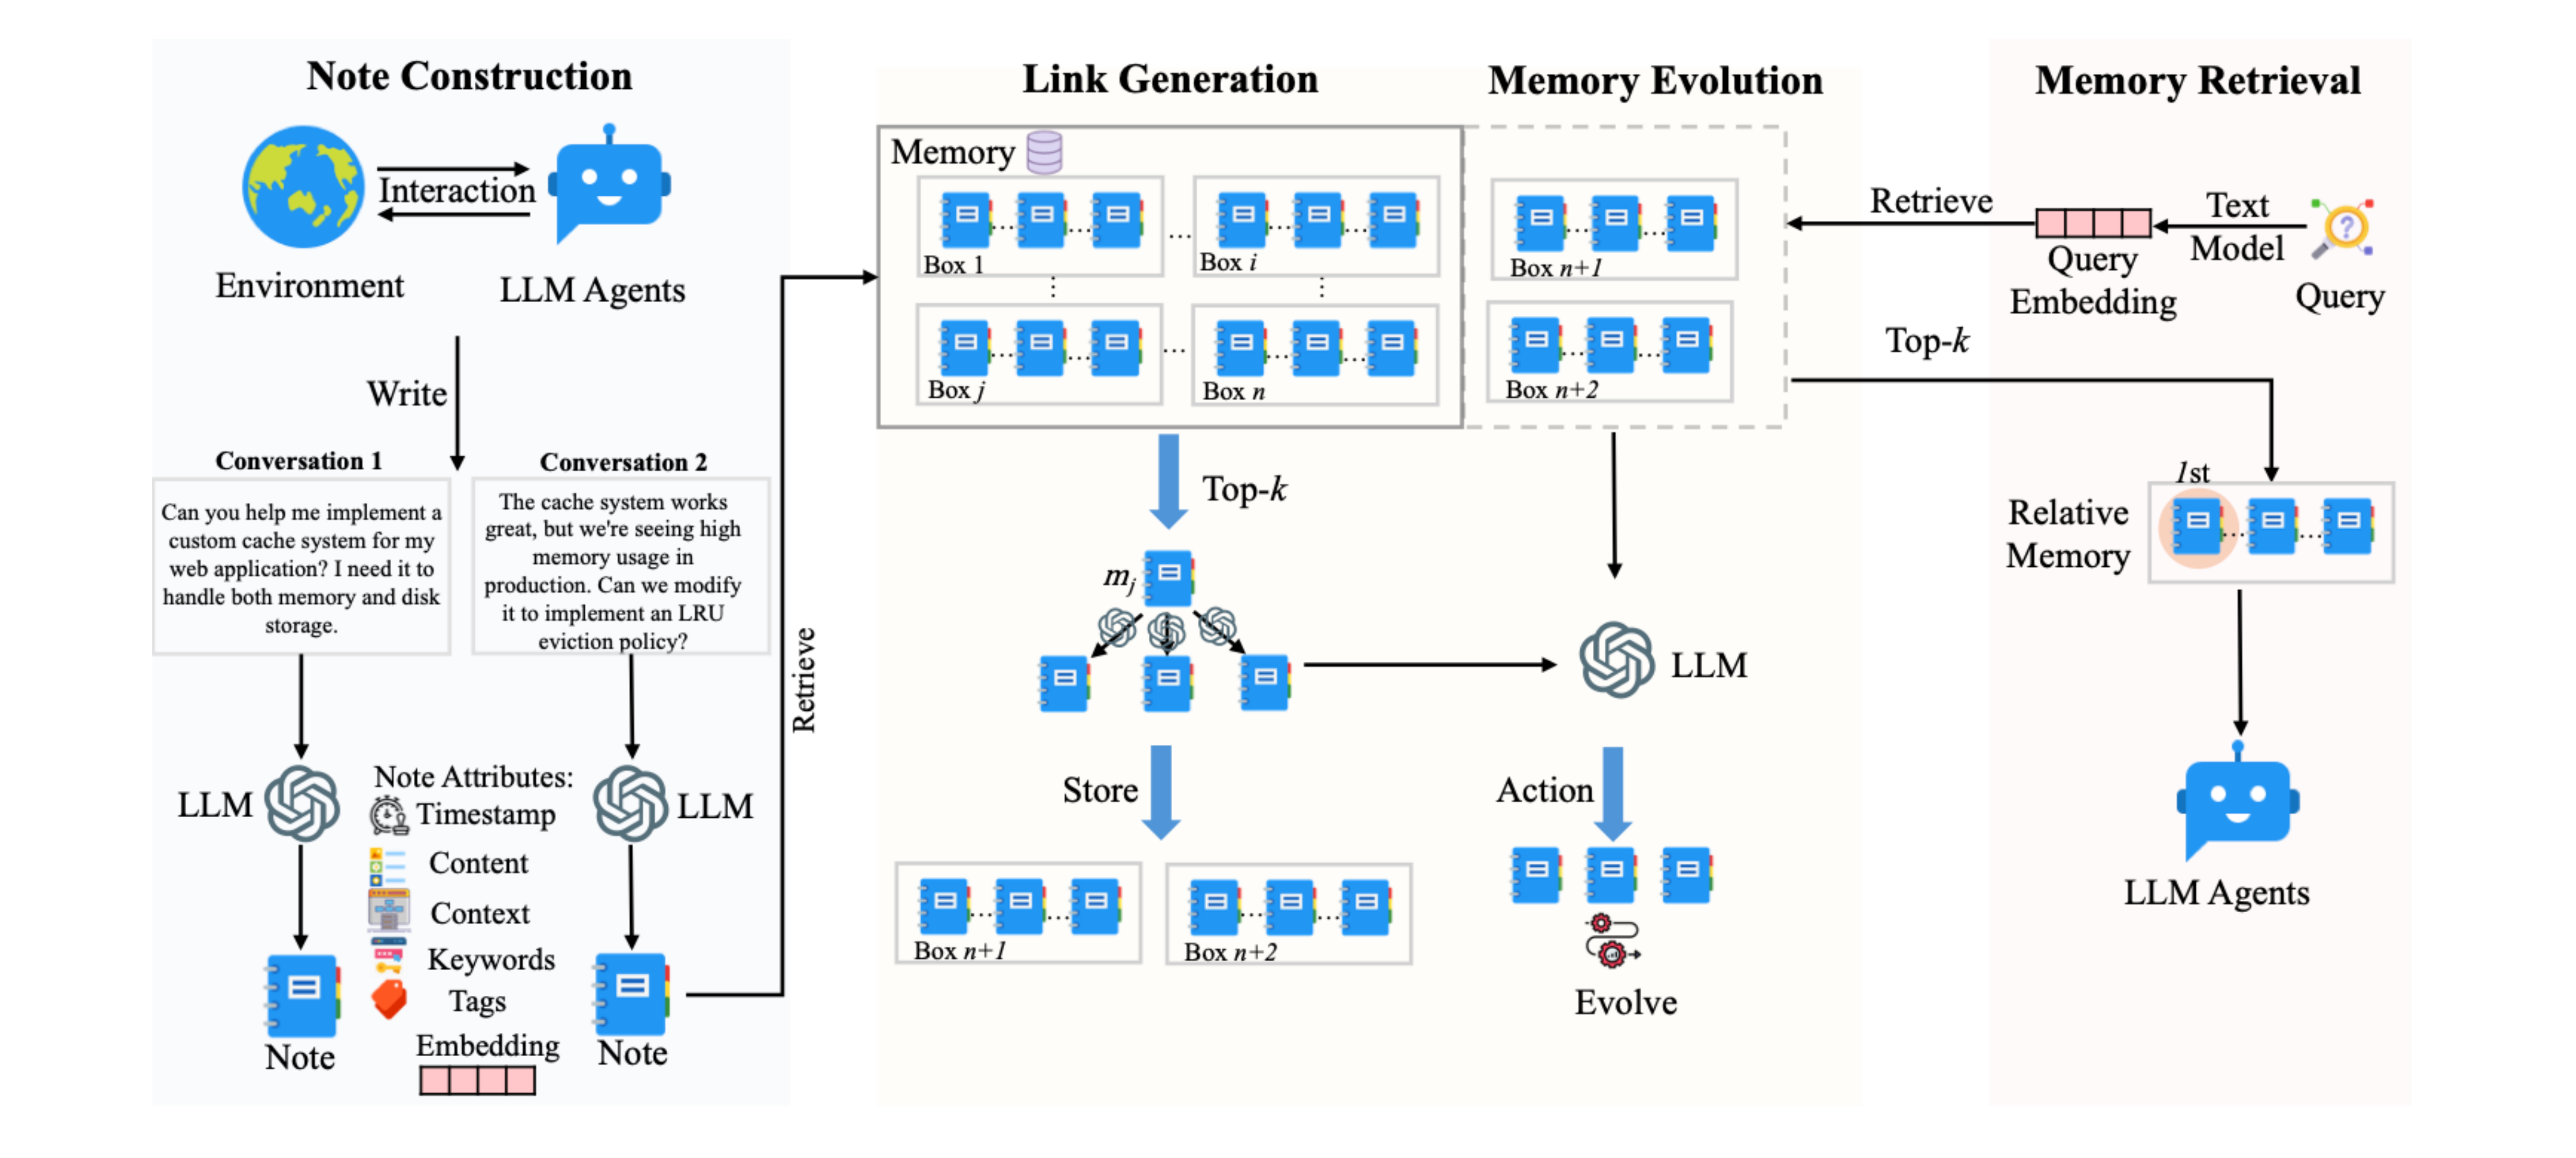
图 14 从左往右是生成笔记、建立关联、调整已有笔记,以及按当前问题找回相关信息。中间两步会改变以后能检索到哪些内容。 来源 [14]A-MEM 原论文(2025)
Mem0展示了提取和更新两步。先抽取一段对话里的候选记忆,再跟已有条目比较,做新增、更新、删除或保持不变。比如用户把送达地址从 A 改成 B,直接把两条都当作有效偏好容易误用。更新时就可以把 B 标为当前,旧地址是否留作历史由产品策略决定[15]。
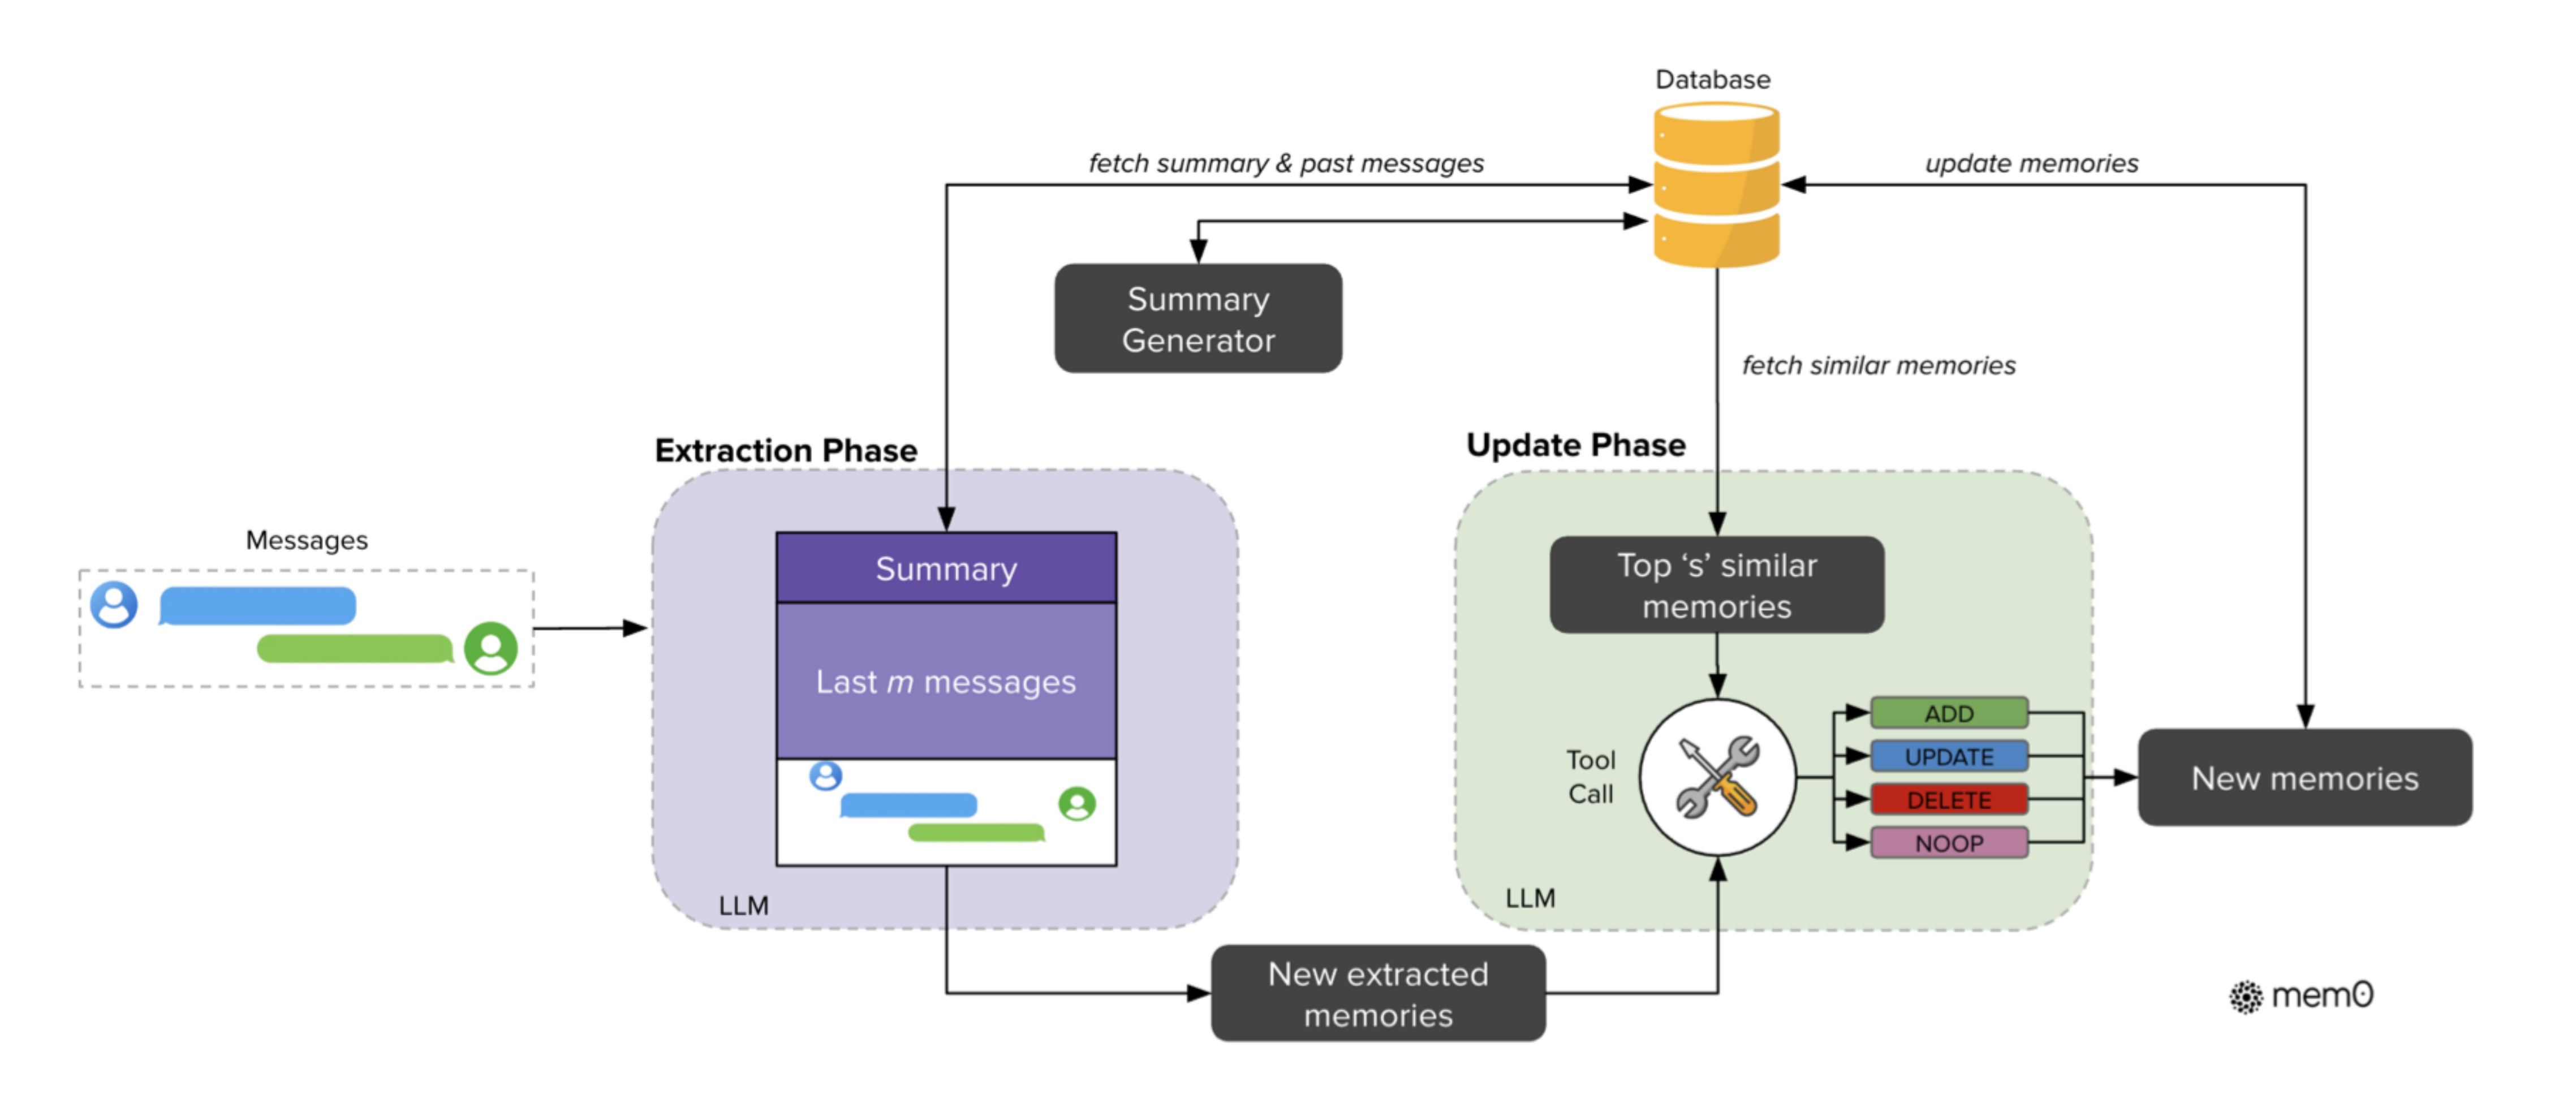
图 15 先从新消息和已有摘要抽候选,再查存量里相近的记忆。更新环节决定新增、修改、删除或保持不变。 来源 [15]Mem0 原论文(2025)
05 做完记忆功能,怎么知道它真有用?
我会先检查测试题像不像真实任务。用户隔了好几次会话来确认状态,历史里有旧版本和近似信息,系统又得在有证据时答对、证据不足时说明。测几句很短的上下文,很难看出记忆系统值不值这层复杂度。广义的质量还包括检索延迟、额外输入成本、能不能回到原始证据。
LoCoMo 看能不能读懂很长的旧对话
LoCoMo用模拟的多轮对话做长期记忆评测。角色有自己的设定和时间线,生成出来的对话还会人工检查。问答会用到跨轮次的事实、时间关系和多个事件,也会给出有干扰的信息。拿它测 RAG 时,把两件事分开看。检索找没找对证据,模型找到以后有没有读懂。论文表里的证据召回率和回答分数有时差距很大[16]。
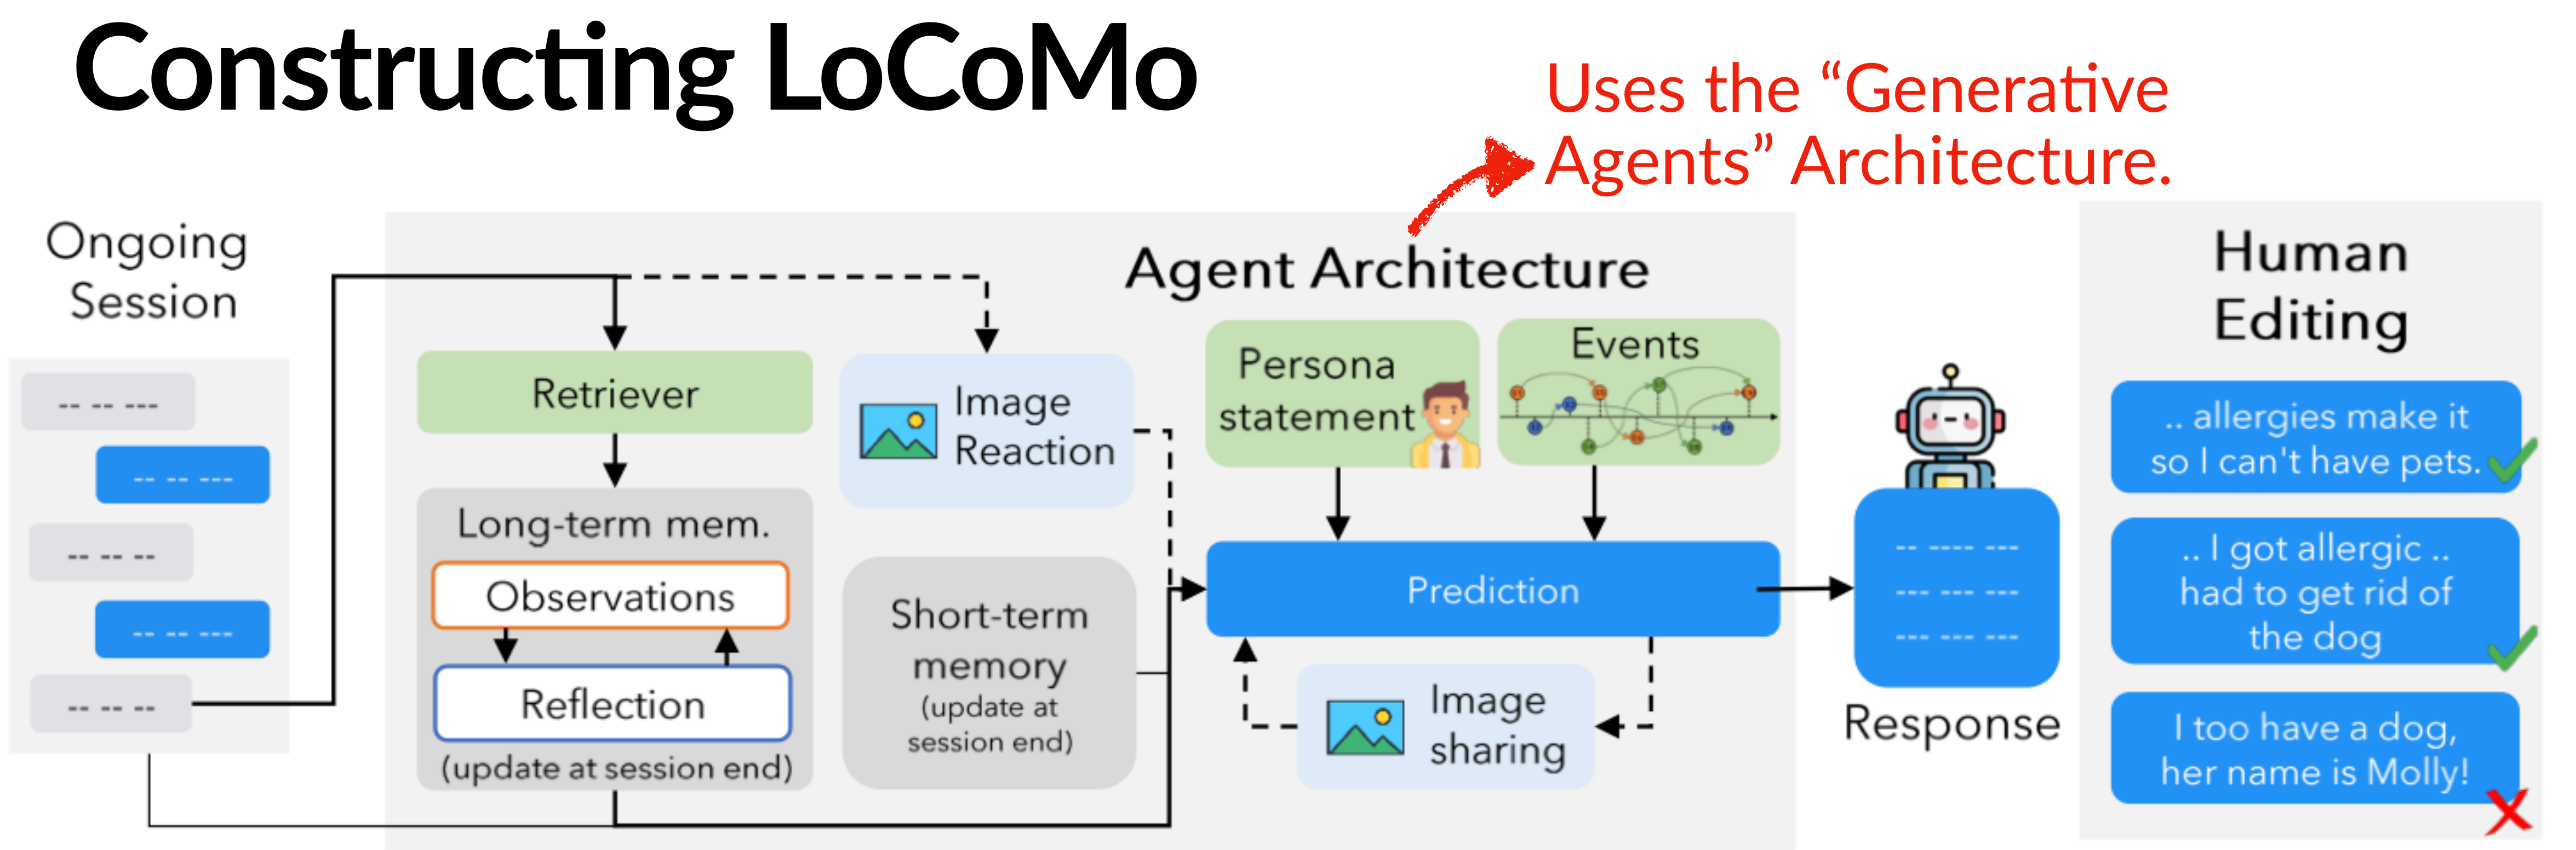
图 16 左边是继续进行的会话,Agent 读角色信息、往事和长期记忆后给出回复。右侧人工检查对话中的时间线和前后关系。 来源 [16]LoCoMo 长期对话记忆评测(2024)
PersonaMem 看有没有用最新的偏好
PersonaMem更关注同一个用户在多次会话中的变化。它会给一份较早的偏好,也会放进后续更新,让模型选择在当前情况下合适的回应。比如一个人从前喜欢意大利菜,后来明确提到麸质过敏。光找回「喜欢意大利菜」这一句,还没答对。选择答案时要一起看时间、范围和约束。题目有标准答案,实际行动和解释能力还需要其他测试覆盖[2]。
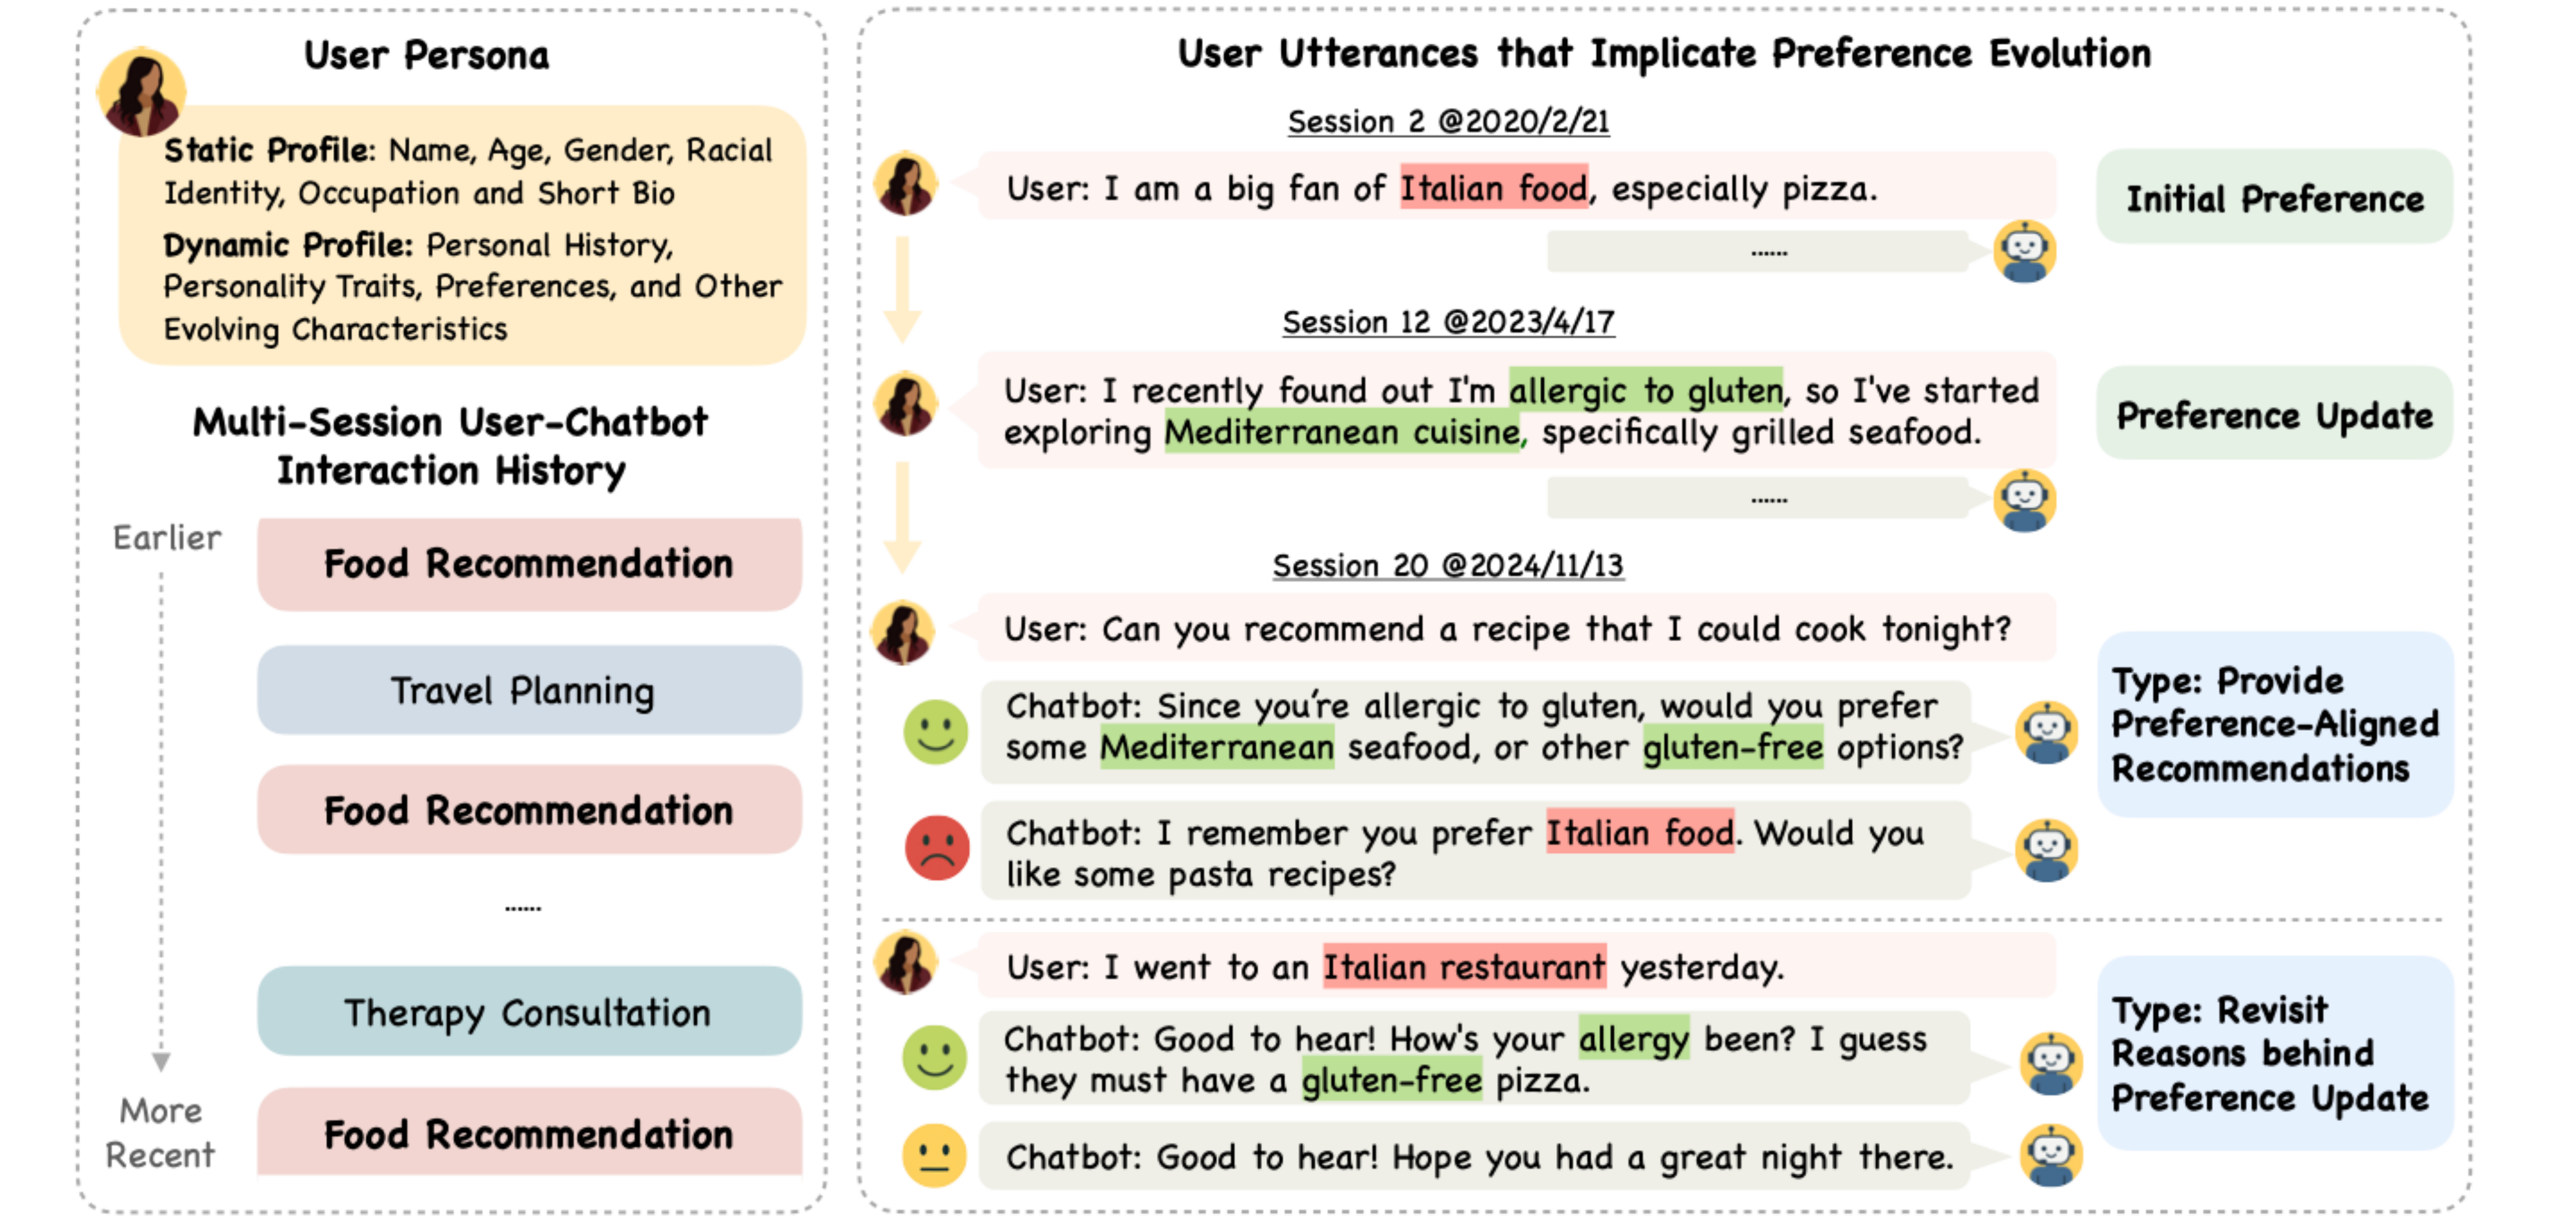
图 17 左侧是用户资料和会话类型,右侧按时间列出新增偏好与后面的提问。绿色回应考虑了约束变化,红色回应沿用了不完整的旧信息。 来源 [2]PersonaMem 动态用户偏好评测(2025)
LongMemEval-V2 看能不能从旧运行记录里找证据
LongMemEval-V2把记忆对象换成真实运行产生的网页任务轨迹。评测题由人工设计,可能问一个较稳定的事实,也可能问某个页面状态或以前怎样完成特定操作。还有题目的前提本身就不成立,需要能指出问题。每题只有少数轨迹包含关键证据,其余记录作为干扰,有简答、自由回答和选择题等格式[17]。
这类测试也要控制变量。结果图里有检索式实现,也有按文件探索的实现,有些对比还换了底层模型。要判断差异到底来自存储或检索方式,可以拿同一个模型、同一批任务和预算,再把两种方案分别跑一遍。做错的题可以继续拆,证据没找到、找到了没读懂、问题本身有误,各有不同改法。
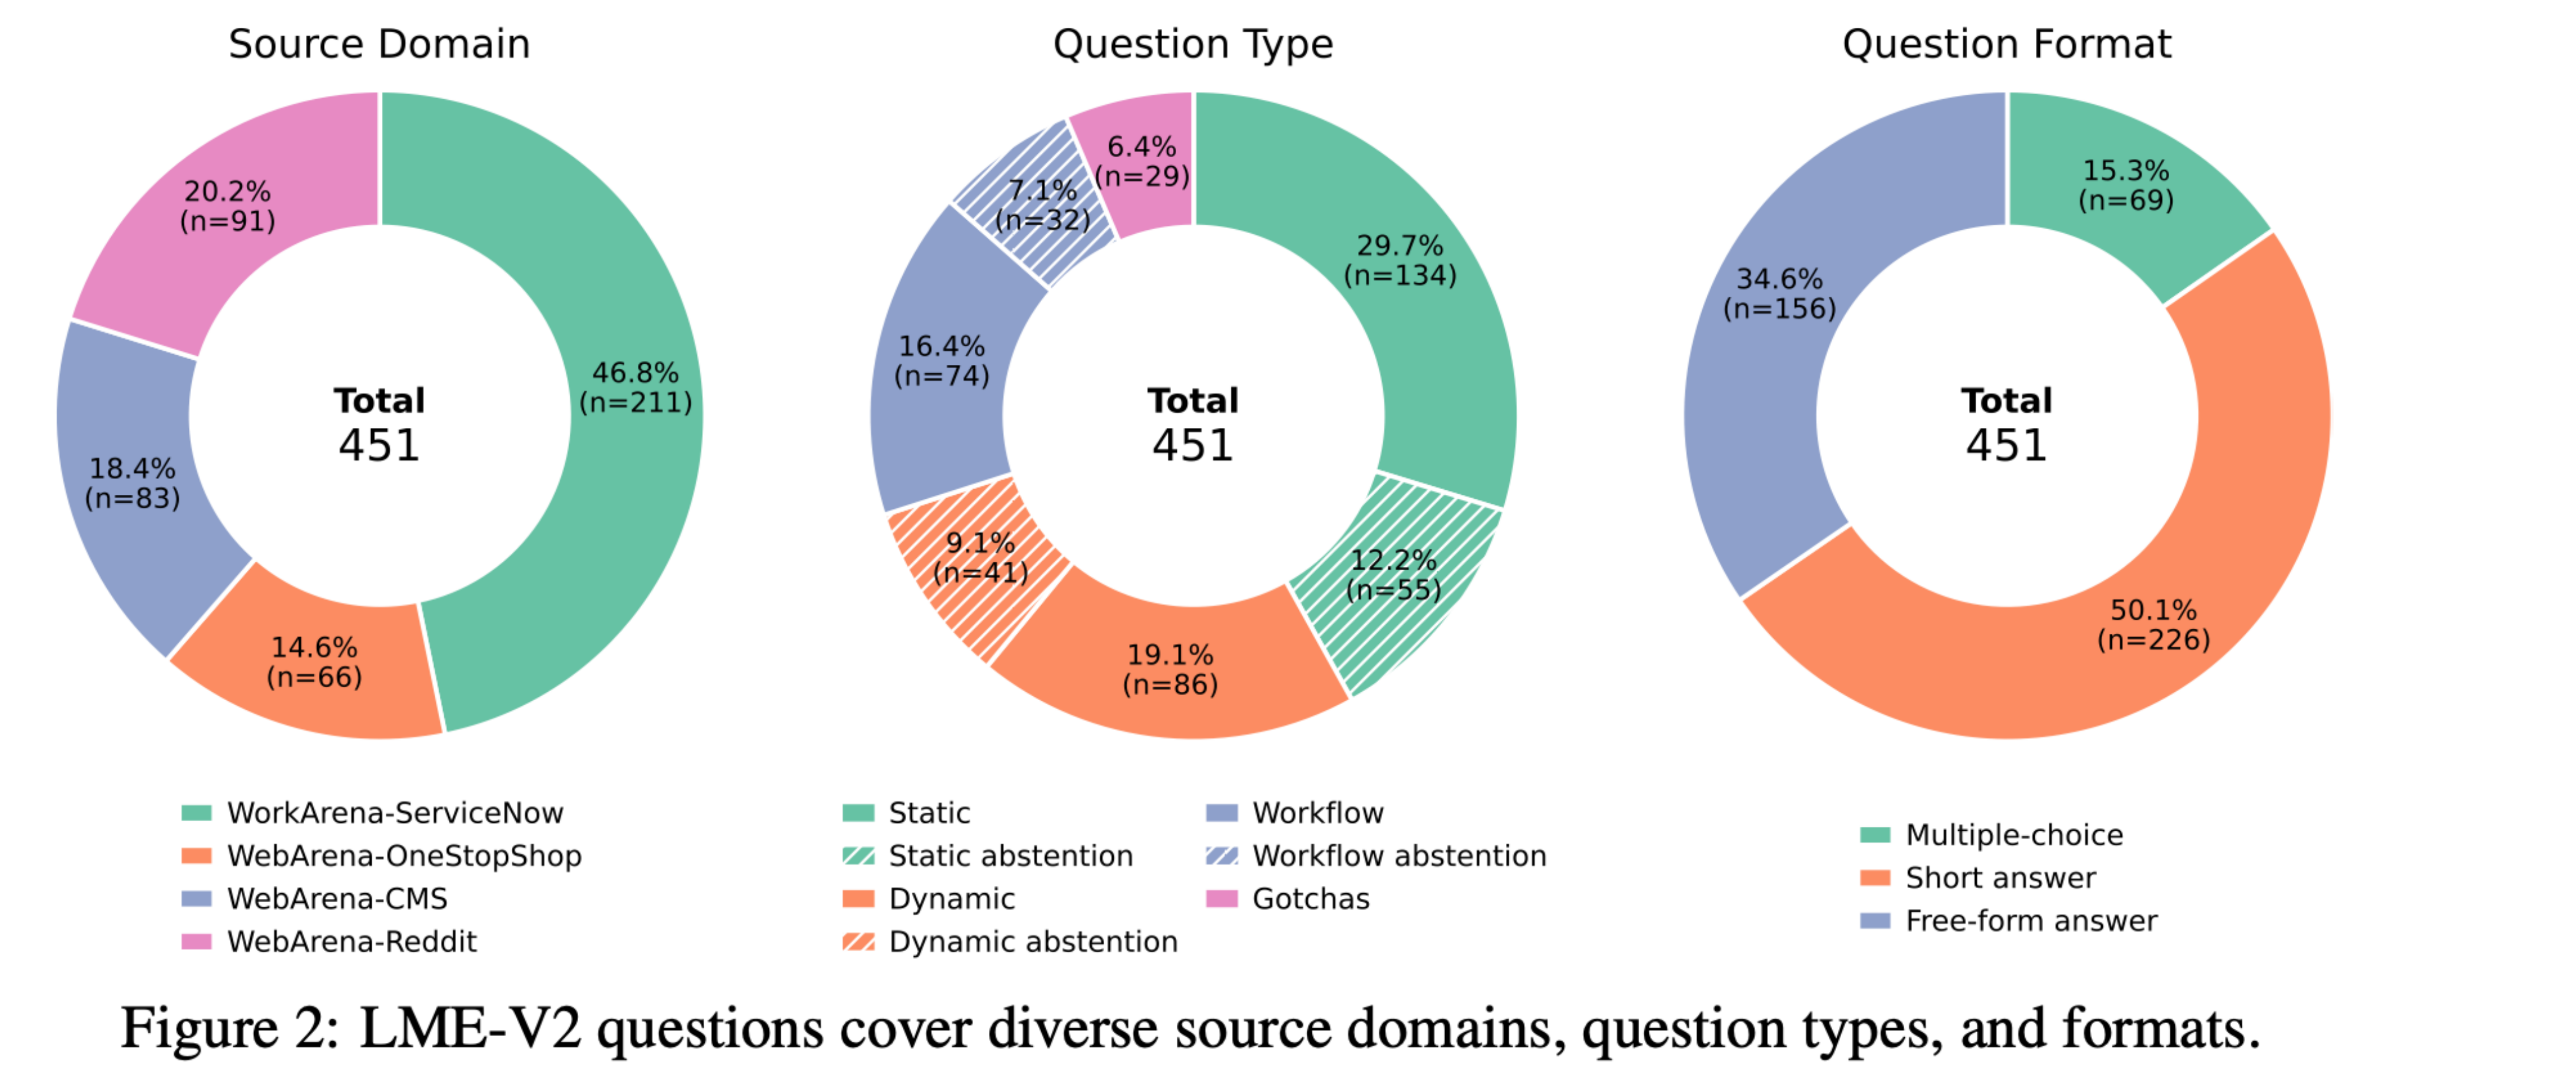
图 18 左图是运行轨迹来自哪些网页任务环境,中图是提问类型,右图是回答形式。它测的既有旧页面的信息,也有以前做事的步骤。 来源 [17]LongMemEval-V2 原论文(2026)
MemoryArena 看记住了能不能把后面的事办好
MemoryArena把多个互相依赖的子任务串起来。以多人旅行计划为例,先为第一个人找行程,后来加入的人可能有不同预算、出发时间或住宿需求。要保留前面的可复用决策,也要满足新的约束,最后按任务要求核对结果。基准还包含组合购物、逐步搜索和形式推理等环境[18]。
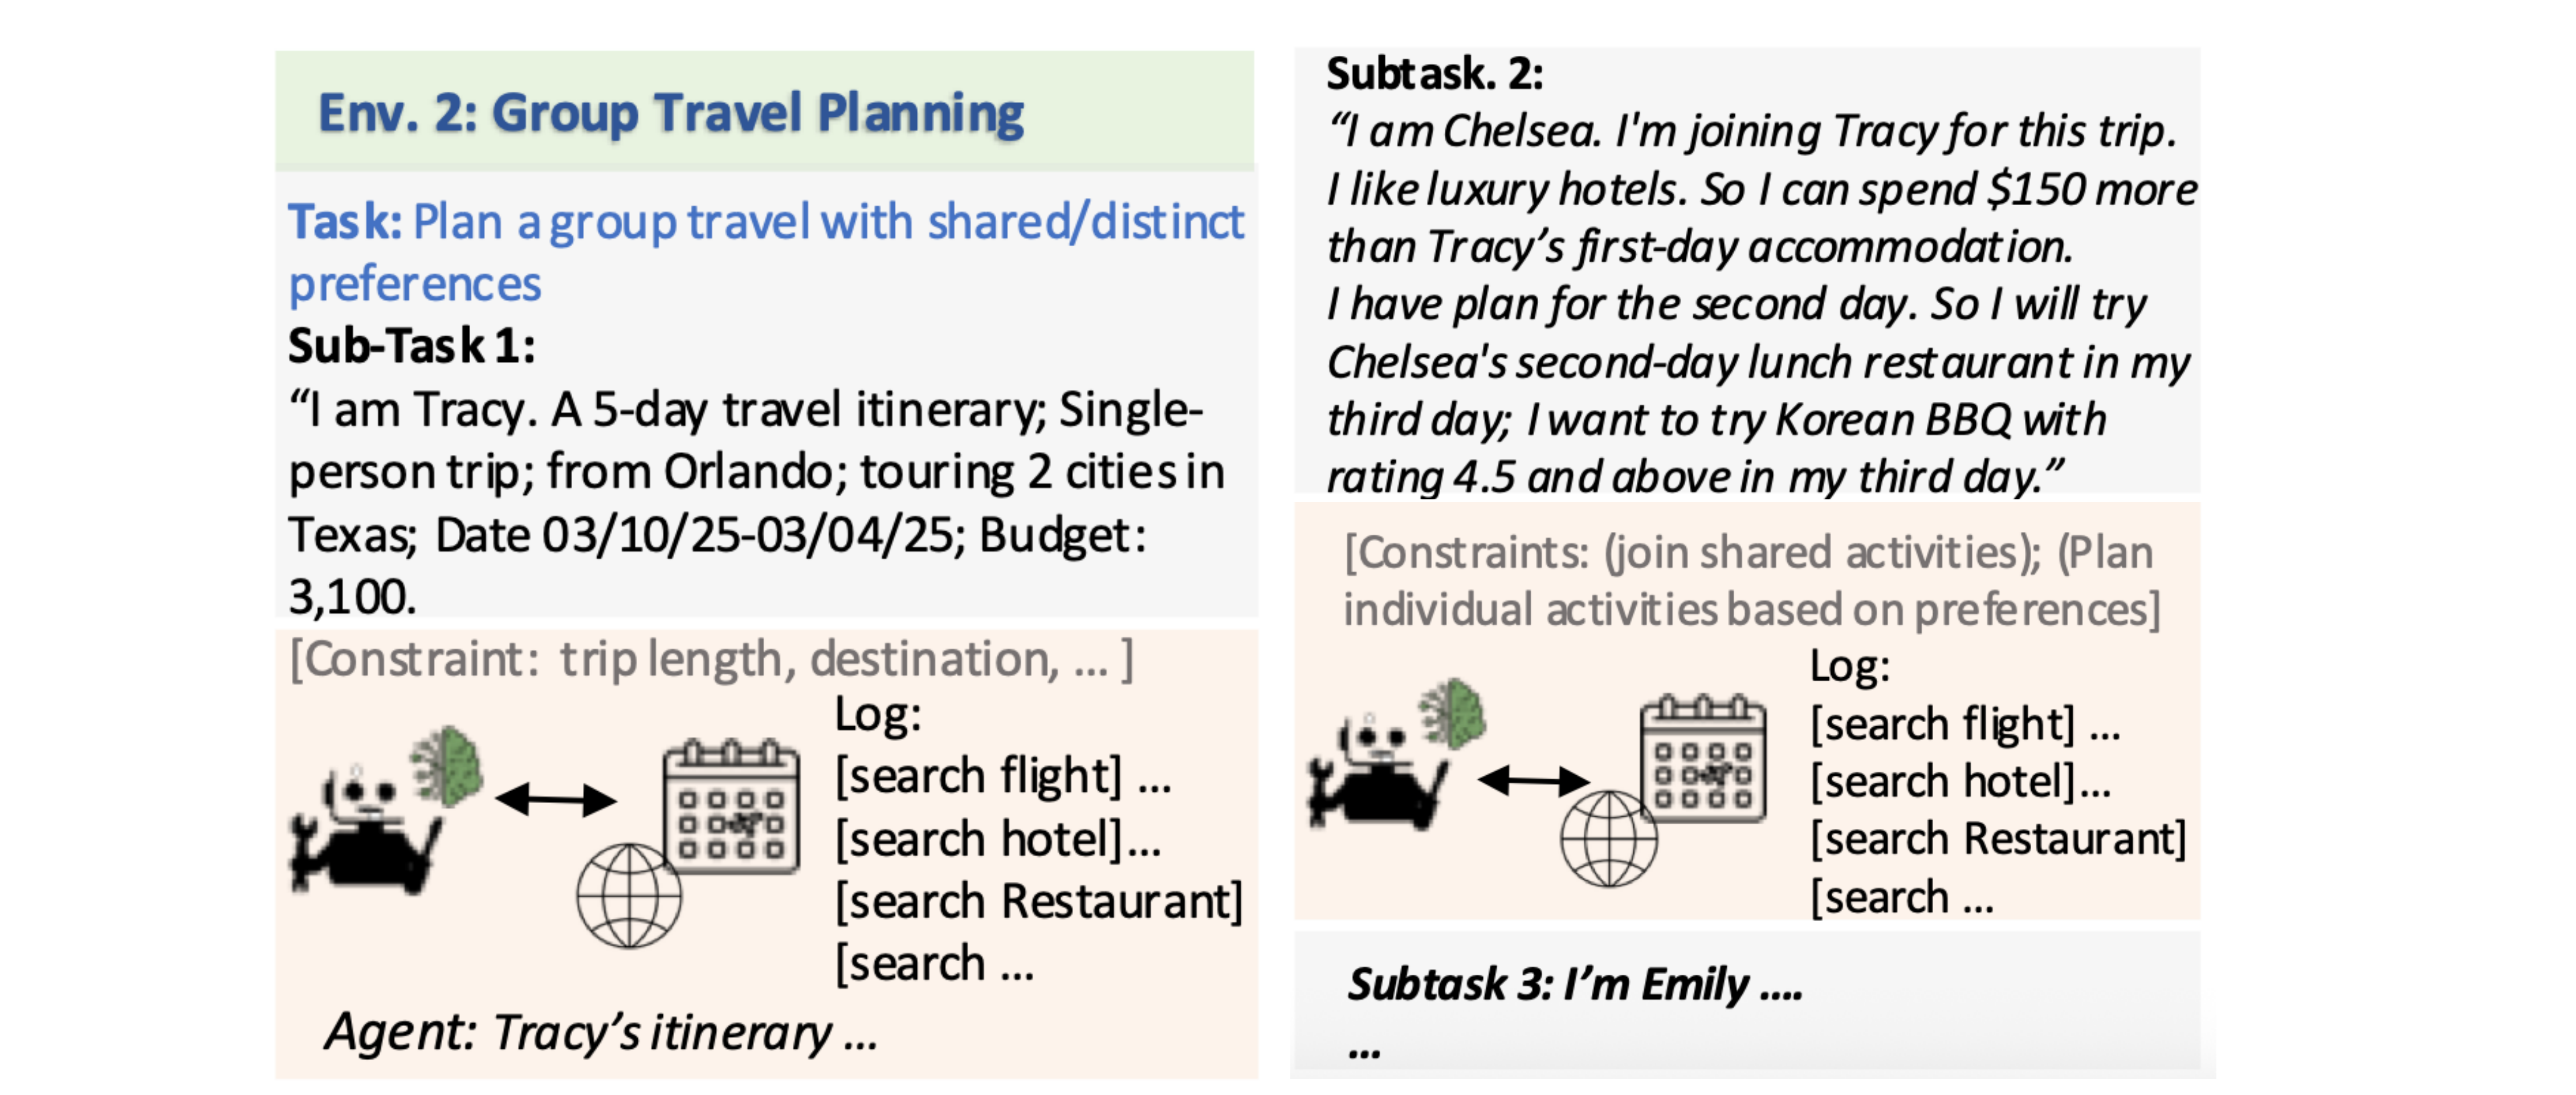
图 19 先看左侧第一位旅客的计划,再看右侧后来加入的人和新增要求。后面的任务需要查回前面的安排,同时处理刚给出的条件。 来源 [18]MemoryArena 原论文(2026)
比起只问一个事实,这类评测更贴近 Agent 最后的表现。出现失败时,需要看是记忆取不到、规划理解错了,还是搜索工具没能完成。原论文里,有些单独加装记忆组件的方案,在这类任务上的成绩仍然偏弱。把相关条目存下来只是第一步,后续规划有没有用上它,还得由整个系统的结果来验证。
06 记住之后,还得知道什么时候该用
有些信息当场看不出以后会不会用。比如在约例会时开玩笑说「十点以前的会我都不认」,可以先把它当作当前排期的线索。若要记成所有会话都适用的长期偏好,就得看用户后面有没有确认。全留会让检索越来越吵,删得太急又可能丢掉还没做完的承诺。来源、时间、适用场景和是否已被替代,能帮后来的读逻辑做判断。
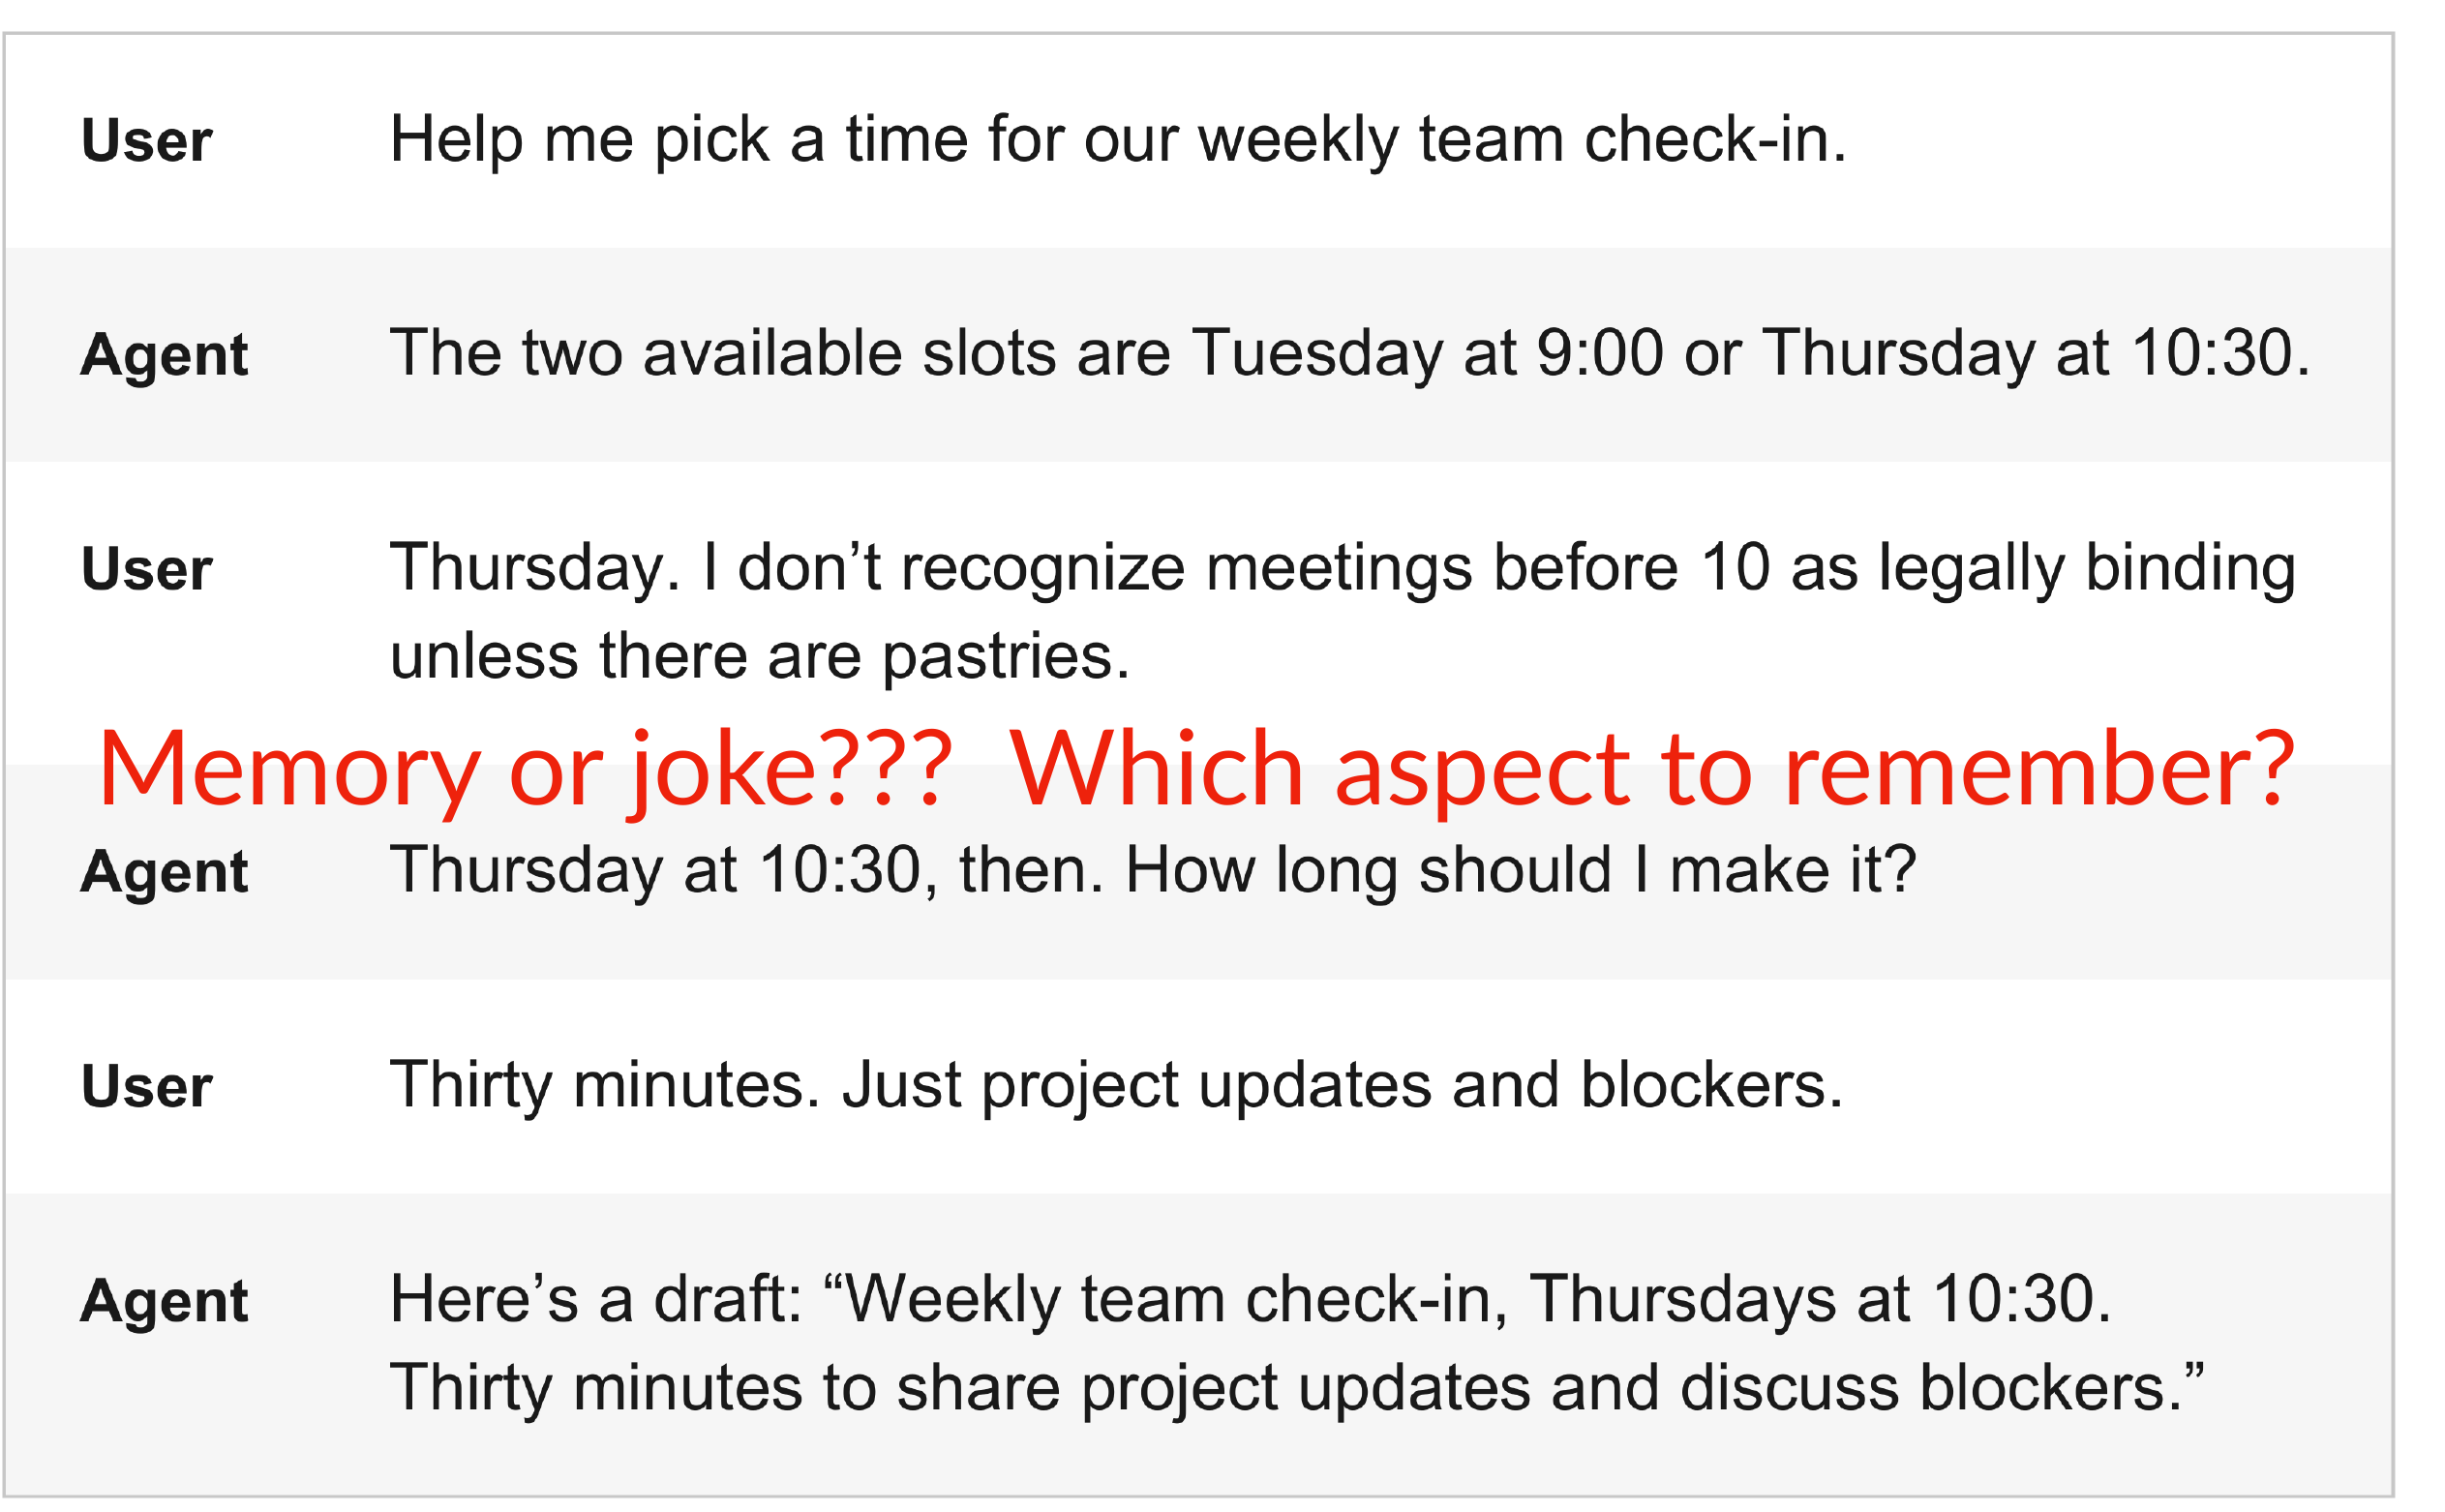
图 20 图里的对话是在约例会,中间一句话很像时间偏好,也可能只是玩笑。当前把时间约好,和以后所有会议都遵守同一条规则,需要分开决定。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
另一件事是谁能用这条记忆。存了某条私人的信息,很可能只适合当前用户自己看。拿这些信息发给第三方时,要重新检查接收方、任务和授权,能少带就少带。PrivacyLens 就用带有具体场景和接收方的任务,测系统会不会把不合适的信息写进外发内容。写入记忆时也要考虑来源可信度,工具返回的内容适合用作证据,读到的文字能否成为长期行动规则,应由应用额外判断[19]。
记忆也会用多。用户让你查一个通用问题,不一定希望每次都把它和自己的职业、住址或者旧对话扯在一起。过度个性化就是在不相干的情况下,模型仍硬套历史偏好。评测最好配一组需要用记忆的题,也配一组应该忽略旧信息的题。有时问题出在检索带回了太多,另外一些情况则是模型不会筛掉无关材料[20]。
回到面试题「Agent 的长短期记忆怎么存」。我会先拿一个业务场景讲,当前目标和最近工具结果放在工作上下文里,历史记录和长期偏好另存,需要时按用户、时间和任务范围找回来。然后说清楚什么时候写、冲突怎么更新、用户怎样能核对或删除。最后拿几条跨会话任务跑一遍,检查有没有找回最新证据、有没有办对事,以及该忽略的记忆有没有乱用。
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]PersonaMem 动态用户偏好评测(2025)
https://arxiv.org/abs/2504.14225
[3]Agent Workflow Memory 原论文(2024)
https://arxiv.org/abs/2409.07429
[4]MemGuide 跨会话记忆选择研究(2025)
https://arxiv.org/abs/2505.20231
[5]CoALA 语言 Agent 认知架构(2023)
https://arxiv.org/abs/2309.02427
[6]Zep 时序知识图谱研究(2025)
https://arxiv.org/abs/2501.13956
[7]Voyager 原论文(2023)
https://arxiv.org/abs/2305.16291
[8]Anthropic Agent Skills 官方说明
https://platform.claude.com/docs/en/agents-and-tools/agent-skills/overview
[9]MemGPT 原论文(2023)
https://arxiv.org/abs/2310.08560
[10]MemoryOS 原论文(2025)
https://arxiv.org/abs/2506.06326
[11]Reflexion 原论文(2023)
https://arxiv.org/abs/2303.11366
[12]Generative Agents 原论文(2023)
https://arxiv.org/abs/2304.03442
[13]Sleep-time Compute 原论文(2025)
https://arxiv.org/abs/2504.13171
[14]A-MEM 原论文(2025)
https://arxiv.org/abs/2502.12110
[15]Mem0 原论文(2025)
https://arxiv.org/abs/2504.19413
[16]LoCoMo 长期对话记忆评测(2024)
https://aclanthology.org/2024.acl-long.747/
[17]LongMemEval-V2 原论文(2026)
https://arxiv.org/abs/2605.12493
[18]MemoryArena 原论文(2026)
https://arxiv.org/abs/2602.16313
[19]PrivacyLens 隐私规范评测(2024)
https://arxiv.org/abs/2409.00138
[20]OP-Bench 过度个性化评测(2026)
https://arxiv.org/abs/2601.13722
[21]LangChain 文件式记忆设计说明
https://www.langchain.com/blog/how-we-built-agent-builders-memory-system
[22]Letta · Sleep-time Compute 示例图
https://www.letta.com/blog/sleep-time-compute/