TechGuide「AI Agent 面试专题」第 5 篇 · 框架与编排
正文约 5100 字 · 预计阅读 11 分钟
大家好,我是声哥。
上一篇讲清楚了一次工具调用。这篇把事情再往前推一步,一封邮件进来,提取日程、检查时间、写入日历,怎么把这几步串起来?中间挂了又从哪儿接着跑?我用同一个例子聊清几个常见框架各管什么。文章脉络会跟着斯坦福大学《Engineering AI Agents》课程来走,也作为我的学习笔记,持续更新,欢迎关注。
01 一个 Agent 系统要先想清楚哪三件事?
假设我想做一个自动录入日历的功能。拿来一封邮件,系统识别出周五上午十点有个会,把日程写进去。一个可演示的版本可能很快就能跑出来。再问两句,它能处理「下周五」,还是只能处理写了具体日期的邮件?遇到通知、推广邮件,怎么知道它不会顺手加一个日程?
我会把事情分成三块。数据是系统会遇到的输入,外加示例、运行轨迹和人工反馈。系统是执行任务的模型、工具、工作流。评测和指标负责判断结果值不值得信,包括日期时间填得对不对、普通邮件误建了多少日程、每封邮件花多久。后面调模型、提示词和流程,都要回这三个地方看。
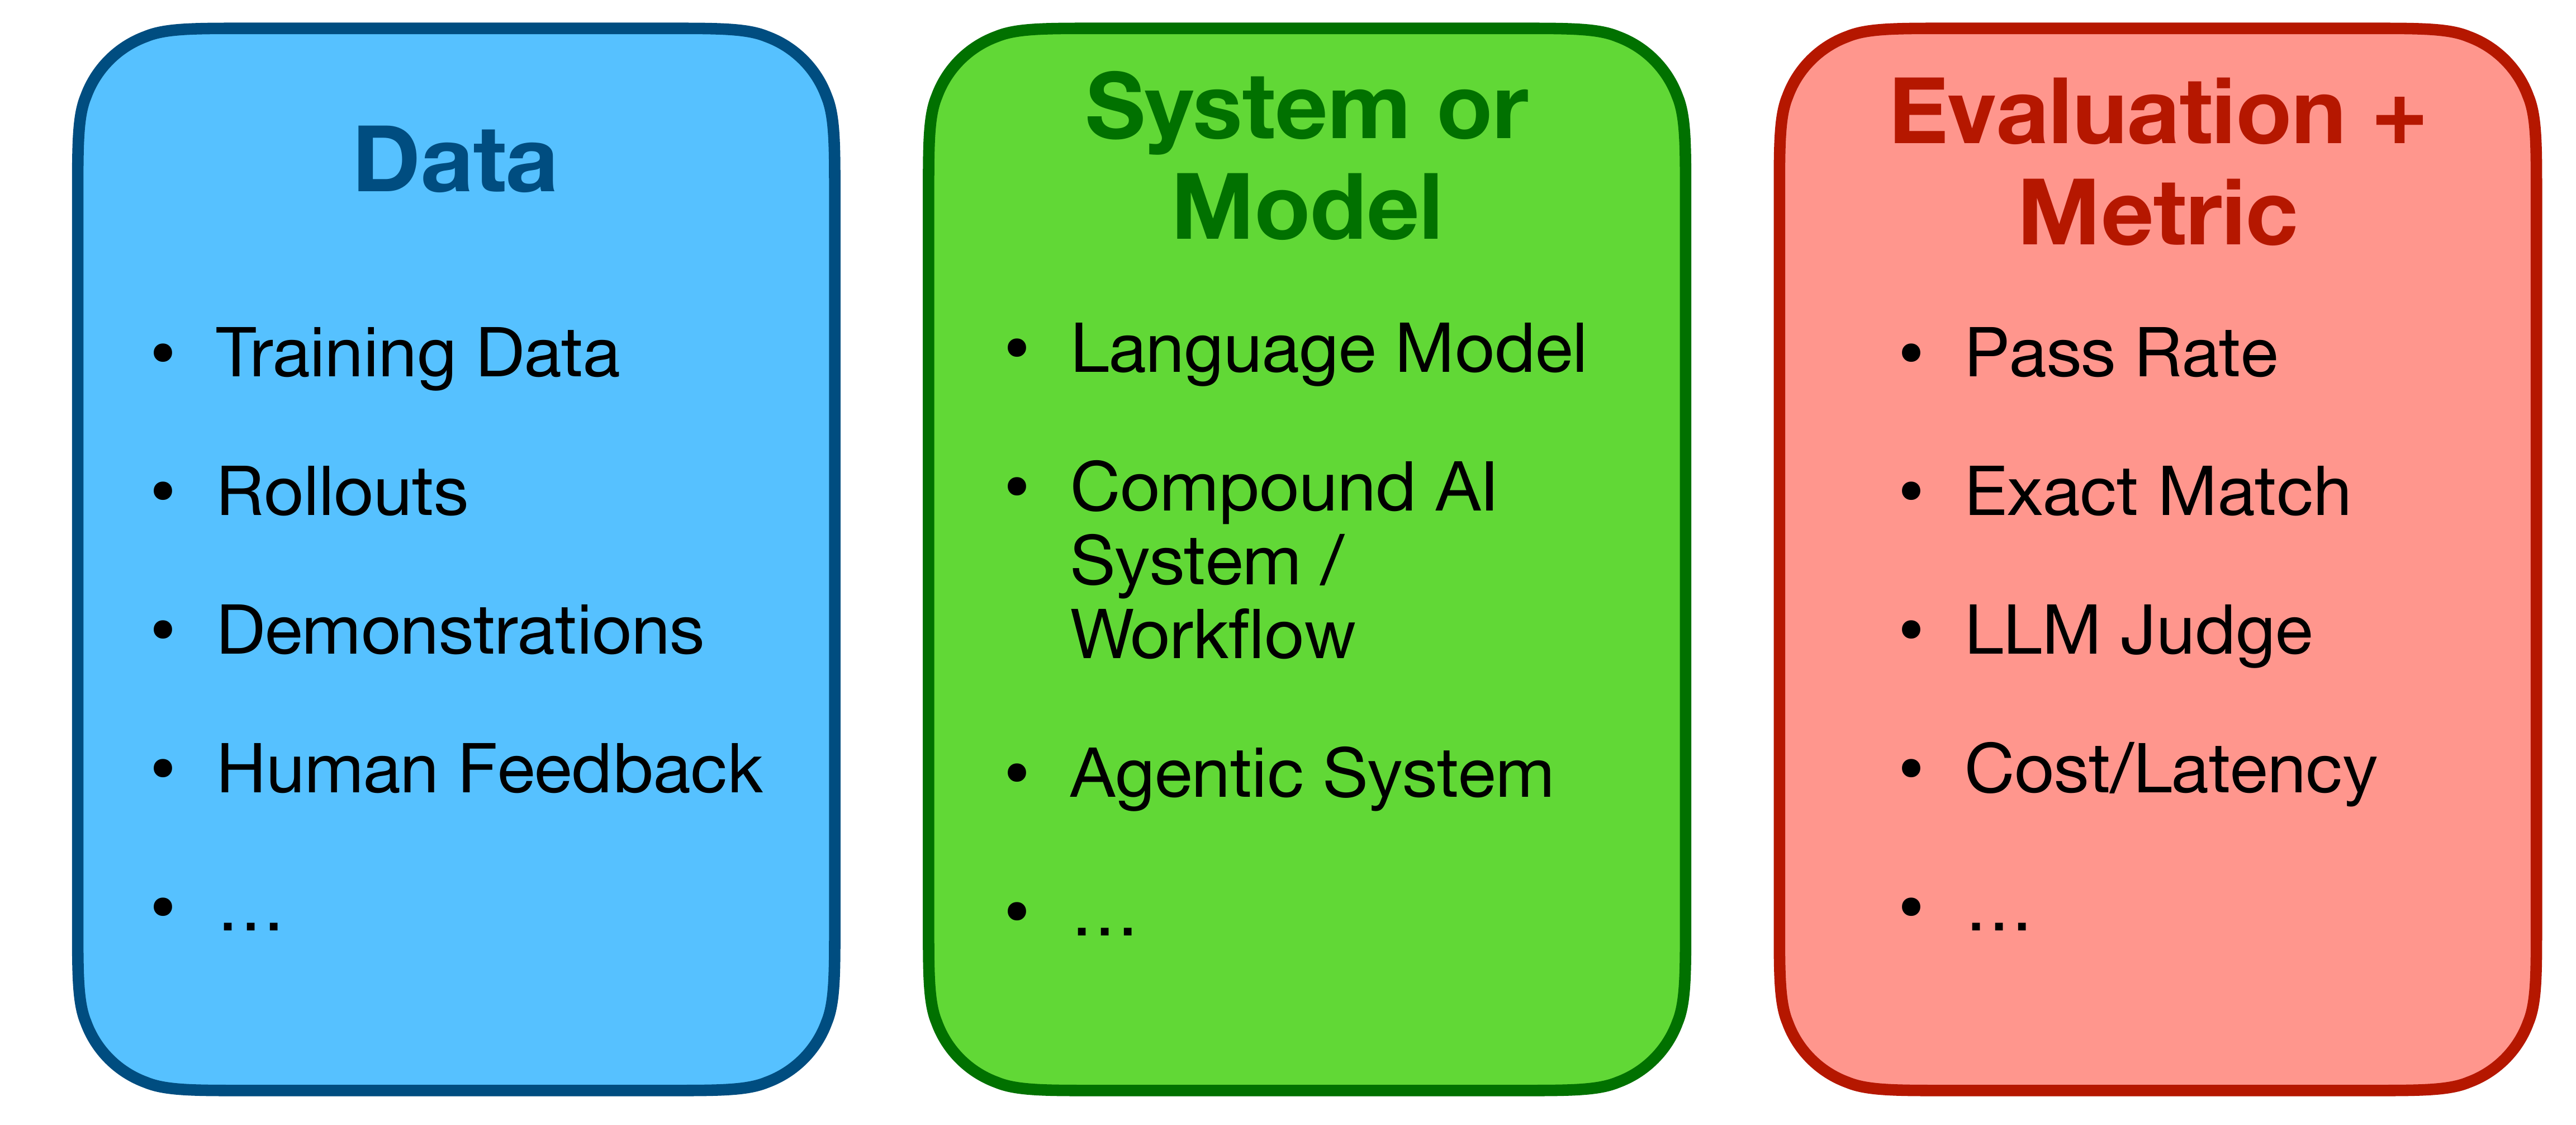
图 01 蓝色是可用于训练和评测的数据,绿色是实际运行的系统,红色是用来衡量效果的指标。三块放在一起才有办法判断改动有没有用。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
框架提供的抽象也分层。最左边是单次模型调用。往右,把几次模型调用和普通代码拼成工作流,程序负责决定下一步。再往右,给模型更多选择空间,让它根据上一轮工具结果决定接着做什么,这时候就会用到 Agent 的运行框架,也叫 Agent Harness。还有两件事贯穿整个系统,怎么保证任务出了故障能接着跑,怎么从记录里定位问题。这是编排和可观测性要回答的问题。
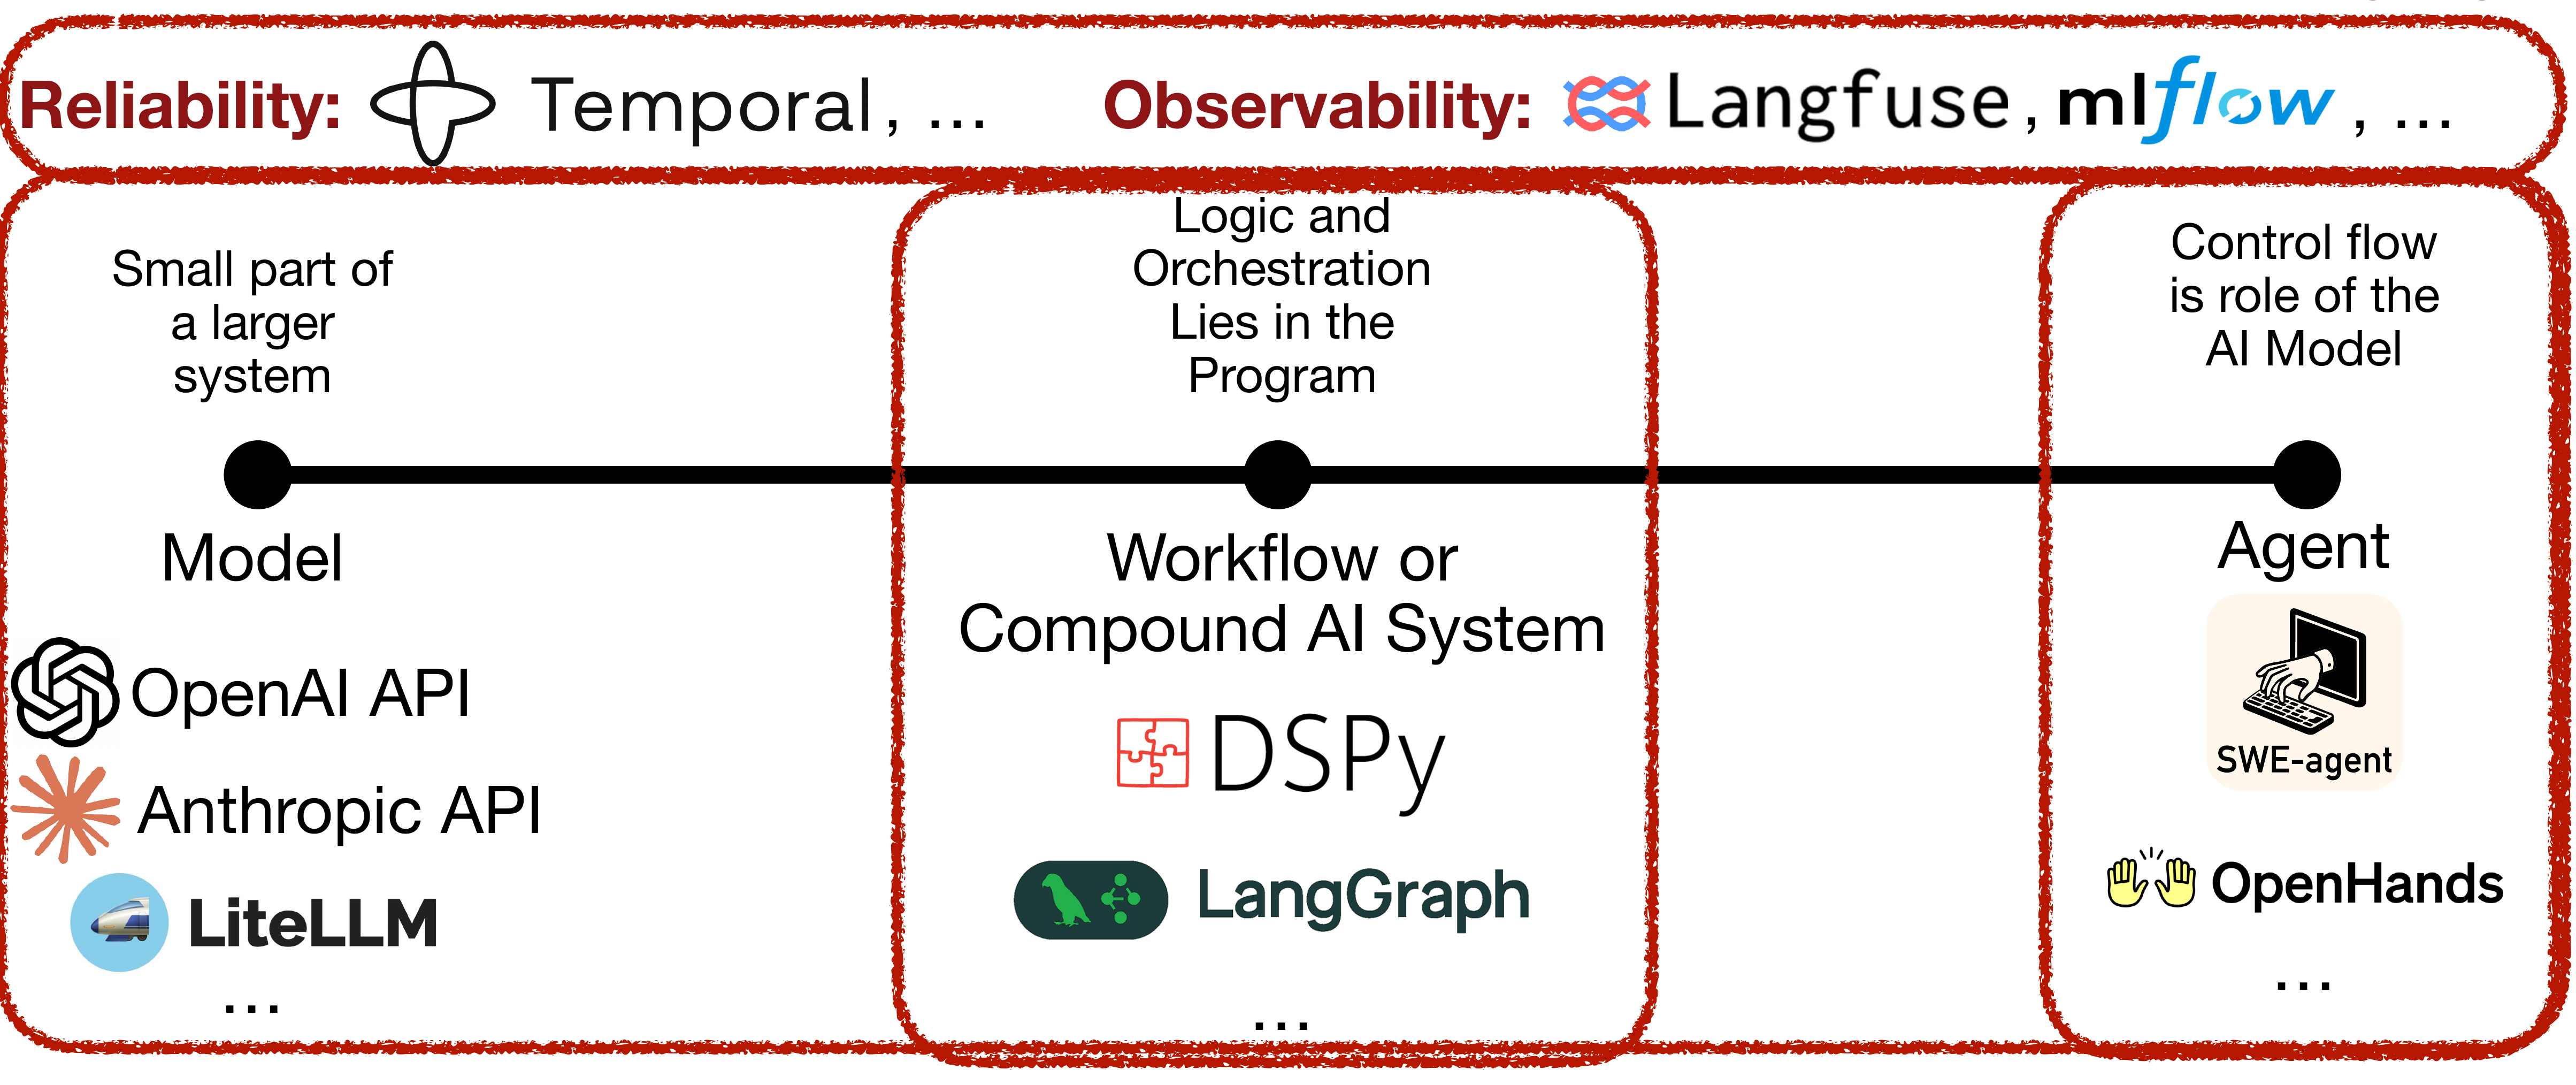
图 02 中间的工作流主要由程序决定走哪条分支,右边的 Agent 允许模型根据结果选择下一步。顶上的可靠性和可观测性横跨整条链。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
02 DSPy 怎么把模型调用写成能评测的程序?
Signature 指定要做什么
DSPy把常见工作拆成三部分。Signature(签名)定义输入和输出。Module(模块)决定怎么调用模型、怎么组合几段逻辑。Optimizer(优化器)根据样本和评分改进提示词等可优化部分[2]。
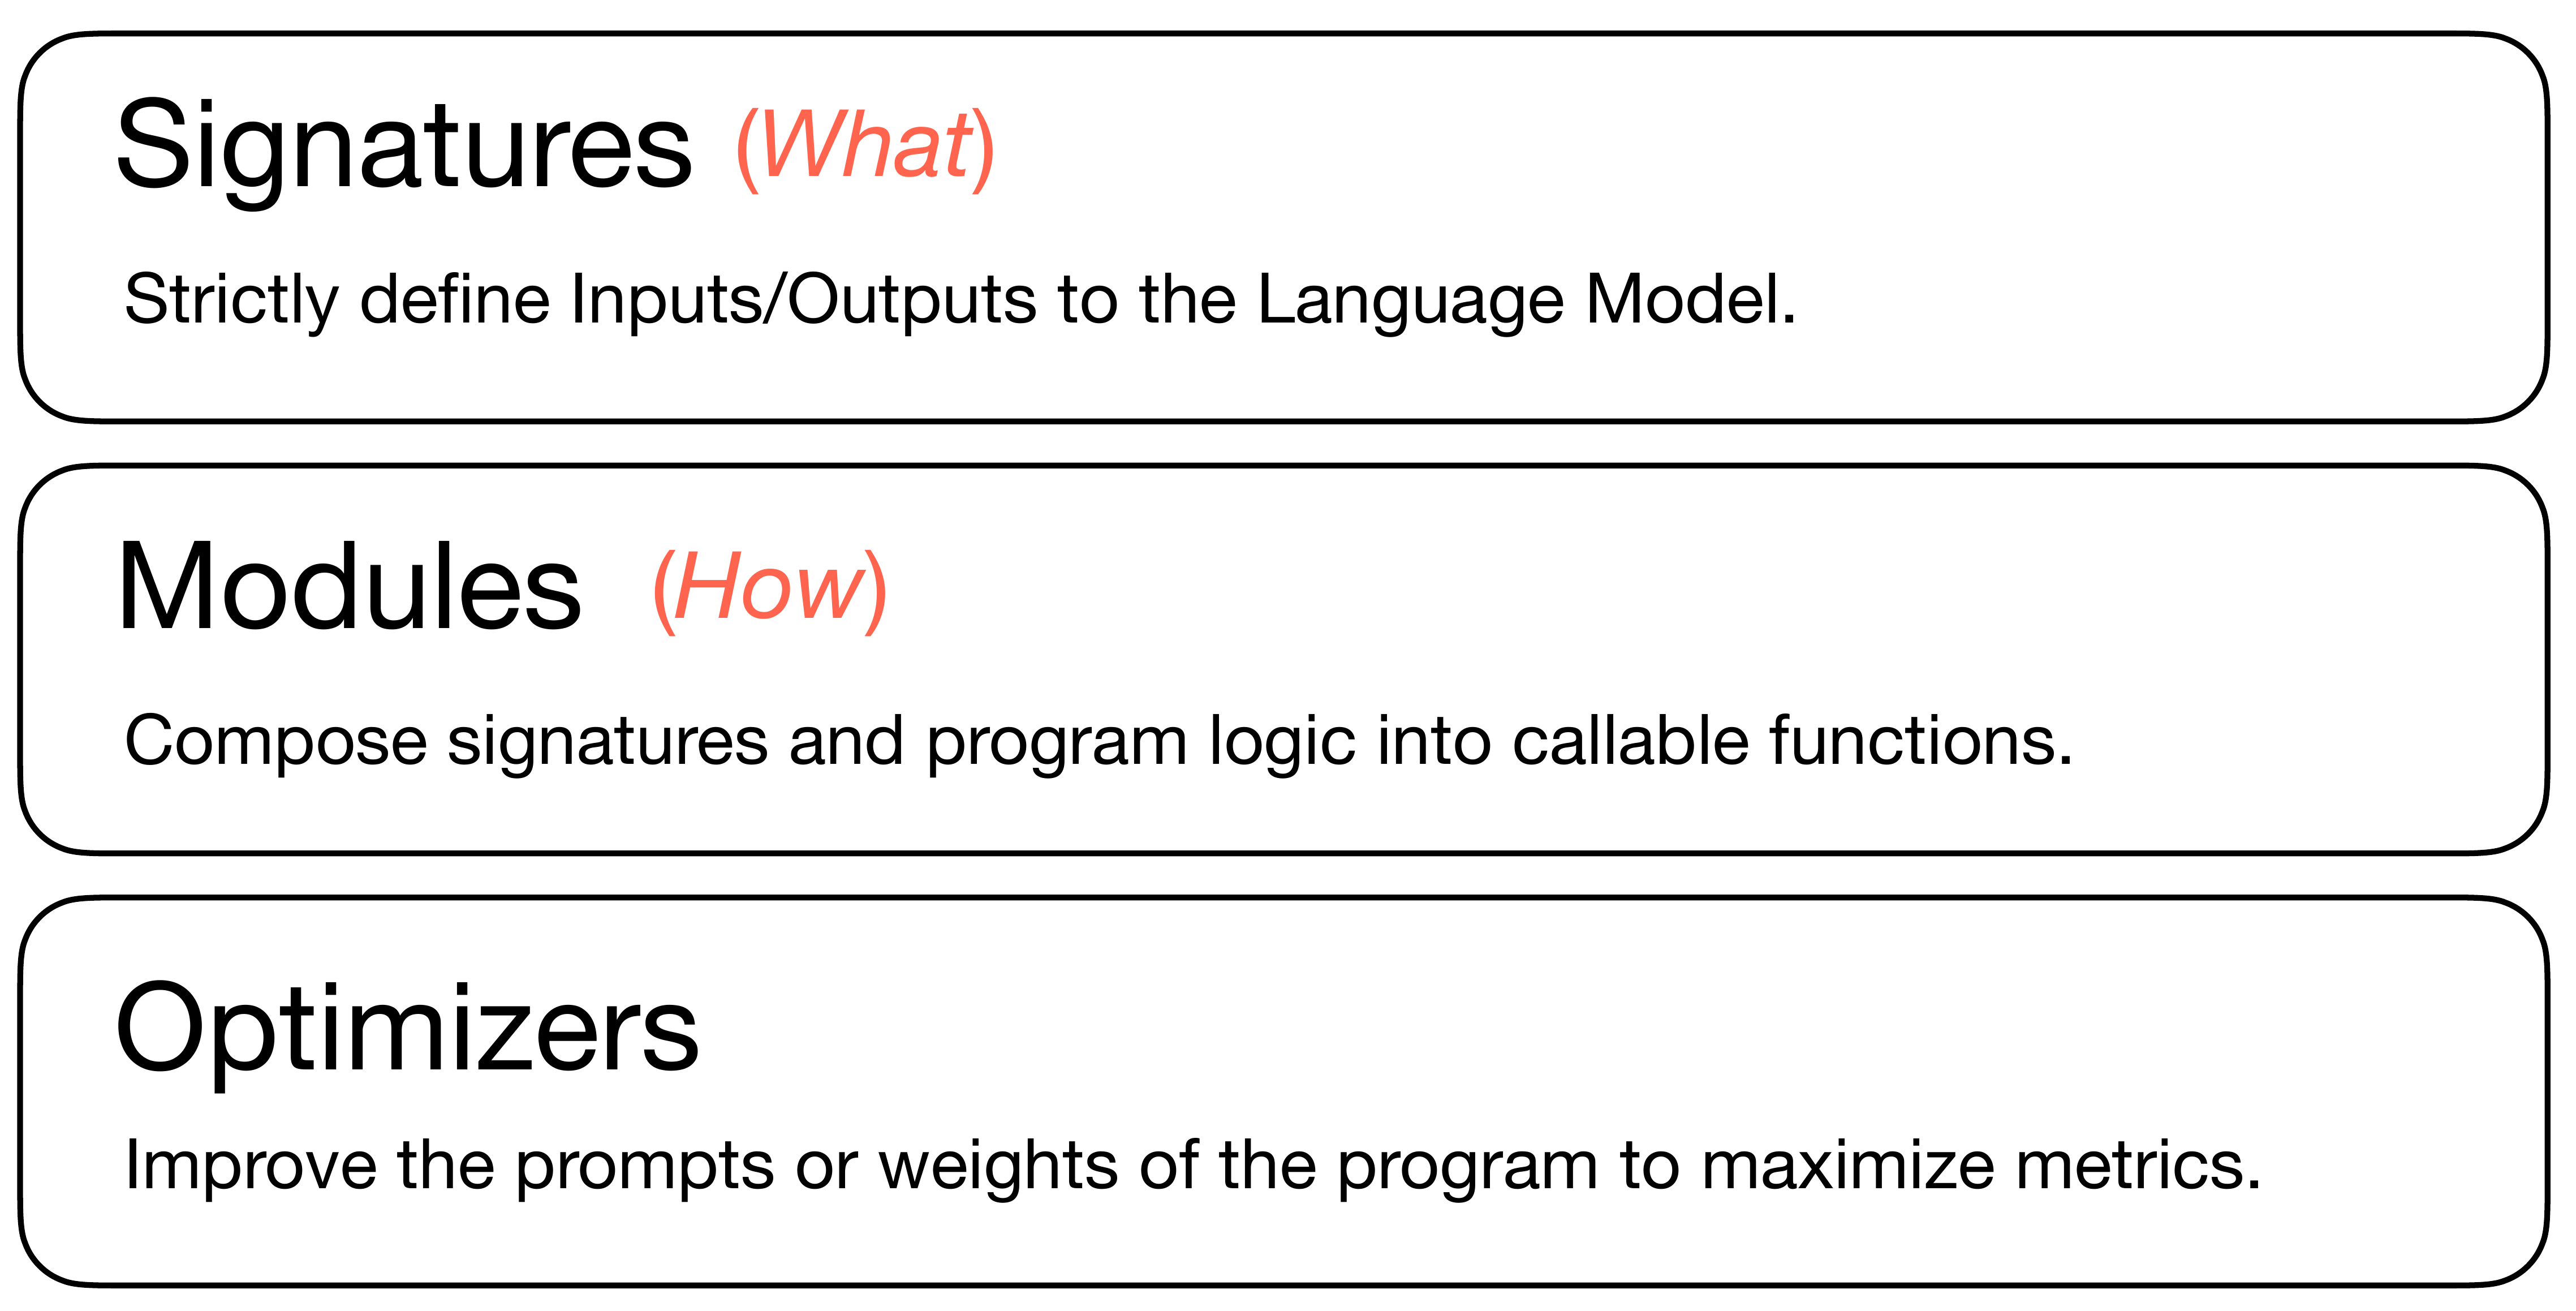
图 03 上面的 Signature 约定输入输出,中间的 Module 决定怎么调用和组合,下面的 Optimizer 用评测反馈改进程序里可调整的部分。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[2]DSPy 原论文(2023)
签名最短能写成「一条消息进来,一个情绪标签出去」。可是标签要是任意字符串,同一个意思可能写成 positive、Positive 或一整句话,后面的代码还得猜。需要精确标签时,可以把允许的输出做成枚举,或者明确要求输出字段。给邮件提取日程也是一样。输入是邮件文本,输出拆成事件名、日期、开始时间和持续时长,没法确定的字段可以为空。DSPy 会按签名和适配器生成模型请求、解析返回。格式正确以后,日期和时区仍然要单独检查。
Module 把模型调用和业务分支串起来
简单的 Predict 可以拿着签名直接调用模型。ChainOfThought 在输出里加入推理字段,再让模型填后面的结果。两个模块也可以装到一起,写成一个像普通 Python 函数一样调用的流程。
日历例子是这么串的。先从邮件提取日程,检查事件名、日期和开始时间。如果前置字段不够,就返回「未找到可录入的日程」。如果字段齐,就让另一个模型调用选一个能代表事件的表情,再通过日历接口新建事件。原示例里没写持续时长时默认一小时,这一步是程序规则,知道它在哪儿,就知道设错了该改哪段。普通邮件走到前置校验就结束,也能省一次模型调用。
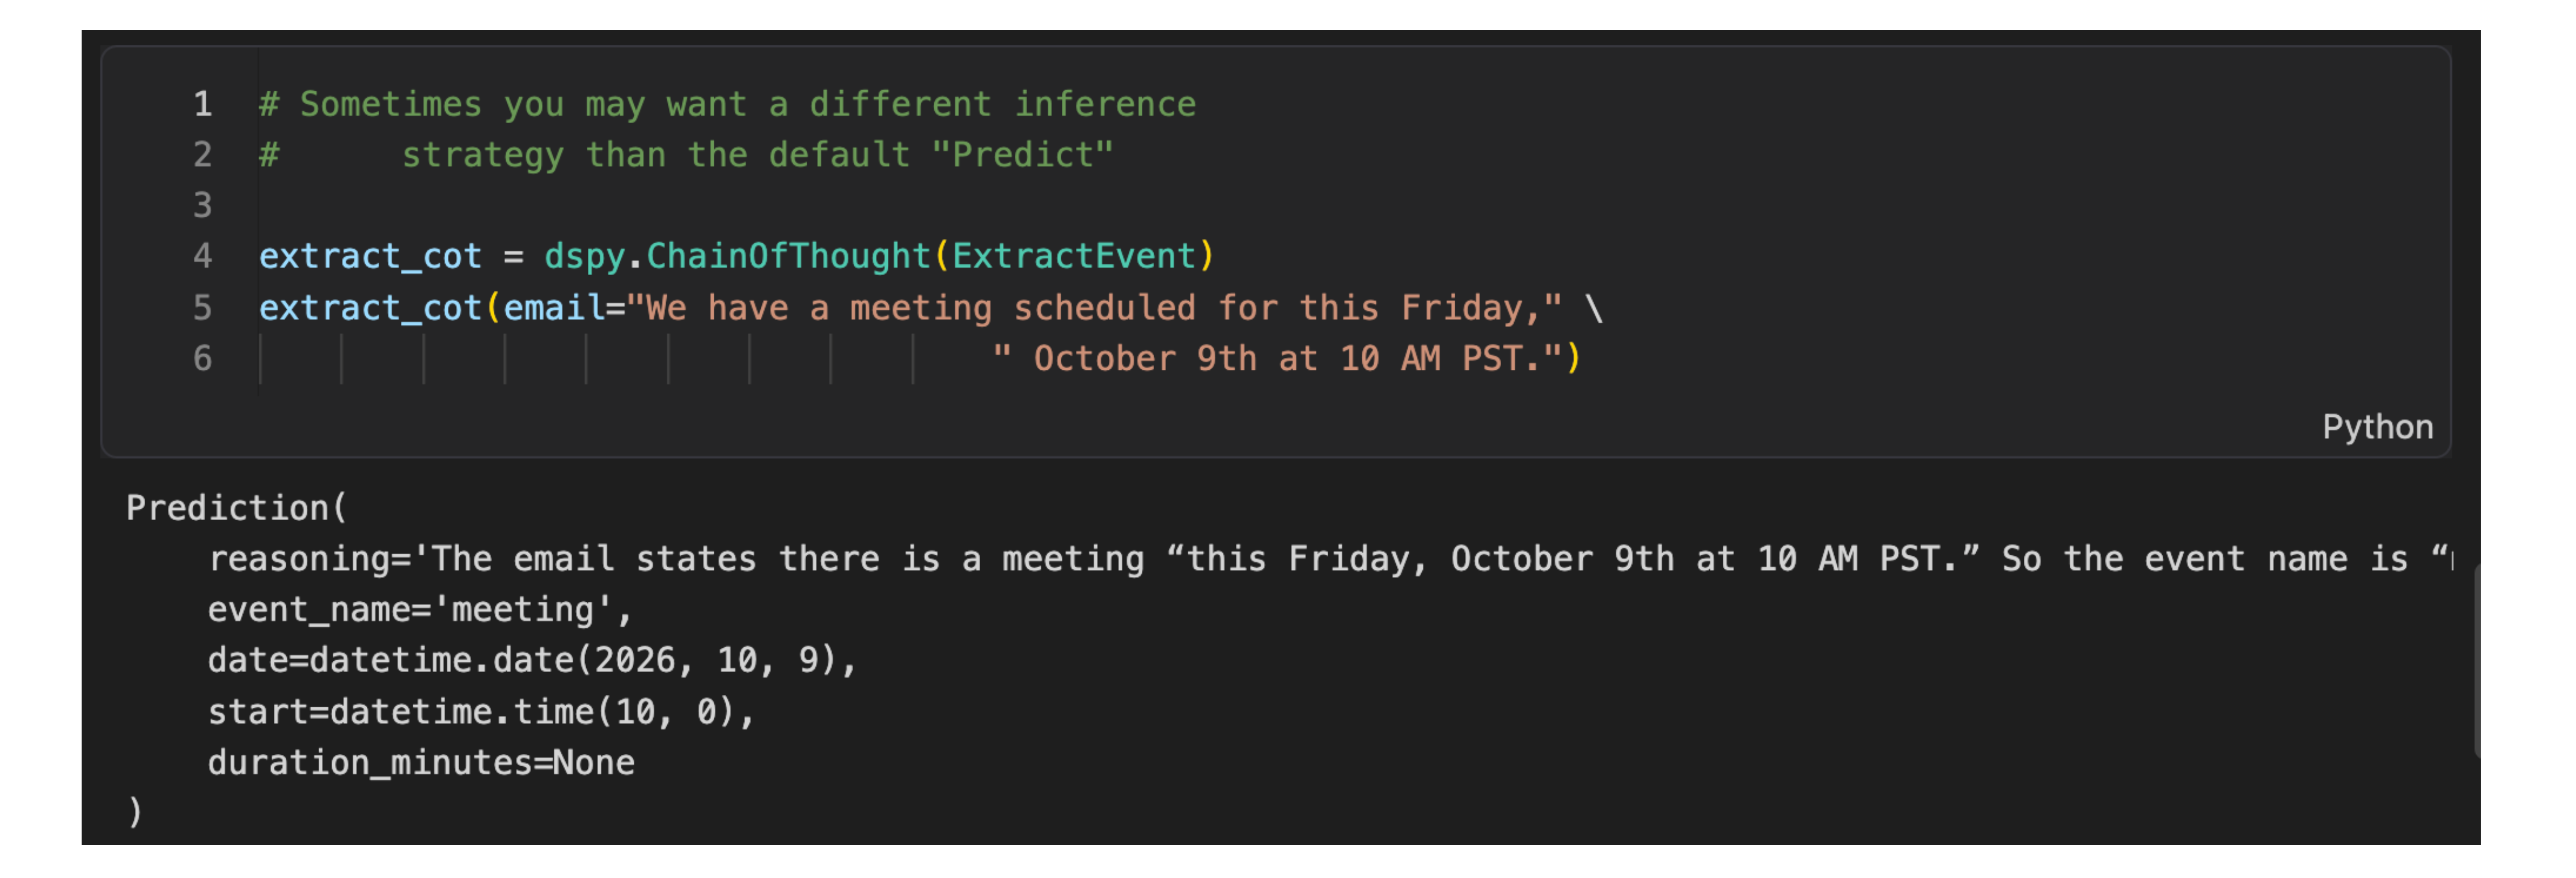
图 04 下半部分是模型的输出。除了推理字段,还有事件名、日期、开始时间和持续时长,后续代码可以逐个读取。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[2]DSPy 原论文(2023)
Optimizer 要先有样本和评分
在日程提取这个小例子里,用了 50 封有标签的合成邮件。30 封用来做优化,20 封留着看结果。评分只核对日期、开始时间和持续时长。三个都吻合得 1 分,任意一个错了得 0 分。事件名没加入精确匹配,因为「组会」和「每周组会」可能都能用。优化器还可以拿到文本反馈,比如「开始时间猜错了一小时」,比只有一个 0 分更容易知道从哪下手。
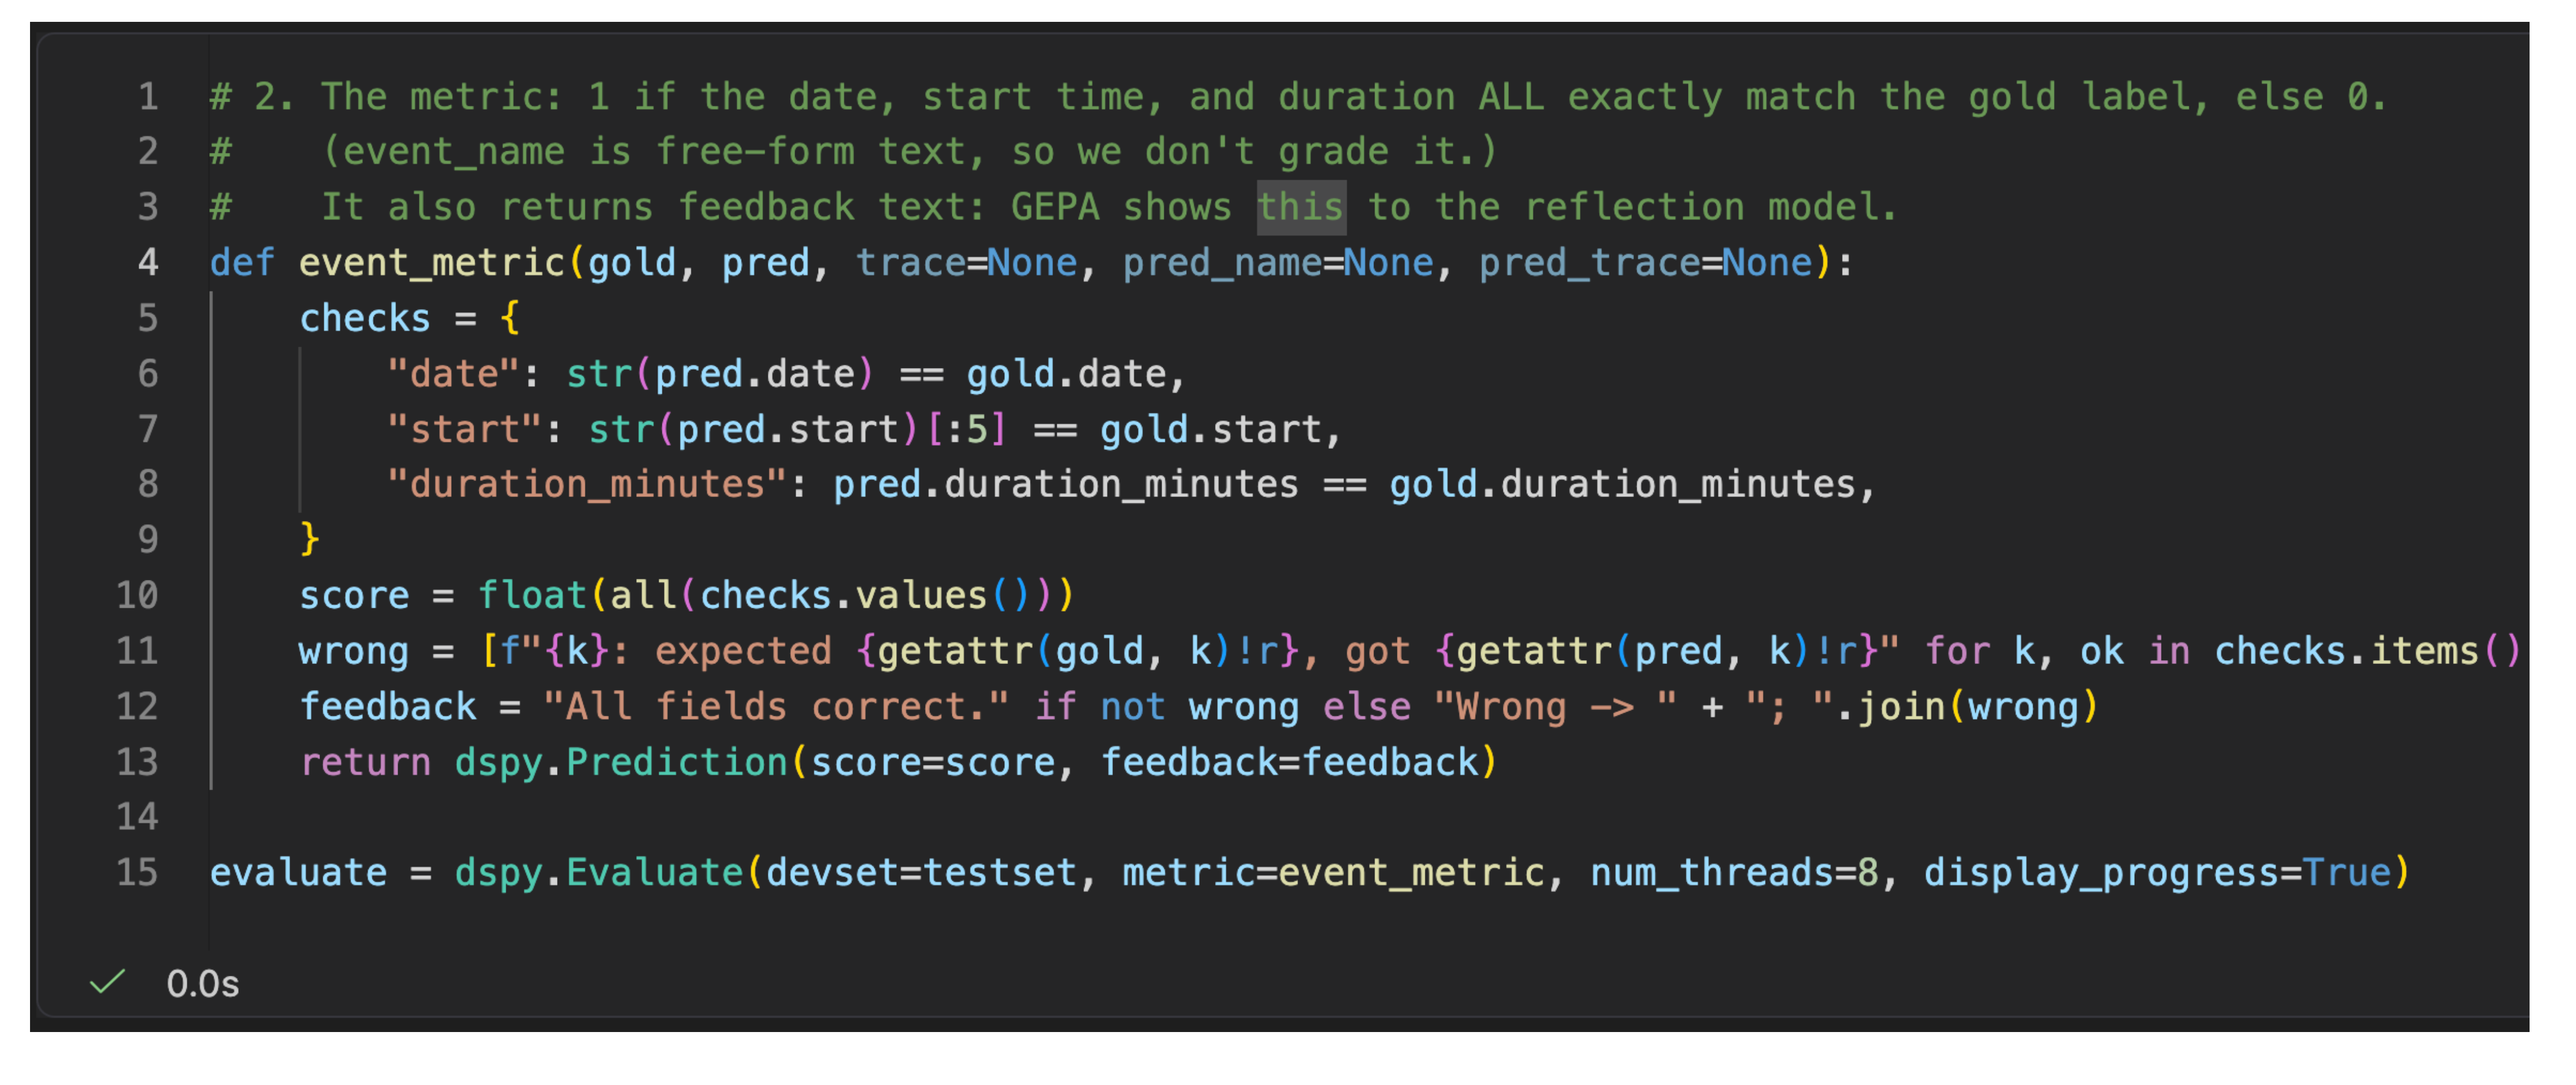
图 05 代码里分别对照日期、开始时间和持续时长。all 是三条都成立才给分。下面还把失败的字段写成反馈,供优化器参考。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
这个示例用 GEPA做提示词优化。它跑一批样本,看调用轨迹和反馈,提出改写方案,再用评分筛选。比如原来只说「从邮件提取日程」,改过的指令会把相对日期、时间格式和空值要求交代得更细。对应的演示里,Gemma 3 12B 从 20 封里答对 11 封,提高到 20 封全部匹配,动的是提取模块的提示词。这个小样本很适合看清流程。拿去处理真实邮箱时,要补上时区冲突、多个备选时间、过期转发这些情况,再看收益能不能保持[3]。
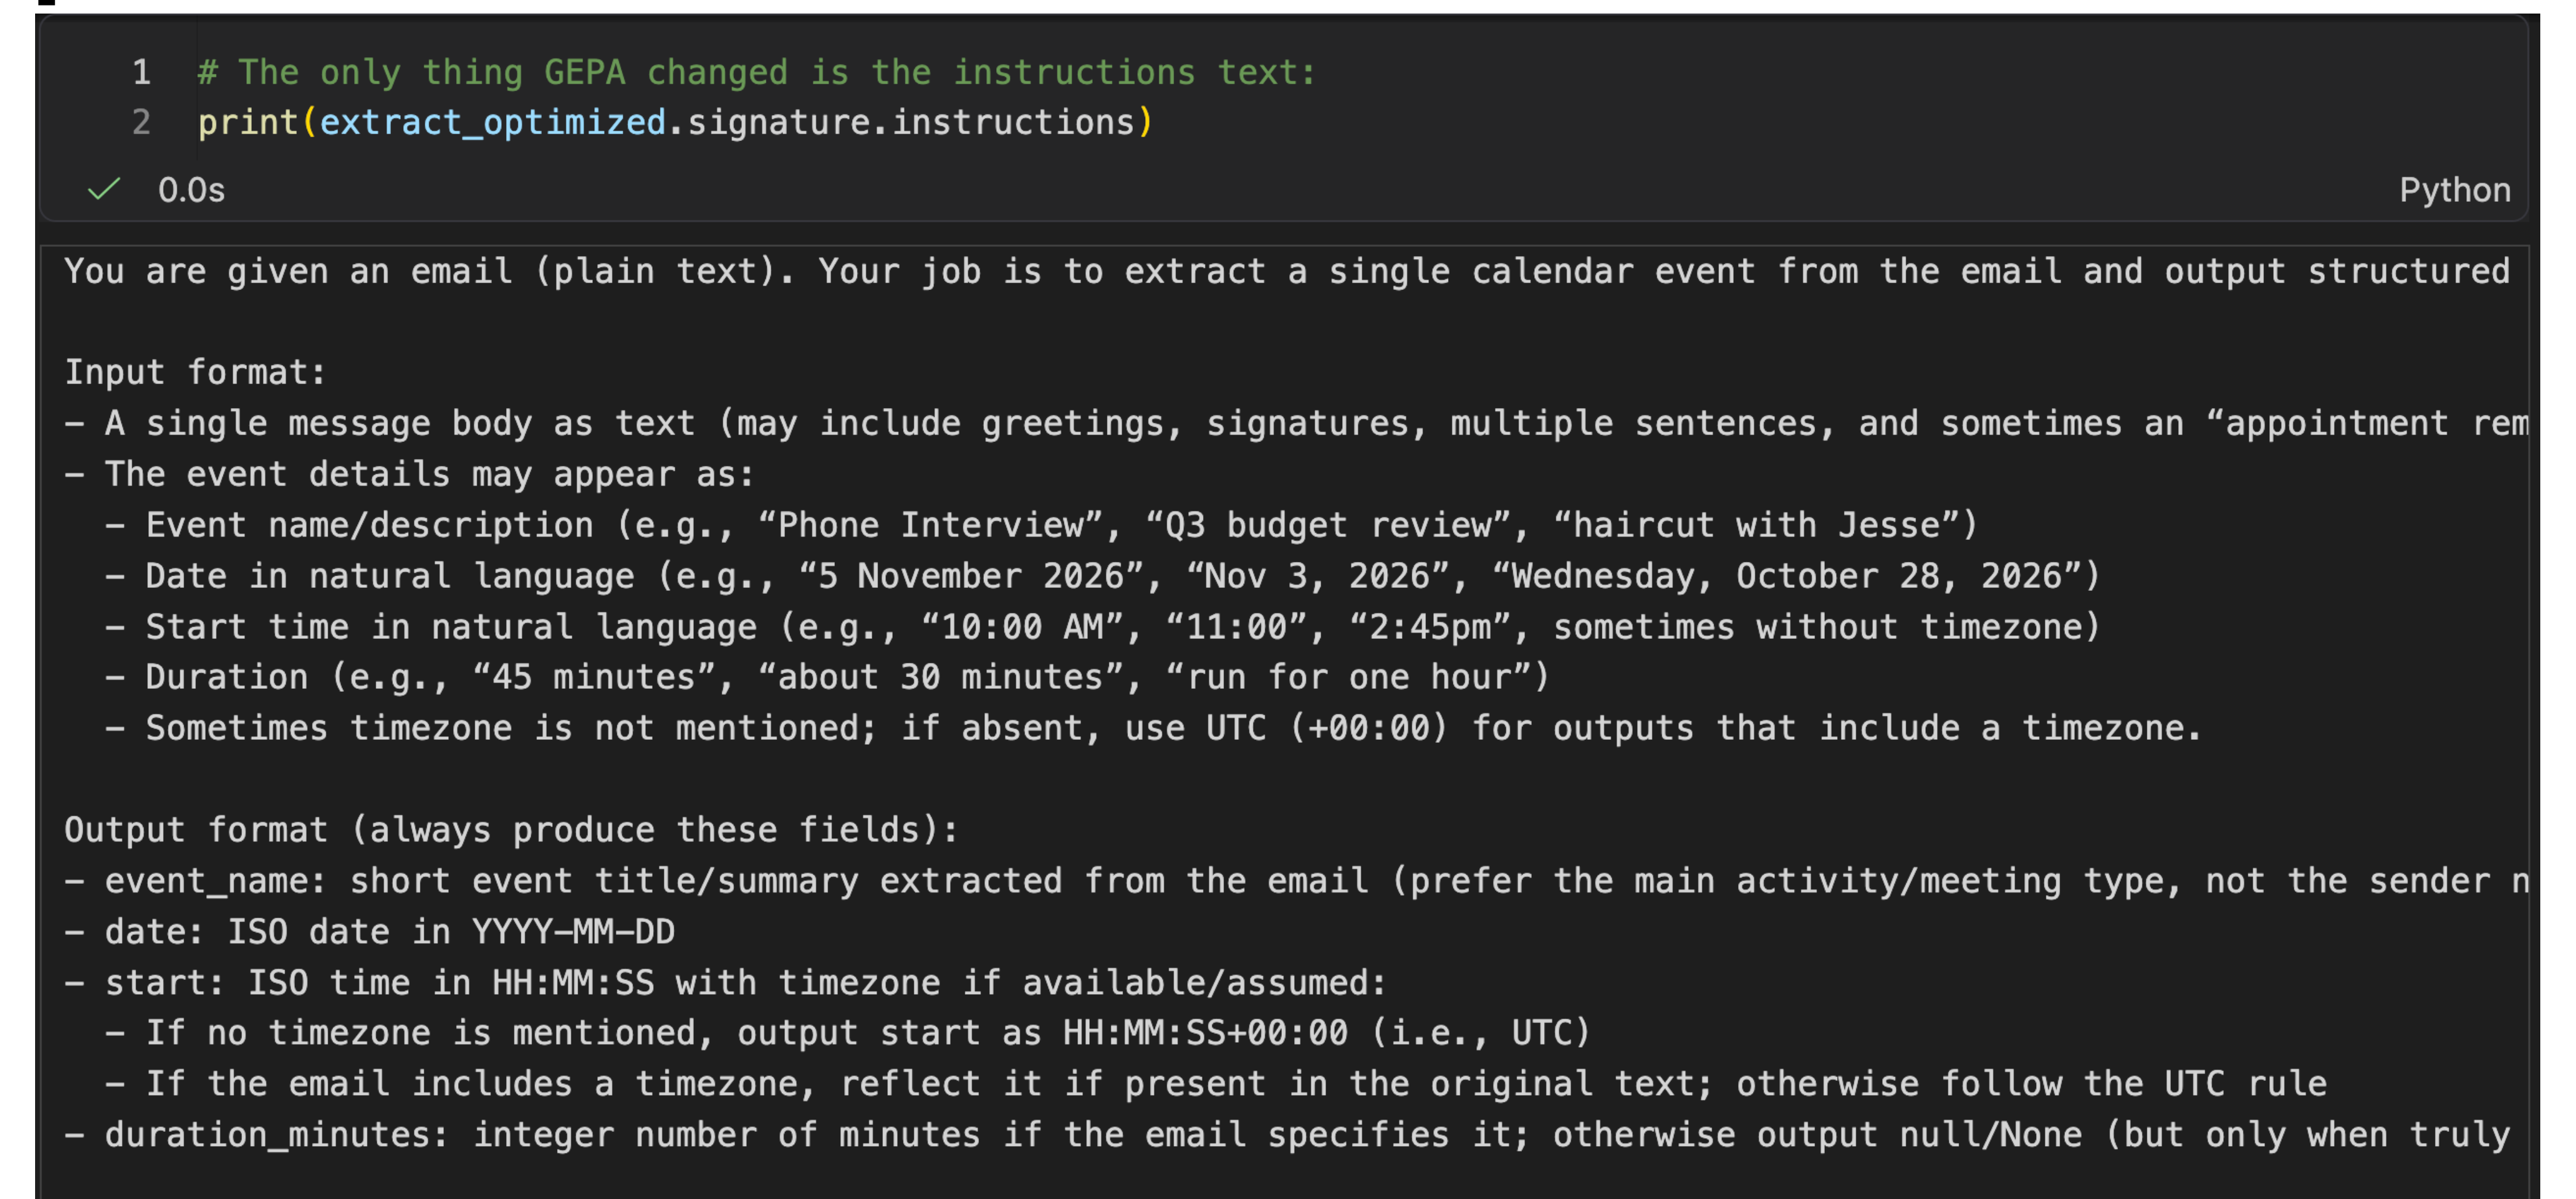
图 06 截图里是优化后的日程提取要求,写出了输出字段、格式和处理缺省值的规则。优化器改的是指令,评测仍用同一套字段规则。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[3]GEPA 提示词优化论文(2025)
用优化器有运行成本。每试一个候选指令,都可能要再跑一批样本。留出来的测试集适合做最后核查,反复拿测试结果挑提示词,也会把答案挑到这组题上。还有一点,指标只算三个字段时,就算分数满了,也说明不了它会不会在没有活动的邮件里误建日程。这样的风险要放进指标里,优化器才有机会帮你改。
同一套工具也能交给模型选
换一个要求,「周三下午的课后约半小时咖啡,顺手把现有讲座都标上书本表情」。现在要先查日历,再找空位,还要更新几条已有记录。把日历函数登记给 DSPy 的 ReAct 模块,它就能按「判断下一步、调工具、读结果」的循环推进。现有日程没查出来时,可以先处理查询失败,后面的写入要继续等合适的信息。
DSPy 还提供 RLM(Recursive Language Models,递归语言模型)模块。举个和前面相连的例子,一个很长的邮箱可以作为变量放在执行环境里。模型通过代码搜索、切段,对需要仔细理解的部分发起子调用。原始内容留在执行环境,每轮输入可以只给这一步需要的片段[4]。
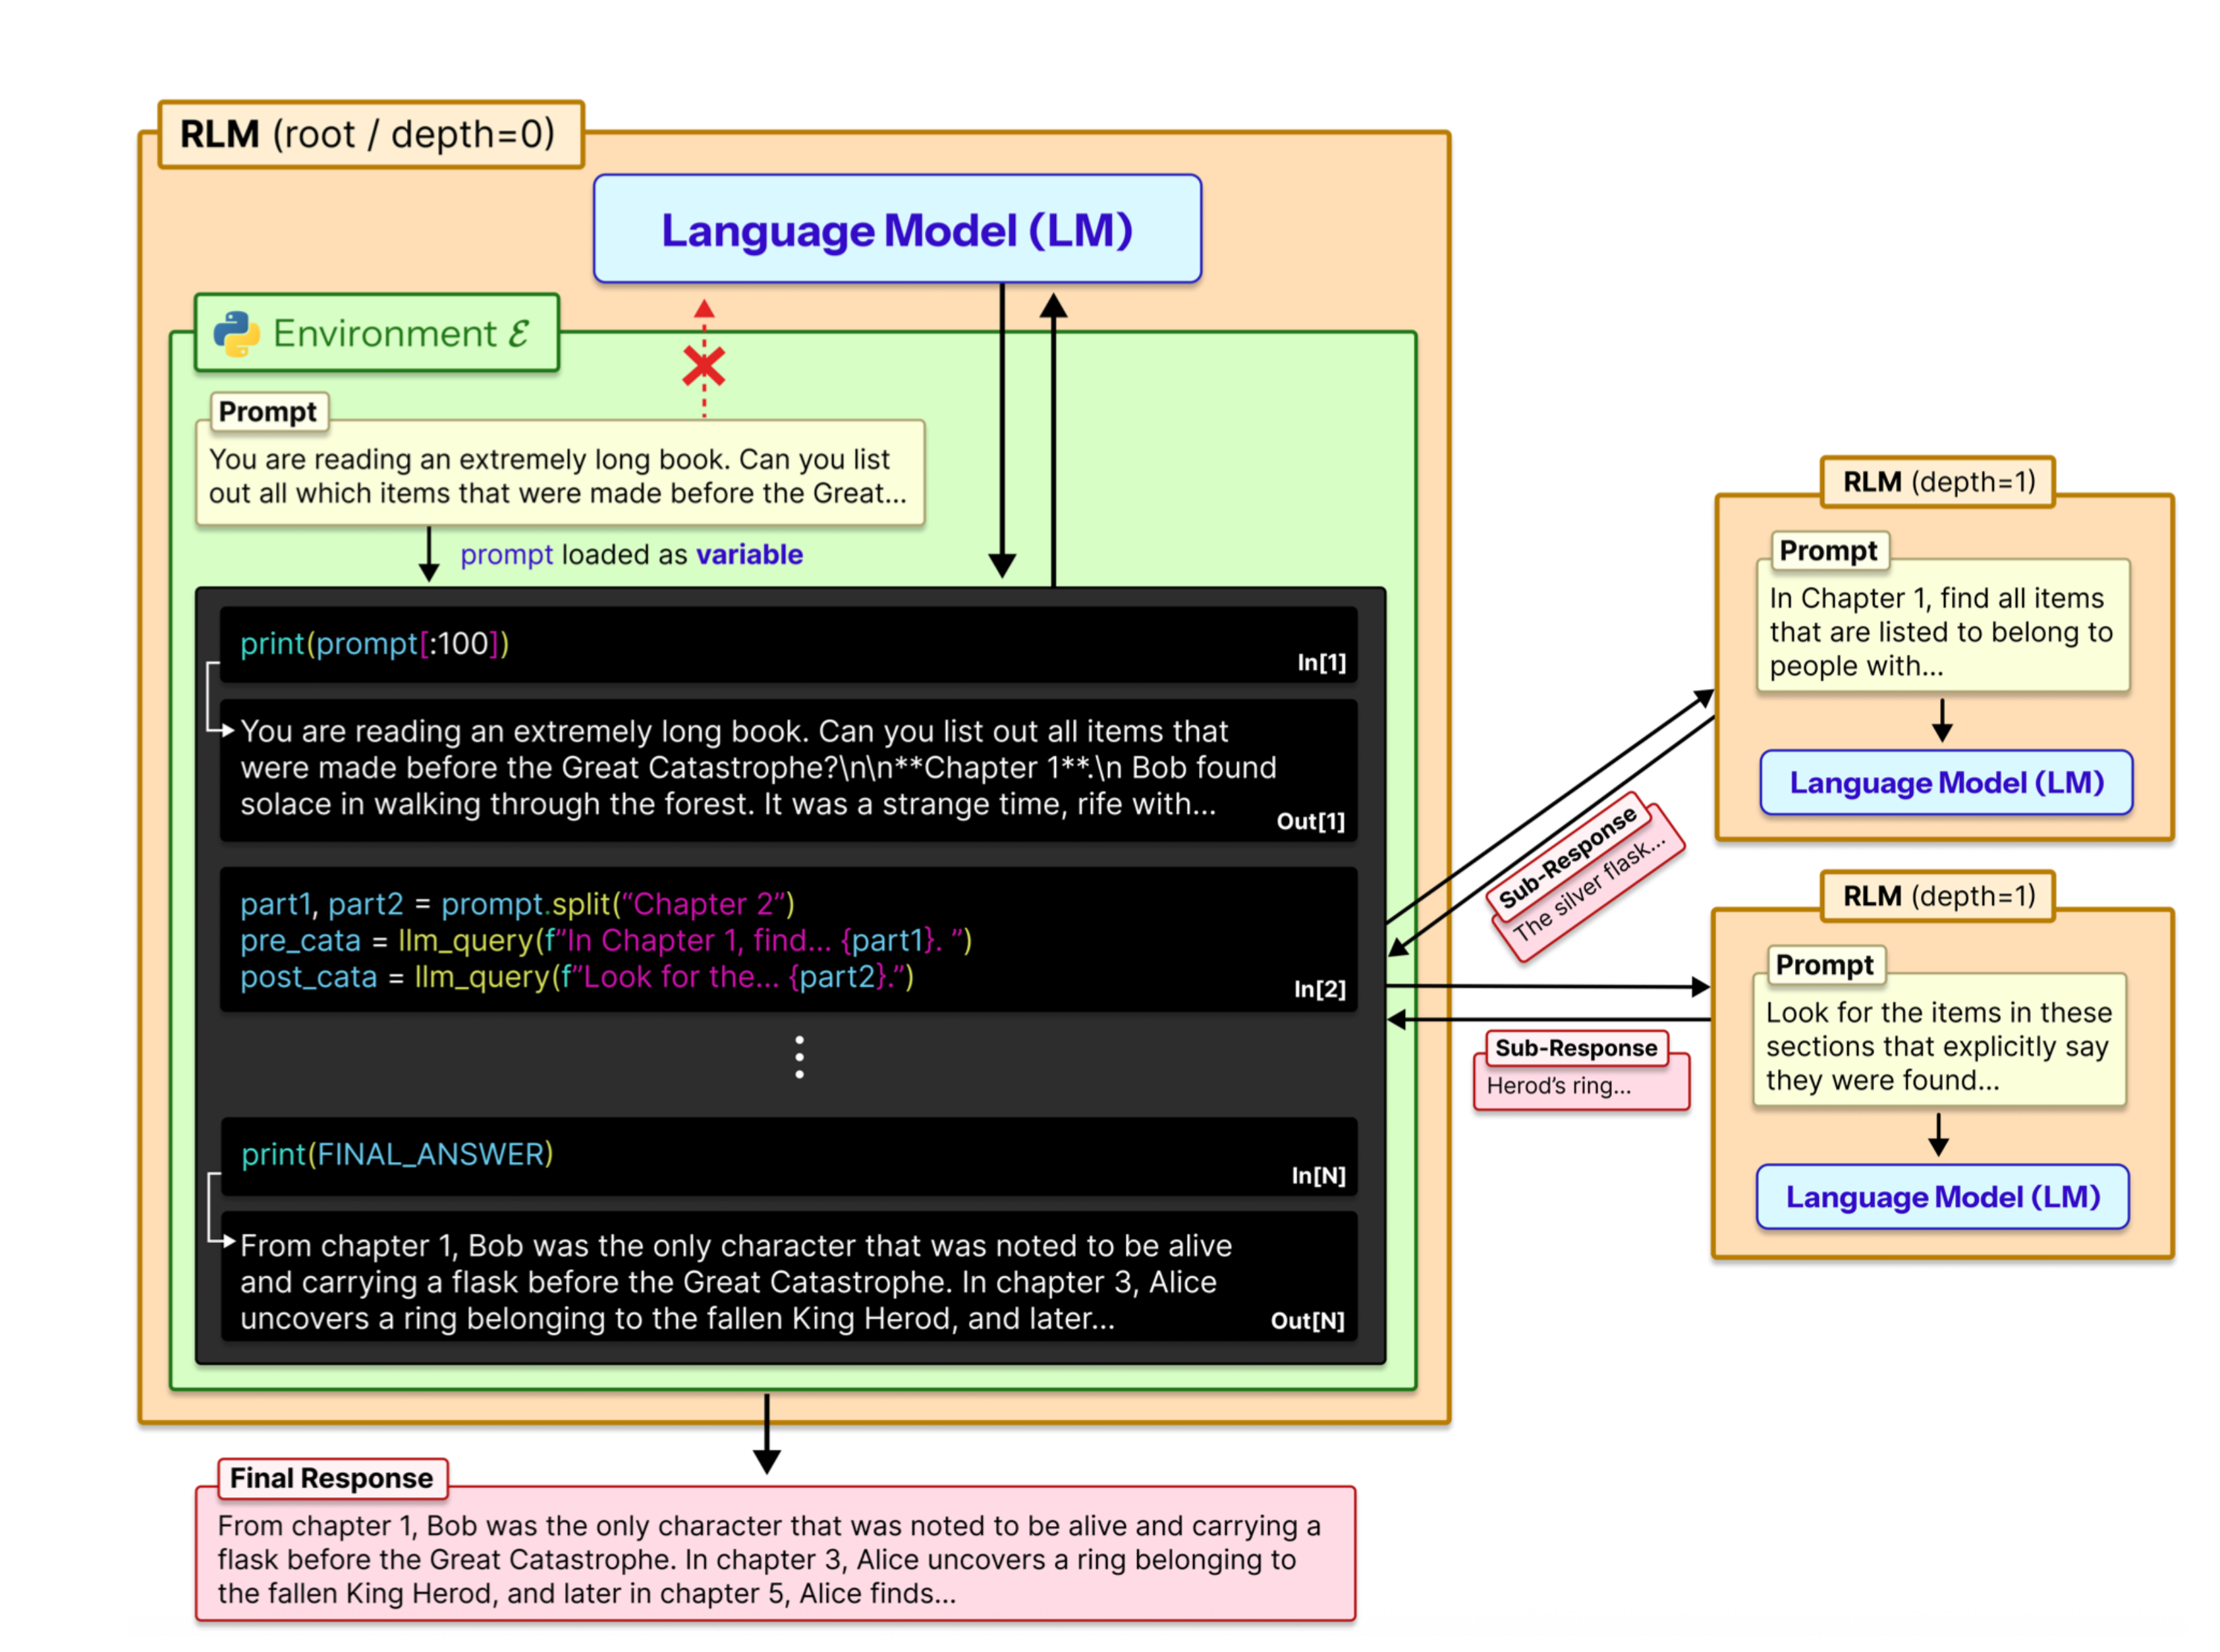
图 07 左边让模型通过执行环境访问长文本变量,右边把选出来的局部片段交给子调用。重点是按需读内容,局部任务的结果再回到主流程。 来源 [4]Recursive Language Models 原论文(2025)
03 LangGraph 怎么把流程和状态画出来?
前面的日历流程用普通 Python 就能写。节点多起来后,想知道某个分支怎么走、哪里循环、哪个节点之后能恢复,可以把这套控制流显式写成图。LangGraph的核心是三样,State(状态)放当前任务数据,Node(节点)读取并更新状态,Edge(边)决定接下来执行哪个节点。节点可以调模型,也可以跑一段确定的代码[5]。
比如,状态起初只有邮件,extract 节点把日程字段写进去。接着跑一条条件边,有事件名、日期和开始时间就去 pick_emoji 节点,再到 add_to_calendar。信息不足就直接结束。这里的路由代码是普通的 Python 判断。要更新字段名或修改条件,能直接找到哪条边依赖它。
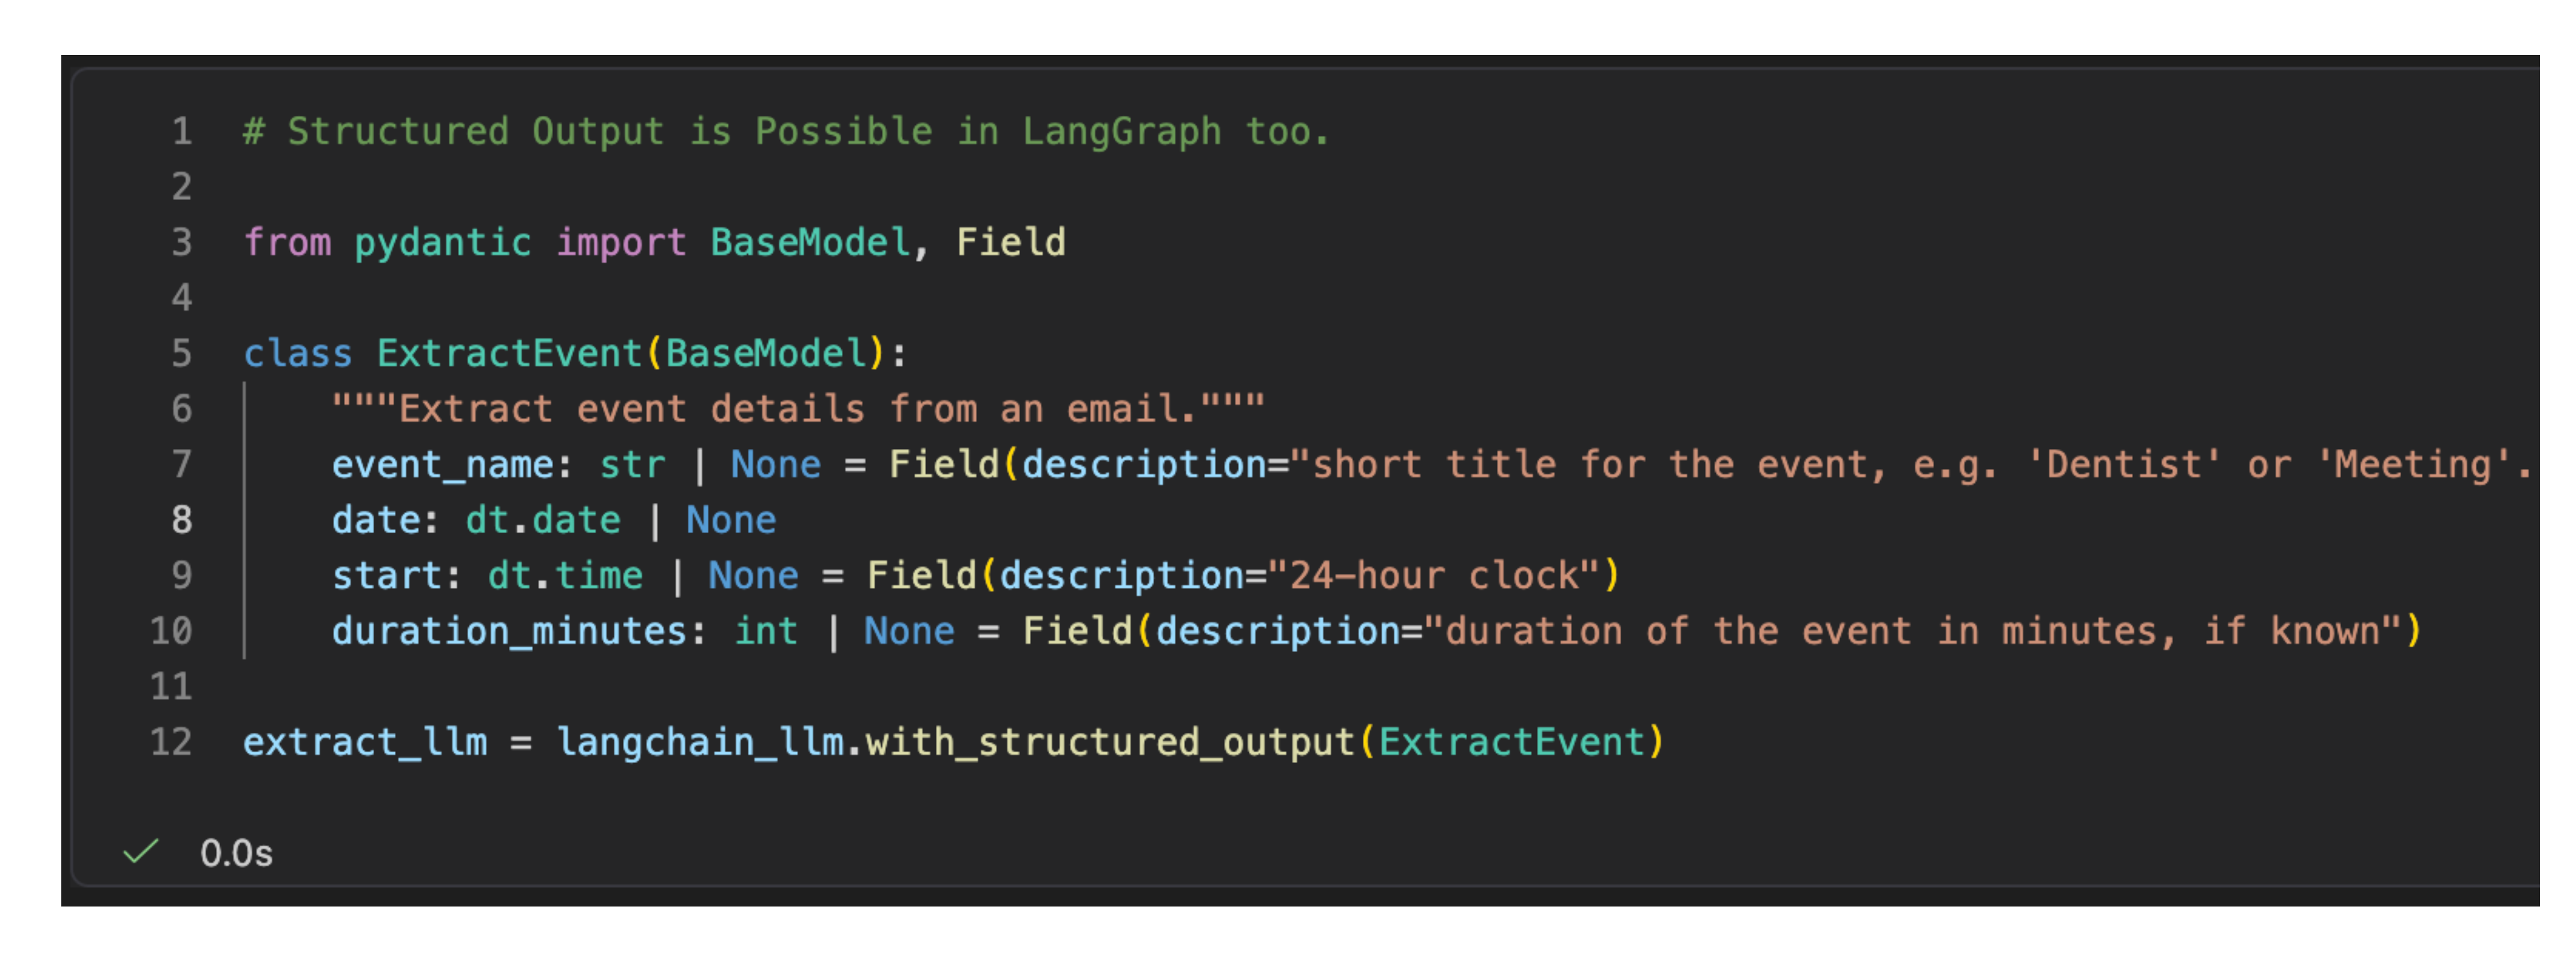
图 08 这段示例用 Pydantic 描述邮件应该提取出哪些字段。节点拿到结构化结果,再由条件边读取字段决定往哪走。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[5]LangGraph 官方概览
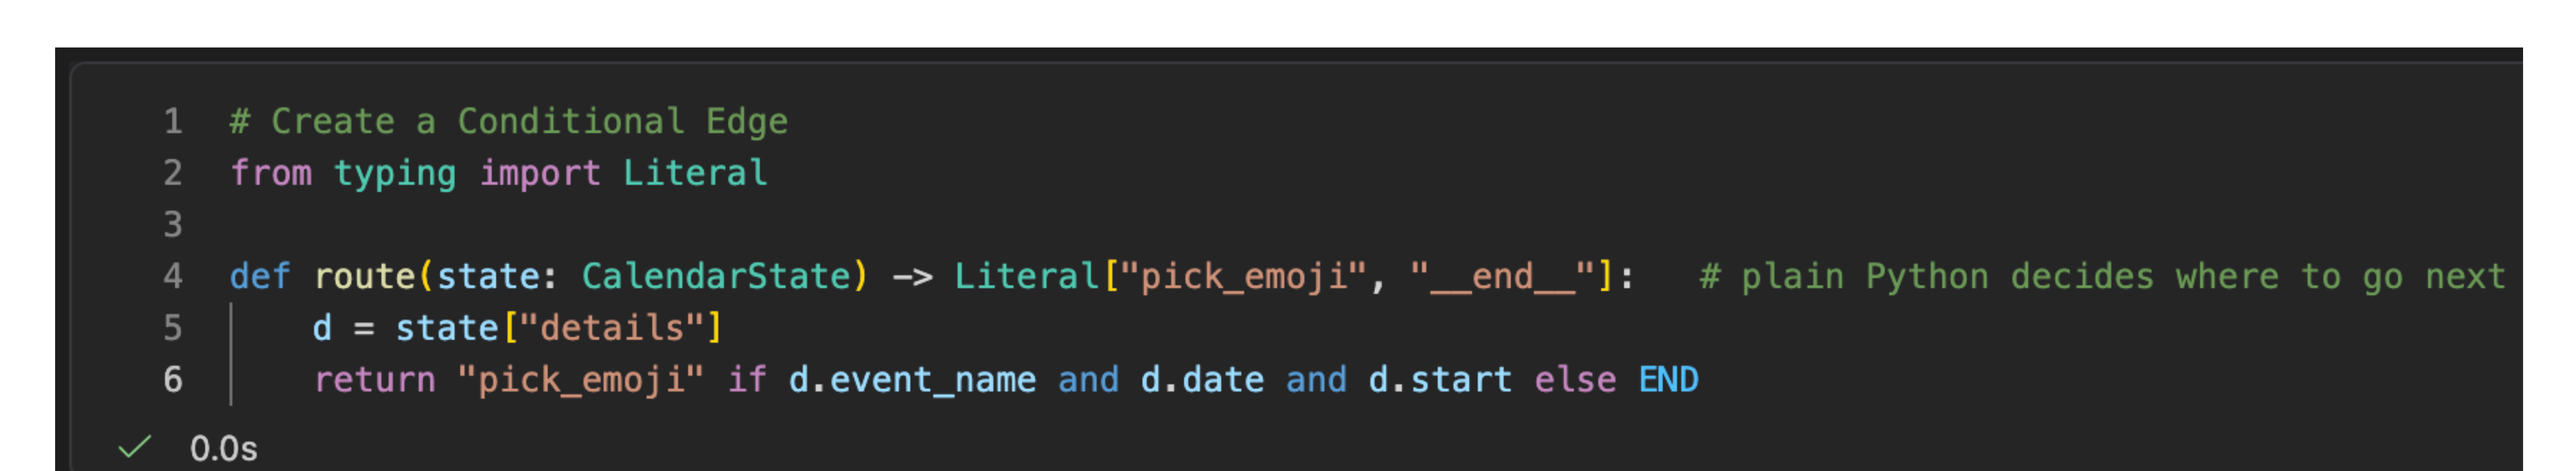
图 09 路由函数读取共享状态里的事件字段,字段够就走到选表情的节点,否则返回 END。状态里的内容来自上一个提取节点。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[5]LangGraph 官方概览
把模型放在中心,也可以搭出 Agent 循环。模型节点读消息状态,给出工具请求就走到工具节点,工具节点写回结果,再回到模型。模型没有新的调用并返回答案时,图走到终点。图负责约束能走的边,模型输出影响这一轮会走哪条。它也可以配置持久化状态等能力,具体要看应用怎么接入,而复杂任务的超时、跨服务恢复和副作用仍有对应的工程工作。
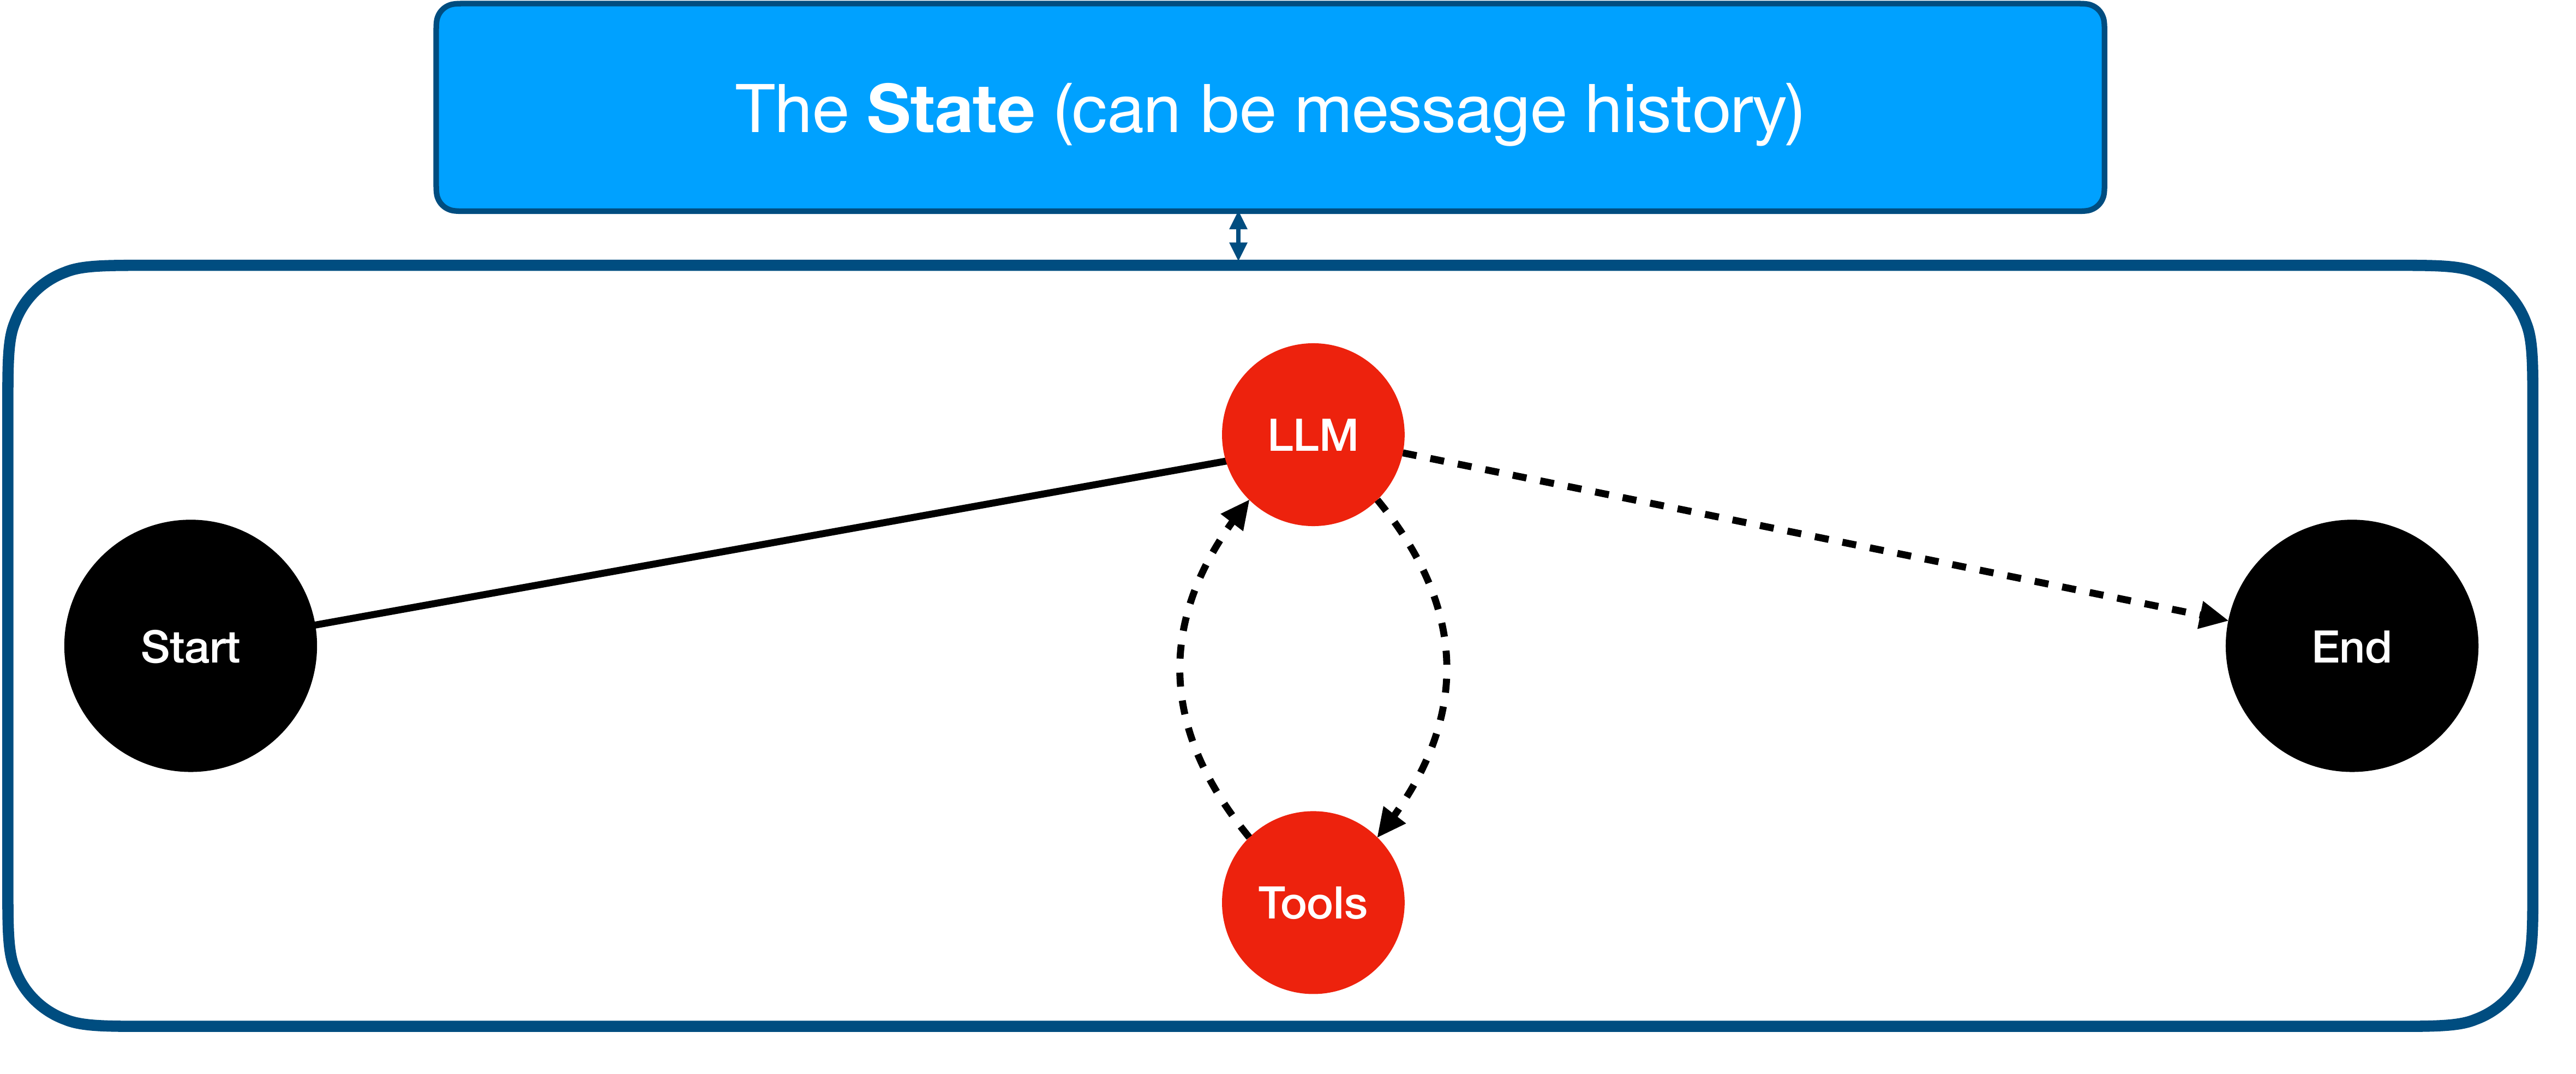
图 10 从 Start 进入模型节点。要用工具就沿向下的边走,结果写回状态再进模型。当前任务完成时,从模型节点走向 End。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[5]LangGraph 官方概览
如果要和 DSPy 放在一起理解,可以把 DSPy 看成定义和优化一段模型程序的方法,把 LangGraph 看成让状态和节点按图流转的方法。比如,提取日期的逻辑可以在某个节点里面用 DSPy 实现,整个流程仍然由图来走。能两层都用,也可以只选眼下需要的一层。
04 模型一样,换一个 Harness 为什么还会变?
看个编程 Agent。模型能不能改好代码,还要看外面那一圈怎么搭。给它哪些工具,终端状态在下一步还在不在,什么时候停止,怎么把几十轮的日志塞回上下文,这些都属于 Harness 的设计。它把模型的判断、外部工具和环境接成一个能运行的循环。
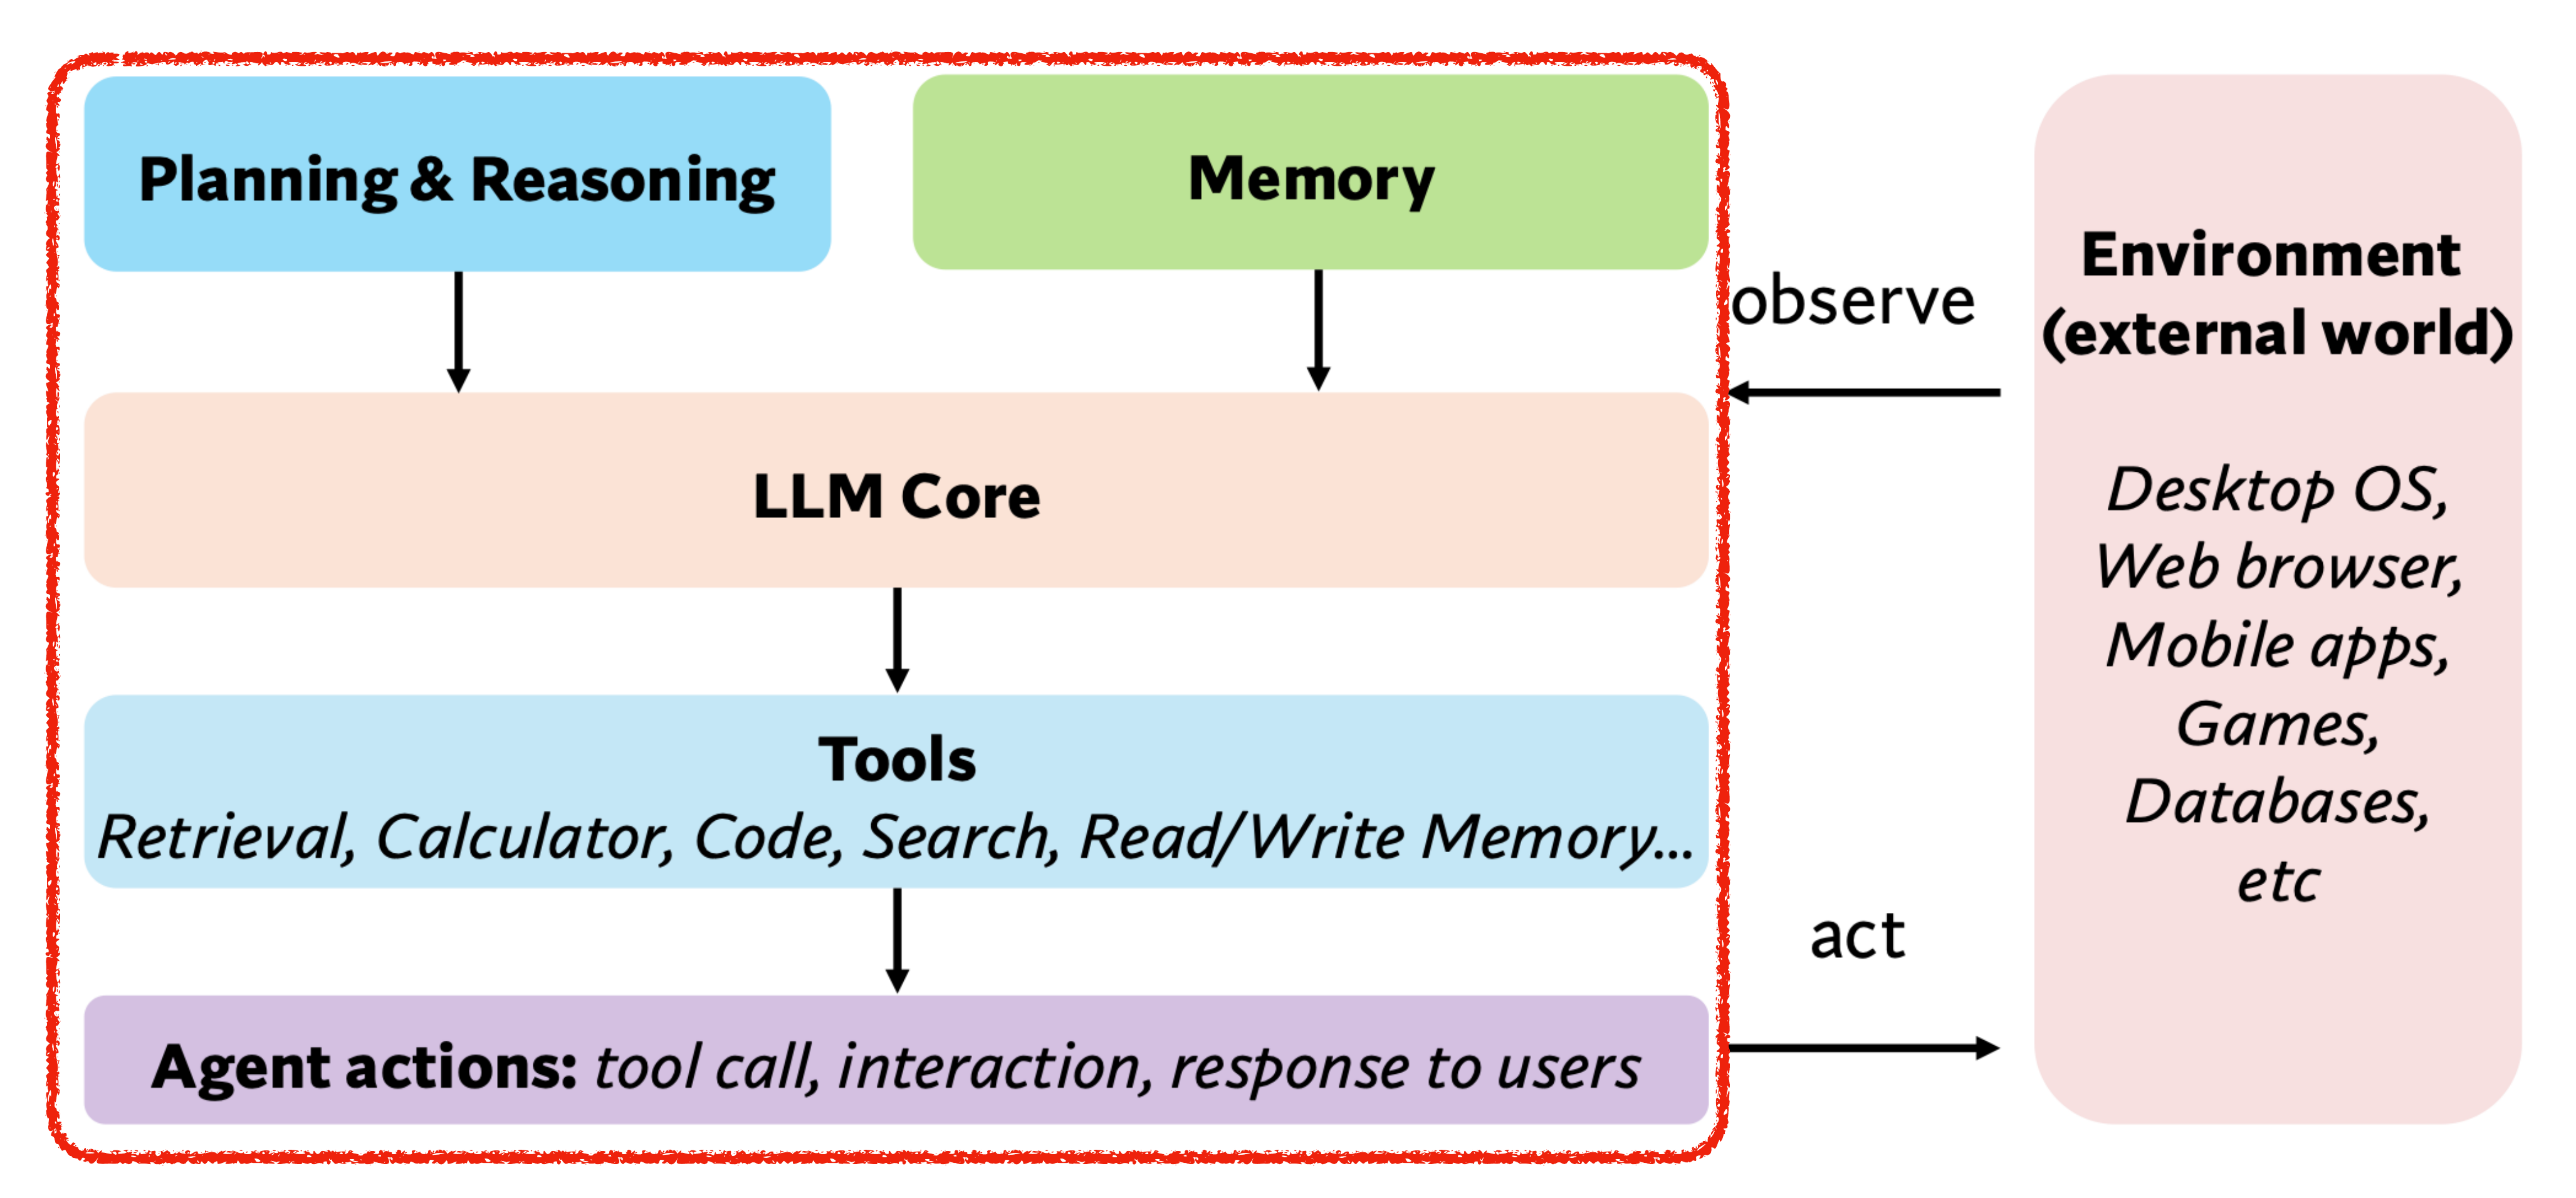
图 11 红框里的模型、记忆、工具和行动一起运转,右边是终端、浏览器等外部环境。箭头表示向外执行,再把观察到的结果交回来。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
mini-SWE-agent的早期设计非常直接。主要靠 Bash 操作,把每一步追加到线性的消息历史里。调用之间不沿用一个长期运行的 shell,刚刚切过的目录不会自动出现在下一次调用里。当工具行为很少时,出错也容易顺着这条消息链找[6]。
OpenHands给出了另一种组织办法。每一步操作和观察都可以记录成事件,再用事件重新构造模型消息。带持久终端的实现允许工作目录和 shell 环境在多步之间保留,也可以针对重复动作和相同结果做停滞检测。调试时既能看当时发生了什么,也能继续查当时给模型看了哪些记录[7]。
Pi默认将工具压到四个,读文件、写文件、编辑和 Bash。会话按树组织,可以回到早一点的消息另开分支。它按启动进程的权限工作,权限边界要由调用方或运行环境管理。OpenClaw则展示了长期运行的一种思路。Gateway 持续接入消息渠道,定时心跳可以触发 Agent,Markdown 文件可用于组织身份、指令和记忆。收到用户消息才运行,还是自己隔一段时间醒一回,会影响系统要维护多少状态[8][9]。
同模型换 Harness 有多少影响?Arena 用 Terminal-Bench 2 对比过几种组合,看到同一模型在不同 Harness 下,任务成功率和运行成本都可能变。榜单上的强弱还跟任务有关。给终端题定制过的 Harness 在终端基准上赢了,并不能代表换到日历场景还会赢。做对比时,最好留住同一批任务、同一套评分、相近的预算,再看差异发生在哪一步。Meta-Harness 的研究更进一步,让一个搜索过程提出 Harness 的改动,看运行轨迹,评分,再继续改。优化对象从单一提示词变成了模型周围的运行代码[10][11]。
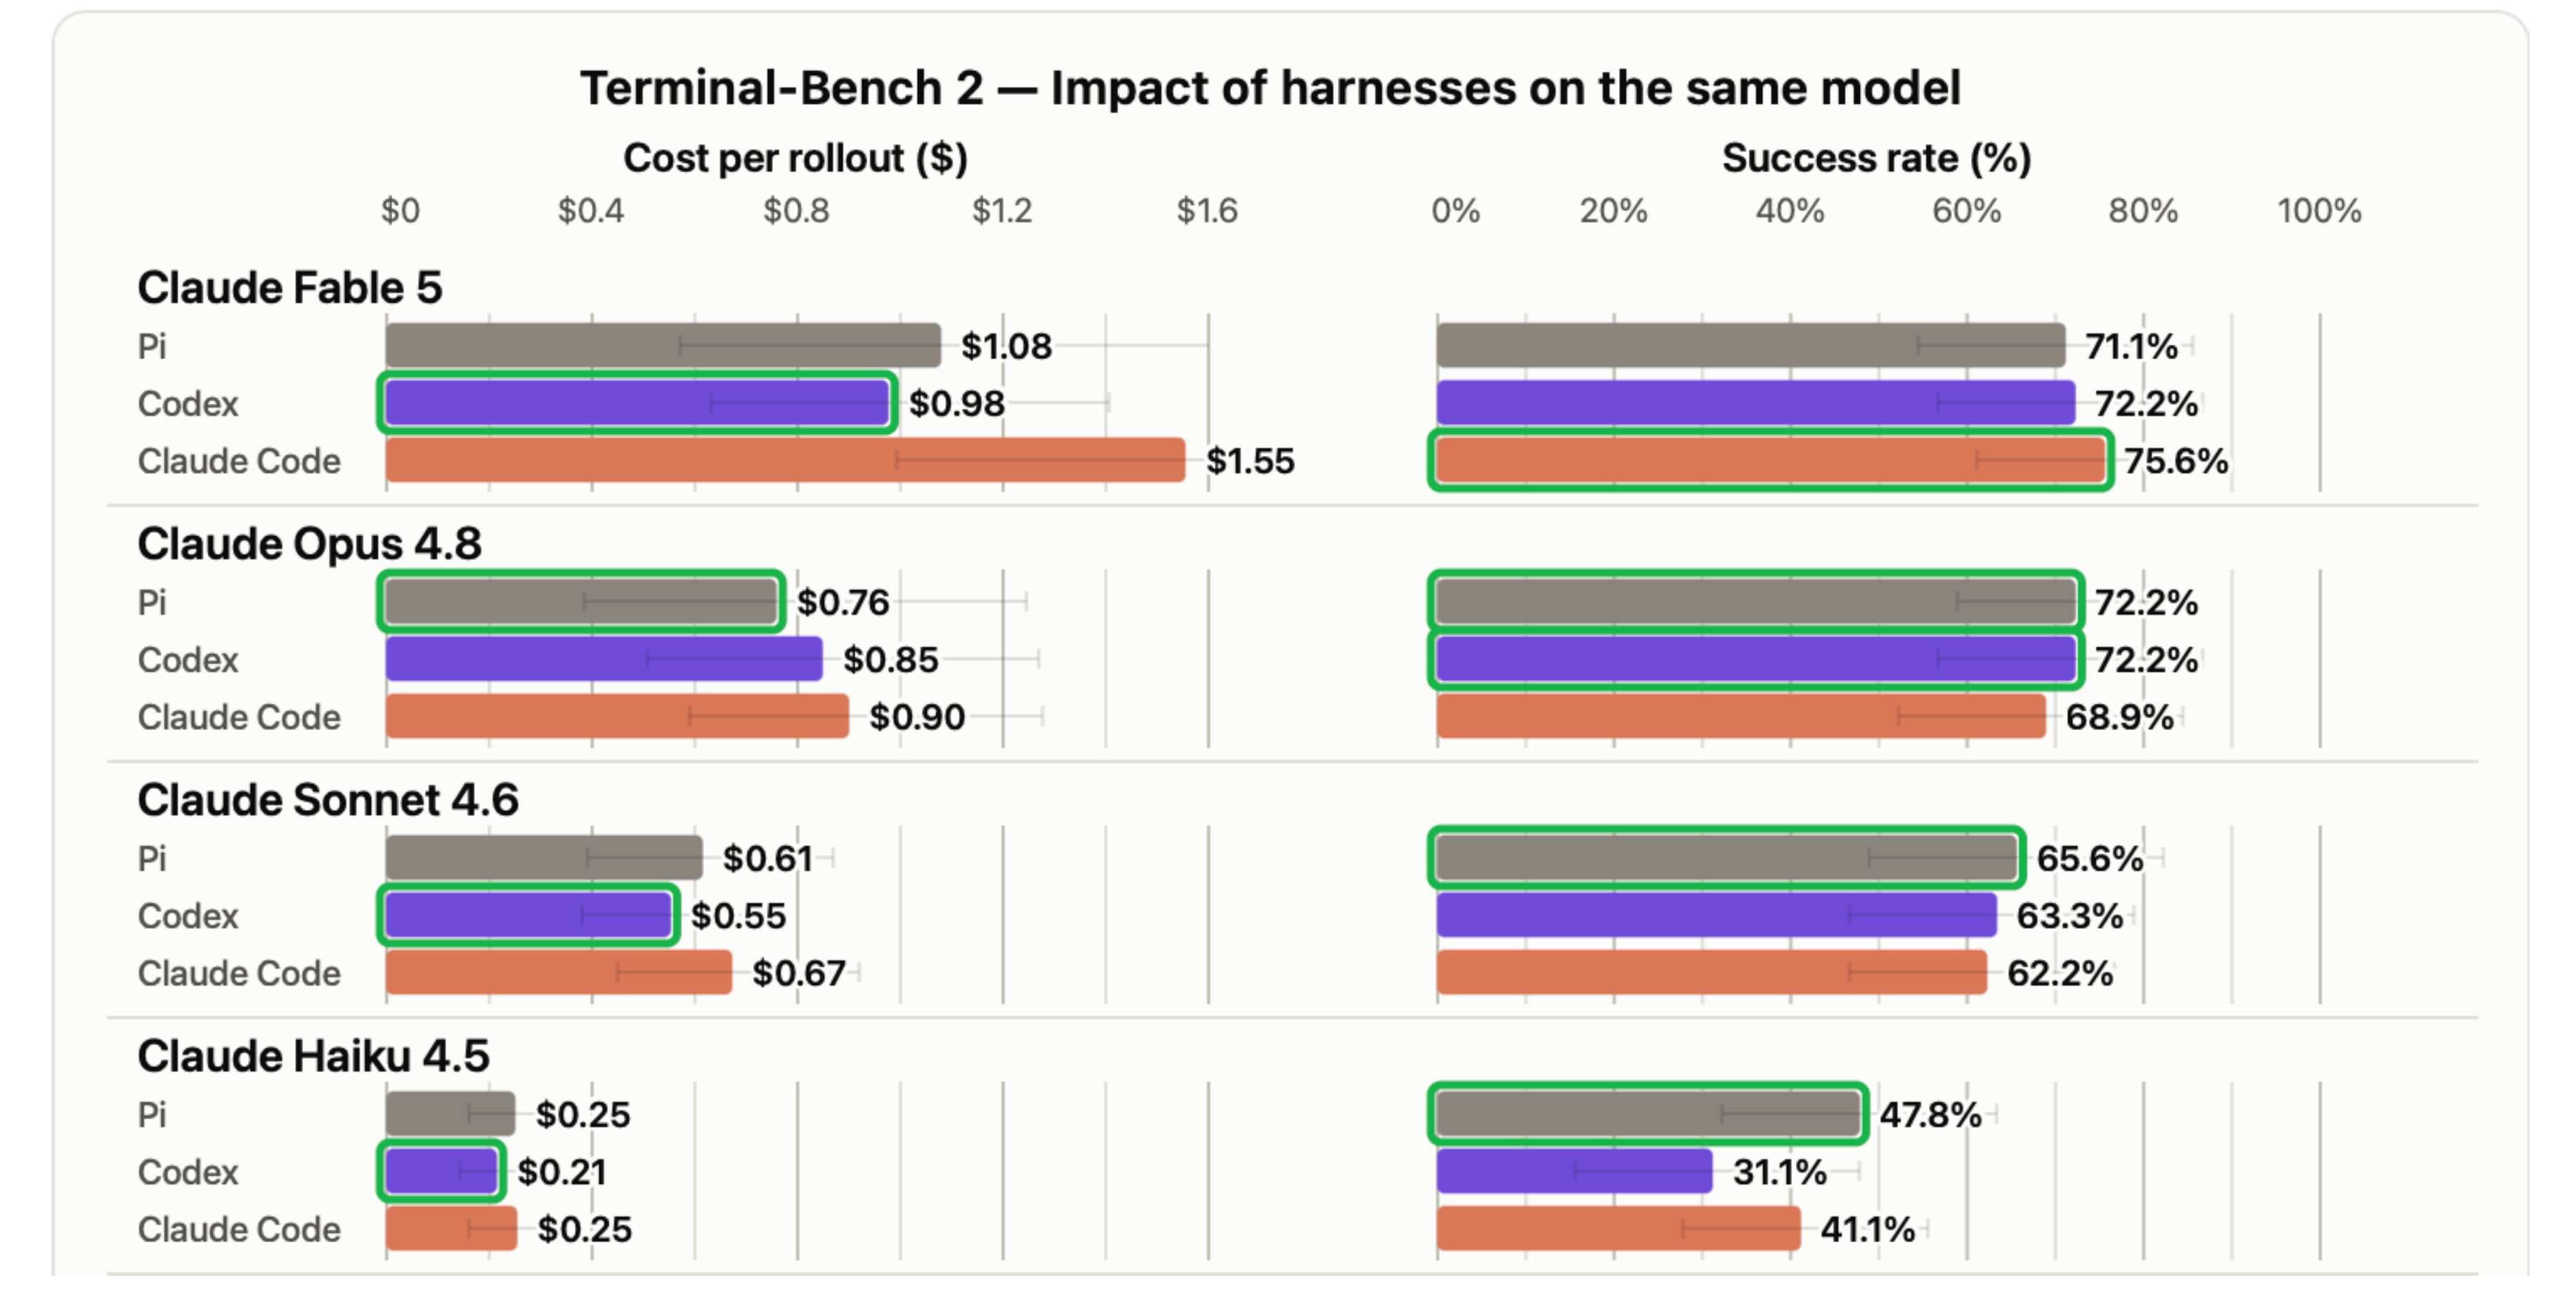
图 12 每一组是同一个模型,颜色代表不同的 Harness。左边量单次运行成本,右边量任务成功率。要看 Harness 的影响,先在同一组横着对比。 来源 [10]Arena 同模型不同 Harness 测试报告
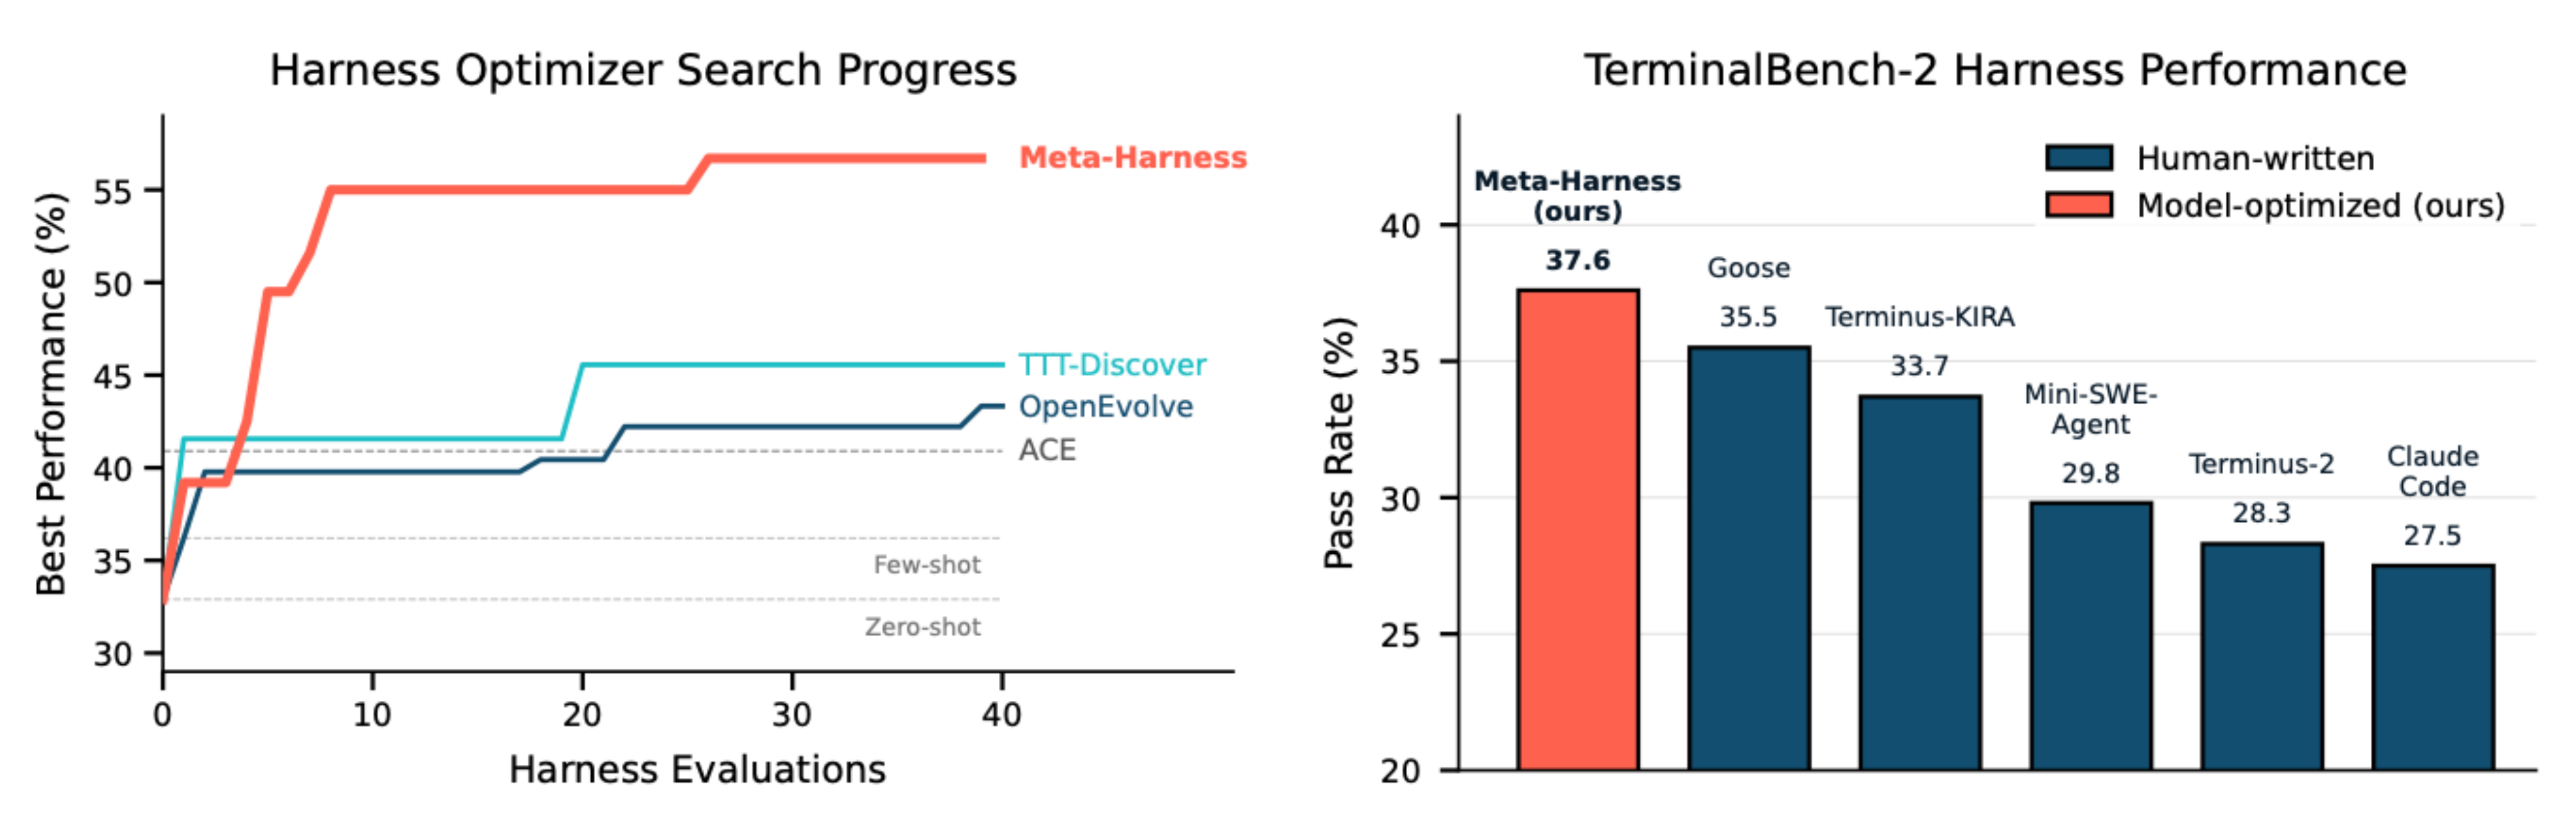
图 13 左图是随评测次数变化的搜索成绩,右图是特定终端任务基准里几个 Harness 的结果。指标用来比较这批设定下的候选设计。 来源 [11]Meta-Harness 原论文(2026)
05 Temporal 怎么让任务从故障里接着跑?
刚才的日历任务只跑几秒。换成一个要等回信、查日程、到预约时间再发提醒的工作流,中间可能隔着几个小时。进程退了,重启之后不能只靠内存判断「刚好跑到哪儿」。Temporal的持久化执行就是为这类问题准备的[12]。
它有两个核心概念。Activity是可能失败的外部操作,比如调用模型、查日历或写一条记录。Workflow描述怎么安排这些操作,比如查完再写,可能要等定时器。Worker从任务队列里取任务跑。Temporal 服务记录执行事件,Worker 换一台机器接手时,可以用历史重建工作流进度。
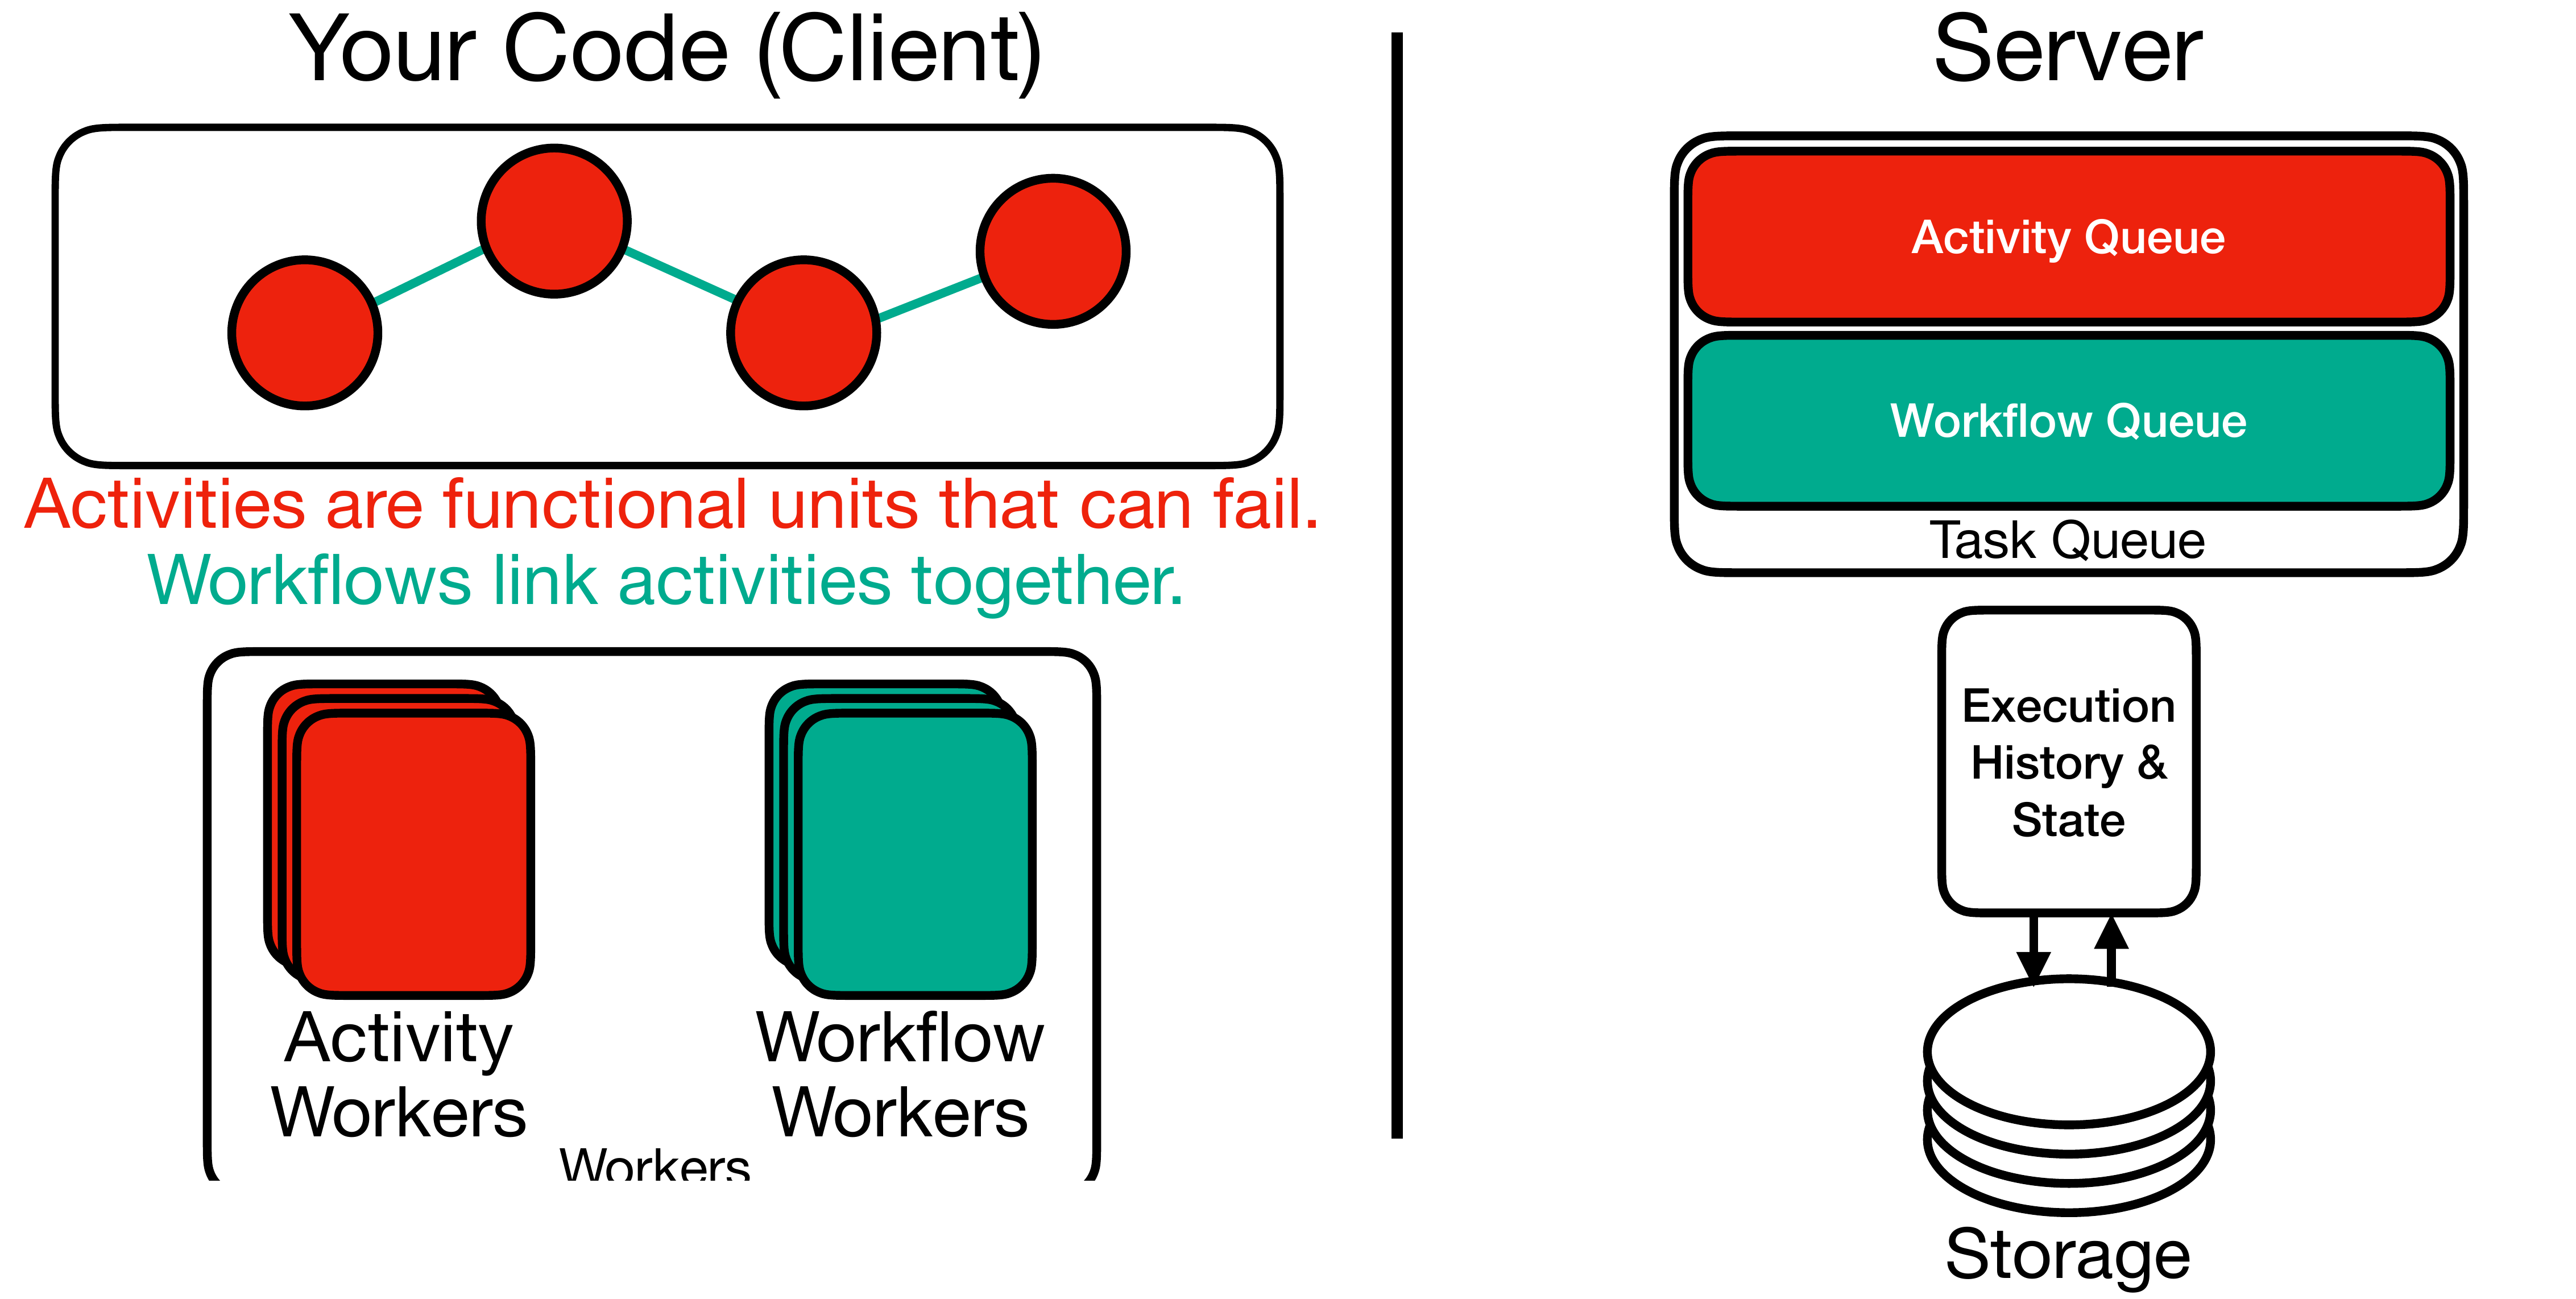
图 14 左边是工作流串起几个 Activity,以及两类 Worker。右边是服务端维护的任务队列和执行历史。恢复时靠的是已记录的历史。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[12]Temporal 官方文档 · Workflows
举个具体一点的恢复过程。提取日程的 Activity 成功了,结果已经写入执行历史。Worker 在选表情前崩了,新的 Worker 回放 Workflow 时,能读到已经记录的提取结果,再继续后半段。为了使这段回放一致,工作流代码的决策要可重放。带随机性、调用模型、网络 I/O 这些操作适合放进 Activity,或者使用框架明确支持的接口。
有失败的 Activity 可以设重试次数、退避和超时。日历演示里故意让选表情的步骤偶尔失败。从时间线上能看到,提取成功后,失败的是选表情,重试也是从选表情开始,成功后才执行写入。写入操作还要考虑另一种情况,日历已经建了日程,服务端确认还没返回,Worker 就断了。框架可能会再执行这次 Activity。给写入带一个可以查到的幂等键,或者按业务规则核对外部结果,才有办法避免重复建日程。长时间等待可以用服务端跟踪的持久定时器。需要等到明天才继续的流程,不必占着一个 Worker 一直睡。
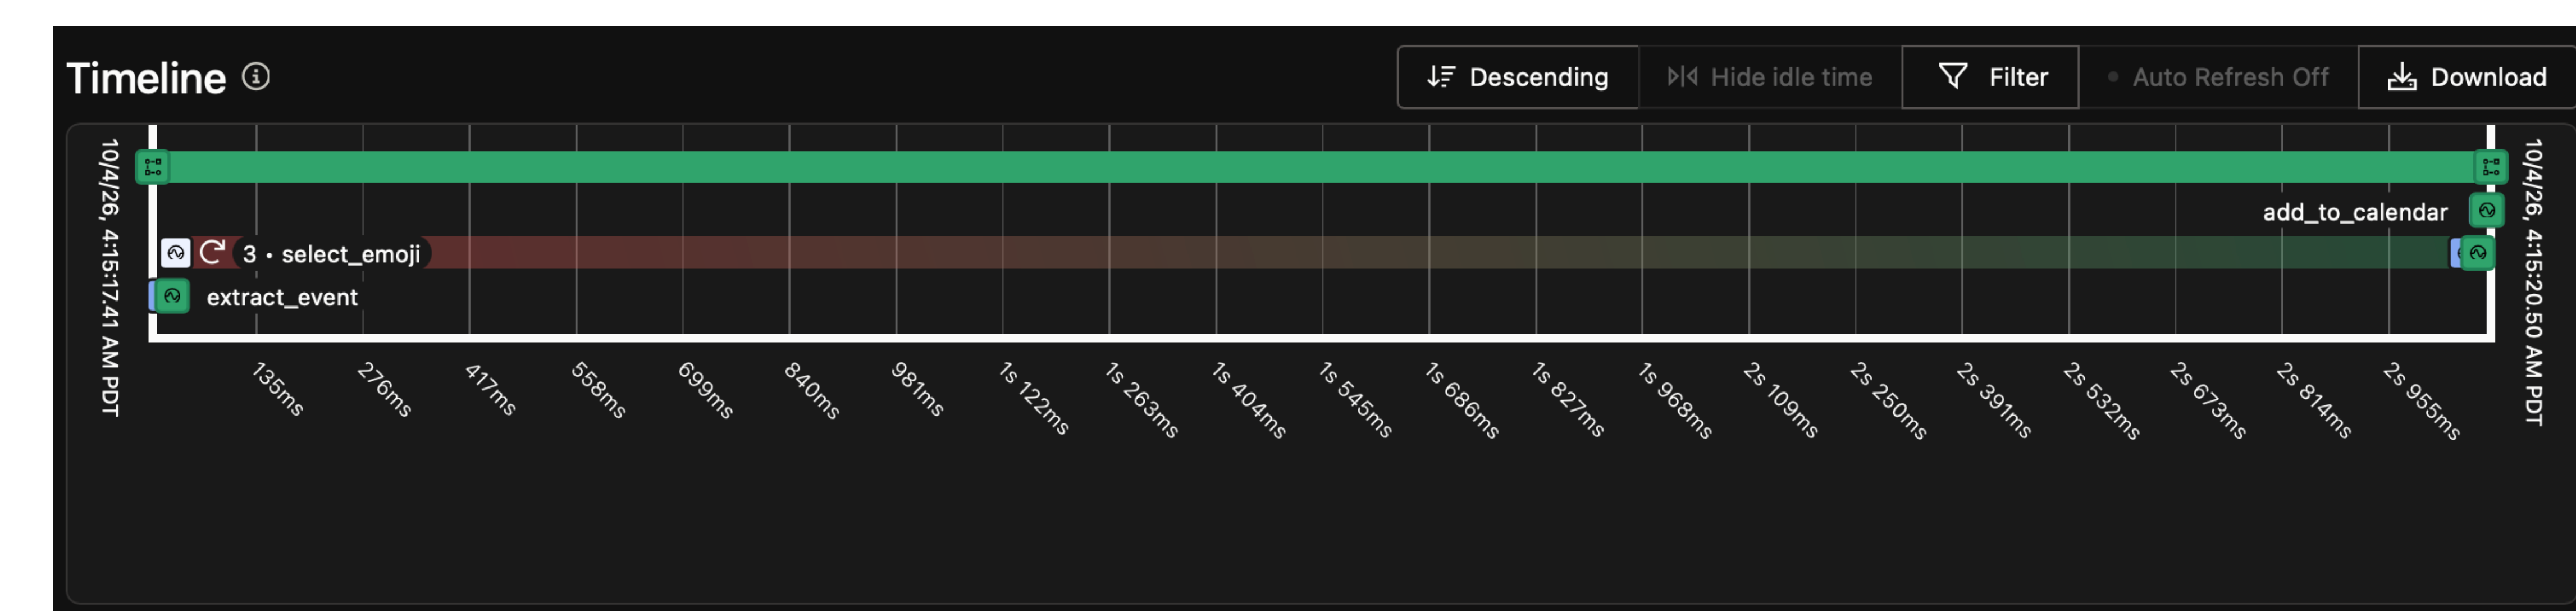
图 15 看同一条执行时间线里的多个 Activity 尝试。某一步失败后可以按策略再次执行,其他已经完成并记入历史的步骤可以沿用。 来源 [1]斯坦福大学《Engineering AI Agents》课程(CS329Z)、[12]Temporal 官方文档 · Workflows
06 做得能跑,也要做得能查、能评测
一次请求的失败,要能追到具体节点
一个日历事件写错了,我希望能找到是谁把「下午三点」改成了「凌晨三点」。查一次完整的 Trace(追踪),先看模型的输入和结构化结果,再看路由判断、调用外部 API 的实参、返回状态。账号、令牌和邮件正文等敏感信息要按业务规定脱敏和控制访问。记录的重点是,谁在什么时候用哪些关键字段做了什么,究竟哪一步出的问题。
MLflow 可以把模型调用和评测放到实验记录里看。LangSmith 有按请求和步骤排开的运行记录。Langfuse 也把调用、成本、延迟等指标聚合起来,并支持往下找具体任务。这些工具共同解决的是出了错怎么找,故障恢复还要靠工作流本身设定超时、重试上限和预算,到达上限时要有能看懂的结束状态[13][14][15]。
工具返回失败之后,还有两种情况要分开。一次临时的网络错误,可以按基础设施的策略重试。返回「日期格式不支持」或者「这个时间段已有预约」,原样重试也改变不了结果,可以把可读的错误送回模型,让它改参数、换一步,或者向用户确认。把这两种错误分开,才不会把预算花在同一条失败调用上。
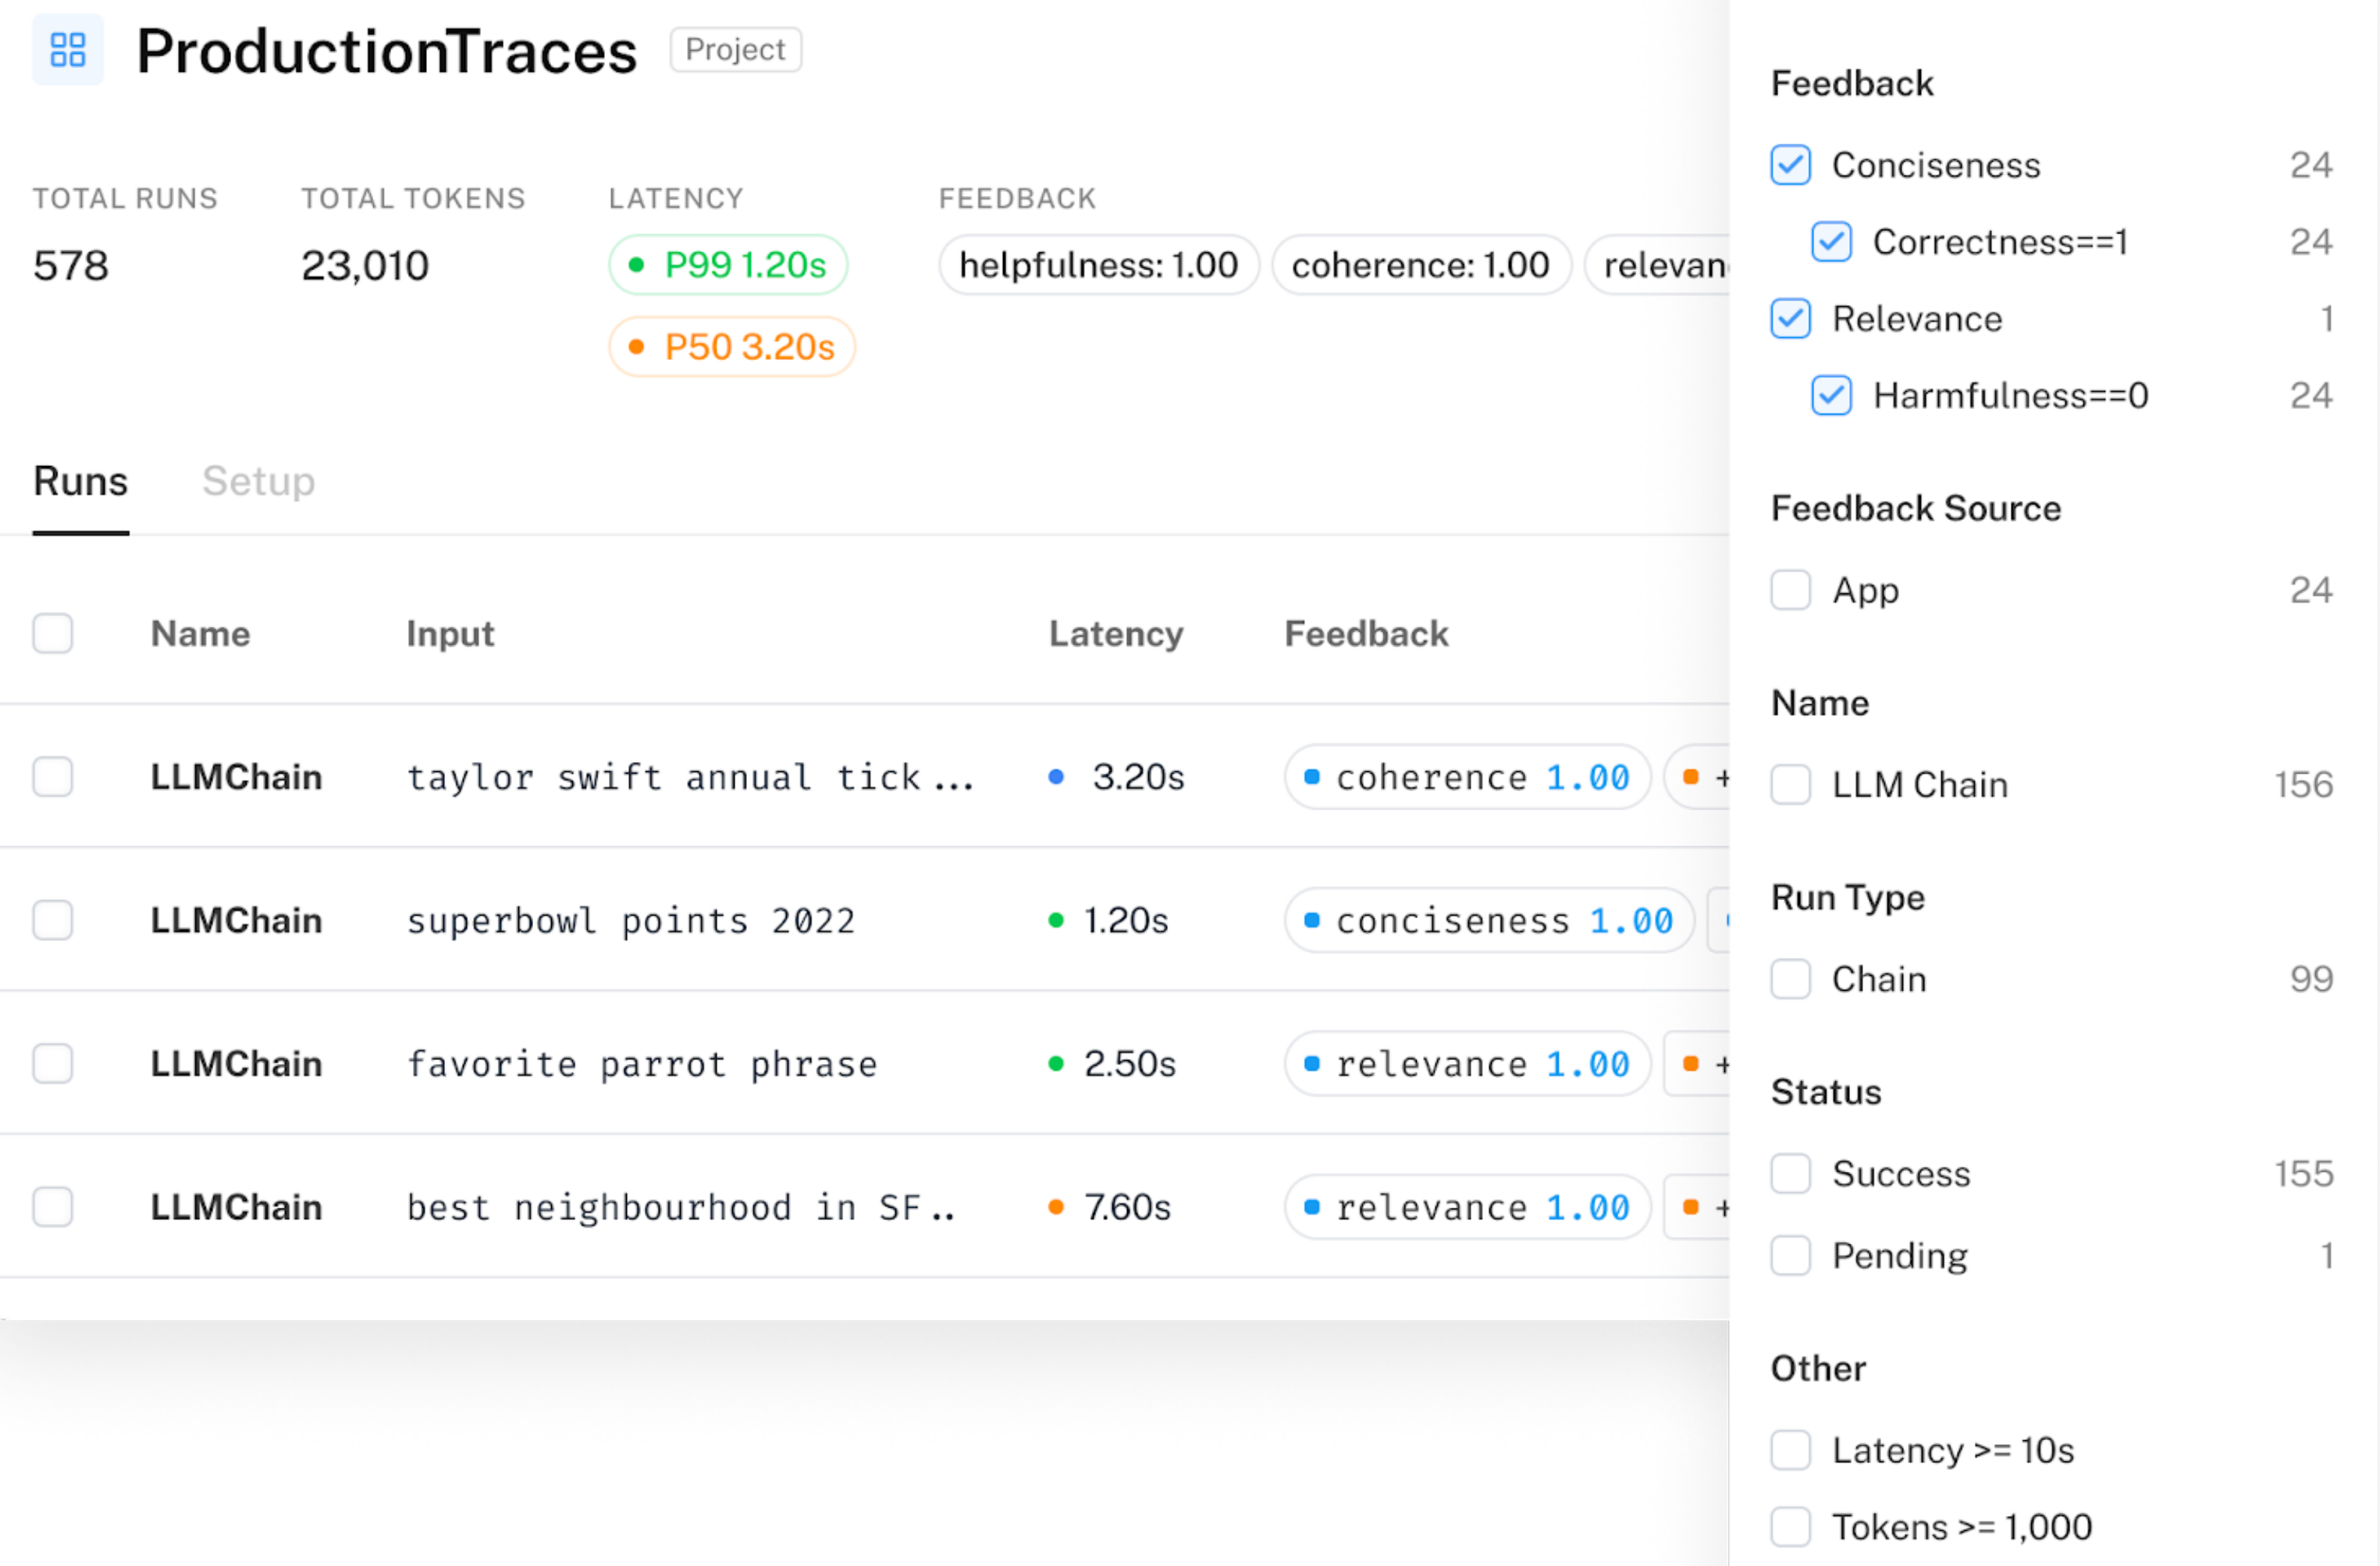
图 16 这一页展示一次次运行的追踪记录。能按延迟、状态等信息找同一次请求,再展开看里面的模型调用和工具步骤。 来源 [14]LangSmith 官方发布文与界面
Shepherd展示了执行轨迹还可以服务于另一种用途。它把可观察的执行轨迹变成可操作的结构,外部的 Meta-Agent 能根据轨迹进行分支、回退或介入,再比较后续表现。这是研究里的执行抽象。现实系统已经写到外部的动作,还要按外部系统支持的方式补偿或撤销,一段模型的历史回退不了已经送达的邮件[16]。
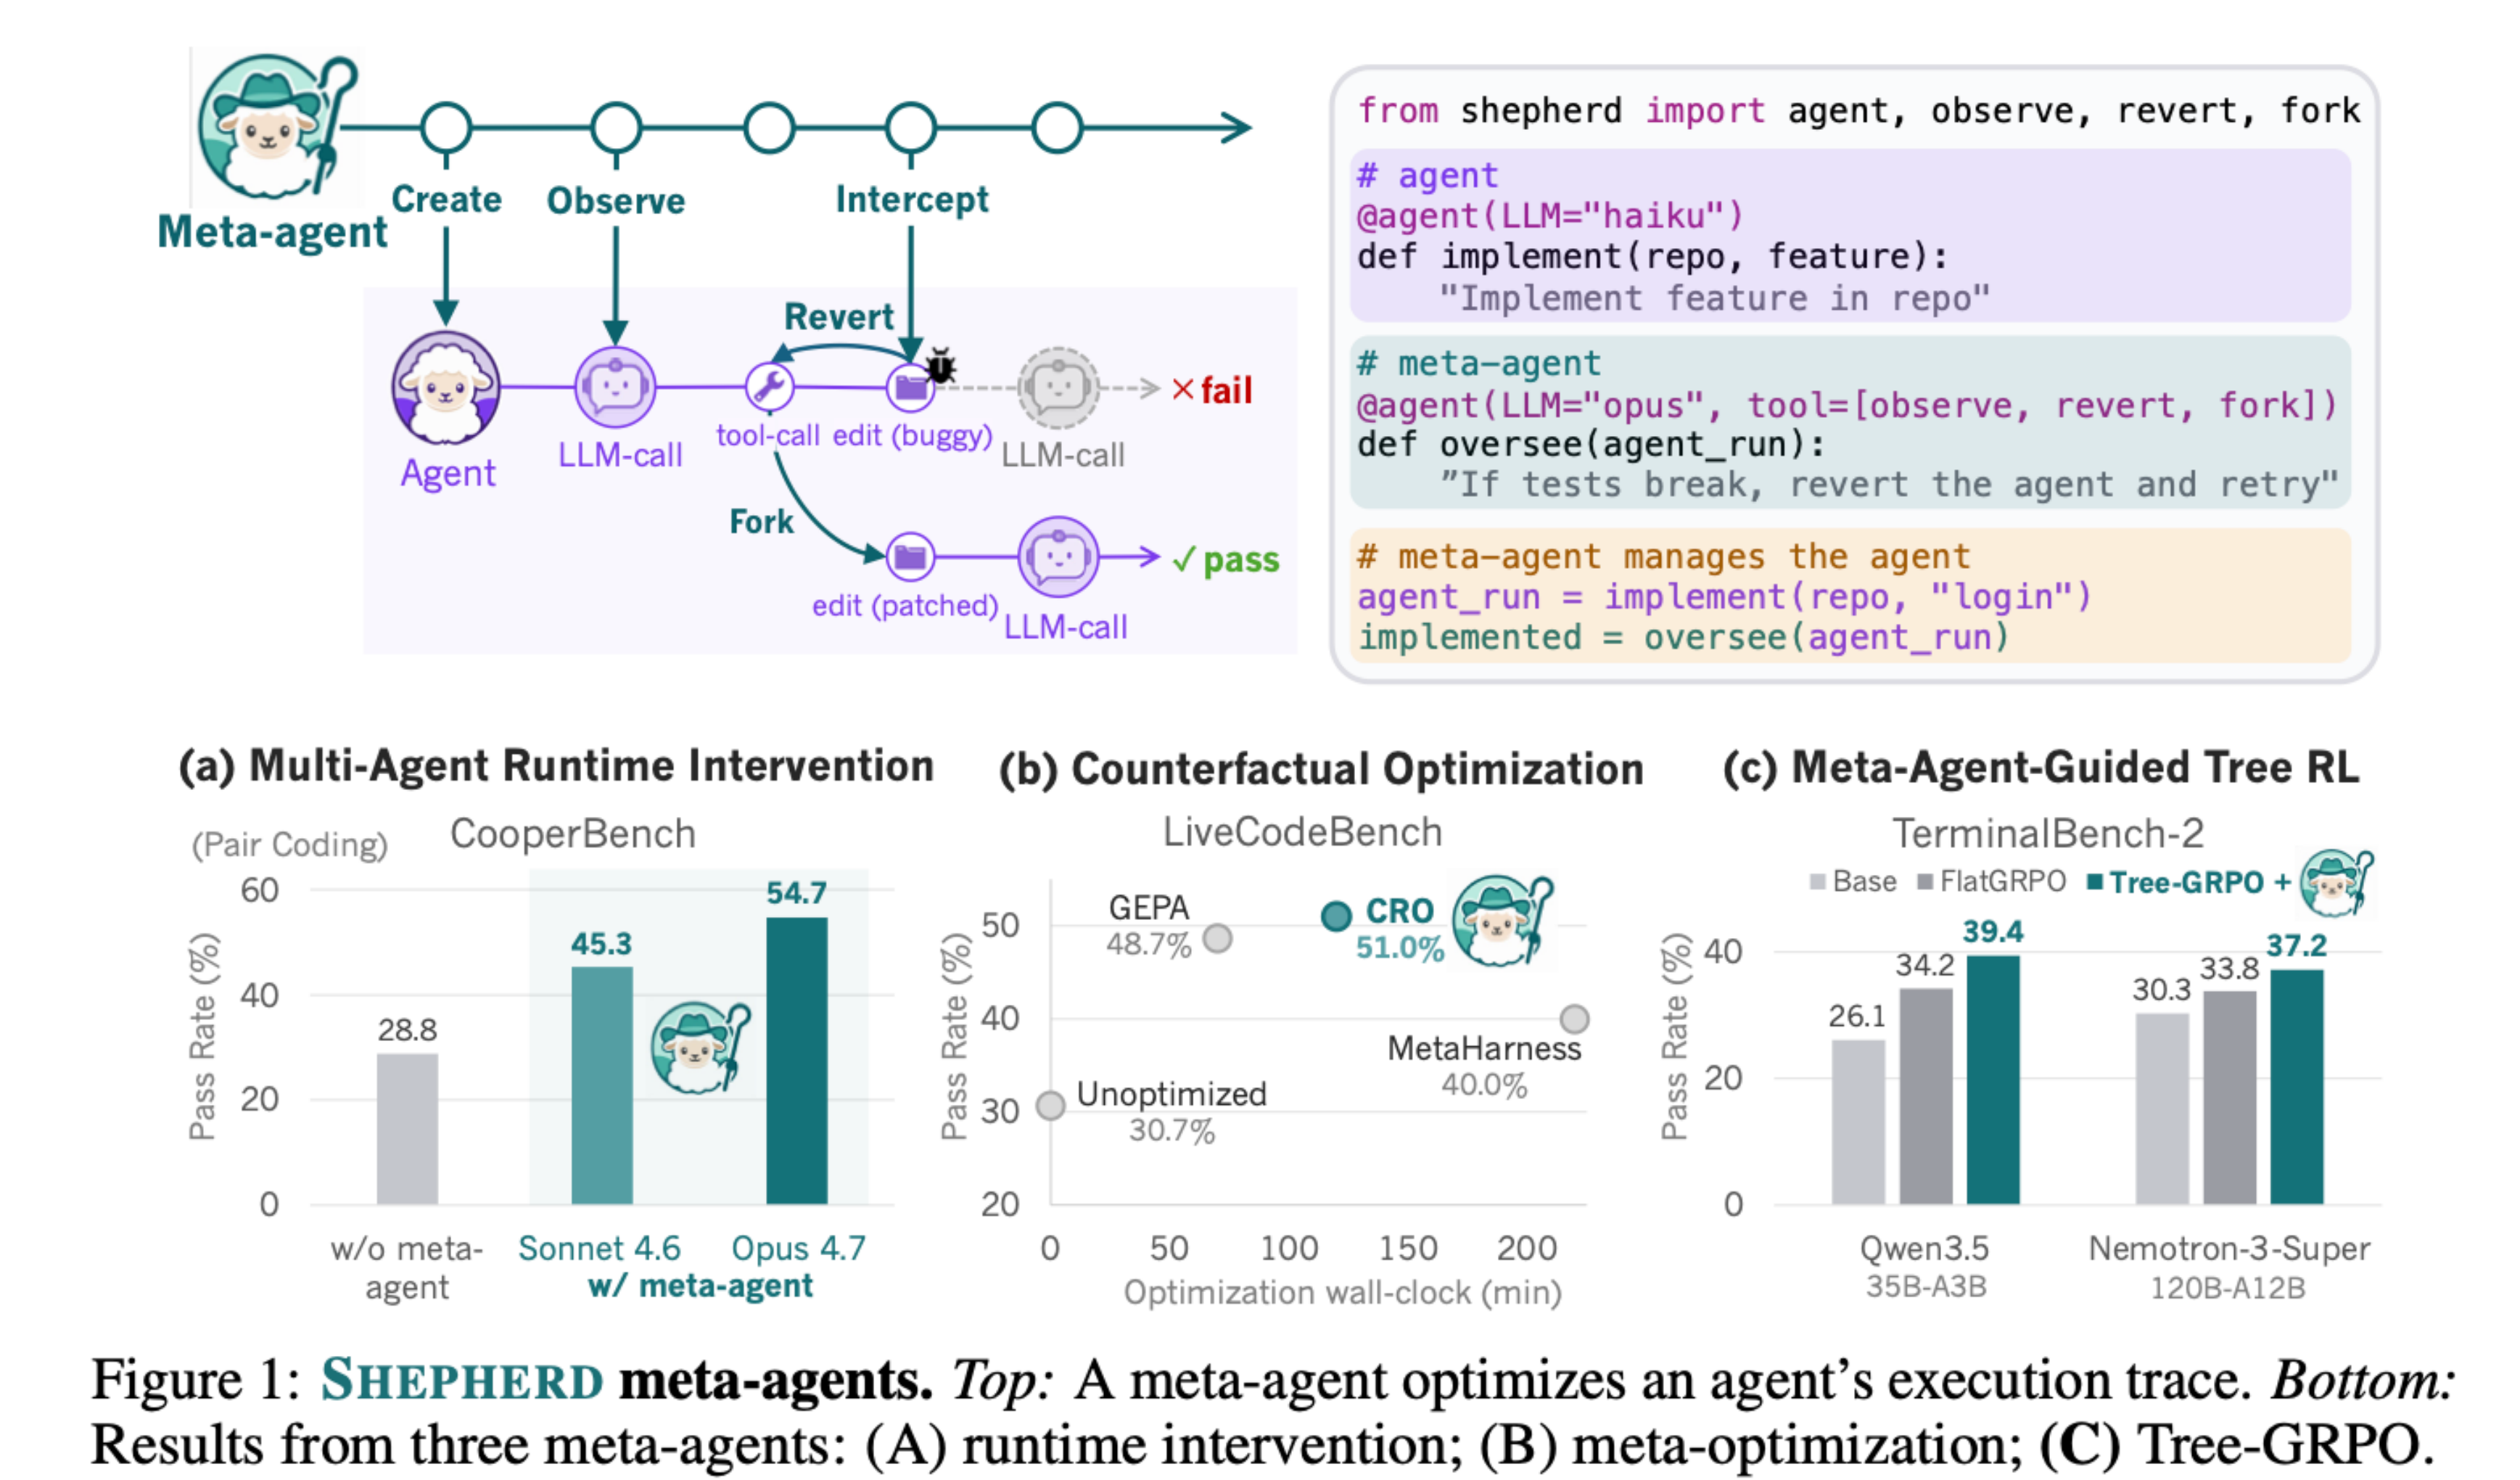
图 17 上方图里,Meta-Agent 在轨迹的不同位置观察、干预或分叉。下方三张图对比的是论文里三类使用方式的结果。 来源 [16]Shepherd 原论文(2026)
把领域里的真实任务做成测试集
公开编程榜单可以测一类 Agent 的通用能力。真要把邮件加到日历,更有用的分数来自自己的样本。可以先选几个用户真的会遇到的场景,写得很明确的约会,跨时区会议,只有日期没有时间的通知,邮件里同时有几个候选日期。再加 API 超时、重复投递、无权限写入这些情况。检查最终状态,核对错误是不是按规则收住,同时看准确率、费用、延迟。改完提示词或工具以后用同一套样本回归,才能知道哪些变好、哪些被带坏。
用框架之前,我会先把自己想省的那段工作说清楚。需要系统化地优化模型模块,就从数据和指标开始。需要看清多段任务怎么流转,先把状态和分支写出来。要跨进程、跨几小时接着跑,就看持久化执行和副作用。框架把这些事情做成了能复用的部件。出了错,开发者仍然要知道实际发给了模型什么、又调了哪个外部接口。
下一篇接着讲设计本身。什么时候几条固定的分支就够用,什么时候值得让模型自己决定下一步?
都看到这里了,点个赞或者在看,就是对我最大的支持。
参考文献
[1]斯坦福大学《Engineering AI Agents》课程(CS329Z)
https://cs329z.stanford.edu/
[2]DSPy 原论文(2023)
https://arxiv.org/abs/2310.03714
[3]GEPA 提示词优化论文(2025)
https://arxiv.org/abs/2507.19457
[4]Recursive Language Models 原论文(2025)
https://arxiv.org/abs/2512.24601
[5]LangGraph 官方概览
https://docs.langchain.com/oss/python/langgraph/overview
[6]mini-SWE-agent 官方仓库
https://github.com/SWE-agent/mini-swe-agent
[7]OpenHands SDK 事件架构文档
https://docs.openhands.dev/sdk/arch/events
[8]Pi CLI 官方文档
https://docs.pi.dev/latest/cli
[9]OpenClaw 官方文档 · Heartbeat
https://docs.openclaw.ai/gateway/heartbeat
[10]Arena 同模型不同 Harness 测试报告
https://arena.ai/blog/coding-agents-harness-tax
[11]Meta-Harness 原论文(2026)
https://arxiv.org/abs/2603.28052
[12]Temporal 官方文档 · Workflows
https://docs.temporal.io/workflows
[13]MLflow 官方文档 · Tracing
https://mlflow.org/docs/latest/genai/tracing/
[14]LangSmith 官方发布文与界面
https://www.langchain.com/blog/announcing-langsmith
[15]Langfuse 官方文档
https://langfuse.com/docs
[16]Shepherd 原论文(2026)
https://arxiv.org/abs/2605.10913